
Alibaba เปิดตัว Qwen3.8-LiveTranslate ล่าม AI แปลเรียลไทม์ 60 ภาษา
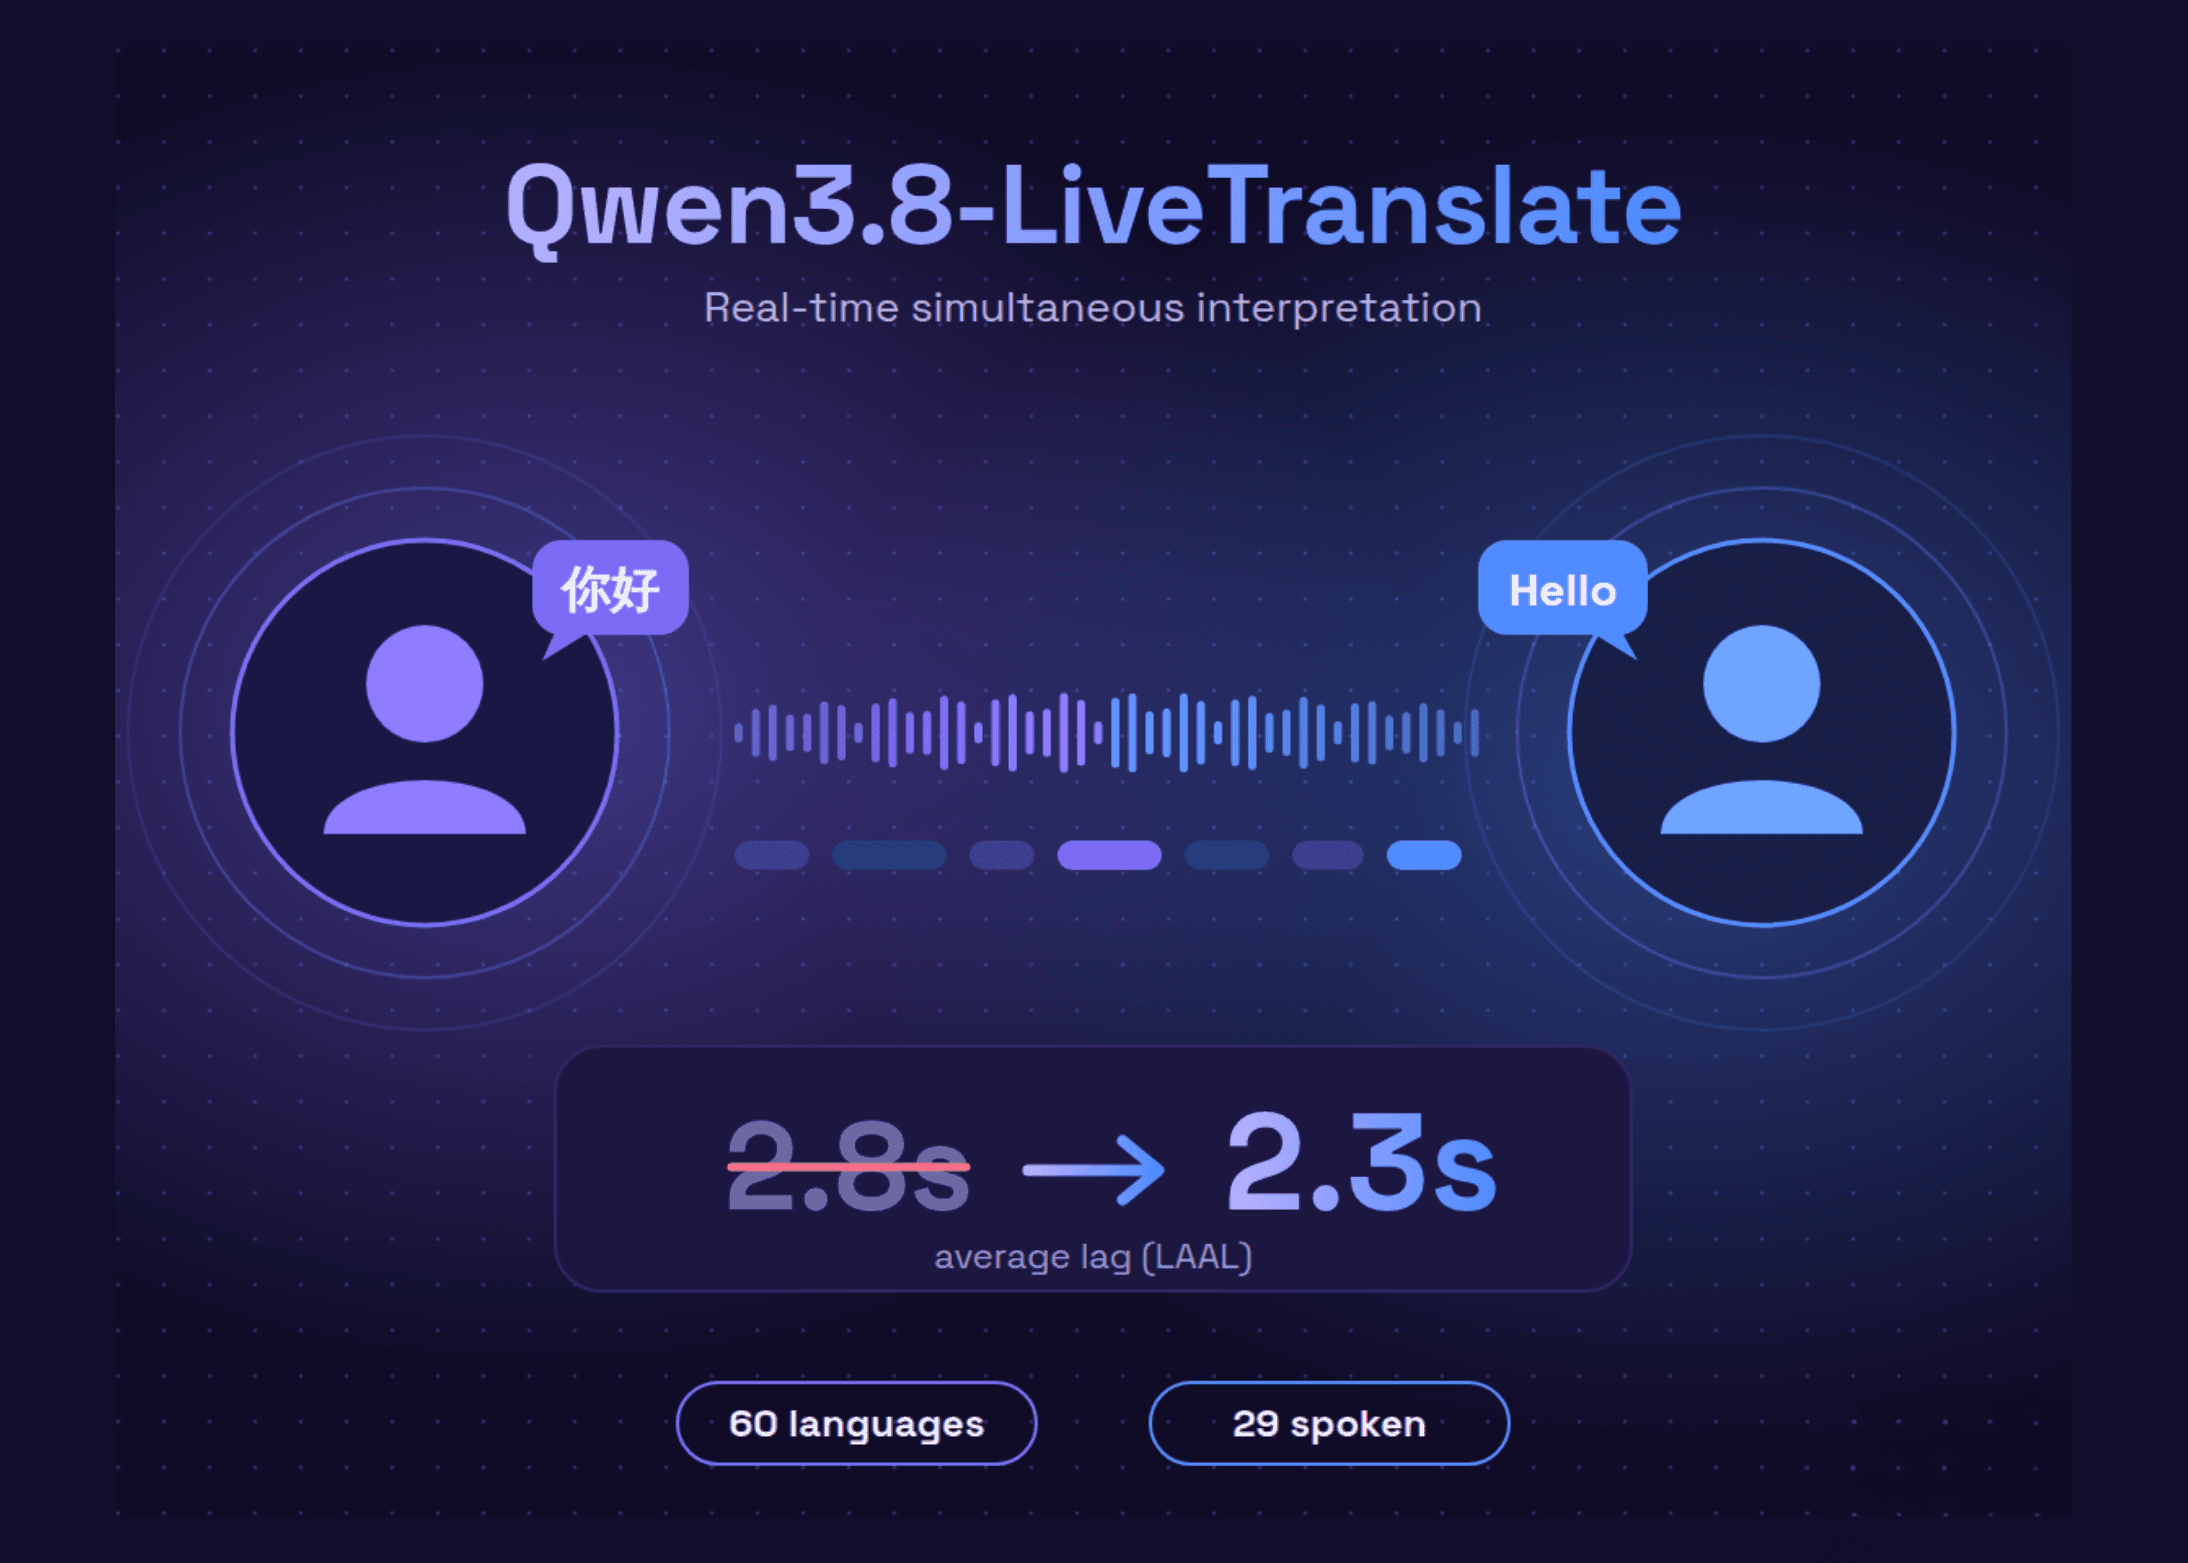
Qwen เปิดตัว Qwen3.8-LiveTranslate โมเดลล่ามแปลภาษาอัจฉริยะรุ่นล่าสุดที่ทำงานแบบเรียลไทม์ โดยสามารถรับข้อมูลได้ทั้งเสียงสดและเฟรมวิดีโอ เพื่อประมวลผลเป็นข้อความและเสียงแปลได้ทันทีในขณะที่ผู้พูดยังพูดไม่จบ
จุดเด่นสำคัญอยู่ที่การเปลี่ยนมาใช้สถาปัตยกรรม Interleave ใหม่ ซึ่งช่วยให้การแปลมีความถูกต้อง ลื่นไหล และกระชับยิ่งขึ้น โดยสามารถลดค่าความหน่วงเฉลี่ย (LAAL) จากเดิม 2.8 วินาที เหลือเพียง 2.3 วินาทีเท่านั้น การ เปิดตัว ครั้งนี้ยังมาพร้อมความสามารถในการแยกแยะผู้พูด การแสดงผลสองภาษาพร้อมกัน และการทำความเข้าใจบริบทที่ยาวเพื่อลดความกำกวมของเนื้อหา
ปัจจุบันโมเดลนี้พร้อมใช้งานแล้วในรูปแบบ API ผ่าน Alibaba Cloud Model Studio และ QwenCloud ภายใต้ชื่อ qwen3.8-livetranslate-flash-realtime โดยเชื่อมต่อผ่านโปรโตคอล WebSocket
เจาะลึกเทคโนโลยีเบื้องหลังความเร็ว
การแปลล่ามฉับพลันมักต้องเลือกระหว่างความแม่นยำและความเร็ว การรอนานขึ้นช่วยให้ AI เข้าใจบริบทได้ดีขึ้น แต่การแปลที่เร็วขึ้นจะช่วยลดช่องว่างในการสื่อสาร ซึ่ง Qwen3.8-LiveTranslate ได้แก้ปัญหานี้ด้วยการใช้สถาปัตยกรรม Interleave ที่จัดลำดับการประมวลผลใหม่
ทางทีมงานใช้ตัวชี้วัด LAAL (Length-Adaptive Average Lagging) เพื่อวัดระยะเวลาที่การแปลตามหลังเสียงต้นฉบับ ซึ่งผลลัพธ์ที่ลดลงเหลือ 2.3 วินาที คิดเป็นการปรับปรุงประสิทธิภาพด้านความเร็วขึ้นถึง 18% โดยโมเดลนี้พัฒนาต่อยอดมาจากสแต็ก Qwen-Omni ที่รองรับข้อมูลต่อเนื่องหลายรูปแบบ (Multimodal)
3 ฟีเจอร์ใหม่เพื่อการสื่อสารที่สมบูรณ์แบบ
- การแยกแยะผู้พูดแบบเรียลไทม์ (Real-time speaker diarization): โมเดลสามารถระบุได้ว่าใครเป็นคนพูดในการสนทนาที่มีหลายคน พร้อมทั้งคงเอกลักษณ์เสียงผ่านระบบจำลองเสียง (Voice Cloning) ที่เสถียร โดยมี โหมดการจำลองเสียง ให้เลือกใช้ตามความเหมาะสมของงาน
- การแสดงผลสองภาษาพร้อมกัน (Synchronized bilingual display): ระบบจะส่งข้อมูลข้อความถอดเสียงต้นฉบับและคำแปลออกมาพร้อมกัน ทำให้ผู้ใช้งานสามารถตรวจสอบความถูกต้องของเนื้อหาได้ทันทีบนหน้าจอ
- การแก้ความกำกวมจากบริบทที่ยาว (Long-context disambiguation): AI จะจดจำประวัติการสนทนาเพื่อใช้แปลชื่อเฉพาะหรือคำศัพท์เทคนิคให้ถูกต้องแม่นยำและสอดคล้องกันตั้งแต่ต้นจนจบการประชุม
รองรับหลากหลายภาษาพร้อมอินพุตภาพ
โมเดลนี้มีความสามารถในการเข้าใจภาษาถึง 60 ภาษา และสามารถโต้ตอบด้วยเสียงได้ 29 ภาษา (ที่เหลือ 31 ภาษาจะแสดงผลเป็นข้อความ) ครอบคลุมภาษาหลักอย่าง จีน อังกฤษ อาหรับ เยอรมัน ฝรั่งเศส สเปน ญี่ปุ่น เกาหลี ฮินดี และอื่นๆ
นอกจากเสียงแล้ว AI ยังรับอินพุตเป็นรูปภาพเพื่อช่วยในการตีความ เช่น การสังเกตริมฝีปาก ท่าทาง หรือข้อความบนสไลด์ประกอบ ซึ่งช่วยเพิ่มความแม่นยำในสภาพแวดล้อมที่มีเสียงรบกวน โดยผู้ใช้งานสามารถตั้งค่าคำสำคัญ (Hotwords) ได้สูงสุด 1,000 คำ เพื่อกำหนดคำแปลเฉพาะเจาะจงที่ต้องการ
รายละเอียด API และราคาค่าบริการ
นักพัฒนาสามารถใช้งานผ่าน WebSocket Realtime API โดยรองรับเสียงมาตรฐาน 16 kHz สำหรับขาเข้า และ 24 kHz สำหรับขาออก พร้อมหน้าต่างบริบท (Context Window) รวม 53,248 โทเค็น
ราคาประมาณการต่อ 1 ล้านโทเค็น (ศูนย์ข้อมูลสิงคโปร์):
- อินพุตเสียง: $7.50
- อินพุตภาพ: $0.55
- เอาต์พุตข้อความ: $20
- เอาต์พุตเสียง: $30
สำหรับการใช้งานรับส่งเสียงต่อเนื่อง 1 ชั่วโมง จะมีค่าใช้จ่ายพื้นฐานประมาณ $1.54 (ไม่รวมโทเค็นข้อความและรูปภาพ) อย่างไรก็ตาม ในขณะนี้โมเดลยังไม่รองรับฟีเจอร์บางอย่าง เช่น Function Calling หรือการปรับแต่งโมเดล (Fine-tuning)
สรุปประเด็นสำคัญ
- ลดความหน่วงในการแปลเหลือ 2.3 วินาที เร็วขึ้นกว่าเดิม 18%
- สถาปัตยกรรม Interleave ช่วยให้การแปลลื่นไหลและแม่นยำขึ้น
- รองรับ 60 ภาษาทั่วโลก และสามารถระบุตัวตนผู้พูดได้แบบเรียลไทม์
- เปิดให้ใช้งานผ่าน API บน Alibaba Cloud Model Studio และ QwenCloud แล้ว
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร