
เปิดตัว Apertus 1.5 โมเดล Open-Source มัลติโมดัลขีดความสามารถสูง
การเปิดตัวล่าสุดของเรา Apertus 1.5 ได้ขยายขีดความสามารถของโมเดล Apertus 1.0 รุ่น 8B และ 70B ด้วยความเข้าใจภาพ/เสียง, โหมดการคิด (thinking mode) ที่เลือกใช้ได้, หน้าต่างบริบทที่ยาวขึ้นสี่เท่า, การปฏิบัติตามคำสั่งที่ดียิ่งขึ้น และการใช้เครื่องมือที่ดีกว่าเดิม
น้ำหนักโมเดล (weights) รุ่น 8B และ 70B ที่ได้รับการอัปเดตได้ถูกปล่อยบน Hugging Face เมื่อวันที่ 24 กรกฎาคม 2026 ภายใต้ใบอนุญาต Apache 2.0 โดยสามารถอ่านรายละเอียดเพิ่มเติมได้จาก Technical Report ของโครงการ
Apertus 1.5 พัฒนาต่อยอด (continued pretraining) จากโมเดลรุ่นแรก โดยเพิ่มข้อมูลข้อความและข้อมูลการฝึกฝนแบบ multimodal จำนวน 4 ล้านล้านโทเค็นให้กับโมเดล 8B และ 2 ล้านล้านโทเค็นให้กับโมเดล 70B รวมเป็น 19T และ 17T ตามลำดับ
เช่นเดียวกับ Apertus ทุกรุ่น โมเดลเหล่านี้เป็นแบบเปิดทั้งหมด: เปิด weights, เปิด data, เปิด values และรายละเอียดการฝึกฝนฉบับเต็ม details
การปรับปรุงที่สำคัญ
- Native Multimodal Understanding: รองรับภาพและเสียงควบคู่ไปกับข้อความ สามารถนำเอกสาร แผนภูมิ และรูปภาพมาใช้ในการสนทนาได้ รวมถึงประมวลผลภาษาพูดได้ (ยังอยู่ในขั้นทดลอง)
- Thinking Mode: โมเดลสลับเข้าสู่โหมดการคิดเพื่อใช้เหตุผลเกี่ยวกับข้อมูลนำเข้าก่อนตอบคำถาม ช่วยเพิ่มประสิทธิภาพในปัญหาด้านการใช้เหตุผล
- Long Context: หน้าต่างบริบทเพิ่มขึ้นเป็น 262,144 โทเค็น หรือเพิ่มขึ้น 4 เท่าเมื่อเทียบกับ Apertus 1.0
- Improved Instruction-Following: ปฏิบัติตามคำสั่งได้แม่นยำและคาดเดาผลลัพธ์ได้ดีขึ้น
- Improved Tool Use: ฝึกฝนการรวมเครื่องมือให้มีประสิทธิภาพมากขึ้น ช่วยในการเรียกใช้ API ภายนอก
- Open Values: ยึดมั่นต่อ Apertus Charter อย่างเข้มแข็ง เพื่อสร้างความโปร่งใสในค่านิยมและหลักการของโมเดล
กระบวนการฝึกฝน
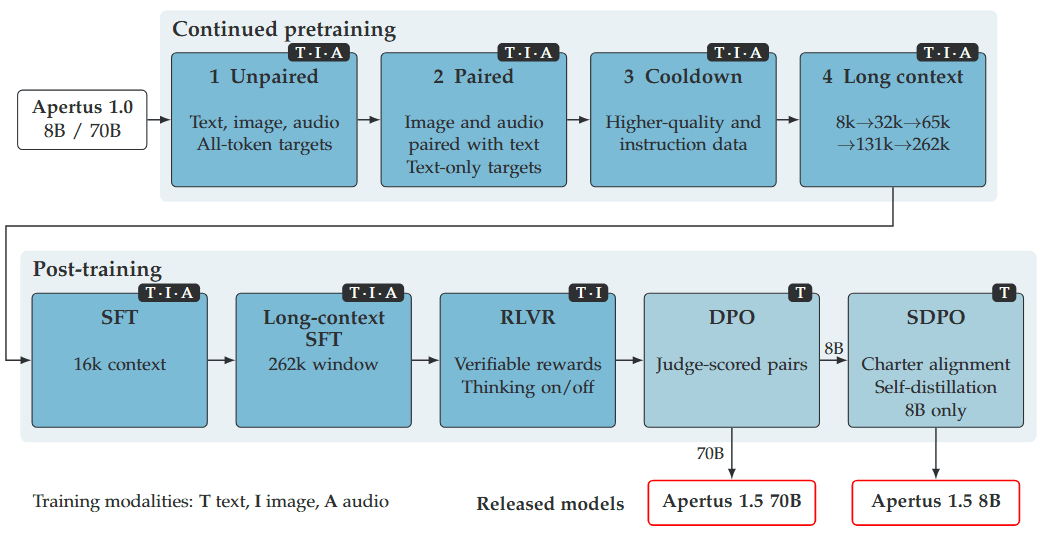
กระบวนการฝึกฝน Apertus 1.5 ฉบับเต็ม
ความเป็น Multimodal ผ่าน Tokenizer
เราใช้เทคนิค early-fusion ในรุ่น v1.5 โดยข้อมูลภาพและเสียงจะเข้าสู่โมเดลในฐานะโทเค็นแยกส่วนในลำดับเดียวกับข้อความ แทนที่จะใช้ vision encoder แยกต่างหาก รูปภาพจะถูกแปลงเป็นโทเค็นด้วย Emu3.5 tokenizer (ภาพ 512×512 กลายเป็น 1,024 โทเค็น) และเสียงด้วย WavTokenizer (40 โทเค็นต่อวินาที) สถาปัตยกรรมหลักจึงไม่มีการเปลี่ยนแปลง และฝึกฝนได้รวดเร็วระดับเดียวกับข้อความล้วน
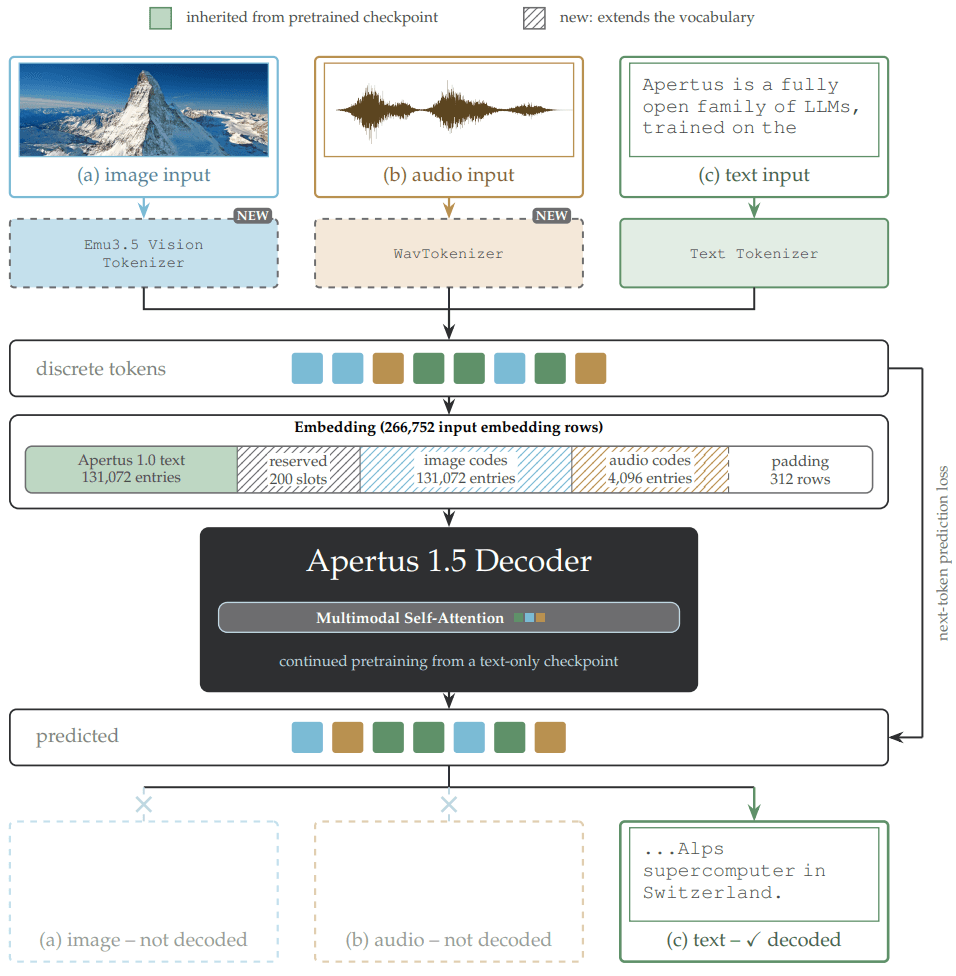
Pre-Training
เราทำ continued pretraining จาก Apertus 1.0 ในสี่ขั้นตอน:
- Unpaired: ข้อความบวกกับภาพและเสียงแบบเดี่ยวเพื่อให้เรียนรู้รูปแบบข้อมูลใหม่
- Paired: คู่ภาพ-คำบรรยาย และคู่เสียง-การถอดความ เพื่อเชื่อมโยงข้อมูลกับภาษา
- Cooldown: เพิ่มข้อมูลคุณภาพสูงด้านคณิตศาสตร์และโค้ด
- Long context: ขยายหน้าต่างบริบททีละขั้นจาก 8k เป็น 262k โทเค็น
โทเค็นการฝึกฝนมากกว่าครึ่งเป็นข้อความล้วนเพื่อรักษาความสามารถเดิมไว้ โดยใช้แหล่งข้อมูลคุณภาพสูง เช่น FineWeb2-HQ+ ข้อมูลทั้งหมดเปิดเผยต่อสาธารณะและระบุไว้ใน apertus-data-transparency
Post-Training
กระบวนการ Post-training แบ่งเป็น 5 ขั้นตอน: SFT → long-context SFT → RL → DPO → charter alignment (SDPO)
การทำ SFT ใช้ตัวอย่างข้อความ 3.7 ล้านตัวอย่างพร้อมข้อมูลมัลติโมดัล โดยมีการเพิ่ม Reasoning traces ในโจทย์ที่ยาก ส่วนการทำ RLVR ครอบคลุมพรอมต์ด้านคณิตศาสตร์และโค้ด 350k รายการ ปิดท้ายด้วย SDPO เพื่อปรับโมเดลให้สอดคล้องกับ Apertus Charter
ผลการประเมิน
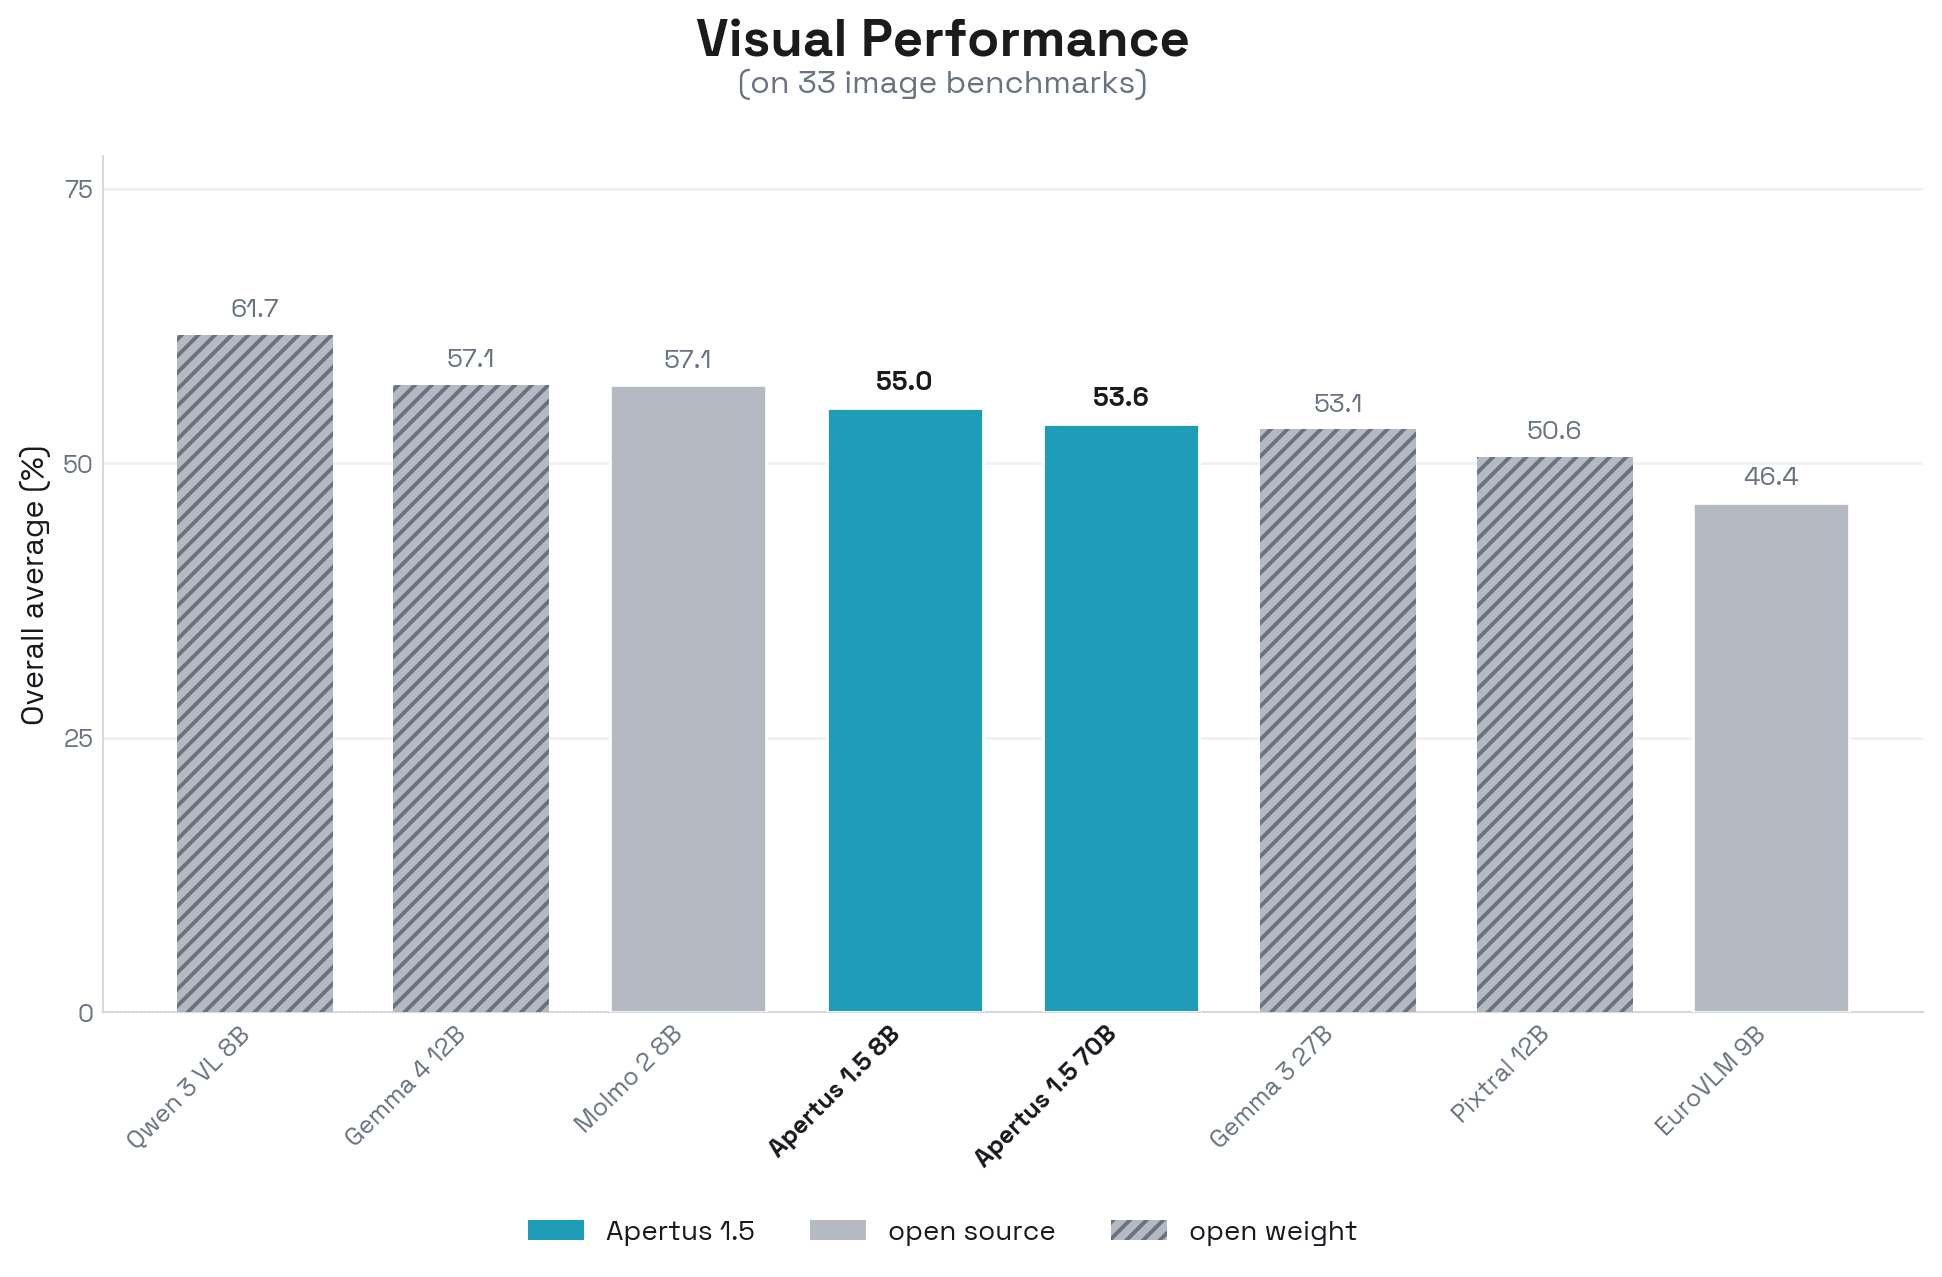
เราขยายขอบเขตการประเมินให้ครอบคลุมทั้งมัลติโมดัลและโหมดการคิด ผ่านไปป์ไลน์ MLLM-eval-suite ซึ่งรวมเกณฑ์มาตรฐานจากหลายแห่งเข้าด้วยกัน
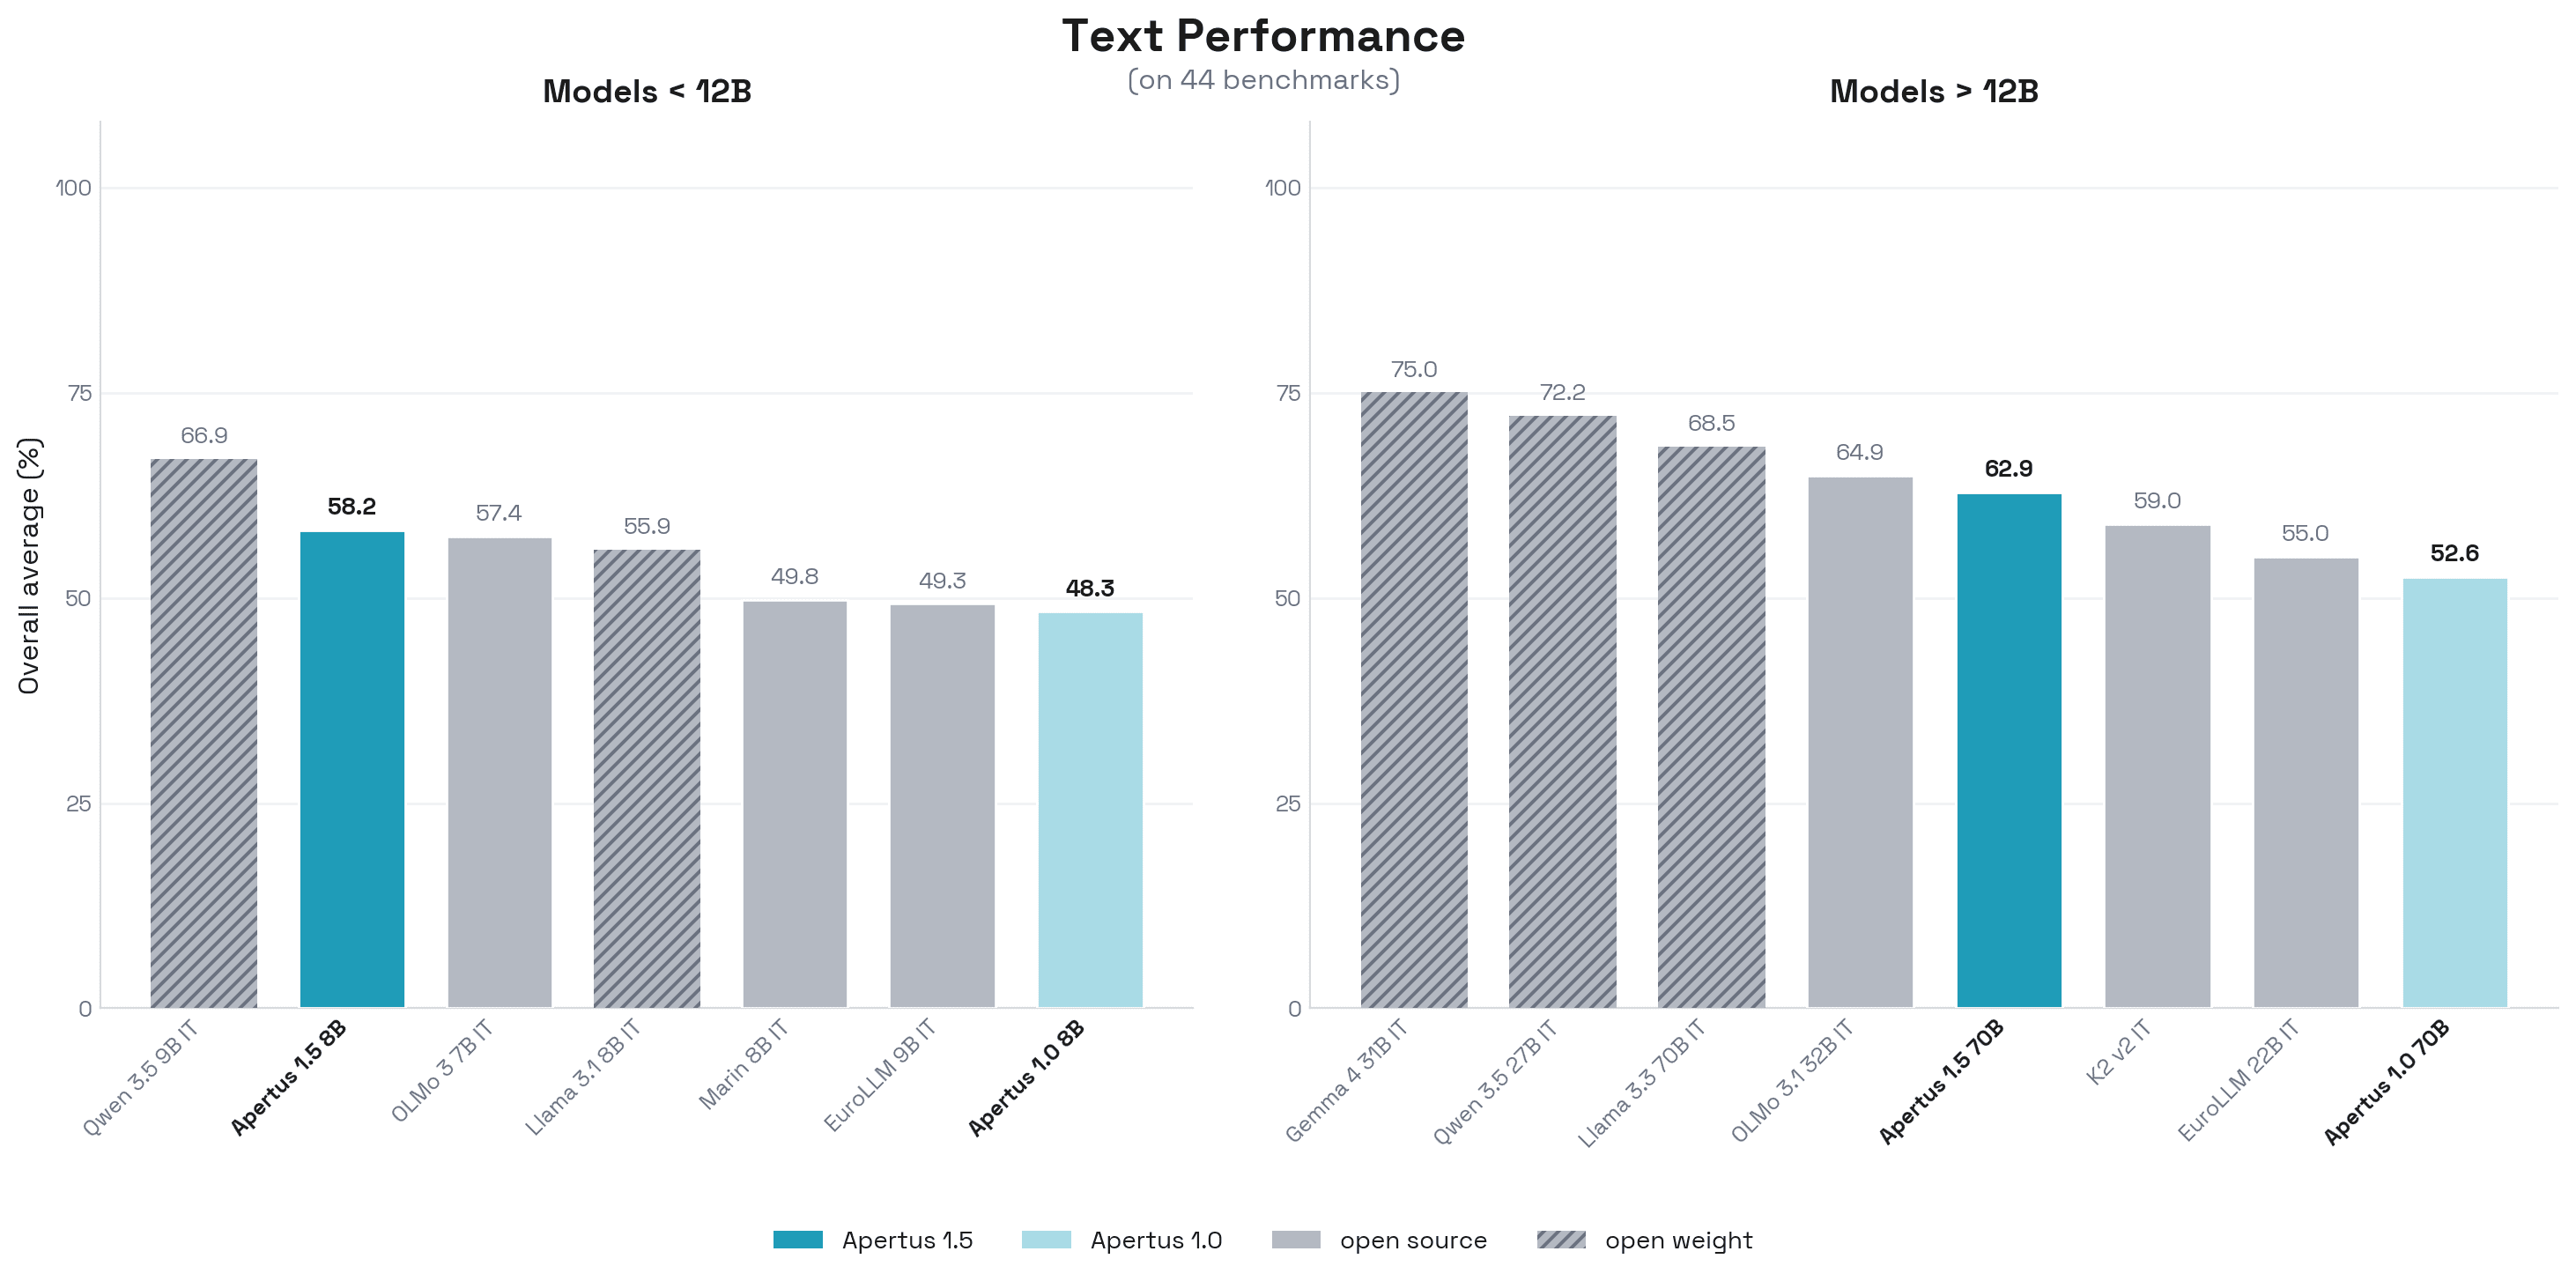
Apertus 1.5 8B มีประสิทธิภาพเหนือกว่าโมเดล open-weight ขนาดเดียวกันในงานด้านภาษาและการปฏิบัติตามคำสั่ง ส่วนด้านมัลติโมดัลมีความสามารถใกล้เคียงกับ Gemma 4 12B และยังทำคะแนนได้ดีเยี่ยมในงานด้านกฎหมายสวิส (Swiss Legal tasks) รวมถึงการแปลภาษาที่เทียบเท่ากับโมเดลขนาดใหญ่อย่าง GPT-OSS-20B
บัตรการประเมิน: Apertus ❤️ EvalEval
เราจับมือกับ EvalEval Coalition เพื่อความโปร่งใสในการวัดผล โดยเผยแพร่ผลในรูปแบบ Every Eval Ever (EEE) ที่บันทึกทั้งคะแนนและวิธีการรันอย่างละเอียด ข้อมูลเหล่านี้ยังสอดคล้องกับข้อกำหนดการกำกับดูแล AI เช่น EU AI Act ช่วยให้หน่วยงานกำกับดูแลและนักวิจัยตรวจสอบหลักฐานเบื้องหลังโมเดลได้ง่ายขึ้น
การทำซ้ำของ Apertus 1.5
สูตรการสร้างและข้อมูลทั้งหมดถูกบันทึกไว้ใน Technical Report และโฮสต์ไว้ที่ Apertus 1.5 Hugging Face collection เพื่อให้นักวิจัยสามารถตรวจสอบและพัฒนาต่อยอดได้
| โมเดล | 8B | 70B |
|---|---|---|
| Pre-training | Apertus-v1.5-8B-base | Apertus-v1.5-70B-base |
| DPO | Apertus-v1.5-8B-DPO | Apertus-v1.5-70B (สุดท้าย) |
| SDPO | Apertus-v1.5-8B (สุดท้าย) | - |
ความพร้อมใช้งานของโมเดล
ปัจจุบัน Apertus 1.5 ถูกรวมเข้ากับแอปพลิเคชันอย่าง Proton Lumo และ Infomaniak Euria เรียบร้อยแล้ว นอกจากนี้ยังมีให้บริการในรูปแบบ API ผ่านผู้ให้บริการชั้นนำ เช่น Swisscom และ Infomaniak
วิธีการมีส่วนร่วม
เราเพิ่งฉลองยอดดาวน์โหลดครบ 5 ล้านครั้งบน Hugging Face และกำลังเดินหน้าแผนงานสำหรับ Apertus 2.0 ซึ่งจะเป็นสถาปัตยกรรม MoE ขนาด 600B ที่เน้นด้านเอเจนต์และทักษะขั้นสูง หากคุณใช้งาน Apertus สามารถร่วมแชร์ผลงานได้ผ่าน Showcase form
การอ้างอิง
Project Apertus, et al. “Apertus 1.5: From Open Text Models to Open Multimodal Reasoners.” arXiv:2610.15542. Preprint, arXiv, October 11, 2026. https://doi.org/10.48550/arXiv.2610.15542.
@misc{apertus2026apertus15opentext,
      title={Apertus 1.5: From Open Text Models to Open Multimodal Reasoners},
      author={Project Apertus and Yixuan Xu and others},
      year={2026},
      eprint={2610.15542},
      archivePrefix={arXiv},
      primaryClass={cs.CL},
      url={https://arxiv.org/abs/2610.15542},
}ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร