
NVIDIA เปิดตัวฮาร์ดแวร์ AI ท้องถิ่น ขับเคลื่อน Agent ยุคใหม่
ในงาน GTC Berlin ทาง NVIDIA ได้จัดแสดงไลน์อัปฮาร์ดแวร์ AI ระดับท้องถิ่นแบบครบวงจร โดยมี RTX Spark ที่ เปิดตัวเมื่อสัปดาห์ที่แล้ว เป็นขุมพลังหลักให้กับ personal agent บน Windows PC
นอกจากนี้ยังมี DGX Spark ที่ออกแบบมาเพื่อสนับสนุนนักพัฒนาในการสร้างและขยายขนาดแอปพลิเคชันบน Linux และ DGX Station สำหรับทีมระดับองค์กรที่รันเวิร์กโหลดระดับแนวหน้าบน Linux โดยจะมีเวอร์ชัน Windows ตามมาในเดือนธันวาคมนี้
การประกาศสำคัญในครั้งนี้ประกอบด้วย:
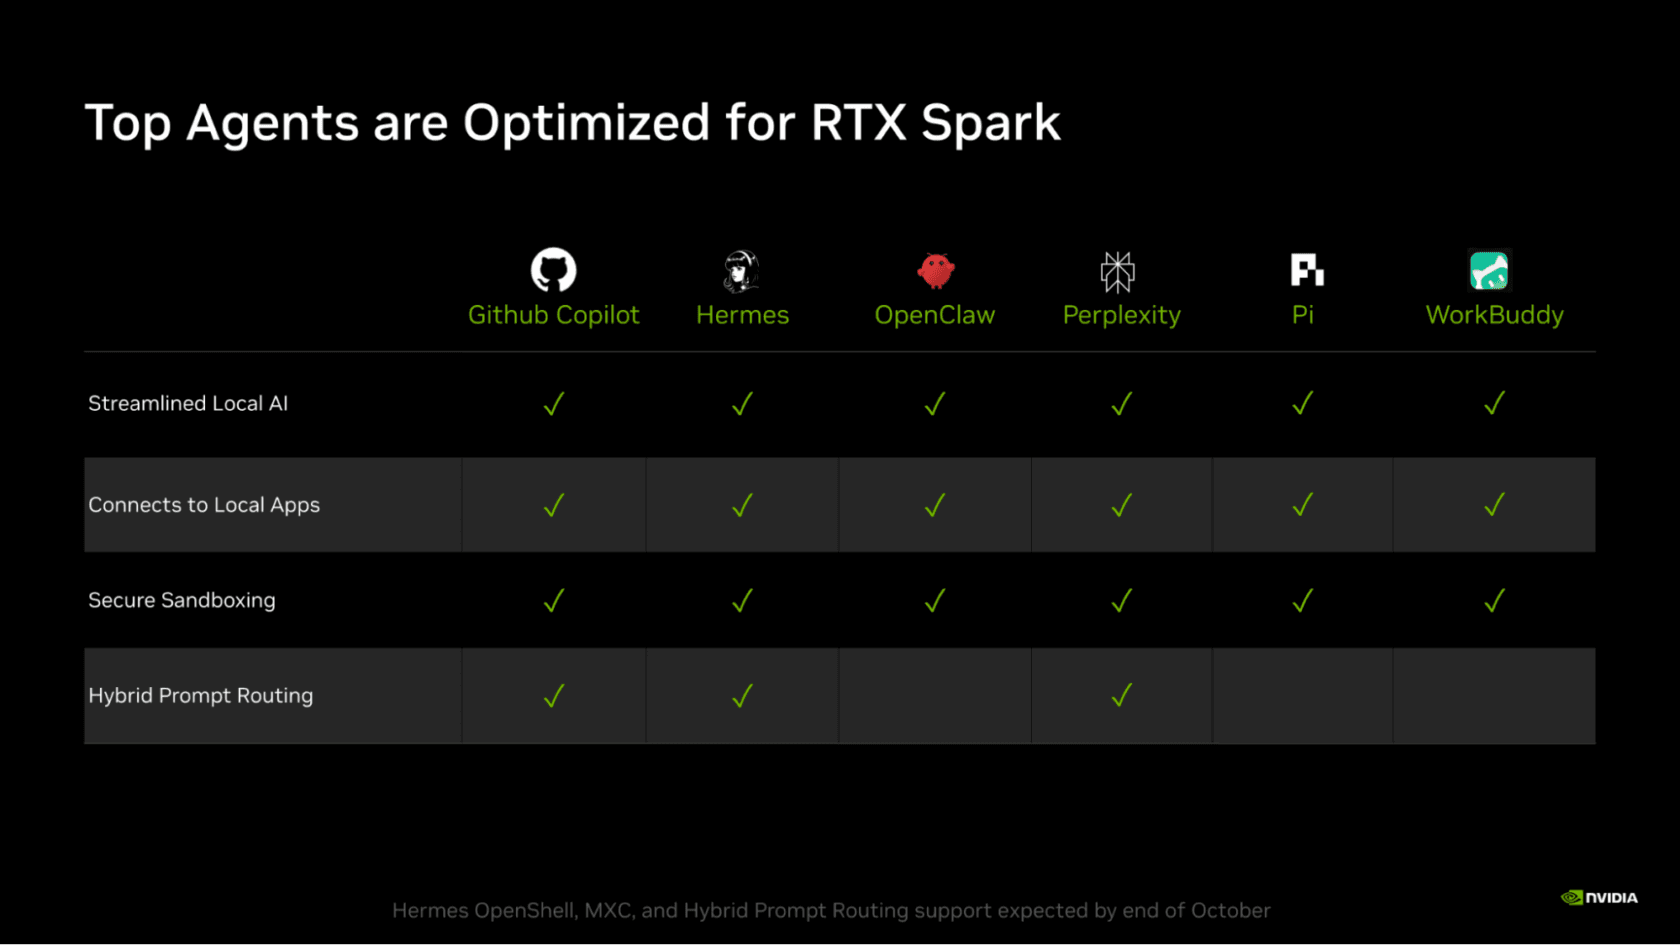
- Underdog Desktop Agent พร้อมใช้งานแล้วสำหรับ RTX Spark
- DGX Spark 64GB เริ่มจำหน่ายในวันศุกร์ที่ 23 ต.ค.
- NVIDIA Sync รองรับ DGX Spark แปดเครื่อง และเพิ่ม Model Launcher ในเดือนนี้
- อัปเดตซอฟต์แวร์ DGX Spark เดือนตุลาคม เพิ่ม Wi-Fi Assistant และอัปเดต DGX Spark Skills
- DGX Station เพิ่มความสามารถการจัดการด้วยการผสานรวมใหม่ 7 รายการ
- DGX Station สำหรับ Windows จะเปิดตัวในเดือนธันวาคม รองรับแอปพลิเคชันและ agent harness จำนวนมาก
- เวิร์กโฟลว์อ้างอิงแบบ open source ใหม่ 3 รายการสำหรับหุ่นยนต์บน DGX Station
- NVIDIA Cloud Functions เตรียมเปิดให้เข้าถึงแบบ early access บน DGX Station
- Recursive Flint โมเดลเขียนโค้ดระดับท้องถิ่นตัวใหม่ พร้อมใช้งานบนฮาร์ดแวร์ NVIDIA
- รองรับแบบ Day-0 สำหรับโมเดล AI ใหม่ อาทิ Nemotron, GLM, DeepSeek, Qwen, MiniMax และ FLUX.3
- เร่งความเร็วเอนจินการทำ inference อย่าง llama.cpp และ vLLM พร้อมคอลเลกชัน checkpoint ใหม่
ผู้ที่สนใจสามารถศึกษาข้อมูลเพิ่มเติมเกี่ยวกับ AI ระดับท้องถิ่นเหล่านี้ได้จากเดโมและ เซสชันต่างๆ ที่ GTC Berlin หรือ อ่านประกาศทั้งหมดของ NVIDIA ในยุโรป
RTX Spark นำ Personal Agent มาสู่ Windows PC
RTX Spark คือจุดเริ่มต้นใหม่ของ PC ที่สามารถรัน personal agent, เร่งความเร็วการสร้างสรรค์ และเล่นเกมระดับ 1440p ที่ 100 FPS ด้วยหน่วยความจำแบบ unified สูงสุด 128GB และพลังประมวลผล AI ระดับ 1 petaflop
เหล่านักวิจารณ์ได้ให้ความเห็นหลังจากเปิดตัวเมื่อวันที่ 16 ตุลาคม ดังนี้:
“เครื่องจักรในฝันสำหรับนักสร้างสรรค์ตัวจริง…” - CGMag
“ออกแบบมาเพื่ออนาคตของ AI…” - The Verge
“มีความสามารถสูง พกพาสะดวก และทรงประสิทธิภาพ…” - PCMag
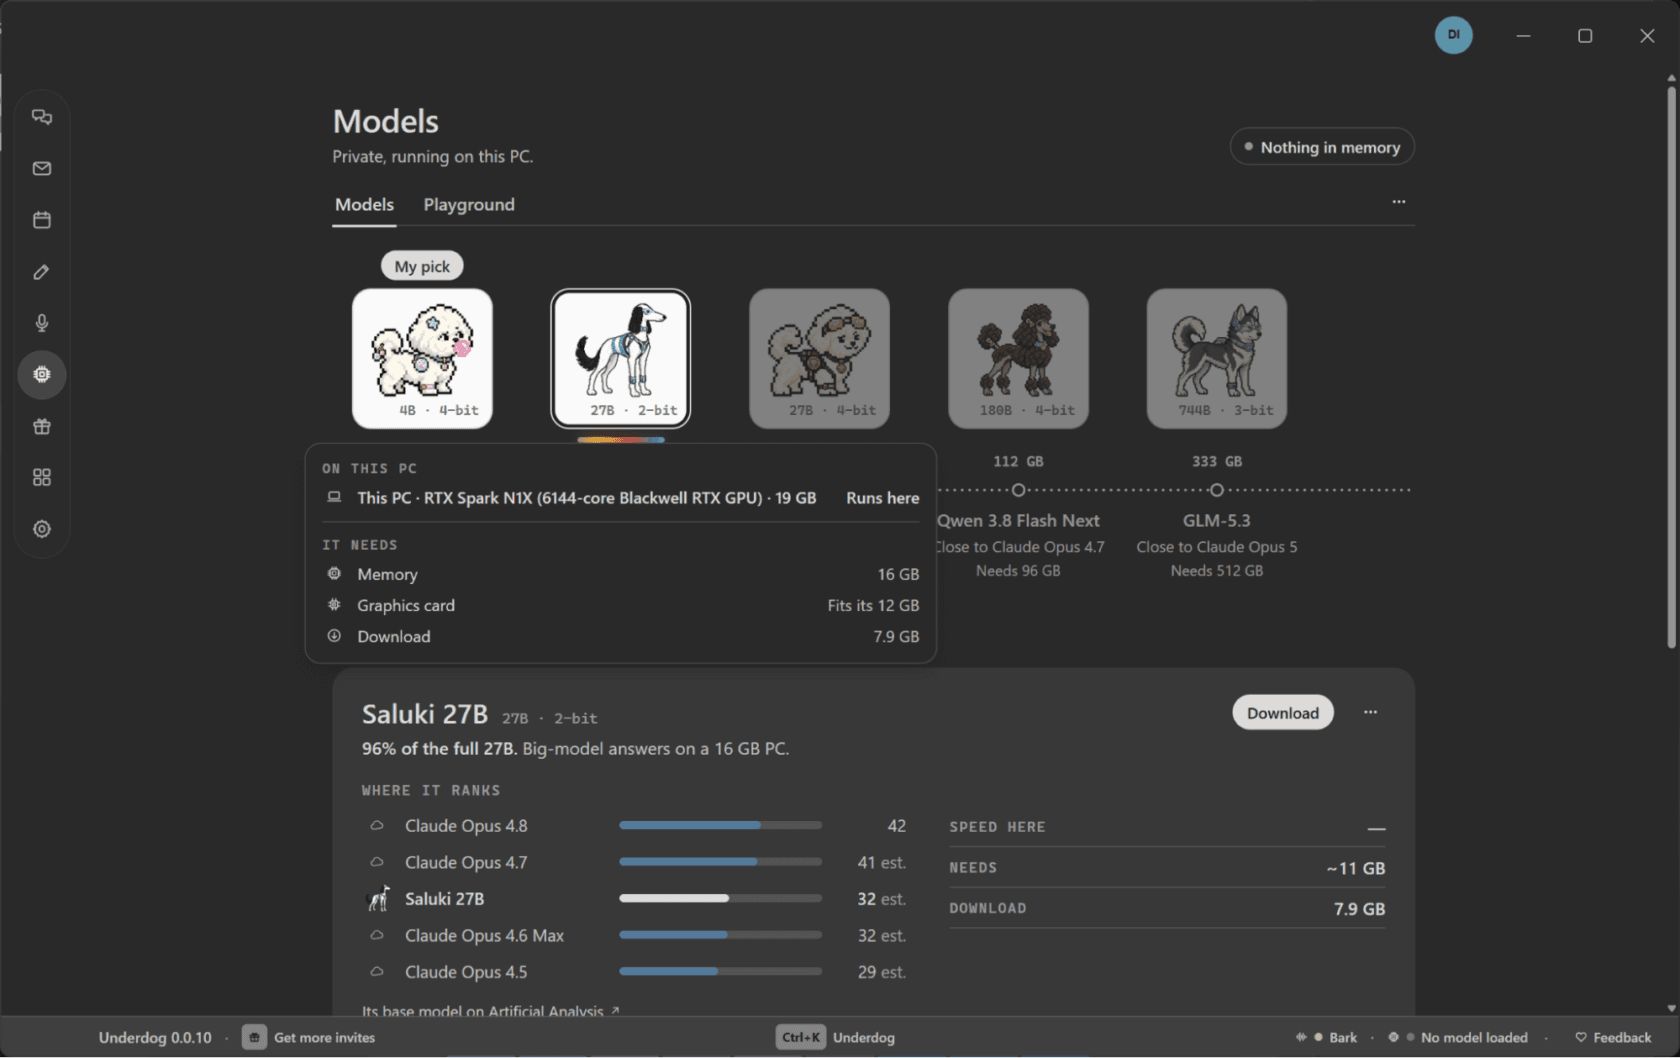
Underdog แอป desktop agent ตัวใหม่ที่เน้นความเป็นส่วนตัว ขับเคลื่อนด้วยเอนจิน Husky ช่วยให้รันโมเดลบนอุปกรณ์ได้ทั้งหมดโดยข้อมูลไม่หลุดออกจาก PC พร้อมให้ ดาวน์โหลด แล้ววันนี้
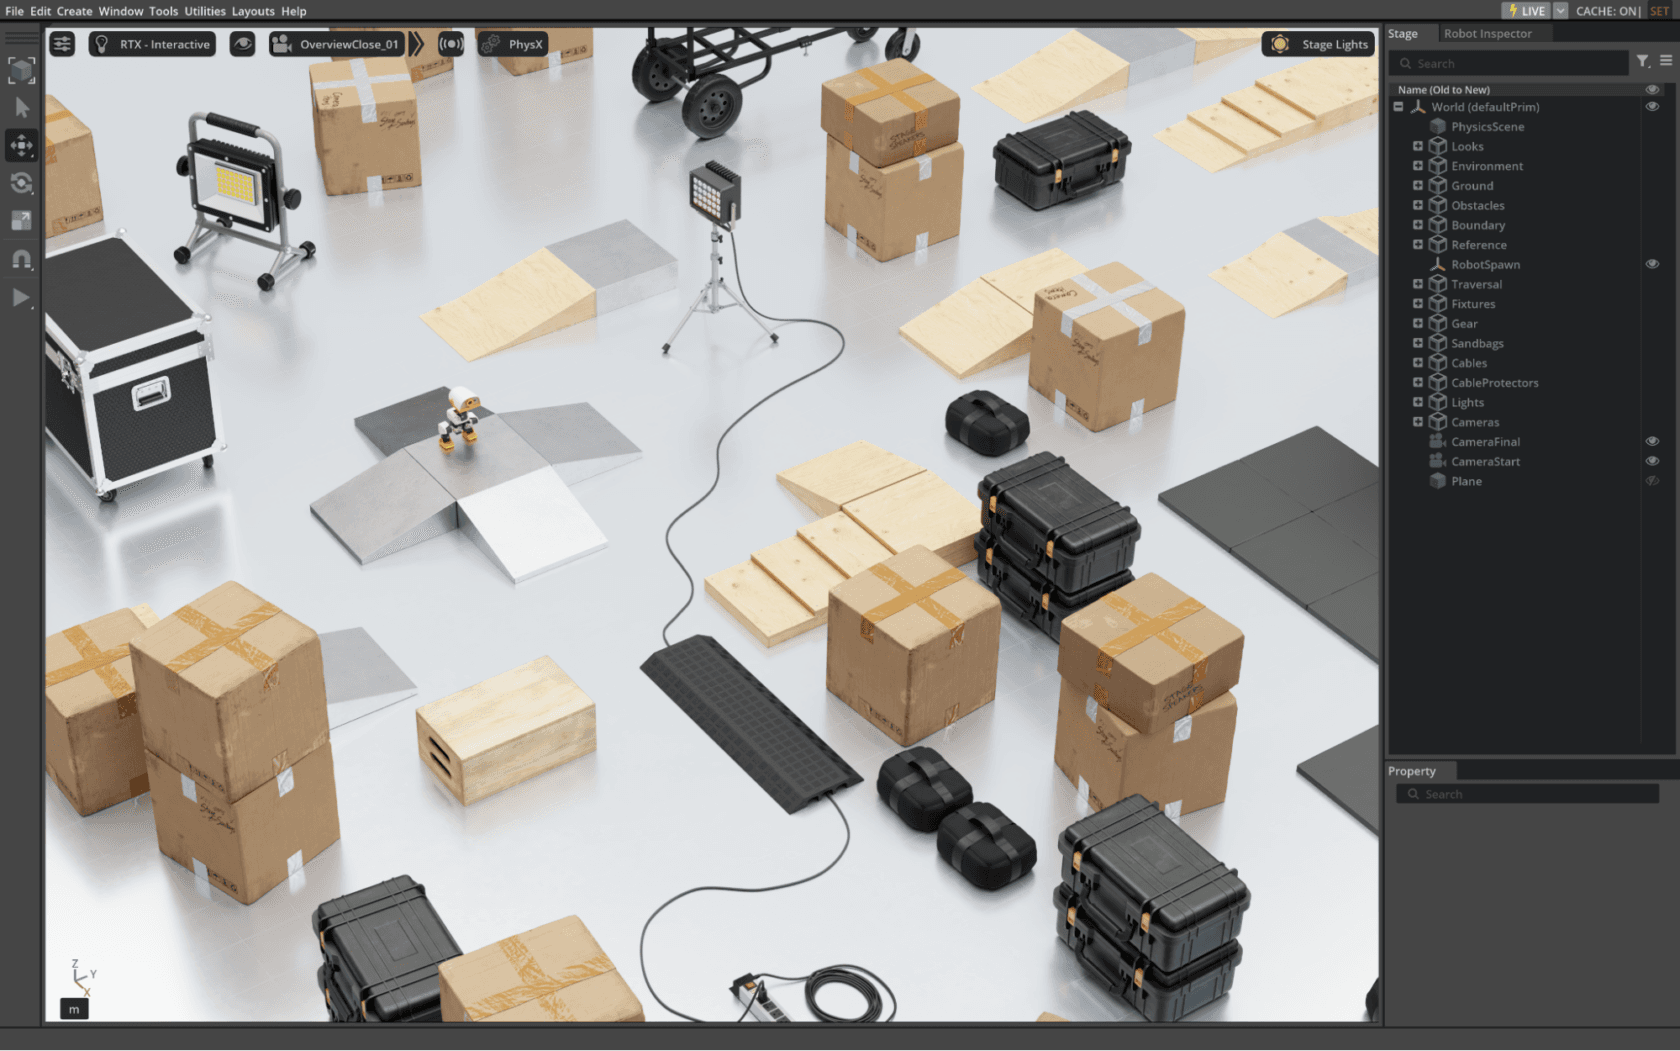
เพื่อให้นักพัฒนาสร้าง agent ระดับท้องถิ่นได้ดียิ่งขึ้น แล็ปท็อป RTX Spark หลายรุ่นจึงมาพร้อมกับ bootloader ที่ปลดล็อกแล้ว โดย Jensen Huang ได้สาธิตการใช้ AI agent บนเครื่องเพื่อฝึกฝน หุ่นยนต์ Microduck ของ Hugging Face ผ่าน NVIDIA Isaac Lab
ปัจจุบันแล็ปท็อปจาก ASUS, Dell Technologies, HP, Lenovo, Microsoft และ MSI พร้อมวางจำหน่ายแล้ว ส่วน Acer จะตามมาในเร็วๆ นี้ ผู้ใช้สามารถเริ่มต้นได้ผ่าน RTX Spark playbooks
DGX Spark ให้พื้นที่นักพัฒนาในการสร้างสรรค์
ระบบ DGX Spark 64GB รุ่นใหม่ที่รองรับโมเดลอย่าง Nemotron 3.5 Bolt และ Gemma 4 จะเริ่มทยอยส่งมอบในวันศุกร์ที่ 23 ต.ค. โดยสามารถเชื่อมต่อหลายระบบเข้าด้วยกันผ่านเครือข่าย NVIDIA ConnectX-7 และ NVIDIA Sync Cluster Assistant
ปัจจุบัน DGX Spark รองรับคลัสเตอร์สูงสุด 8 หน่วย ให้หน่วยความจำ unified ขนาด 1TB ซึ่งเพียงพอต่อการรันโมเดลระดับ frontier อย่าง GLM 5.3 นักพัฒนาสามารถศึกษาขั้นตอนได้จาก DGX Spark cluster playbook
ช่วงปลายเดือนนี้ NVIDIA Sync Model Launcher จะเปิดใช้งานเพื่อช่วยให้การดาวน์โหลดโมเดลและคอนเทนเนอร์ทำได้ง่ายขึ้นเพียงไม่กี่คลิก พร้อมโหลด DGX Spark Skills สำหรับการแก้ไขปัญหาและบำรุงรักษาอุปกรณ์โดยอัตโนมัติผ่าน OpenCode
การอัปเดตเดือนตุลาคมยังเพิ่ม Wi-Fi Assistant สำหรับโหมด appliance และปรับปรุงการให้คำแนะนำที่เน้นเวิร์กโฟลว์ โดยระบบ DGX Spark มีจำหน่ายผ่านพันธมิตรอย่าง Acer, ASUS, Dell, GIGABYTE, HP, Lenovo, MSI และ NVIDIA
DGX Station วางขุมพลัง Frontier Intelligence ไว้บนโต๊ะทำงาน
สำหรับทีมขนาดใหญ่ DGX Station มาพร้อมหน่วยความจำ coherent 748GB และประสิทธิภาพ AI 20 petaflops รองรับผู้ใช้พร้อมกันกว่า 30 ราย และสามารถขยายการเชื่อมต่อระหว่างระบบ Linux ได้ง่ายขึ้นผ่าน NVIDIA Sync
ความร่วมมือกับพันธมิตรอย่าง Splunk, Microsoft Intune และ Tanium ช่วยให้ทีม IT จัดการระบบได้ตามมาตรฐานองค์กร ลดระยะเวลาไปสู่ token แรก (time to first token) และเพิ่มความปลอดภัยในการติดตั้งใช้งาน
DGX Station สำหรับ Windows จะเริ่มส่งมอบในเดือนธันวาคม ช่วยให้นักพัฒนาทำงานบนซอฟต์แวร์ Windows-native ร่วมกับ NVIDIA RTX PRO GPU และโมเดลภาษาขนาดใหญ่บนระบบเดียวกันได้ทันที
ระบบจะรองรับแอปพลิเคชันระดับมืออาชีพจาก Siemens, Dassault Systèmes และอื่นๆ โดยผู้ใช้สามารถรัน agent ภายในองค์กรผ่าน Hermes Agent หรือ Perplexity เพื่อการควบคุมแบบ agentic ที่สมบูรณ์แบบ
ในด้านหุ่นยนต์ NVIDIA ได้เปิดตัว เวิร์กโฟลว์อ้างอิง open source 3 รายการ ที่นำ GPT-6 Astra และ Cosmos มาสู่ DGX Station ช่วยให้นักพัฒนาปรับแต่งโมเดล GR00T 1.7 และฝึกทักษะการจัดการหุ่นยนต์ได้รวดเร็วยิ่งขึ้น
NVIDIA Cloud Functions กำลังจะเปิด early access บน DGX Station (Linux) ช่วยให้ทีมสามารถเข้าถึง endpoint ของโมเดลท้องถิ่นผ่านจุดใช้งานเดียวที่รองรับ OpenAI ทำให้ DGX Station กลายเป็นบริการ inference ส่วนตัวของทีม
นอกจากนี้ยังมีการพรีวิว DSX OS สำหรับจำลองโรงงาน AI ก่อนการติดตั้งจริง โดยระบบพร้อมส่งมอบแล้วจากพันธมิตรหลายราย อาทิ Dell Technologies, GIGABYTE และ Exxact
ขอแนะนำ Recursive Flint: โมเดลเขียนโค้ดระดับท้องถิ่นตัวใหม่ที่ปรับแต่งมาสำหรับ RTX Spark
Recursive Superintelligence เปิดตัว Recursive Flint โมเดล mixture-of-experts ขนาด 4 หมื่นล้านพารามิเตอร์ ออกแบบมาเพื่อการเขียนโค้ดที่รวดเร็วบน RTX Spark โดยทำความเร็วได้กว่า 220 token ต่อวินาที
โมเดลนี้สร้างขึ้นด้วย Eureka Machine ช่วยให้การวิจัย AI เป็นไปอย่างอัตโนมัติ และเพิ่มความเร็วการสร้างข้อมูลขึ้น 55% โดยนักพัฒนาสามารถ ดาวน์โหลด open weights ภายใต้ลิขสิทธิ์ Apache 2.0 ได้แล้ว
นอกจากนี้ยังรองรับการทำ post-train ผ่าน NeMo Automodel และการปรับแต่งด้วยเทคนิคอย่าง LoRa หรือ NeMo RL
โมเดลใหม่พร้อมการรองรับแบบ Day-Zero
NVIDIA เพิ่มการรองรับแบบ Day-Zero ให้กับหลายโมเดล เช่น Nemotron Bolt E4B, GLM, DeepSeek และ FLUX.3 โดยโมเดล Bolt E4B ขนาด 4GB จะปล่อยในวันที่ 23 ต.ค. นี้ เพื่อขับเคลื่อน voice assistant และตัวละครในเกม
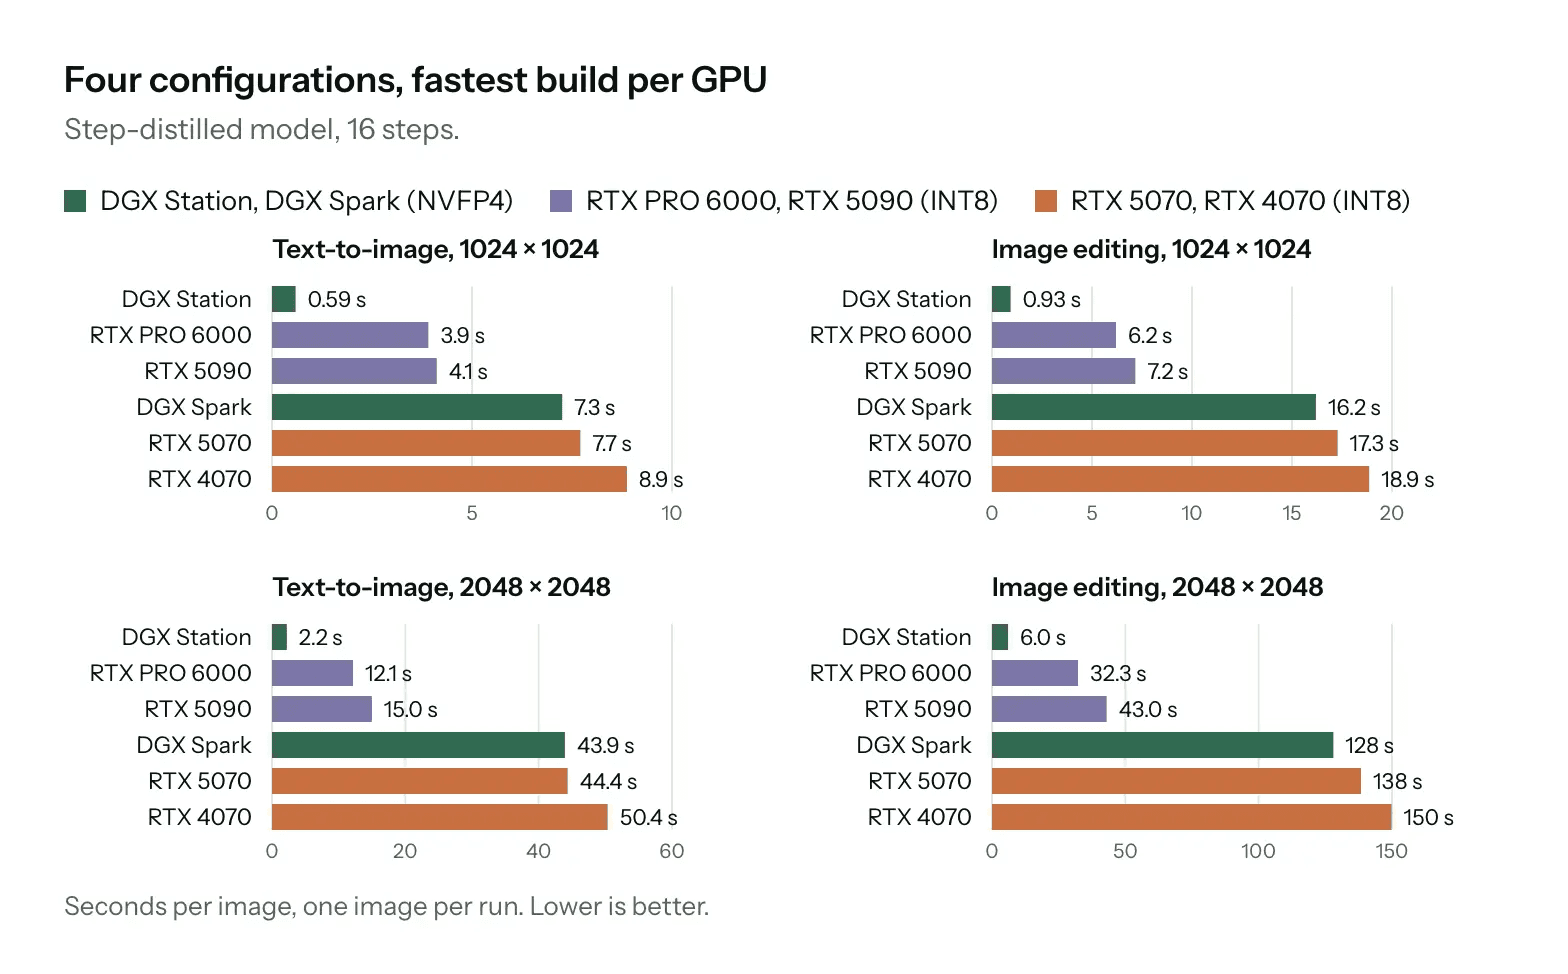
สำหรับ FLUX 3 Image Klein ของ Black Forest Labs ที่ปรับแต่งโดย NVIDIA สามารถรันบน GPU VRAM 8GB และสร้างภาพ 1MP ได้ใน 4 วินาทีบน RTX 5090
โมเดลอื่นๆ อย่าง MiniMax M3.1 Flash และ LFM2.5-24B-A2B ก็พร้อมรันบน DGX Station และ PC เช่นกัน นอกจากนี้ยังมี คอลเลกชัน model checkpoints ที่ปรับแต่ง quantization มาเพื่อประหยัด RAM โดยเฉพาะ
การเร่งความเร็ว AI Inference
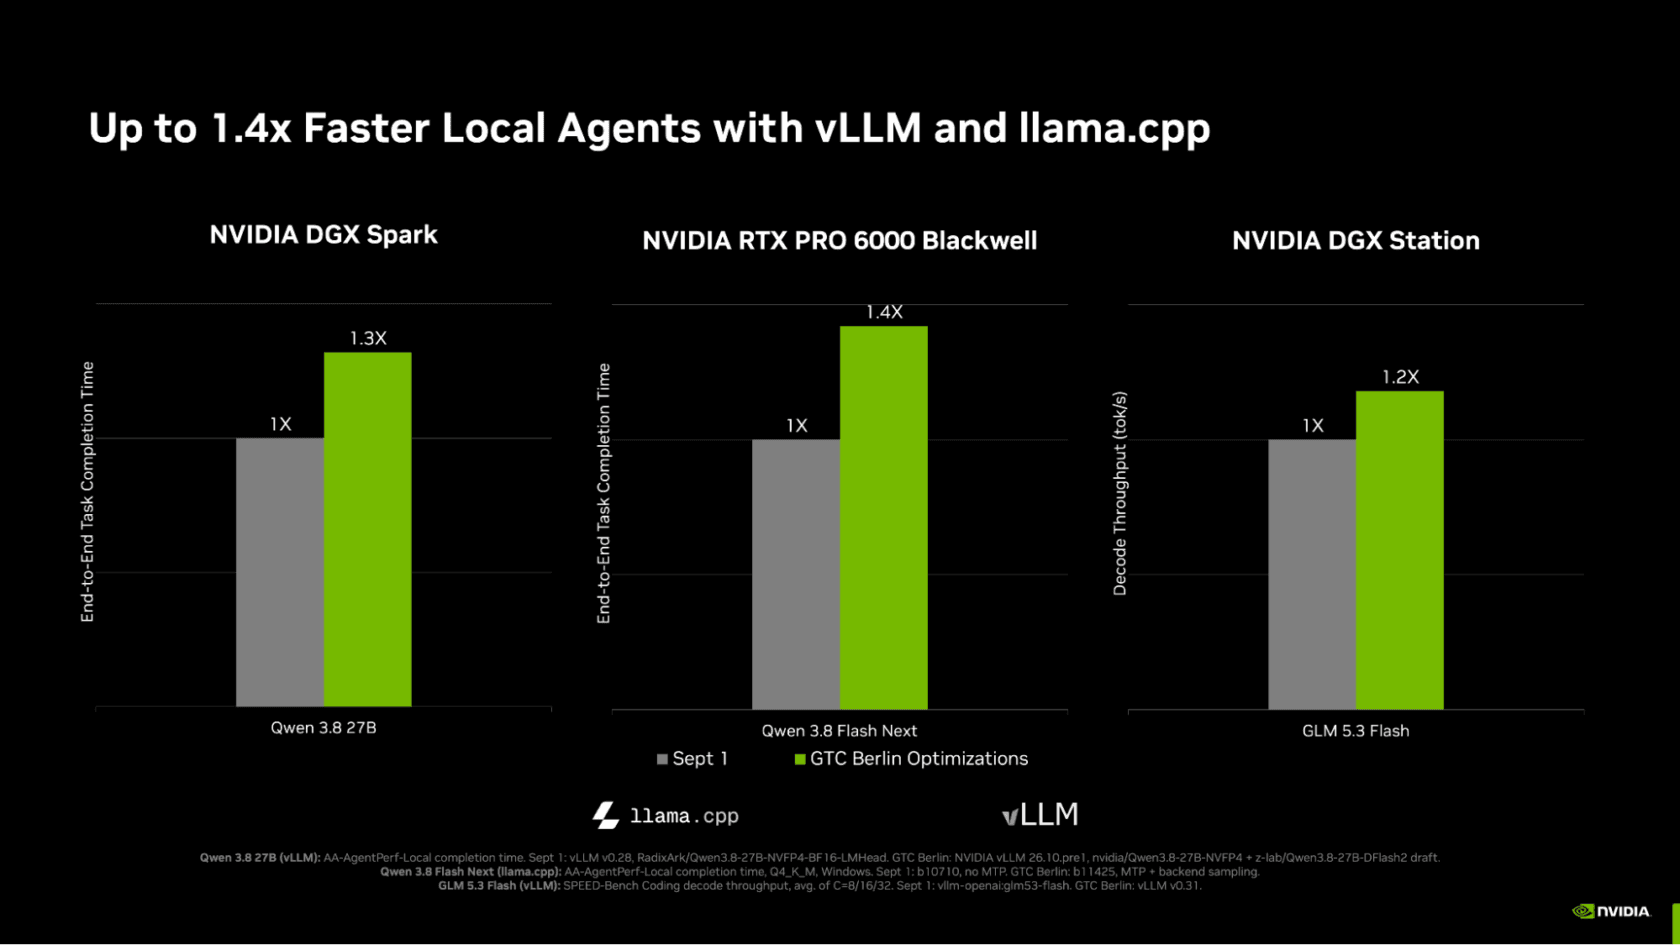
NVIDIA ร่วมกับชุมชน llama.cpp และ vLLM เพื่อเร่งการทำงานของ agent โดยใน llama.cpp สามารถทำงานเร็วขึ้นสูงสุด 1.4 เท่าบน RTX PRO 6000 Blackwell
ส่วนใน vLLM การใช้ FlashInfer prefill ช่วยให้งานบน DGX Spark เร็วขึ้น 1.3 เท่า และ DGX Station มี throughput สูงขึ้น 1.2 เท่าสำหรับโมเดล GLM 5.3 Flash
นักพัฒนาสามารถทดลองใช้การปรับแต่งเหล่านี้ได้ที่ สูตรการทำ local AI inference ของ NVIDIA
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร