
สร้างแอป GenAI ประสิทธิภาพสูงด้วย Graph ผ่าน graphrag-toolkit
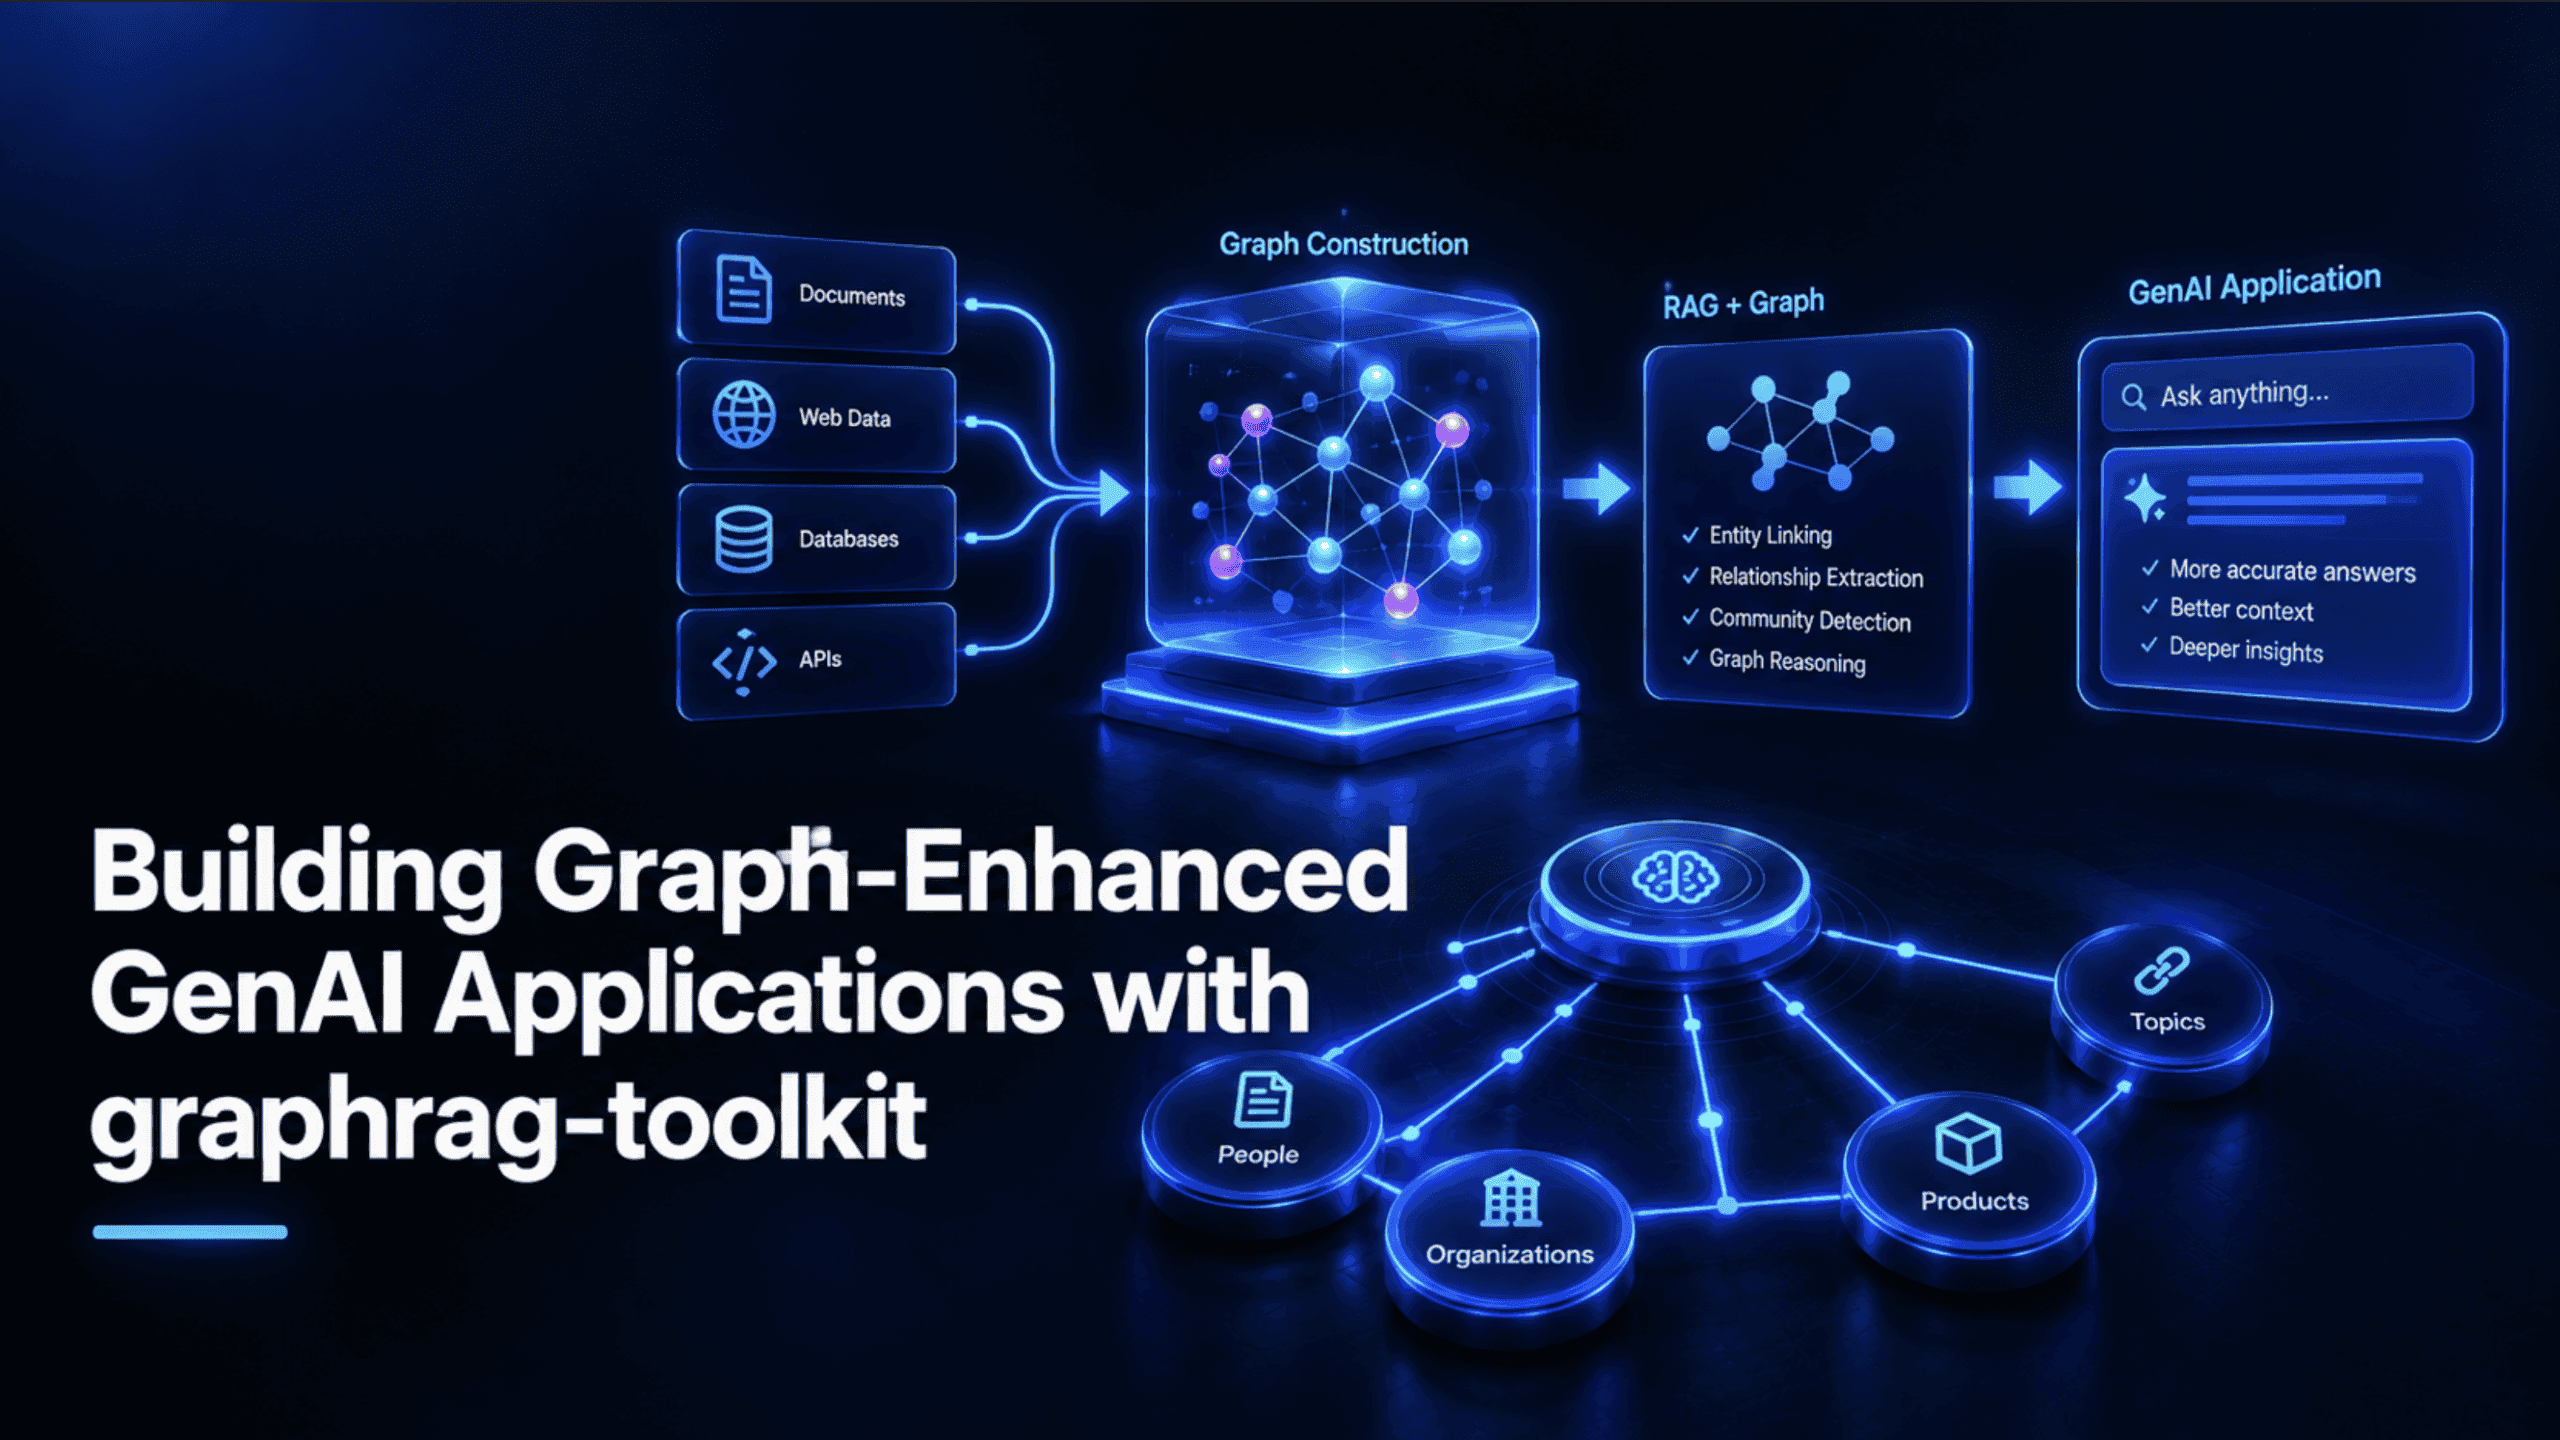
แชทบอทแบบ retrieval-augmented generation (RAG) มาตรฐานสามารถตอบคำถามพื้นฐานอย่าง "นโยบายการคืนสินค้าคืออะไร" ได้อย่างรวดเร็วโดยการค้นหาข้อมูลเป็นส่วนๆ (chunks) แล้วส่งให้โมเดลประมวลผล แต่เมื่อเจอคำถามที่ซับซ้อนขึ้น เช่น "นโยบายการคืนสินค้าสัมพันธ์กับเงื่อนไขการรับประกันสำหรับการสั่งซื้อระหว่างประเทศอย่างไร" ระบบมักจะเริ่มทำงานผิดพลาด
สาเหตุเป็นเพราะคำตอบไม่ได้อยู่ในข้อความส่วนใดส่วนหนึ่งเพียงชิ้นเดียว แต่ต้องอาศัยการเชื่อมโยงข้อมูลสองส่วนที่แยกจากกัน ซึ่งการค้นหาแบบเวกเตอร์ (Vector Search) ที่วัดเพียงความคล้ายคลึงของเสียงไม่สามารถสร้างความเชื่อมโยงนี้ได้ด้วยตัวมันเอง
ช่องว่างที่ระบบหาข้อความพบแต่ไม่เข้าใจความสัมพันธ์นี้เอง คือเหตุผลที่การดึงข้อมูลแบบเสริมประสิทธิภาพด้วย graph (graph-enhanced retrieval) เข้ามามีบทบาทสำคัญ บทความนี้จะพาไปรู้จักกับ graphrag-toolkit เครื่องมือ open-source จาก AWS Labs พร้อมสาธิตการสร้างผู้ช่วยวิจัยแบบเสริมประสิทธิภาพด้วย graph ที่ใช้งานได้จริง
แอปพลิเคชัน Generative AI แบบเสริมประสิทธิภาพด้วย Graph คืออะไรกันแน่
Graph-enhanced RAG หรือ GraphRAG คือการดึงข้อมูลผ่าน knowledge graph แทน index เวกเตอร์แบบธรรมดา เพื่อให้แอปพลิเคชันสามารถไล่ตามความสัมพันธ์จริงระหว่างข้อมูลได้ คำอธิบายของ Neo4j เอง ระบุว่านี่คือการรวมจุดแข็งของ knowledge graph ในด้านความชัดเจนของเอนทิตีและความสัมพันธ์ เข้ากับความสามารถในการสร้างภาษาของ large language model (LLM)
แนวคิดนี้ได้รับการยอมรับอย่างกว้างขวาง โดยแม้แต่ บทความของ Oracle เอง ก็ให้เหตุผลทำนองเดียวกันว่า RAG มาตรฐานมองว่าทุก chunk เป็นเกาะที่แยกขาดจากกัน ในขณะที่ graph จะจับภาพความเชื่อมโยงของเกาะเหล่านั้นว่าเอนทิตีใดปรากฏในหลายจุด และแนวคิดต่างๆ สัมพันธ์กันอย่างไรในภาพรวม
จุดที่ RAG แบบเวกเตอร์ธรรมดาทำได้ไม่ดีพอ
vector store มาตรฐานจะดึง chunks ออกมาโดยอิงจากความคล้ายคลึงทางความหมาย (semantic similarity) ระหว่างคำถามและข้อมูลที่ถูกเก็บไว้เท่านั้น โดยประมวลผลแต่ละส่วนแยกกัน ทำให้ไม่มีข้อมูลว่าแต่ละ chunk สัมพันธ์กันอย่างไร ไม่ว่าจะเป็นการกล่าวถึงเอนทิตีเดียวกัน หรือความสัมพันธ์แบบเหตุและผลต่อกัน
คำถามแบบ Multi-hop ที่ต้องการข้อเท็จจริงหลายส่วนมาประกอบกันจึงเป็นจุดอ่อนของระบบนี้ ปัญหานี้ไม่ได้อยู่ที่ความสามารถในการใช้เหตุผลของโมเดล แต่อยู่ที่กลไกการดึงข้อมูลที่ไม่สามารถหาชิ้นส่วนที่ถูกต้องทั้งหมดออกมาได้ตั้งแต่ต้น ซึ่งไม่สามารถแก้ไขได้เพียงแค่การทำ prompting หรือขยาย context window
แนะนำ graphrag-toolkit
graphrag-toolkit เป็นชุดเครื่องมือ Python (Apache 2.0) จาก AWS Labs ที่ประกอบด้วยสองส่วนหลักคือ lexical-graph สำหรับสร้าง hierarchical knowledge graph จากเอกสารที่ไม่มีโครงสร้าง และ BYOKG-RAG สำหรับทีมที่มี knowledge graph อยู่แล้วและต้องการเพิ่มเลเยอร์การตอบคำถามแบบหลายกลยุทธ์
AWS ได้เปิดตัวเครื่องมือนี้ผ่าน บล็อกโพสต์เปิดตัว โดยมีพื้นฐานจาก เอกสารวิจัย เรื่อง "Hierarchical Lexical Graph for Enhanced Multi-Hop Retrieval" ปัจจุบันมีการนำไปใช้งานจริงในระดับ production เช่นใน GenAI Security Intelligence Center ของ Deloitte ที่ใช้ Amazon Neptune ซึ่งถูกนำเสนอใน เซสชันทางเทคนิคของ re:Invent 2025
วิธีการทำงานที่แท้จริง
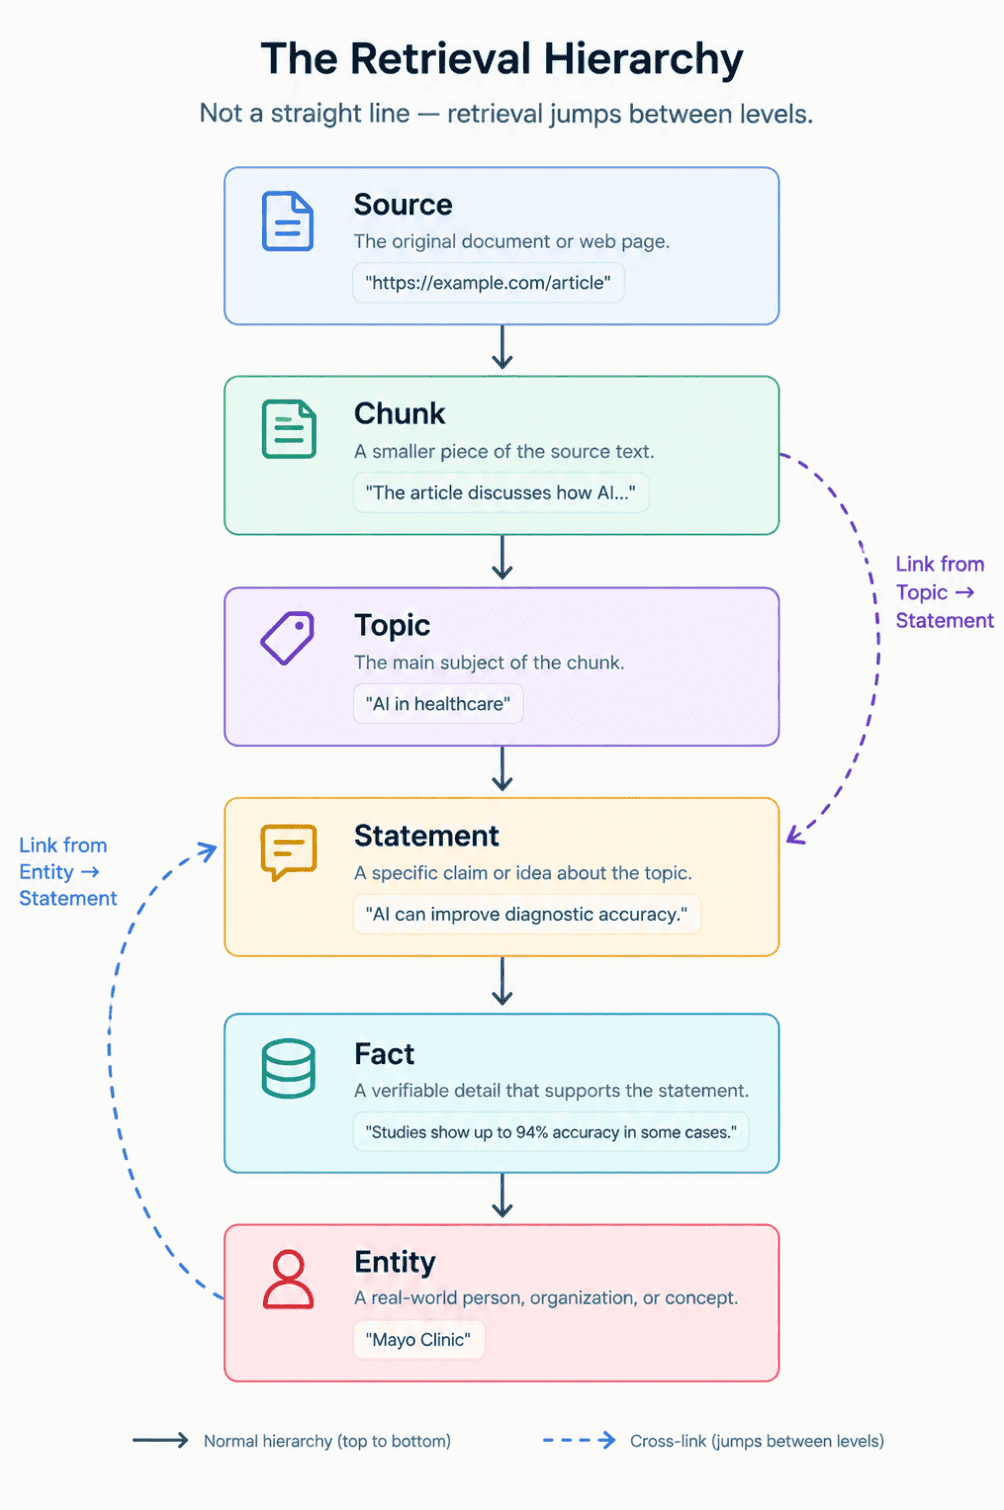
ตาม เอกสารโมเดล graph ตัว lexical graph จะจัดระเบียบข้อมูลเป็น 6 ระดับ: source, chunk, topic, statement, fact และ entity ซึ่งช่วยให้การดึงข้อมูลสามารถข้ามไปมาระหว่างระดับต่างๆ ได้ ทำให้ตอบคำถามแบบ multi-hop ได้อย่างมีประสิทธิภาพ
กระบวนการสร้าง graph แบ่งเป็นสองขั้นตอนคือ extract (สกัดข้อมูล) และ build (สร้าง index) โดยออกแบบมาให้ทำงานแบบ micro-batched และสามารถรันต่อได้ (resumable) ช่วยให้การนำเข้าข้อมูลขนาดใหญ่มีความยืดหยุ่นและตรวจสอบความถูกต้องได้ตลอดสายงาน
จุดเด่นอีกประการคือการเรียก LLM สองครั้งต่อหนึ่ง chunk ครั้งแรกเพื่อล้างข้อความดิบให้เป็นข้อเสนอ (propositions) ที่สมบูรณ์ และครั้งที่สองเพื่อสกัดข้อมูลเชิงลึก แม้จะเป็นทางเลือกเสริม แต่เอกสารยืนยันว่าขั้นตอน proposition-cleanup นี้ช่วยเพิ่มคุณภาพของการสกัดข้อมูลได้อย่างเห็นได้ชัด
การ Query: การค้นหาแบบอิงการท่องไปใน Graph (Traversal-Based Search)
อ้างอิงจาก เอกสารการ query คำถามจะถูกทำ embedding เพื่อหาจุดยึด (anchor points) ใน vector store จากนั้นจะเริ่มกระบวนการท่องไปใน graph (graph traversal) เพื่อดึงเนื้อหาที่เชื่อมโยงกันตามหัวข้อทั่วทั้ง graph มาส่งให้ LLM สร้างคำตอบ
ปัจจุบันการค้นหาแบบ Traversal-based เป็นค่าเริ่มต้นที่แนะนำ เนื่องจากกลยุทธ์แบบ semantic-guided รุ่นเก่ามีแนวโน้มที่จะถูกยกเลิกในอนาคต
| ชั้น (Layer) | ตัวเลือกที่มีให้ในตัว |
|---|---|
| Graph store | Amazon Neptune Database, Amazon Neptune Analytics, Neo4j, FalkorDB |
| Vector store | Amazon Neptune, Amazon OpenSearch Serverless, Postgres (พร้อม pgvector), Amazon S3 Vectors |
| Foundation model provider | Amazon Bedrock |
สำหรับการทดลองใช้งาน Neo4j และ Postgres พร้อม pgvector สามารถรันผ่าน Docker ได้โดยไม่มีค่าใช้จ่ายพื้นฐาน แต่จำเป็นต้องมีบัญชี AWS เพื่อเข้าถึงโมเดลใน Bedrock ตามการออกแบบปัจจุบันของเครื่องมือ
สิ่งที่ต้องมีก่อนเริ่ม
- Python 3.10 หรือใหม่กว่า
- Docker สำหรับรัน Neo4j และ Postgres
- บัญชี AWS ที่เปิดใช้งาน Amazon Bedrock
การสร้างผู้ช่วยวิจัยแบบเสริมประสิทธิภาพด้วย Graph
เป้าหมายคือการสร้างระบบที่ตอบคำถามจากการเชื่อมโยงบทความวิกิพีเดียหลายบทความเกี่ยวกับการบินอวกาศ ซึ่งการค้นหาแบบเดิมไม่สามารถตอบได้ครบถ้วน
ขั้นตอนที่ 1: รัน Neo4j และ Postgres ในเครื่อง
# docker-compose.yml
services:
  neo4j:
    image: neo4j:5
    ports:
      - "7474:7474"
      - "7687:7687"
    environment:
      - NEO4J_AUTH=neo4j/graphrag-password

postgres:
    image: pgvector/pgvector:pg16
    ports:
      - "5432:5432"
    environment:
      - POSTGRES_PASSWORD=graphrag-password
      - POSTGRES_DB=graphrag
ขั้นตอนที่ 2: ติดตั้ง Toolkit และ Dependencies
pip install graphrag-lexical-graph
pip install psycopg2-binary pgvector
pip install llama-index-readers-web html2text
ขั้นตอนที่ 3: การสกัดและสร้าง Graph จากบทความต้นฉบับจริง
from graphrag_toolkit.lexical_graph import LexicalGraphIndex
from graphrag_toolkit.lexical_graph.storage import GraphStoreFactory, VectorStoreFactory
from llama_index.readers.web import SimpleWebPageReader

neo4j_connection = "neo4j://neo4j:graphrag-password@localhost:7687"
postgres_connection = "postgresql://postgres:graphrag-password@localhost:5432/graphrag"

with (
    GraphStoreFactory.for_graph_store(neo4j_connection) as graph_store,
    VectorStoreFactory.for_vector_store(
        postgres_connection,
        index_names=["chunk"],
    ) as vector_store,
):
    graph_index = LexicalGraphIndex(graph_store, vector_store)

docs = SimpleWebPageReader(html_to_text=True).load_data([
        "https://en.wikipedia.org/wiki/Artemis_program",
        "https://en.wikipedia.org/wiki/International_Space_Station",
        "https://en.wikipedia.org/wiki/Commercial_Crew_Program",
    ])

graph_index.extract_and_build(docs, show_progress=True)
โค้ดส่วนนี้จะรันกระบวนการสกัดและสร้าง graph โดยใช้ Amazon Bedrock จัดการด้านความปลอดภัยและการเชื่อมต่อผ่าน SigV4 โดยอัตโนมัติ ทั้งนี้ต้องรันขั้นตอนที่ 4 และ 5 ภายในบล็อก with เดียวกันเพื่อให้การเชื่อมต่อฐานข้อมูลยังเปิดอยู่
ขั้นตอนที่ 4: ตรวจสอบสิ่งที่ถูกสร้างขึ้นจริง
    stats = graph_index.get_stats()
    print(stats)
ฟังก์ชัน get_stats() จะแสดงจำนวน node ในแต่ละระดับของลำดับชั้น ซึ่งช่วยยืนยันว่าระบบสามารถเชื่อมโยงเนื้อหาจากบทความทั้งสามเข้าด้วยกันได้จริง
ขั้นตอนที่ 5: การ Query ด้วยคำถามแบบ Multi-Hop
    from graphrag_toolkit.lexical_graph import LexicalGraphQueryEngine

query_engine = LexicalGraphQueryEngine.for_traversal_based_search(
        graph_store,
        vector_store,
        versioning=False,
    )

response = query_engine.query(
        "How does the Commercial Crew Program relate to crew transport "
        "for the International Space Station, and how might that "
        "connect to Artemis program crew logistics?"
    )

print(response)
ระบบจะประมวลผลคำถามที่ครอบคลุมทั้งสามบทความ โดยการไล่ตามลิงก์ของ entity และ topic ใน graph เพื่อสรุปเป็นคำตอบเดียวที่สอดคล้องกัน ซึ่งเป็นสิ่งที่ RAG แบบเวกเตอร์ทั่วไปทำได้ยาก
สิ่งที่คุณเพิ่งสร้างขึ้น และทิศทางต่อไป
ระบบนี้เป็นพื้นฐานของ hierarchical lexical graph ที่ใช้งานได้จริง ซึ่งคุณสามารถขยายความสามารถต่อได้ เช่น การใช้ Model Context Protocol server เพื่อให้เอเจนท์เข้าถึง graph หรือการใช้ Multi-tenancy เพื่อแยกข้อมูลผู้ใช้ภายในโครงสร้างพื้นฐานเดิม
หากคุณมี knowledge graph อยู่แล้ว สามารถศึกษา BYOKG-RAG เพื่อข้ามขั้นตอนการสกัดข้อมูล หรือทดลองผ่าน เวิร์กช็อปแบบศึกษาด้วยตนเอง และแอปพลิเคชัน RAG Explorer เพื่อเปรียบเทียบผลลัพธ์ระหว่าง Graph RAG และ Vector RAG ได้อย่างชัดเจน
บทสรุป
ดัชนีเวกเตอร์จะบอกว่าอะไรที่ "ฟังดู" เกี่ยวข้อง แต่ lexical graph จะบอกว่าข้อมูลนั้น "เชื่อมโยง" กันอย่างไร GraphRAG จึงเป็นทางออกสำคัญสำหรับคำถามแบบ multi-hop ที่ซับซ้อน ซึ่งผู้ใช้งานในโลกแห่งความเป็นจริงต้องการมากกว่าแค่การค้นหาข้อความธรรมดา
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร