
เผยเทคนิค Fork-and-Flush ล้างแชทช่วยให้ AI หาคำตอบได้ดีขึ้น
การศึกษาวิจัยจาก Microsoft Research พบความจริงที่น่าสนใจว่า AI research agent ที่ทำงานต่อเนื่องเป็นเวลานานอาจมีประสิทธิภาพคงที่ (plateau) แม้จะมีการเพิ่มทรัพยากรประมวลผลก็ตาม เนื่องจากบริบทการสนทนาที่สะสมมายาวนานเกินไปได้กลายเป็นข้อจำกัด ทำให้ตัวเอเจนต์จดจ่ออยู่กับโซลูชันเดิมๆ จนไม่สามารถข้ามไปสำรวจแนวทางใหม่ที่ดีกว่าได้
ทีมวิจัยได้ศึกษา "Autoresearch agents" หรือระบบ AI ที่มีความสามารถในการเสนอโซลูชัน ประเมินผล และปรับปรุงงานซ้ำๆ จากการทดสอบรันเอเจนต์ตัวเดียวกันในงานเดิม 8 ครั้ง พบว่ามีคะแนนประสิทธิภาพตั้งแต่ 68.3 ถึง 100.0 ซึ่งสะท้อนให้เห็นว่าแม้จะมีงบประมาณการประมวลผลเพิ่มขึ้น แต่ประสิทธิภาพที่ได้กลับมีความเหลื่อมล้ำและไม่คงที่เสมอไปตามรายงานการวิจัย
เอเจนต์ติดอยู่ใน "idea basins"
นักวิจัยได้พล็อต ข้อมูลโซลูชันจากการรันทั้งหมดลงบนแผนที่สองมิติเพื่อเปรียบเทียบความใกล้เคียงกัน พบว่าโซลูชันจากการรันเพียงครั้งเดียวมักจะกระจุกตัวอยู่ในขอบเขตเล็กๆ ของแผนที่ ซึ่งผู้เขียนเรียกปรากฏการณ์นี้ว่า "idea basins" หรือแอ่งทางความคิด
ปัญหานี้ทำให้เอเจนต์ใช้งบประมาณการประมวลผลส่วนใหญ่ไปกับการปรับปรุงโซลูชันเดิมในพื้นที่ที่มีประสิทธิภาพต่ำ แทนที่จะค้นหาแนวทางใหม่ที่ให้ผลลัพธ์ดีกว่า ซึ่งรูปแบบนี้ยังคงเกิดขึ้นแม้ว่าเอเจนต์จะทำการบีบอัดประวัติการสนทนาเป็นระยะแล้วก็ตาม
การล้างประวัติการแชทช่วยให้เอเจนต์สำรวจแนวทางใหม่ๆ
ทีมนักวิจัยจึงนำเสนอวิธีการที่เรียกว่า "Fork-and-Flush" ซึ่งผสมผสานสองกลไกหลัก ได้แก่ ขั้นตอน "forking" ที่จะแยกเอเจนต์ออกเป็น K สาขาขนานกัน โดยแต่ละสาขาจะสืบทอดพื้นที่ทำงาน (workspace) และไฟล์ที่สร้างไว้ก่อนหน้าทั้งหมดไปใช้งานต่อ
ตามด้วยขั้นตอน "flushing" ที่จะล้างบริบทการแชท (chat context) ของแต่ละสาขาทิ้งทั้งหมด แต่ยังคงรักษาไฟล์งานในพื้นที่ทำงานไว้ ทำให้เอเจนต์สามารถเริ่มการสนทนาใหม่เพื่อต่อยอดจากเนื้องานเดิมได้โดยไม่มีกรอบความคิดเก่ามาฉุดรั้ง
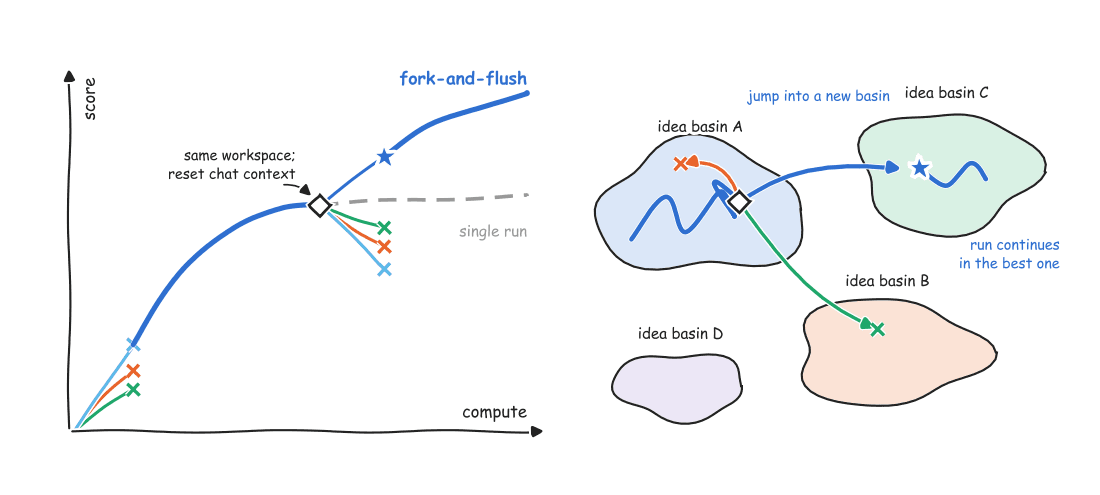
สาขาที่ยังคงเก็บบริบทการแชทเดิมไว้มักจะวนกลับไปยัง idea basin เดิม เนื่องจากกระบวนการคิดก่อนหน้าจะคอยชี้นำการตัดสินใจในขั้นตอนต่อไป ดังนั้นการใช้บริบทที่สดใหม่จะช่วยฟื้นฟูความหลากหลายในการค้นหา แม้ประวัติการสนทนาจะหายไป แต่โค้ดและผลลัพธ์สำคัญที่บันทึกไว้ในพื้นที่ทำงานยังคงอยู่ครบถ้วน
คะแนนเฉลี่ยสูงขึ้น 66 เปอร์เซ็นต์ภายใต้งบประมาณเท่าเดิม
จากการทดสอบกับ งานที่ใช้ระยะเวลานาน 13 งาน เช่น การจัดวาง polyomino, การจัดตารางงานในโรงงาน และการวิเคราะห์รหัสลับ โดยใช้โมเดล GPT-5.6-terra และ GPT-5.5 ผ่าน GitHub Copilot CLI พบว่าภายใต้งบประมาณประมวลผลที่เท่าเดิม Fork-and-Flush ทำคะแนนเฉลี่ยแบบ min-max-normalized ได้ที่ 0.78 เมื่อเทียบกับ 0.47 ของการรันครั้งเดียว คิดเป็นประสิทธิภาพที่เพิ่มขึ้นถึง 66.0%
นอกจากนี้ วิธีการดังกล่าวยังให้ผลลัพธ์ที่สม่ำเสมอมากขึ้น โดยค่าเบี่ยงเบนมาตรฐานลดลงจาก 0.26 เหลือเพียง 0.16 และที่น่าสนใจคือ ลำพังเพียงแค่การล้างบริบทการแชทโดยไม่มีการแยกสาขา (flushing only) ก็สามารถช่วยให้ผลลัพธ์ดีขึ้นได้ถึง 22 เปอร์เซ็นต์
| การประเมินผล | วิธีการ | คะแนนเฉลี่ยแบบปรับมาตรฐาน | ค่าเบี่ยงเบนมาตรฐานแบบปรับมาตรฐาน | การปรับปรุงสัมพัทธ์เหนือเกณฑ์มาตรฐานการรันครั้งเดียว |
|---|---|---|---|---|
| 13 งาน | รันครั้งเดียว | 0.47 | 0.26 | เกณฑ์มาตรฐาน |
| 13 งาน | Best-of-4 | 0.54 | 0.21 | ประมาณ +14.9% |
| 13 งาน | Fork-and-Flush | 0.78 | 0.16 | +66.0% |
| 11 งาน | รันครั้งเดียว | 0.45 | - | เกณฑ์มาตรฐาน |
| 11 งาน | เฉพาะ Flushing | 0.55 | - | ประมาณ +22% |
โมเดลที่แข็งแกร่งกว่าอาจยังต้องมีการรีเซ็ตบริบท
เมื่อทดสอบกับโมเดลที่มีความสามารถสูงขึ้นผ่าน ปัญหา MAX-3-SAT โดยใช้ Qwen3.5-4B, 9B และ 27B พบว่าความแปรปรวนของผลลัพธ์จะสูงสุดเมื่อเจอกับงานที่อยู่ตรงขอบเขตขีดความสามารถของโมเดลนั้นๆ
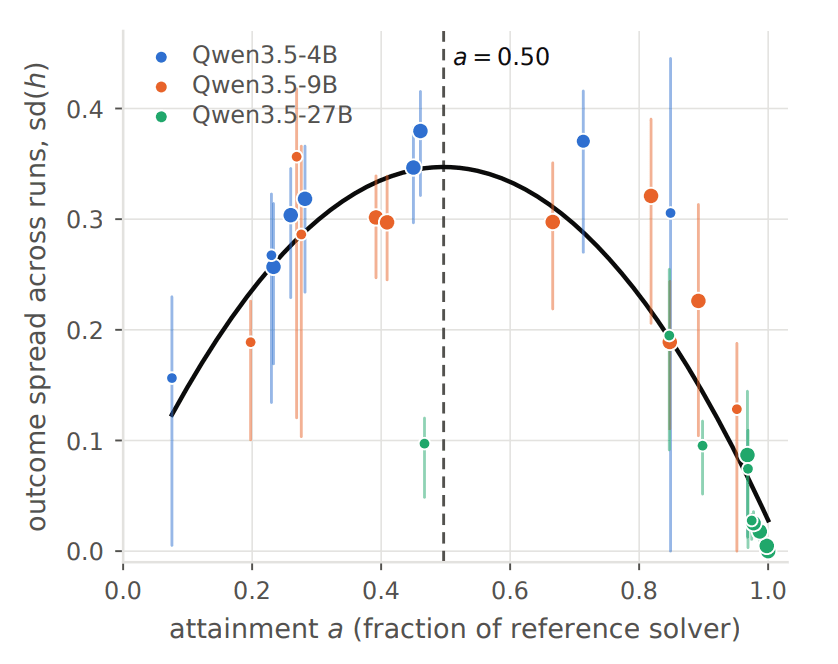
ผู้วิจัยให้ความเห็นว่า ปัญหางานวิจัยปลายเปิดมักจะตั้งอยู่บนขีดจำกัดความสามารถของโมเดลเสมอ ดังนั้นการรีเซ็ตบริบทเป็นประจำตามแนวทาง Fork-and-Flush จะยังคงมีความสำคัญและมีประโยชน์ต่อ research agent ระดับแนวหน้า แม้ในวันที่โมเดลจะพัฒนาไปไกลกว่านี้ก็ตาม
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร