
Open ASR Leaderboard เพิ่มข้อมูลสำเนียงอียิปต์และไนจีเรีย
เมื่อไม่กี่เดือนก่อน เราได้เพิ่มข้อมูลส่วนตัว (private data) ลงใน Open ASR Leaderboard ซึ่งเป็นชุดข้อมูล 11 ส่วนจาก Appen และ DataOceanAI ครอบคลุมทั้งการพูดตามบทและบทสนทนาทั่วไปใน 5 สำเนียงที่แตกต่างกัน ตามที่ได้ระบุไว้ใน blog
ผลตอบรับจากชุมชนเป็นไปในทิศทางที่ดีมาก โดยหลายฝ่ายได้ เน้นย้ำถึงความสำคัญของชุดข้อมูลแบบ held-out เพื่อการประเมินที่น่าเชื่อถือ ต่อมาเราจึงได้เพิ่มข้อมูลส่วนตัวสำหรับสำเนียงอินเดียภายใต้ความร่วมมือกับ Voice Arena ตามรายละเอียดใน blog
ล่าสุดเรามีความยินดีที่จะประกาศความร่วมมือครั้งใหม่กับ Liva AI เพื่อขยายฐานข้อมูลส่วนตัวด้วยสำเนียงใหม่อีก 2 สำเนียง ได้แก่ อียิปต์ 🇪🇬 และ ไนจีเรีย 🇳🇬
| Dataset | Accent | Duration [h] | Style | Transcription |
|---|---|---|---|---|
| Liva AI Conversational EG | Egyptian | 1.34 | Conversational, spontaneous | Punctuated, cased, with disfluencies. |
| Liva AI Conversational NG | Nigerian | 1.55 | Conversational, spontaneous | Punctuated, cased, with disfluencies. |
การเพิ่มข้อมูลครั้งนี้เป็นส่วนหนึ่งของความมุ่งมั่นในการยกระดับมาตรฐานการประเมินผล ASR ให้ครอบคลุมสำเนียงและภาษาที่หลากหลายมากขึ้น พร้อมทั้งเสริมสร้างความเชื่อมั่นด้วยการใช้ข้อมูลส่วนตัวใหม่ๆ เพื่อลดปัญหา benchmaxxing และกระจายแหล่งที่มาของข้อมูล เราตื่นเต้นที่จะได้เห็นชุมชนร่วมขับเคลื่อนประสิทธิภาพของเทคโนโลยี ASR ให้ก้าวไกลยิ่งขึ้น 🤗
การวิเคราะห์สำเนียงที่ละเอียดยิ่งขึ้นในแท็บ Private
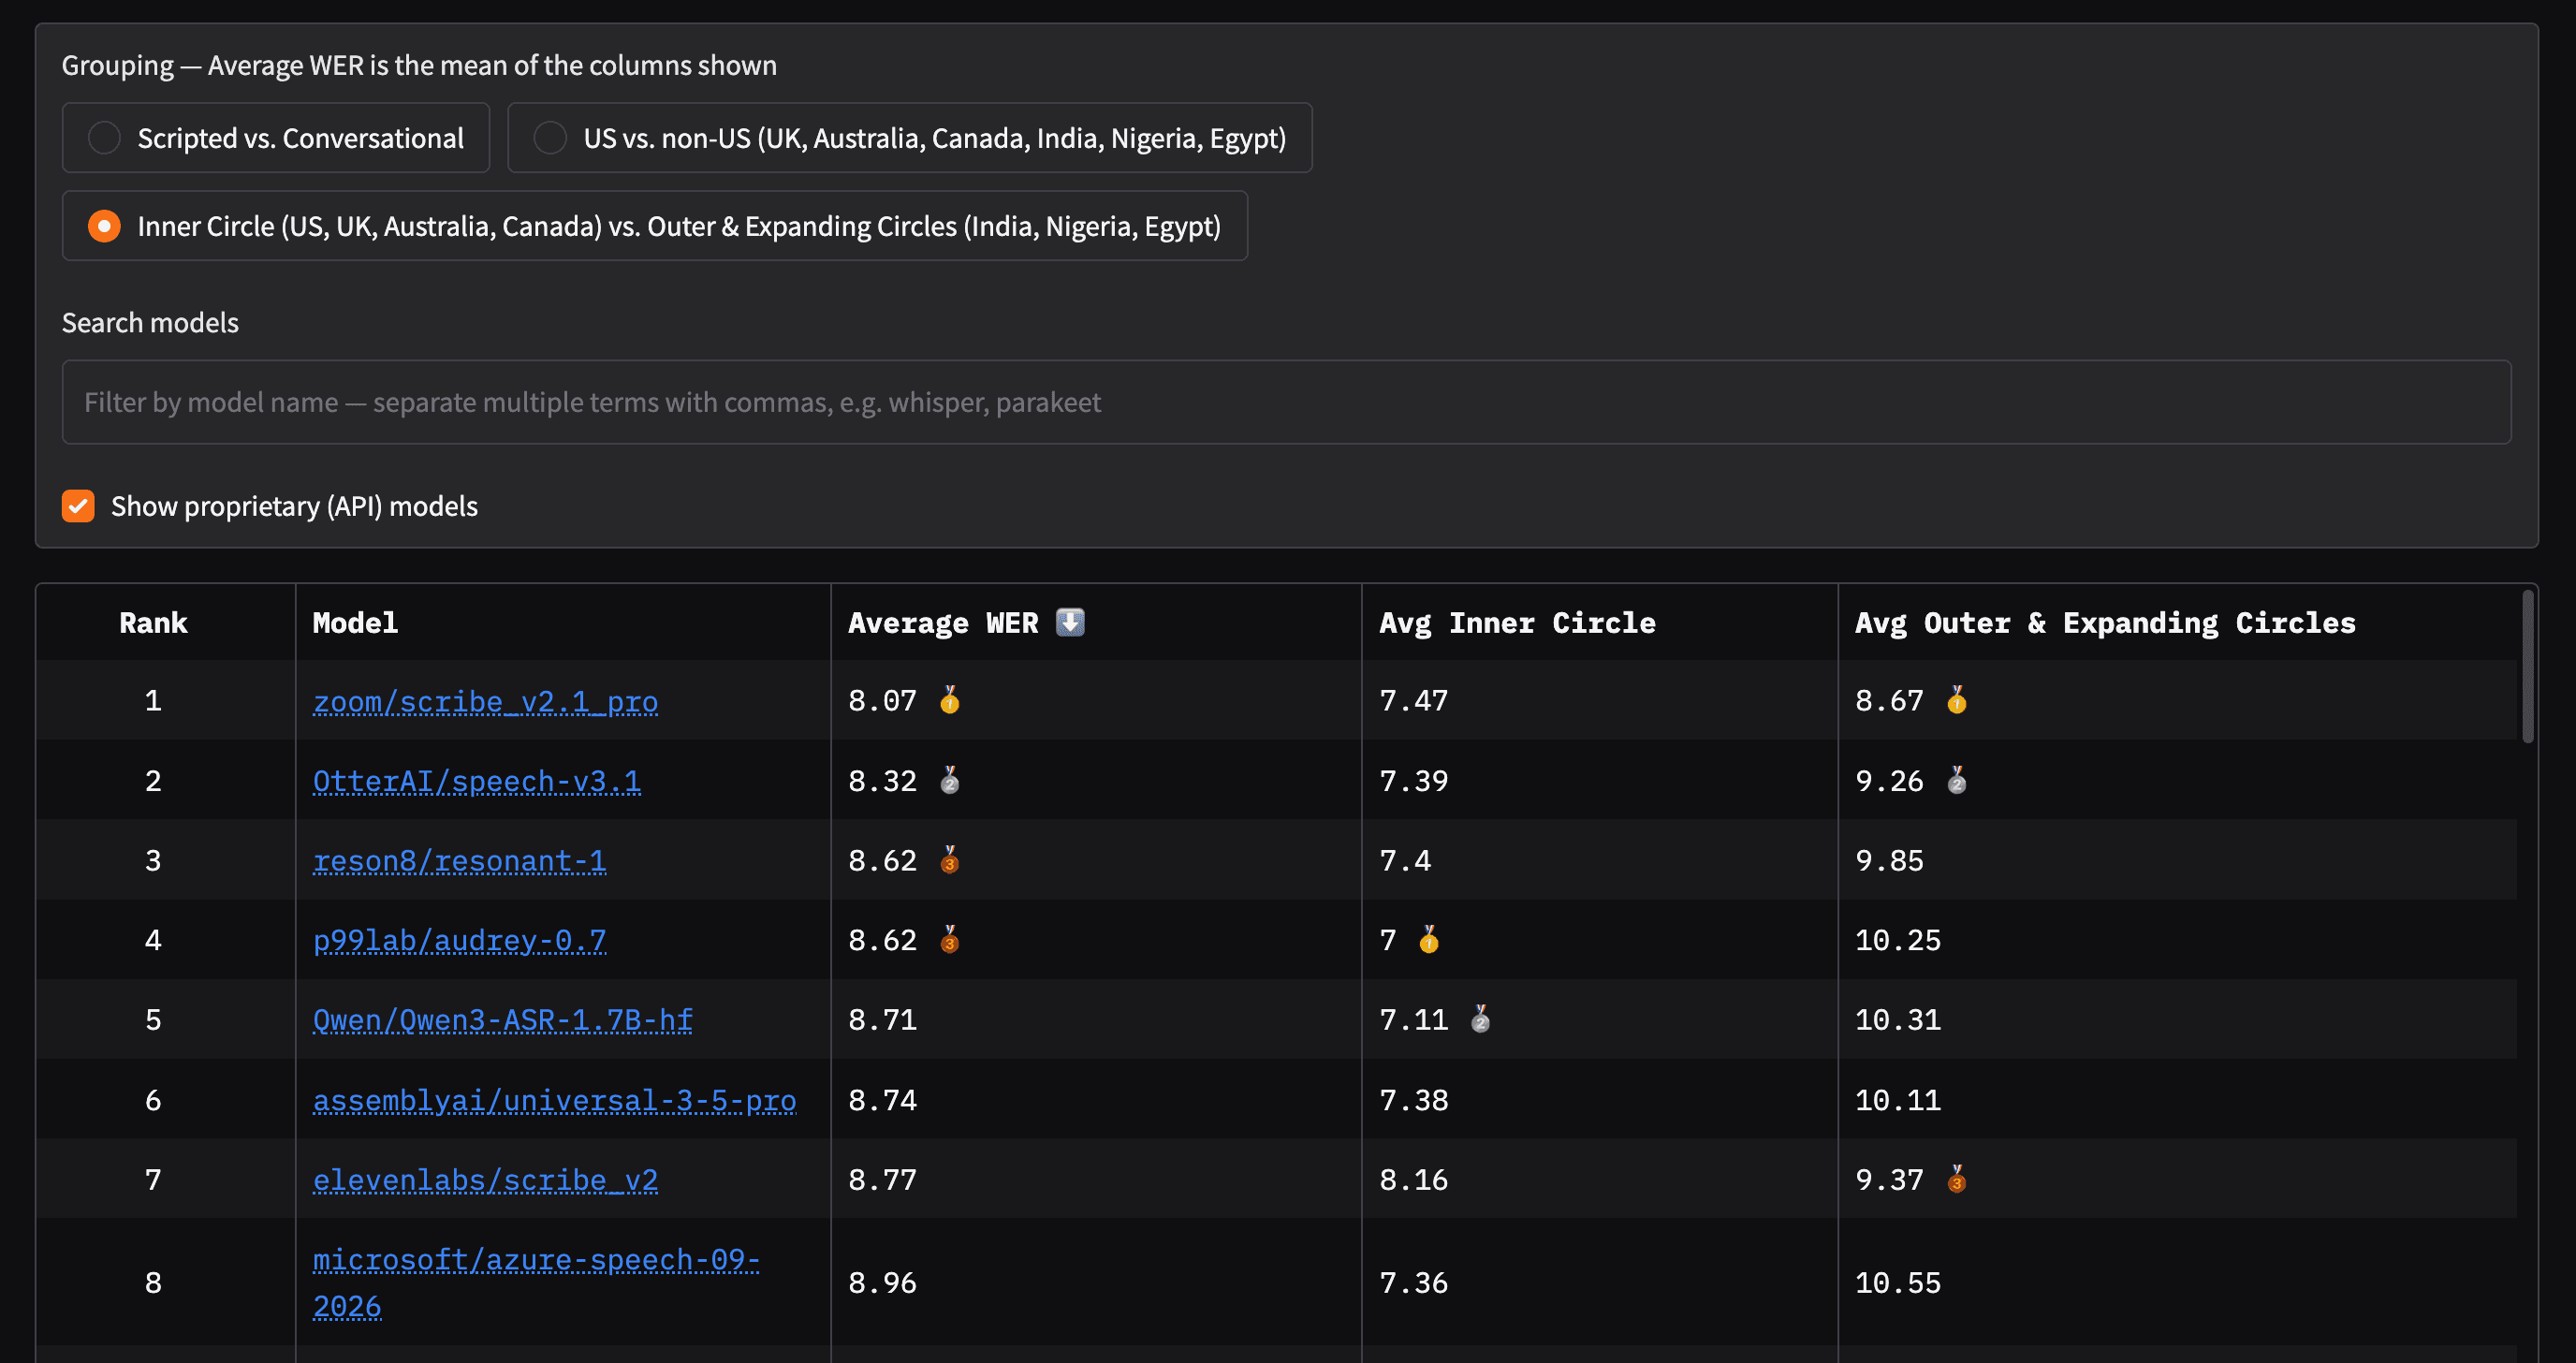
การมาถึงของสำเนียงใหม่ช่วยให้เราสามารถวิเคราะห์ข้อมูลได้ละเอียดยิ่งขึ้นตามหลักการ Kachru’s Three Circles โดยต้องขอบคุณ Hume AI สำหรับแนวคิดใน leaderboard ของพวกเขา ซึ่งปัจจุบัน Open ASR Leaderboard จะรายงานผลดังนี้:
- สหรัฐอเมริกา (US) เปรียบเทียบกับกลุ่มนอกสหรัฐอเมริกา (สหราชอาณาจักร, ออสเตรเลีย, แคนาดา, อินเดีย, ไนจีเรีย และอียิปต์)
- วงใน (Inner Circle) (สหรัฐอเมริกา, สหราชอาณาจักร, ออสเตรเลีย, แคนาดา) เปรียบเทียบกับกลุ่มวงนอกและวงขยาย (Outer & Expanding Circles) (อินเดีย, ไนจีเรีย และอียิปต์)
ในอนาคตเมื่อมีข้อมูลสำเนียงเพิ่มเติม เรามีแผนที่จะแยกการแสดงผลระหว่างกลุ่มวงนอกและวงขยายออกจากกันเพื่อความชัดเจน
เกี่ยวกับ Liva AI
Liva AI เชี่ยวชาญด้านการจัดเก็บข้อมูลการโต้ตอบแบบหลายรูปแบบ (multimodal interaction data) ผ่านผลิตภัณฑ์ที่ใช้งานโดยผู้ใช้จริง เนื่องจาก Liva เป็นเจ้าของทั้งระบบการจัดเก็บและการกระจายข้อมูล จึงสามารถออกแบบผลิตภัณฑ์เพื่ออุดช่องโหว่ของโมเดลเฉพาะด้านได้ครอบคลุมทั้งในแง่อุตสาหกรรม ภาษา และประเภทการโต้ตอบ
วิธีการดังกล่าวช่วยให้เข้าถึงพฤติกรรมการใช้งานที่เป็นธรรมชาติและมีบริบทสูง ซึ่งเกิดจากการใช้งานผลิตภัณฑ์จริงในชีวิตประจำวัน แตกต่างจากการโต้ตอบที่ถูกกำหนดขึ้นตามสถานการณ์จำลองหรืองานวิจัยทั่วไป
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร