
วิธีประเมิน AI Agent: เลิกวัดผลด้วยความรู้สึกสู่ระบบมาตรฐาน
15 ต.ค. 2026
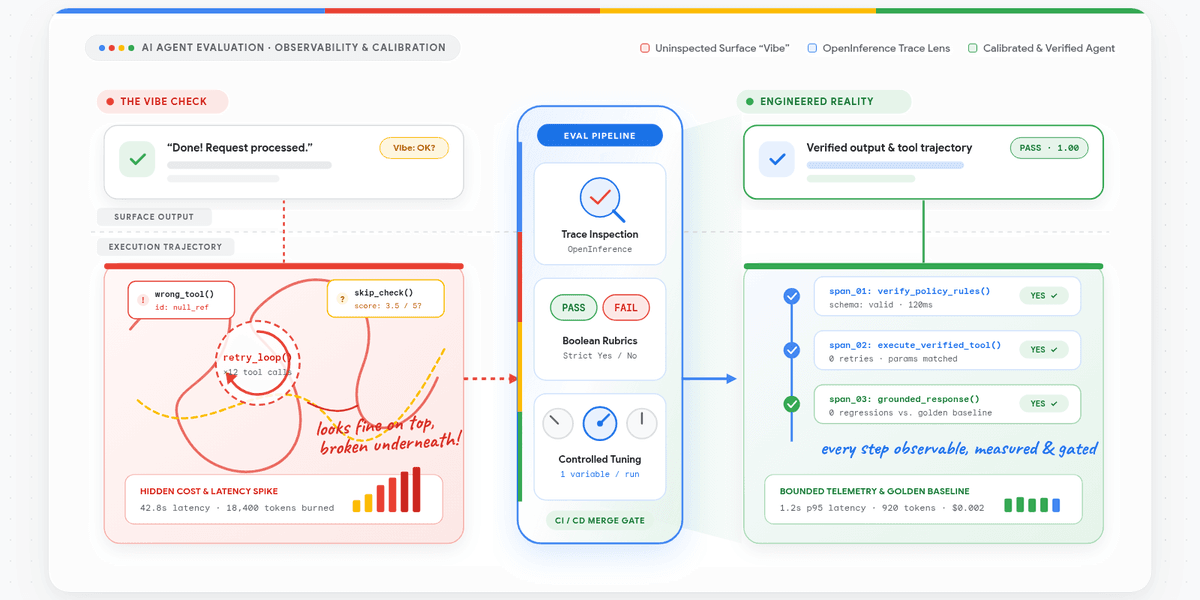
AI Agent ของคุณอาจทำงานวนลูป เผาผลาญ Token หรือให้ข้อมูลที่หลอน (Hallucinated) แต่ภายนอกยังดูเหมือนทำงานปกติ ซึ่งการตรวจเช็คด้วยความรู้สึก (Vibe Check) ไม่สามารถตรวจพบสิ่งเหล่านี้ได้ บทความนี้คือคู่มือจากรายการ AI Agent Clinic ตอน How to Actually Evaluate (Any) AI Agent: Beyond the Vibe Check ที่จะช่วยคุณสร้าง Eval Pipeline สำหรับ LangGraph Agent ภายใน 60 นาที
เมื่อเริ่มพัฒนา AI Agent หลายทีมมักทดสอบแบบเดิมๆ คือเชื่อมต่อโมเดลกับเครื่องมือ แล้วรัน Prompt ใน Terminal เพื่อตรวจดูผลลัพธ์ด้วยสายตา หากคำตอบดูดีก็ปล่อยใช้งานทันที แต่ในทางปฏิบัติวิธีนี้จะพังอย่างรวดเร็ว เพราะการปรับแก้ System Prompt เพื่อแก้ปัญหาหนึ่ง อาจทำให้ Agent หยุดเรียกใช้เครื่องมือที่จำเป็นในอีกส่วนหนึ่งโดยไม่รู้ตัว
ที่แย่กว่านั้นคือ Agent ล้มเหลวต่างจากซอฟต์แวร์ทั่วไป มันสามารถติดอยู่ใน Retry Loop หรือเรียกใช้เครื่องมือซ้ำซ้อน แต่ยังคงส่งคืนคำตอบสุดท้ายที่ดูสุภาพและน่าเชื่อถือ ความล้มเหลวที่ซ่อนอยู่เหล่านี้ส่งผลเสียร้ายแรง ทั้งค่าบริการ Cloud ที่พุ่งสูงขึ้น การใช้ Token เกินความจำเป็น ไปจนถึงการทำลายความเชื่อมั่นของผู้ใช้ที่ต้องรอสัญลักษณ์โหลดค้างเป็นเวลานาน
การสร้างระบบประเมินที่ทำซ้ำได้ (Repeatable Evaluation) คือหัวใจสำคัญ แม้จะดูเหมือนเป็นภาระในช่วงแรก แต่ระบบที่เรียบง่ายย่อมดีกว่าการสุ่มตรวจเฉพาะหน้า คุณไม่จำเป็นต้องมีระบบซับซ้อนตั้งแต่วันแรก แต่ควรเริ่มจากการตรวจเช็คที่ทำซ้ำได้และพัฒนาไปสู่เฟรมเวิร์กอัตโนมัติเมื่อ Agent มีความสามารถมากขึ้น
การเปลี่ยนผ่านไปสู่การตรวจเช็คที่เป็นระบบมีเสาหลักสองประการ คือการดูแลโดยมนุษย์และเครื่องมือที่ตรงจุด บทความนี้จะใช้ชุดเครื่องมือโอเพนซอร์ส agent-eval เพื่อสาธิตวิธีรวมร่องรอยการทำงาน (Traces) ที่ตรวจสอบด้วยตนเองเข้ากับการตรวจสอบอัตโนมัติ เพื่อดักจับการถดถอยที่มองไม่เห็น (Silent Regressions) ตั้งแต่ต้นจนถึงช่วงใช้งานจริง
วางรากฐานด้วย Critical User Journeys (CUJs)
ก่อนจะเขียนโค้ดทดสอบ คุณต้องกำหนดวิสัยทัศน์ว่าผลลัพธ์ที่ดีคืออะไร โดยอ้างอิงจาก Critical User Journeys (CUJs) มากกว่าเกณฑ์มาตรฐานนามธรรม เช่น กำหนดว่า "ในฐานะนักวิเคราะห์ Agent ต้องรับอีเมล ระบุธุรกรรม ตรวจสอบความถูกต้องกับบัญชีแยกประเภทภายใน 30 วินาที และร่างคำตอบโดยใช้ชื่อเรียกของโบรกเกอร์ได้เอง"
ทุกประโยคใน CUJ จะกลายเป็นจุดประเมิน เช่น Agent แก้ไข ID ถูกต้องหรือไม่? ตรวจสอบบัญชีแยกประเภทก่อนร่างจดหมายหรือไม่? การกำหนดความคาดหวังล่วงหน้าจะช่วยให้ทีมผลิตภัณฑ์และวิศวกรเห็นภาพความสำเร็จที่ตรงกัน
คุณไม่จำเป็นต้องมี Log จากการใช้งานจริงหลายเดือนเพื่อสร้างชุดข้อมูลหลัก (Golden Dataset) แต่สามารถย่อย CUJ เป็นสถานการณ์ต่างๆ และใช้ LLM จำลองผู้ใช้ เช่น ADK user simulations เพื่อจำลองพฤติกรรมผู้ใช้ที่หลากหลาย ทั้งการพิมพ์ผิด หรือการถามคำถามซับซ้อนหลายรอบ เพื่อบันทึกร่องรอยการทำงาน (Traces) และแก้ไขช่องว่างประสิทธิภาพก่อนเจอผู้ใช้จริง
การประเมินแบบ 4 ระดับและกฎ Boolean
คะแนนรวมเพียงอย่างเดียวไม่สามารถบอกสาเหตุการล้มเหลวได้ คุณควรแยกประเภทการตรวจเช็คเป็น 4 ระดับ ได้แก่ Unit Tests, Deterministic Metrics, LLM-as-a-judge Rubrics และ Integration Tests ที่สำคัญคือต้องรักษาชุดข้อมูลหลักให้คงที่เพื่อไม่ให้ค่าพื้นฐาน (Baseline) เคลื่อนที่จนวัดผลไม่ได้ เนื่องจาก LLM มักให้คะแนนเชิงคุณภาพ (1-5) ไม่สม่ำเสมอ ควรเปลี่ยนเกณฑ์เป็น คำถามแบบ Boolean (ผ่าน/ไม่ผ่าน) เช่น แทนที่จะถามว่าคำตอบมีประโยชน์ไหม ให้ถามว่า "Agent ได้ตรวจสอบ ID บัญชีก่อนเรียกใช้เครื่องมือคืนเงินหรือไม่?" (แนะนำการใช้ Adaptive Rubrics)
นอกจากนี้ต้องประเมินทั้งระบบไม่ใช่แค่ข้อความสุดท้าย โดยติดตาม Latency, การบริโภค Token, ค่าใช้จ่าย API และจำนวนการเรียกใช้เครื่องมือ การใช้มาตรฐานร่องรอยการทำงานอย่าง OpenInference จะช่วยให้คุณเปลี่ยนเฟรมเวิร์กการจัดการได้โดยไม่ต้องเขียนชุดทดสอบใหม่ทั้งหมด
เริ่มจากเล็กๆ ด้วย "ปากกาสีแดง"
คุณสามารถติดตั้งระบบ Eval Pipeline ได้ในเวลาไม่กี่ชั่วโมงด้วย agent-eval toolkit โดยเริ่มจากการรันการจำลองและอ่าน Traces จริงตั้งแต่ต้นจนจบ จากนั้นใช้ ปากกาสีแดง ทำเครื่องหมายจุดที่ Agent ลังเล หลอนพารามิเตอร์ หรือเลือกเครื่องมือผิด การสละเวลาตรวจสอบด้วยตนเองเพียงไม่กี่ชั่วโมงจะช่วยให้คุณเห็นรูปแบบความล้มเหลวที่แท้จริงได้ดีกว่ากราฟอัตโนมัติ
เมื่อมีรายการการตรวจเช็คเริ่มต้นแล้ว เครื่องมือ agent-eval จะช่วยจัดการส่วนที่เหลือ ทั้งการรันสถานการณ์แบบ Multi-turn, การรับ Traces ที่รองรับทั้ง LangGraph หรือเฟรมเวิร์กอื่นๆ และการส่งข้อมูลไปยัง Gemini Platform เพื่อประเมินผลโดยไม่ต้องเขียนโค้ด API เพิ่มเติม
สร้างวงจรการพัฒนาที่ยั่งยืน
ควรสร้างจังหวะการรัน Eval Pipeline อย่างสม่ำเสมอในทุกการเปลี่ยนแปลง (CI/CD Pull Request Gates) เพื่อป้องกันความถดถอย (Regression) โดยกำหนดเกณฑ์ขั้นต่ำ เช่น ต้องผ่าน 95% และต้องไม่มีความถดถอยในตัวชี้วัดหลัก ข้อมูลจากการรันทั้งหมดควรถูกเก็บไว้ในคลังข้อมูลส่วนกลางอย่าง BigQuery เพื่อแสดงผลบนแดชบอร์ดให้ทีมเห็นความแม่นยำและงบประมาณที่ใช้
บทเรียนสำคัญสำหรับทีมสร้าง Agent คือ "การเปลี่ยนแปลงเล็กๆ ที่วัดผลได้ ชนะการเขียนใหม่ครั้งใหญ่เสมอ"
รับชมการสาธิต: How to Actually Evaluate (Any) AI Agent: Beyond the Vibe Check รับโค้ด: agent-eval toolkit บน GitHub และศึกษาเพิ่มเติมเกี่ยวกับ The Outer Loop, Insights First: An Ambient Quality Agent That Diagnoses Your Production Agent.
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร