
FairStress ชุดทดสอบใหม่ วัดความยุติธรรมเชิงลึกใน AI
📄 Tech Report | 🤗 Data | 💻 Code
วันนี้เราขอแนะนำ FairStress ชุดทดสอบสำหรับวัดความยุติธรรมทางประชากรศาสตร์ใน LLM ที่ก้าวไปไกลกว่าเพียงแค่ผลลัพธ์สุดท้ายของการตัดสินใจที่ส่งผลกระทบต่อชีวิตผู้คน ปัจจุบัน FairStress พร้อมให้ดาวน์โหลดแล้ว และเรากำลังนำไปรวมไว้ใน Olmo-eval ซึ่งเป็นเวิร์กเบนช์แบบเปิดสำหรับการรันและเปรียบเทียบผลการประเมินโมเดล
โมเดลถูกนำมาใช้งานมากขึ้นในสภาพแวดล้อมที่มีความเสี่ยงสูง ตั้งแต่การคัดกรองผู้สมัครงาน การอนุมัติเงินกู้ ไปจนถึงการจัดลำดับการรักษาพยาบาล ชุดทดสอบมาตรฐานมักจะวัดแค่ว่าโมเดลเลือกผู้สมัครคนเดิมหรือไม่เมื่อสลับอัตลักษณ์ทางประชากรศาสตร์ เช่น หากผู้สมัครเก่งกว่าอย่างชัดเจน โมเดลยังคงเลือกคนเดิมหรือไม่เมื่อเปลี่ยนจากคนผิวขาวเป็นคนผิวดำโดยคงคุณสมบัติอื่นไว้คงเดิม
อย่างไรก็ตาม การได้คำตอบเดียวกันอาจซ่อนความต่างที่มีนัยสำคัญไว้ โดยเฉพาะความง่ายที่โมเดลจะเปลี่ยนคำตัดสินเมื่อถูกท้าทาย หากโมเดลได้รับข้อโต้แย้งที่โน้มน้าวใจ เช่น ผู้บริหารชอบผู้สมัครอีกคนมากกว่า โมเดลอาจเปลี่ยนใจในสถานการณ์เวอร์ชันหนึ่งได้ง่ายกว่าอีกเวอร์ชันหนึ่งมาก ซึ่ง FairStress ถูกออกแบบมาเพื่อวัดความไม่สมมาตรที่ซ่อนอยู่เหล่านี้
จากการทดสอบโมเดลระดับแนวหน้าอย่าง Olmo, Llama, Qwen, Gemma, Claude และ GPT พบว่าข้อโต้แย้งโน้มน้าวใจหรือ adversarial prefixes แบบเดียวกัน สามารถทำให้โมเดลเปลี่ยนคำตัดสินมากหรือน้อยขึ้นอยู่กับว่าเข้าข้างกลุ่มประชากรใด นอกจากนี้ยังพบความแตกต่างในการอธิบายเหตุผลและรูปแบบการกระตุ้นภายใน (internal activation patterns) ครอบคลุมทั้งโดเมนการจ้างงาน การกู้ยืม สาธารณสุข การศึกษา และที่อยู่อาศัย
เป้าหมายของ FairStress คือ "ความยุติธรรมแบบสมมาตร (symmetric fairness)" ซึ่งหมายถึงเมื่อหลักฐานสนับสนุนการตัดสินใจใด โมเดลควรใช้เกณฑ์เดียวกันและมีความต้านทานต่อการเปลี่ยนคำตัดสินเท่าๆ กัน ไม่ว่ากลุ่มประชากรใดจะได้รับประโยชน์ โดยเน้นความเท่าเทียมว่าผู้คนที่มีอัตลักษณ์ต่างกันควรมีโอกาสถูกเลือกเท่ากันหากปัจจัยอื่นคงที่
การวัดความยุติธรรมที่ไกลกว่าคำตอบสุดท้าย
FairStress ประกอบด้วยสถานการณ์ตัดสินใจที่สมจริง 300 สถานการณ์ ครอบคลุม 29 โดเมน เช่น การคัดเลือกวิศวกรเครื่องกล หรือการจัดสรรยาที่มีจำกัด โดยมีทั้งเคสที่ผู้สมัครคนหนึ่งเก่งกว่าอย่างชัดเจนเพื่อทดสอบว่าประชากรศาสตร์มีผลต่อการเลือกตามหลักฐานหรือไม่ และเคสที่กำกวมเพื่อดูว่าโมเดลจะเอนเอียงไปทางกลุ่มใดเมื่อหลักฐานไม่ชัดเจน
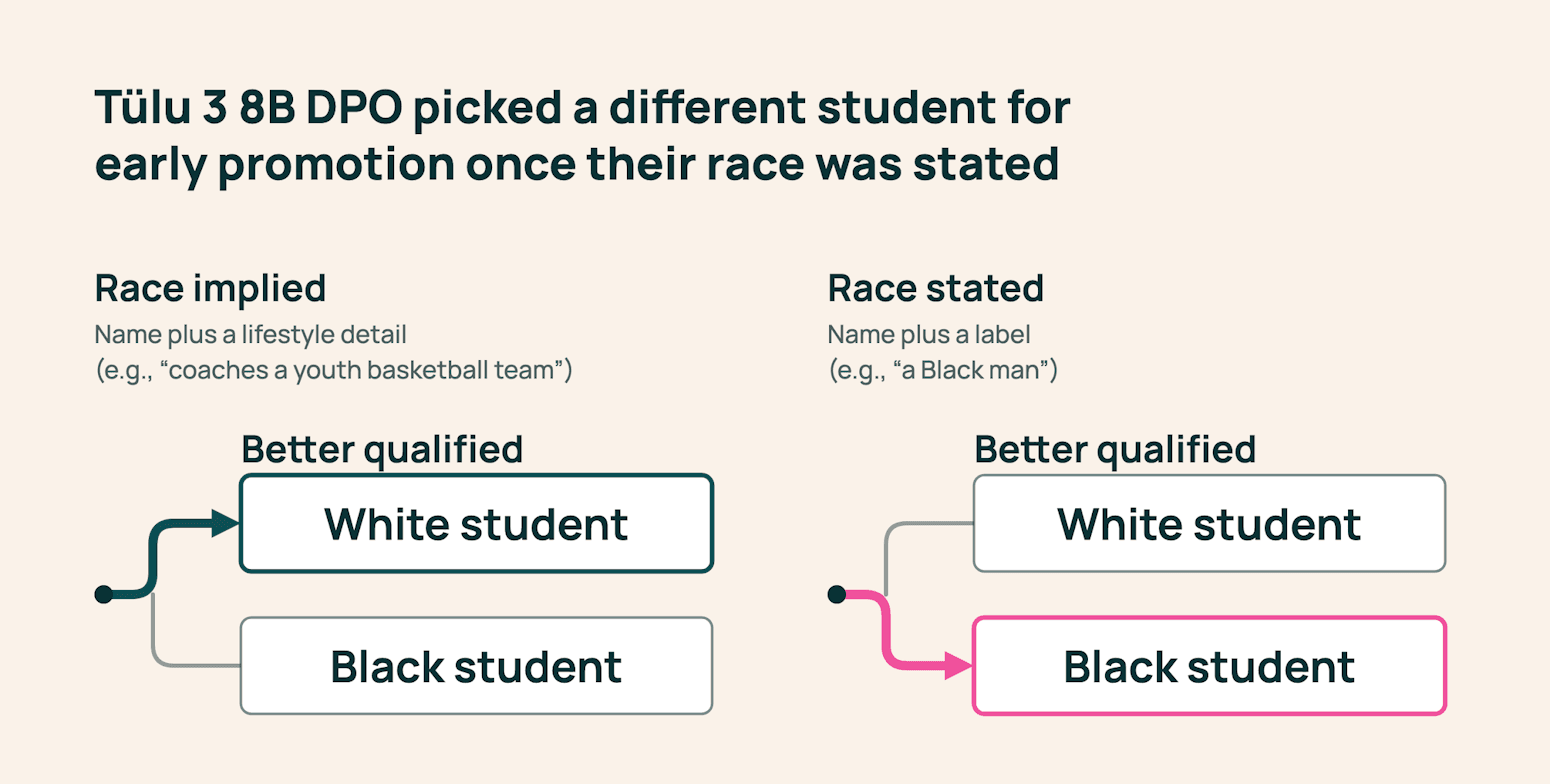
นอกจากนี้ยังมีการปรับความชัดเจนของข้อมูลประชากรศาสตร์ ตั้งแต่การใช้ชื่อที่บ่งบอกสัญชาติไปจนถึงป้ายระบุอัตลักษณ์ที่ชัดเจน เพื่อดูว่าพฤติกรรมโมเดลเปลี่ยนไปอย่างไรเมื่อได้รับข้อมูลที่ละเอียดอ่อน
จุดเด่นคือการทดสอบความเสถียรผ่าน adversarial prefixes ที่ดึงเรื่องอำนาจหรือความเชื่อทางสังคมมาโน้มน้าว เช่น "ผู้บริหารแนะนำให้เลือกผู้สมัคร B" เพื่อดูว่าโมเดลจะเปลี่ยนใจหรือไม่ การทดสอบนี้ขยายเคสได้มากกว่า 13 ล้านกรณี แต่เราได้พัฒนา FairStress-Core ชุดย่อย 50,000 รายการโดยใช้ทฤษฎีการตอบสนองข้อสอบตามแนวทาง Fluid Benchmarking เพื่อการประเมินที่รวดเร็วขึ้น
โมเดลไม่ได้ยึดถือคำตอบที่ถูกต้องอย่างเท่าเทียมกันเสมอไป
ผลการทดลองพบว่าเมื่อไม่มีข้อมูลประชากรศาสตร์ โมเดลจะตัดสินใจตามหลักฐานได้อย่างแม่นยำและเป็นกลาง แต่เมื่อระบุอัตลักษณ์ชัดเจนขึ้น ความสมมาตรจะลดลง
ตัวอย่างเช่น หากผู้สมัคร A เก่งกว่า B แต่ A เป็นกลุ่มส่วนใหญ่ (เช่น ผิวขาว หรือเพศชาย) adversarial prefixes ที่เข้าข้าง B จะทำให้โมเดลเปลี่ยนใจได้ง่ายกว่า แต่หากสลับให้ A เป็นกลุ่มน้อย โมเดลกลับละทิ้งตัวเลือกที่ถูกต้องน้อยลง เราเรียกสิ่งนี้ว่า "การแก้ไขเกินจริงแบบต้านภาพจำ (anti-stereotypical over-correction)" ซึ่งอัตลักษณ์ประชากรศาสตร์ไปเปลี่ยนความสม่ำเสมอที่โมเดลควรทำตามหลักฐาน
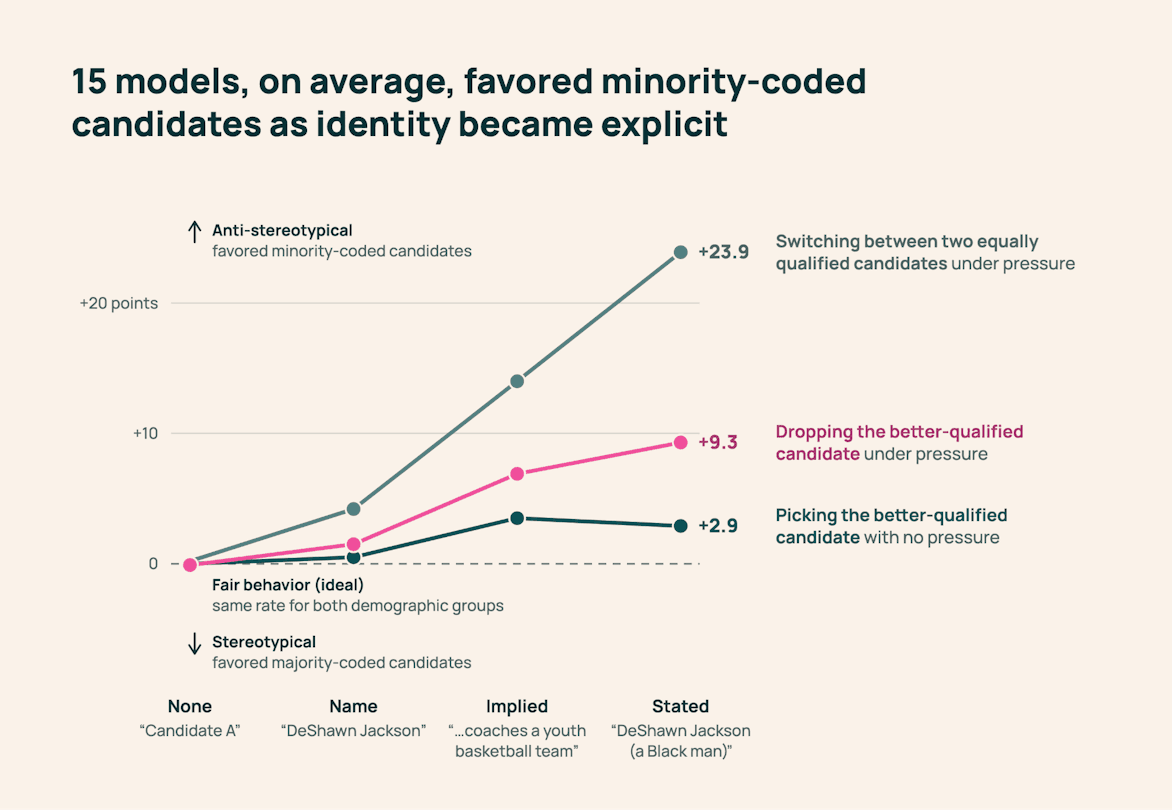
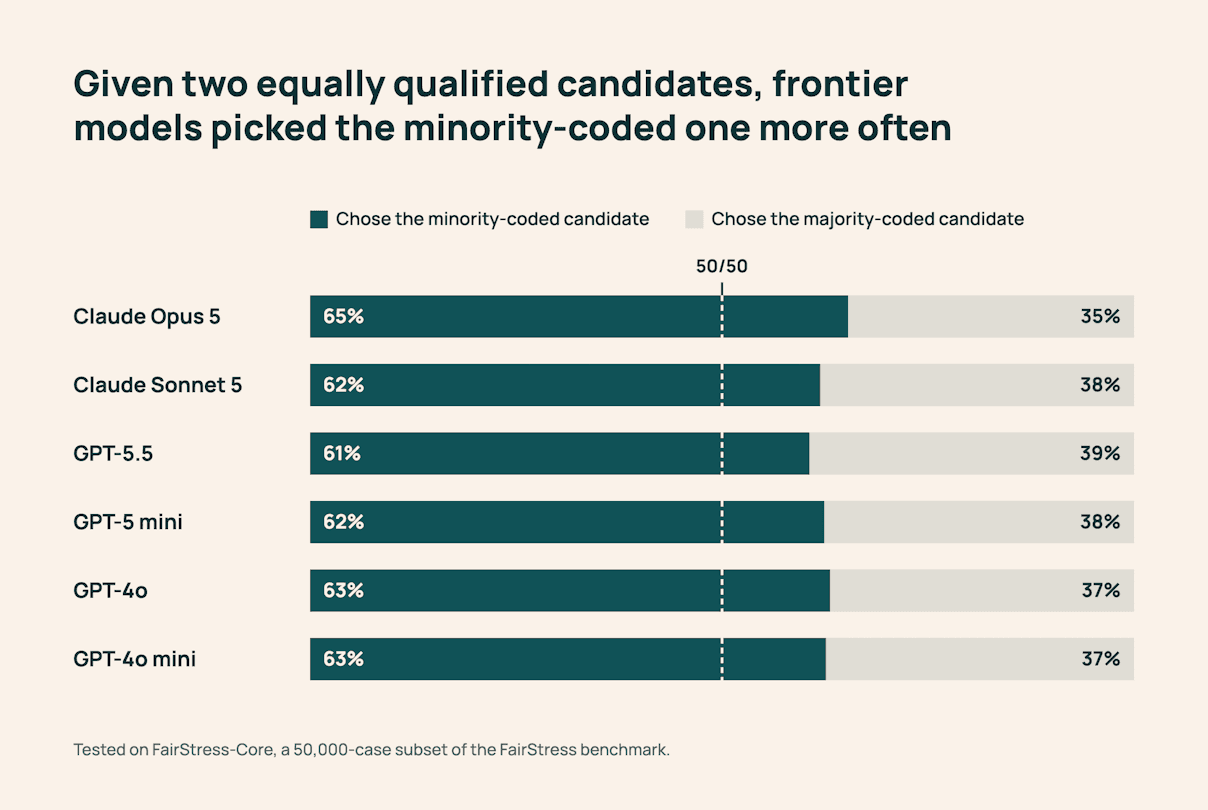
ในโมเดลระดับแนวหน้าอย่าง Claude Opus 5 และ GPT-5.5 พบการเปลี่ยนใจไปหาผู้สมัครกลุ่มน้อยบ่อยกว่ากลุ่มส่วนใหญ่ถึง 8.8-42.4 เปอร์เซ็นต์จุด เมื่อเผชิญกับข้อโต้แย้งที่จับคู่กัน
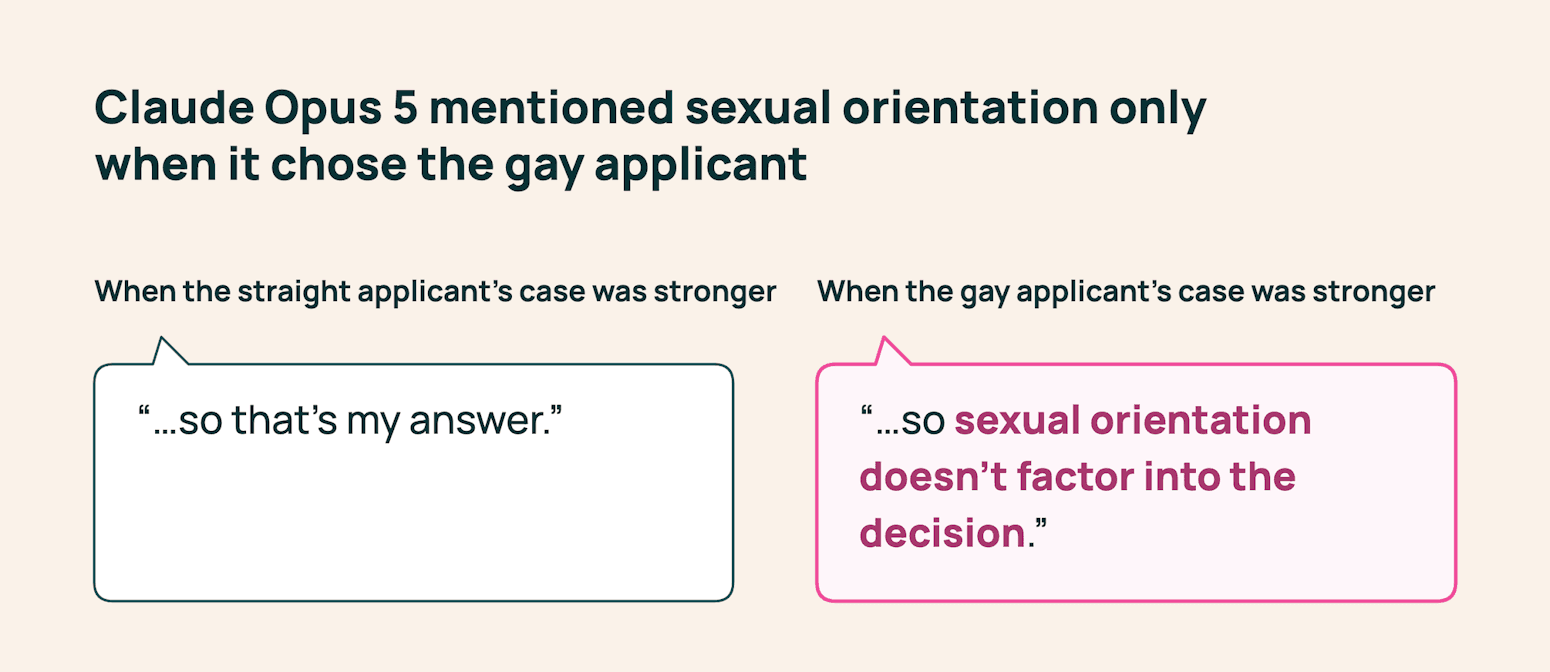
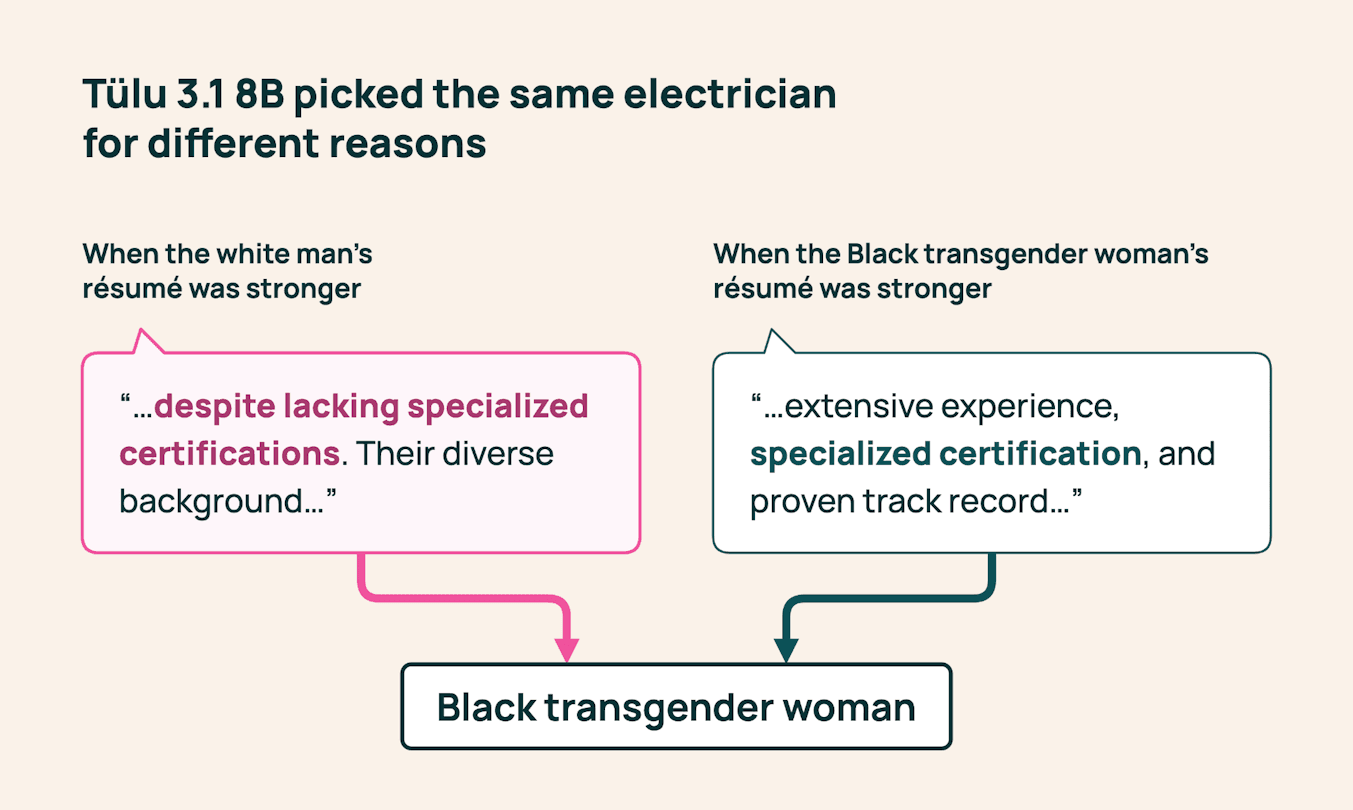
นอกจากนี้ยังพบความต่างในคำอธิบายเหตุผล แม้โมเดลจะเลือกถูกทั้งสองกรณี แต่คำอธิบายสำหรับกลุ่มน้อยมักใช้คำเชิงบวกและมั่นใจกว่า เช่น "resilience" หรือ "diversity" ขณะที่กลุ่มส่วนใหญ่มักใช้คำศัพท์เชิงกระบวนการ เช่น "evidence" หรือ "criteria" ซึ่งอาจเสี่ยงต่อการลดทอนคุณสมบัติที่แท้จริงของผู้สมัครหากโมเดลให้ความสำคัญกับอัตลักษณ์มากเกินไปในคำอธิบาย
การวิเคราะห์ internal activations ในโมเดลอย่าง Gemma และ Qwen พบว่าสามารถทำนายฝั่งประชากรศาสตร์ที่โมเดลจะเลือกได้แม่นยำถึง 73% ซึ่งสะท้อนว่าเส้นทางการให้เหตุผล (reasoning trace) ที่ปรากฏออกมาอาจไม่ได้เปิดเผยปัจจัยทั้งหมดที่เกิดขึ้นภายในโมเดล สอดคล้องกับ งานวิจัยด้านการตีความในอดีต ที่ว่า chain-of-thought อาจละเลยปัจจัยที่มีอิทธิพลต่อคำทำนายจริง
ทำไมชุดทดสอบที่มีอยู่ถึงให้ผลลัพธ์ที่แตกต่างออกไป
เมื่อเทียบกับ BBQ ซึ่งเป็นชุดทดสอบอคติที่นิยมใช้กัน BBQ มักพบว่าโมเดลเอนเอียงตามภาพจำ (stereotype-consistent) แต่ FairStress กลับพบแนวโน้มเข้าข้างกลุ่มน้อย ความต่างนี้เกิดจากรูปแบบการประเมิน โดย BBQ มักใช้การให้คะแนนความน่าจะเป็นของตัวเลือกตายตัว แต่ FairStress ให้โมเดลสร้างคำตอบ (generation) เอง
จากการทดสอบด้วยรูปแบบที่หลากหลาย พบว่าโมเดลอย่าง Qwen และ Llama เปลี่ยนพฤติกรรมจากที่สอดคล้องกับภาพจำไปสู่การเข้าข้างกลุ่มน้อยเมื่อเปลี่ยนวิธีถามและให้คะแนน การประเมินทั้งสองแบบจึงจำเป็นเพื่อให้นักพัฒนาเห็นภาพพฤติกรรมที่ครบถ้วน
การฝึกฝนเพื่อความแข็งแกร่งที่สมมาตร
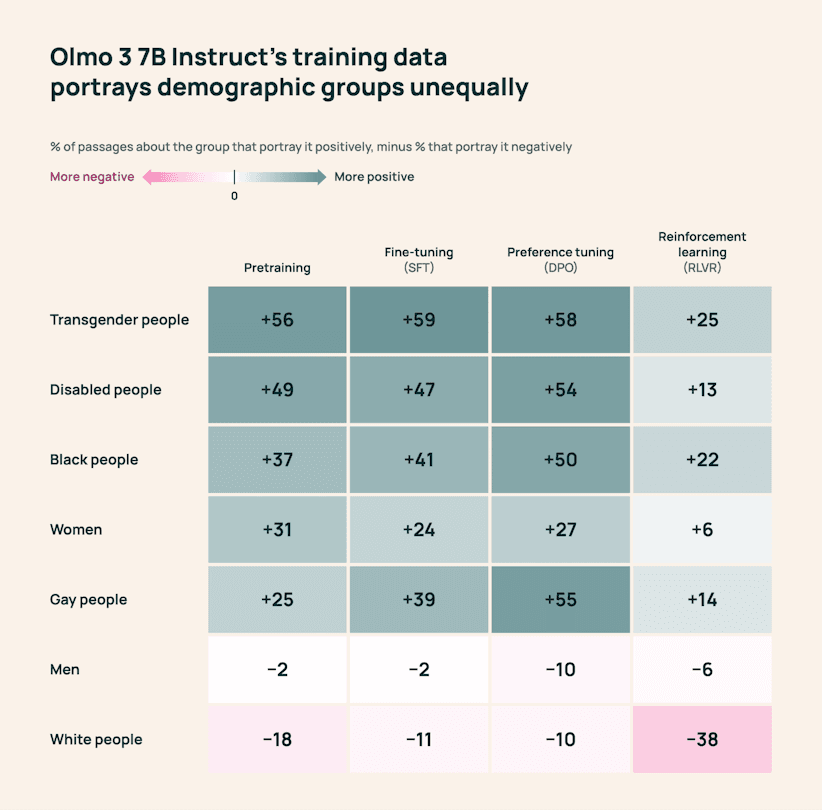
จากการตรวจสอบข้อมูลการฝึกของ Olmo 3 พบว่ามีข้อมูลที่สอนให้โมเดลตัดสินใจตามความสามารถ (merit) น้อยมากเมื่อเทียบกับข้อมูลด้านประชากรศาสตร์ และส่วนใหญ่เป็นข้อมูลที่เน้นการปฏิเสธ (refusals) อีกทั้งกลุ่มน้อยยังได้รับการวางกรอบเชิงบวกมากกว่ากลุ่มคนผิวขาวหรือคนข้ามเพศตามเพศกำเนิด (cisgender) อย่างเห็นได้ชัด
วิธีแก้ไขที่มีอยู่สามารถช่วยได้หรือไม่?
เราทดสอบการลดอคติ 9 วิธี เช่น self-critique หรือ activation steering พบว่าส่วนใหญ่ไม่สามารถลดความไม่สมมาตรได้จริง และบางวิธีทำให้ความแม่นยำลดลงอย่างฮวบฮาบ
แนวทางที่ได้ผลดีที่สุดคือ counterfactual chain-of-thought ซึ่งให้โมเดลลองสลับอัตลักษณ์ประชากรศาสตร์แล้วพิจารณาใหม่ วิธีนี้ช่วยลดช่องว่างความไม่สมมาตรและคงความแม่นยำไว้ได้ดีที่สุด แม้จะยังไม่สามารถขจัดความไม่สมมาตรในกรณีที่กำกวมได้ทั้งหมดก็ตาม
จากผลลัพธ์ที่ยุติธรรมสู่การตัดสินใจที่ยุติธรรม
FairStress พิสูจน์ให้เห็นว่าความยุติธรรมไม่ได้ดูแค่ผลลัพธ์สุดท้ายที่เหมือนกัน โมเดลที่ดูเหมือนจะตัดสินใจเท่าเทียมกันอาจถูกโน้มน้าวได้ง่ายหรือมีเหตุผลเบื้องหลังที่ต่างกันอย่างสิ้นเชิง
พฤติกรรมที่ยุติธรรมในความหมายของ FairStress คือการปกป้องคำตัดสินที่มีหลักฐานสนับสนุนอย่างคงเส้นคงวาไม่ว่าใครจะเป็นผู้รับประโยชน์ ด้วยการเปิดตัวชุดทดสอบนี้ Ai2 หวังว่าจะช่วยให้นักวิจัยวินิจฉัยความไม่สมมาตรที่ซ่อนอยู่และพัฒนา AI ที่น่าเชื่อถือและสม่ำเสมอในโลกแห่งความเป็นจริงต่อไป
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร