
สอนทำ Few-Shot Text Classification ง่ายๆ ด้วย Scikit-LLM
Introduction
หากคุณเคยสร้างโมเดลสำหรับจำแนกประเภทข้อความ (text classification) คุณคงคุ้นเคยกับขั้นตอนปกติ ตั้งแต่การรวบรวมตัวอย่างที่ติด label หลายพันรายการ การทำความสะอาดข้อมูล ไปจนถึงการแปลงข้อความเป็นตัวแทนตัวเลขอย่าง embeddings หรือ TF-IDF เพื่อฝึกสอนโมเดล เช่น logistic regression หรือ random forest
อย่างไรก็ตาม การอุบัติขึ้นของ Large Language Models (LLMs) ได้เปลี่ยนกฎของเกมและ pipeline ของ machine learning แบบดั้งเดิมไปอย่างมาก ในปัจจุบันเราสามารถจำแนกประเภทข้อความได้ง่ายๆ เพียงแค่ขอให้ LLM ทำหน้าที่นั้น แต่ความท้าทายคือการเปลี่ยนจาก workflow แบบคลาสสิกไปสู่ prompt engineering
Scikit-LLM คือ Python library ที่เข้ามาเชื่อมช่องว่างระหว่างทั้งสองโลก โดยการนำความสามารถอันทรงพลังของ LLMs ที่ถูก pre-trained มาห่อหุ้มไว้ภายใต้ interface ของ scikit-learn ที่คุ้นเคยอย่าง fit() และ predict()
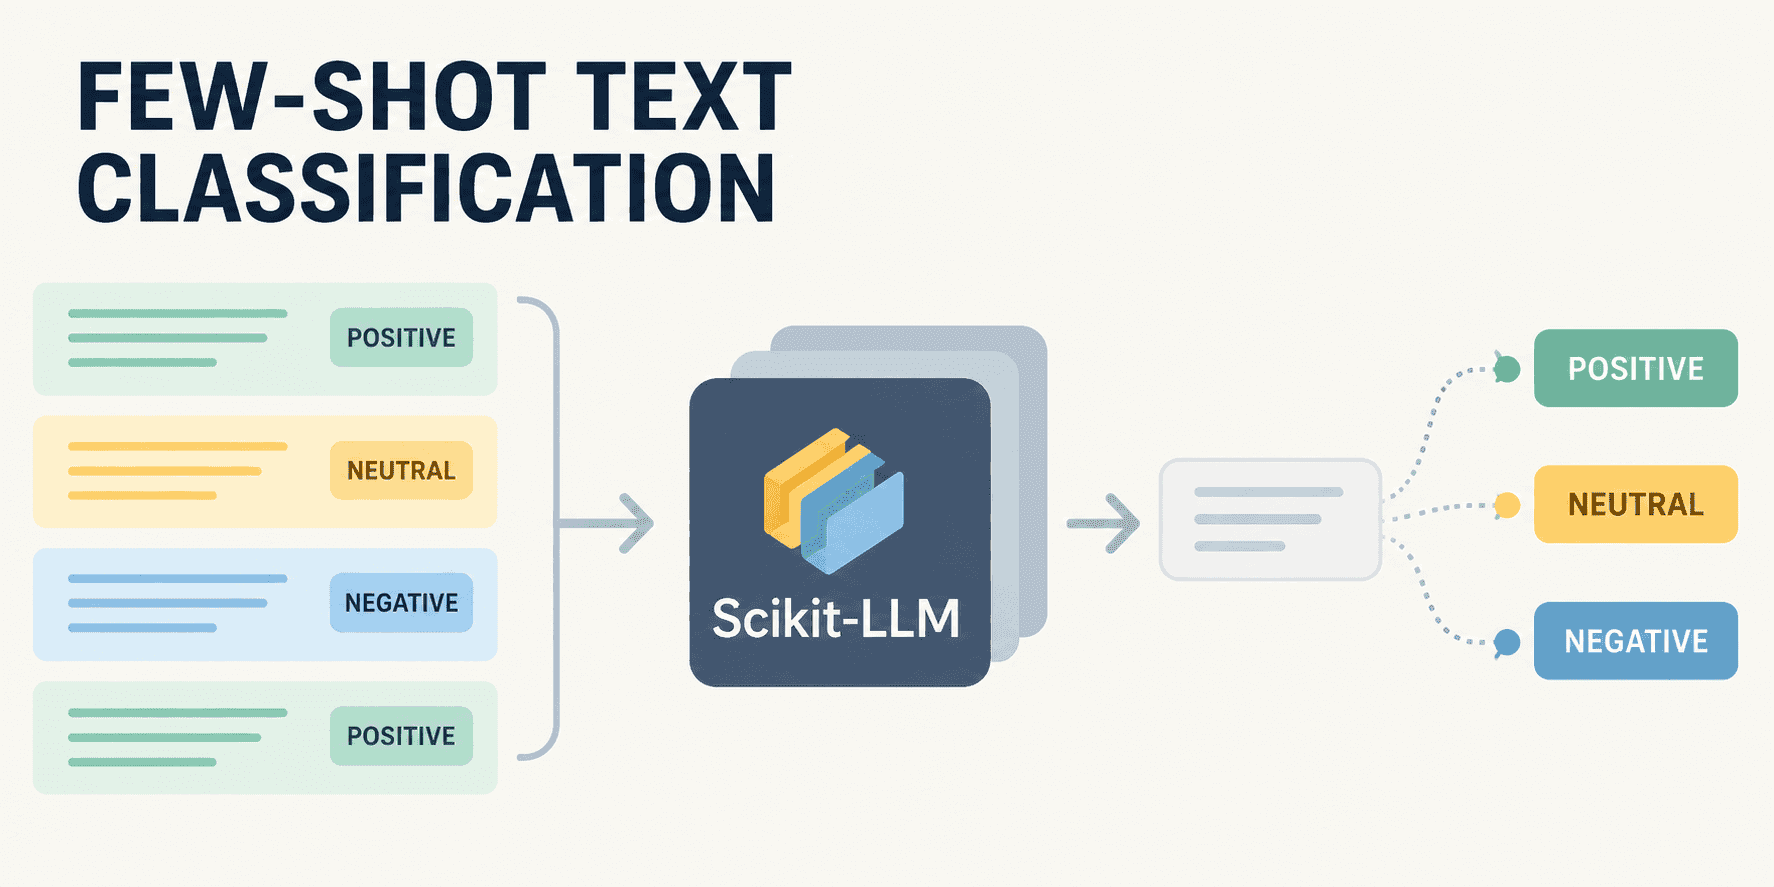
บทความนี้จะแสดงวิธีใช้ Scikit-LLM สำหรับงาน few-shot classification ซึ่งเป็นการจำแนกประเภทข้อความโดยอิงจากตัวอย่างที่ติด label เพียงจำนวนเล็กน้อย เพื่อนำทาง LLM ว่าต้องจัดการกับข้อมูลอย่างไร
Zero-Shot vs. Few-Shot Classification
ก่อนจะเริ่มลงมือเขียนโค้ด เราควรทำความเข้าใจความแตกต่างระหว่าง few-shot classification และรูปแบบยอดนิยมอย่าง zero-shot classification เสียก่อน
- Zero-shot classification: โมเดลจะได้รับข้อความพร้อมรายการ label และถูกขอให้จัดหมวดหมู่โดยไม่มีตัวอย่าง input-output ใดๆ เลย ซึ่งอาศัยเพียงความรู้ภายในของ LLM ที่ได้จากการ pre-training เท่านั้น
- Few-shot classification: จะมีการส่งชุดตัวอย่างขนาดเล็กที่ติด label แล้ว หรือ "shots" ไปให้โมเดลก่อน เพื่อเป็นแนวทางในการจำแนกข้อความใหม่ ตัวอย่างเหล่านี้จะช่วยเสริมความรู้และนำทางกระบวนการใช้เหตุผลได้ดียิ่งขึ้น โดยทั่วไป few-shot classification จะให้ผลลัพธ์ที่ดีกว่าสำหรับงานเฉพาะทางที่มีศัพท์เฉพาะ (jargon), กรณีที่พบได้ยาก (edge cases) หรือความรู้สึกที่ละเอียดอ่อน (nuanced sentiments) การให้ตัวอย่างเพียง 3 ถึง 5 รายการก็เพียงพอที่จะ "สอน" โมเดลได้โดยไม่ต้องทำการ retraining ใหม่ทั้งตัว
Running Few-Shot Classification with Scikit-LLM, Step by Step
ตัวอย่างนี้สามารถรันบน Google Colab โดยใช้ LLM API ของ Groq ซึ่งให้บริการฟรี เพียงแค่สมัครสมาชิกและสร้าง API key จากนั้นนำไปใส่ในฟีเจอร์ "Secrets" (ไอคอนรูปกุญแจ) ของ Colab โดยตั้งชื่อว่า GROQ_API_KEY แล้วจึงติดตั้ง library ดังนี้:
!pip install scikit-llm -qแม้ Scikit-LLM จะถูกสร้างมาเพื่อรองรับ OpenAI แต่ API ของ Groq ก็สามารถใช้งานร่วมกันได้ โดยใช้โค้ดต่อไปนี้ในการตั้งค่า endpoint:
from google.colab import userdata
from skllm.config import SKLLMConfig

# Retrieve the API key securely from Google Colab Secrets
groq_key = userdata.get('GROQ_API_KEY')

# Point scikit-LLM to Groq's OpenAI-compatible endpoint
SKLLMConfig.set_gpt_url("https://api.groq.com/openai/v1")
SKLLMConfig.set_openai_key(groq_key)
ถัดไปคือการเตรียมชุดข้อมูล สำหรับ few-shot classification เราต้องการเพียงตัวอย่างที่เป็นตัวแทนของแต่ละหมวดหมู่ สมมติว่าเราต้องการจำแนกตั๋วแจ้งปัญหา IT support เป็น 3 หมวดหมู่ เราจะกำหนด X_train และ y_train ดังนี้:
# Our "Few-Shot" examples to teach the model the nuances
X_train = [
    "My laptop screen is flickering heavily.",
    "I need a new mouse, the scroll wheel is broken.",
    "Excel keeps crashing every time I open a macro.",
    "How do I update to the latest version of Photoshop?",
    "I forgot my VPN password.",
    "Can you grant me admin rights to the shared drive?"
]

y_train = [
    "Hardware",
    "Hardware",
    "Software",
    "Software",
    "Access",
    "Access"
]

# The unseen data we want to actually predict
X_test = [
    "The keyboard types double letters randomly.",
    "I am locked out of my email account.",
    "Zoom freezes when I share my screen."
]
ในการใช้งาน เราจะเรียกใช้ class FewShotGPTClassifier ซึ่งจะห่อหุ้มโมเดล LLM ที่เราเลือกไว้ เพื่อให้ใช้งานได้เหมือนกับโมเดล machine learning ทั่วไป:
from skllm.models.gpt.classification.few_shot import FewShotGPTClassifier

# Use a confirmed 2026 free-tier model on Groq, ensuring the custom_url:: prefix is present
clf = FewShotGPTClassifier(model="custom_url::openai/gpt-oss-20b")

# "Train" the model (constructs the few-shot prompt memory)
clf.fit(X_train, y_train)
สิ่งที่ควรทราบคือคำสั่ง fit() ไม่ได้ทำการอัปเดตน้ำหนักของโมเดลจริง แต่เป็นการสร้าง few-shot prompt memory เพื่อให้โมเดลใช้อ้างอิงในการหาคำตอบ จากนั้นเราสามารถสั่ง predict() เพื่อดูผลลัพธ์ได้ทันที:
# Generate predictions
predictions = clf.predict(X_test)

# Display the results
for text, label in zip(X_test, predictions):
    print(f"Ticket: '{text}'\nPredicted Category: {label}\n")
ผลลัพธ์ที่ได้จะแสดงการจำแนกประเภทที่ถูกต้องตามที่เราคาดการณ์ไว้:
Ticket: 'The keyboard types double letters randomly.'
Predicted Category: Hardware

Ticket: 'I am locked out of my email account.'
Predicted Category: Access

Ticket: 'Zoom freezes when I share my screen.'
Predicted Category: Software
Wrapping Up
การออกแบบที่ยอดเยี่ยมของ Scikit-LLM ช่วยให้คุณเปลี่ยน LLMs แบบเปิดให้กลายเป็นกลไก machine learning เฉพาะทางได้โดยไม่ต้องฝึกสอนโมเดลใหม่ให้ยุ่งยาก และไม่จำเป็นต้องใช้โมเดลขนาดใหญ่ที่มีค่าใช้จ่ายสูง เพียงแค่มีตัวอย่างที่ติด label ไม่กี่รายการ คุณก็สามารถจำแนกประเภทข้อความได้อย่างแม่นยำแล้ว
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร