
เปลี่ยนเอกสารยุ่งเหยิงเป็นข้อมูลโครงสร้างด้วย Docling
ใน shared drive ของหลายองค์กร มักมีรายงาน PDF หนาเป็นร้อยหน้าที่เราต้องการเพียงตัวเลขแค่ 3 ตัว แต่เมื่อพยายามคัดลอกตารางมาวางในสเปรดชีต ข้อมูลกลับยุบรวมเป็นเซลล์เดียวจนอ่านไม่ออก สุดท้ายจึงต้องลงมือพิมพ์ใหม่ทีละแถวเพราะการเขียนตัวแยกวิเคราะห์ (parser) เฉพาะกิจนั้นดูไม่คุ้มค่ากับเวลาที่เสียไป
ความพ่ายแพ้เล็กๆ ที่เกิดขึ้นซ้ำซากนี้คือเหตุผลที่ Docling ถูกสร้างขึ้นมา ไม่ใช่เพื่อจัดระเบียบต้นฉบับให้เรียบร้อยขึ้น แต่เพื่อให้คุณมีวิธีที่เชื่อถือได้ในการเปลี่ยนความยุ่งเหยิง ไม่ว่าจะเป็นใบแจ้งหนี้สแกน งานวิจัยหลายคอลัมน์ หรือสไลด์ PowerPoint ให้กลายเป็นข้อมูลที่โปรแกรมประมวลผลต่อได้จริง บทความนี้จะพาคุณไปทำความรู้จักตั้งแต่ขั้นพื้นฐานไปจนถึงการสกัดข้อมูลตาม schema พร้อมรหัสโค้ดที่ใช้งานได้ทันที
Docling คืออะไรกันแน่
Docling เป็นชุดเครื่องมือโอเพนซอร์สที่พัฒนาโดยทีม AI for Knowledge ณ IBM Research Zurich และปัจจุบันอยู่ภายใต้การดูแลของ LF AI & Data Foundation ภายใต้สัญญาอนุญาต MIT ณ ขณะนี้ GitHub repository ของโครงการมียอดดาวกว่า 64,000 ดวง และมีการฟอร์ก (fork) เกือบ 4,600 ครั้ง ซึ่งยืนยันความสามารถด้วย รายงานทางเทคนิค ที่น่าเชื่อถือ
สรุปสั้นๆ คือ Docling รับเอกสารที่รูปแบบไม่สอดคล้องกันมาแปลงเป็นโครงสร้างที่เป็นหนึ่งเดียว เพื่อให้ระบบปลายน้ำไม่ต้องเสียเวลานั่งเดาความหมายจากข้อความดิบๆ ที่สกัดออกมา
ทำไมเอกสารที่ยุ่งเหยิงจึงเป็นปัญหาที่ยากอย่างแท้จริง
คำว่า "PDF มันน่ารำคาญ" อาจดูเบาไปเมื่อเทียบกับปัญหาทางเทคนิคจริง เพราะ PDF มาตรฐานไม่มีแนวคิดเรื่องตารางหรือย่อหน้า มีเพียงข้อความที่วางตามพิกัดหน้ากระดาษ หากใช้ตัวสกัดทั่วไปอ่านจากซ้ายไปขวา รายงานแบบสองคอลัมน์จะกลายเป็นข้อความที่สลับกันมั่ว หรือตารางที่เคยสะอาดตาจะกลายเป็นกำแพงตัวเลขที่แยกไม่ออกว่าค่าไหนเป็นของแถวหรือคอลัมน์ใด
เอกสารสแกนยิ่งเพิ่มความซับซ้อนเพราะไม่มีเลเยอร์ข้อความ ต้องพึ่งพาเอนจิน OCR ในการคาดเดาตัวอักษร นอกจากนี้ยังมีหัวกระดาษ ท้ายกระดาษ สูตรคำนวณ และบล็อกโค้ด ที่อาจกลายเป็นสัญญาณรบกวนหากจัดการไม่ดี สิ่งเหล่านี้ไม่ใช่กรณีพิเศษ แต่เป็นลักษณะปกติของเอกสารที่คนทำงานต้องเจอ ซึ่ง Docling ถูกออกแบบมาเพื่อจัดการภาระเหล่านี้โดยเฉพาะ
ทัวร์ชมสิ่งที่ Docling สามารถทำได้จริง
ขอบเขตของ Docling กว้างขวางกว่าแค่การแปลง PDF เป็นข้อความ ตามรายละเอียดบน เว็บไซต์ของ Docling เอง ชุดเครื่องมือนี้รองรับการนำเข้าและส่งออกข้อมูลที่ตอบโจทย์ pipeline เอกสารส่วนใหญ่ ดังนี้
| หมวดหมู่ | สิ่งที่ครอบคลุม |
|---|---|
| นำเข้า | PDF, DOCX, PPTX, Markdown, HTML, AsciiDoc, WebVTT, XLSX, CSV และรูปภาพ (PNG, JPEG, TIFF, BMP, WEBP) รวมถึงเสียง (MP3, WAV) |
| ส่งออก | JSON, Doctags, Markdown, HTML และข้อความธรรมดา |
| สกัด | รูปภาพและเลขหน้า, หัวกระดาษและท้ายกระดาษ, ย่อหน้า, รายการ (list items), บล็อกโค้ด, สูตรคำนวณ, ลำดับการอ่าน, ชิ้นส่วนข้อมูลสำเร็จรูป (ready-made chunks), โครงสร้างตารางและเซลล์, การจำแนกประเภทรูปภาพและคำบรรยายภาพ และขอบเขต (bounding boxes) สำหรับทุกองค์ประกอบ |
สิ่งที่ทำให้ Docling โดดเด่นคือความสามารถในการระบุประเภทเนื้อหาและรักษาความสัมพันธ์ระหว่างชิ้นส่วนเหล่านั้นไว้ ไม่ว่าจะเป็นคำบรรยายภาพหรือเซลล์ตาราง ซึ่งเป็นรากฐานสำคัญของการประมวลผลข้อมูลขั้นสูง
ข้อกำหนดเบื้องต้น
ก่อนเริ่มใช้งาน คุณต้องเตรียมสิ่งต่อไปนี้:
- Python 3.10 ขึ้นไป (ยกเลิกการรองรับ 3.9 ตั้งแต่เวอร์ชัน 2.70.0)
- Pip สำหรับการติดตั้ง
- พื้นฐานการรันสคริปต์ Python ผ่านเทอร์มินัล
จุดเด่นสำคัญคือ Docling รันโมเดลหลักในเครื่อง (locally) โดยไม่ต้องใช้ API key หรืออินเทอร์เน็ต จึงปลอดภัยสำหรับการประมวลผลข้อมูลที่ละเอียดอ่อน เช่น สัญญาหรือรายงานการเงินภายในองค์กร
ขั้นตอนที่ 1: การติดตั้ง Docling และการรันการแปลงครั้งแรกของคุณ
ติดตั้งง่ายๆ ผ่านเทอร์มินัลด้วยคำสั่งเดียว:
pip install doclingเมื่อติดตั้งแล้ว คุณสามารถทดสอบแปลงเอกสารผ่าน URL ได้ทันทีตาม คู่มือเริ่มต้นฉบับย่อ:
# แปลงเอกสารจาก URL และบันทึกเป็นไฟล์ .md
docling https://arxiv.org/pdf/2206.01062
สำหรับการนำไปพัฒนาระบบต่อ การใช้งานผ่าน Python API จะยืดหยุ่นกว่า:
from docling.document_converter import DocumentConverter

# ระบุแหล่งข้อมูล (ไฟล์ในเครื่อง หรือ URL)
source = "https://arxiv.org/pdf/2408.09869"

# DocumentConverter จะเลือก pipeline ที่เหมาะสมให้อัตโนมัติ
converter = DocumentConverter()

# รันการวิเคราะห์เลย์เอาต์ โครงสร้างตาราง และลำดับการอ่าน
result = converter.convert(source)

# ดึงวัตถุ DoclingDocument มาใช้งาน
doc = result.document

print(doc.export_to_markdown())
เบื้องหลังโค้ดไม่กี่บรรทัดนี้คือกระบวนการที่ซับซ้อน ตั้งแต่การเลือก backend การวิเคราะห์เลย์เอาต์ ไปจนถึงการทำ OCR โดยที่คุณไม่ต้องตั้งค่าเอง สิ่งสำคัญคือการทำความเข้าใจกับ DoclingDocument ซึ่งเป็นผลลัพธ์ที่จะนำไปใช้ต่อในขั้นตอนอื่นๆ
ขั้นตอนที่ 2: ทำความเข้าใจ DoclingDocument
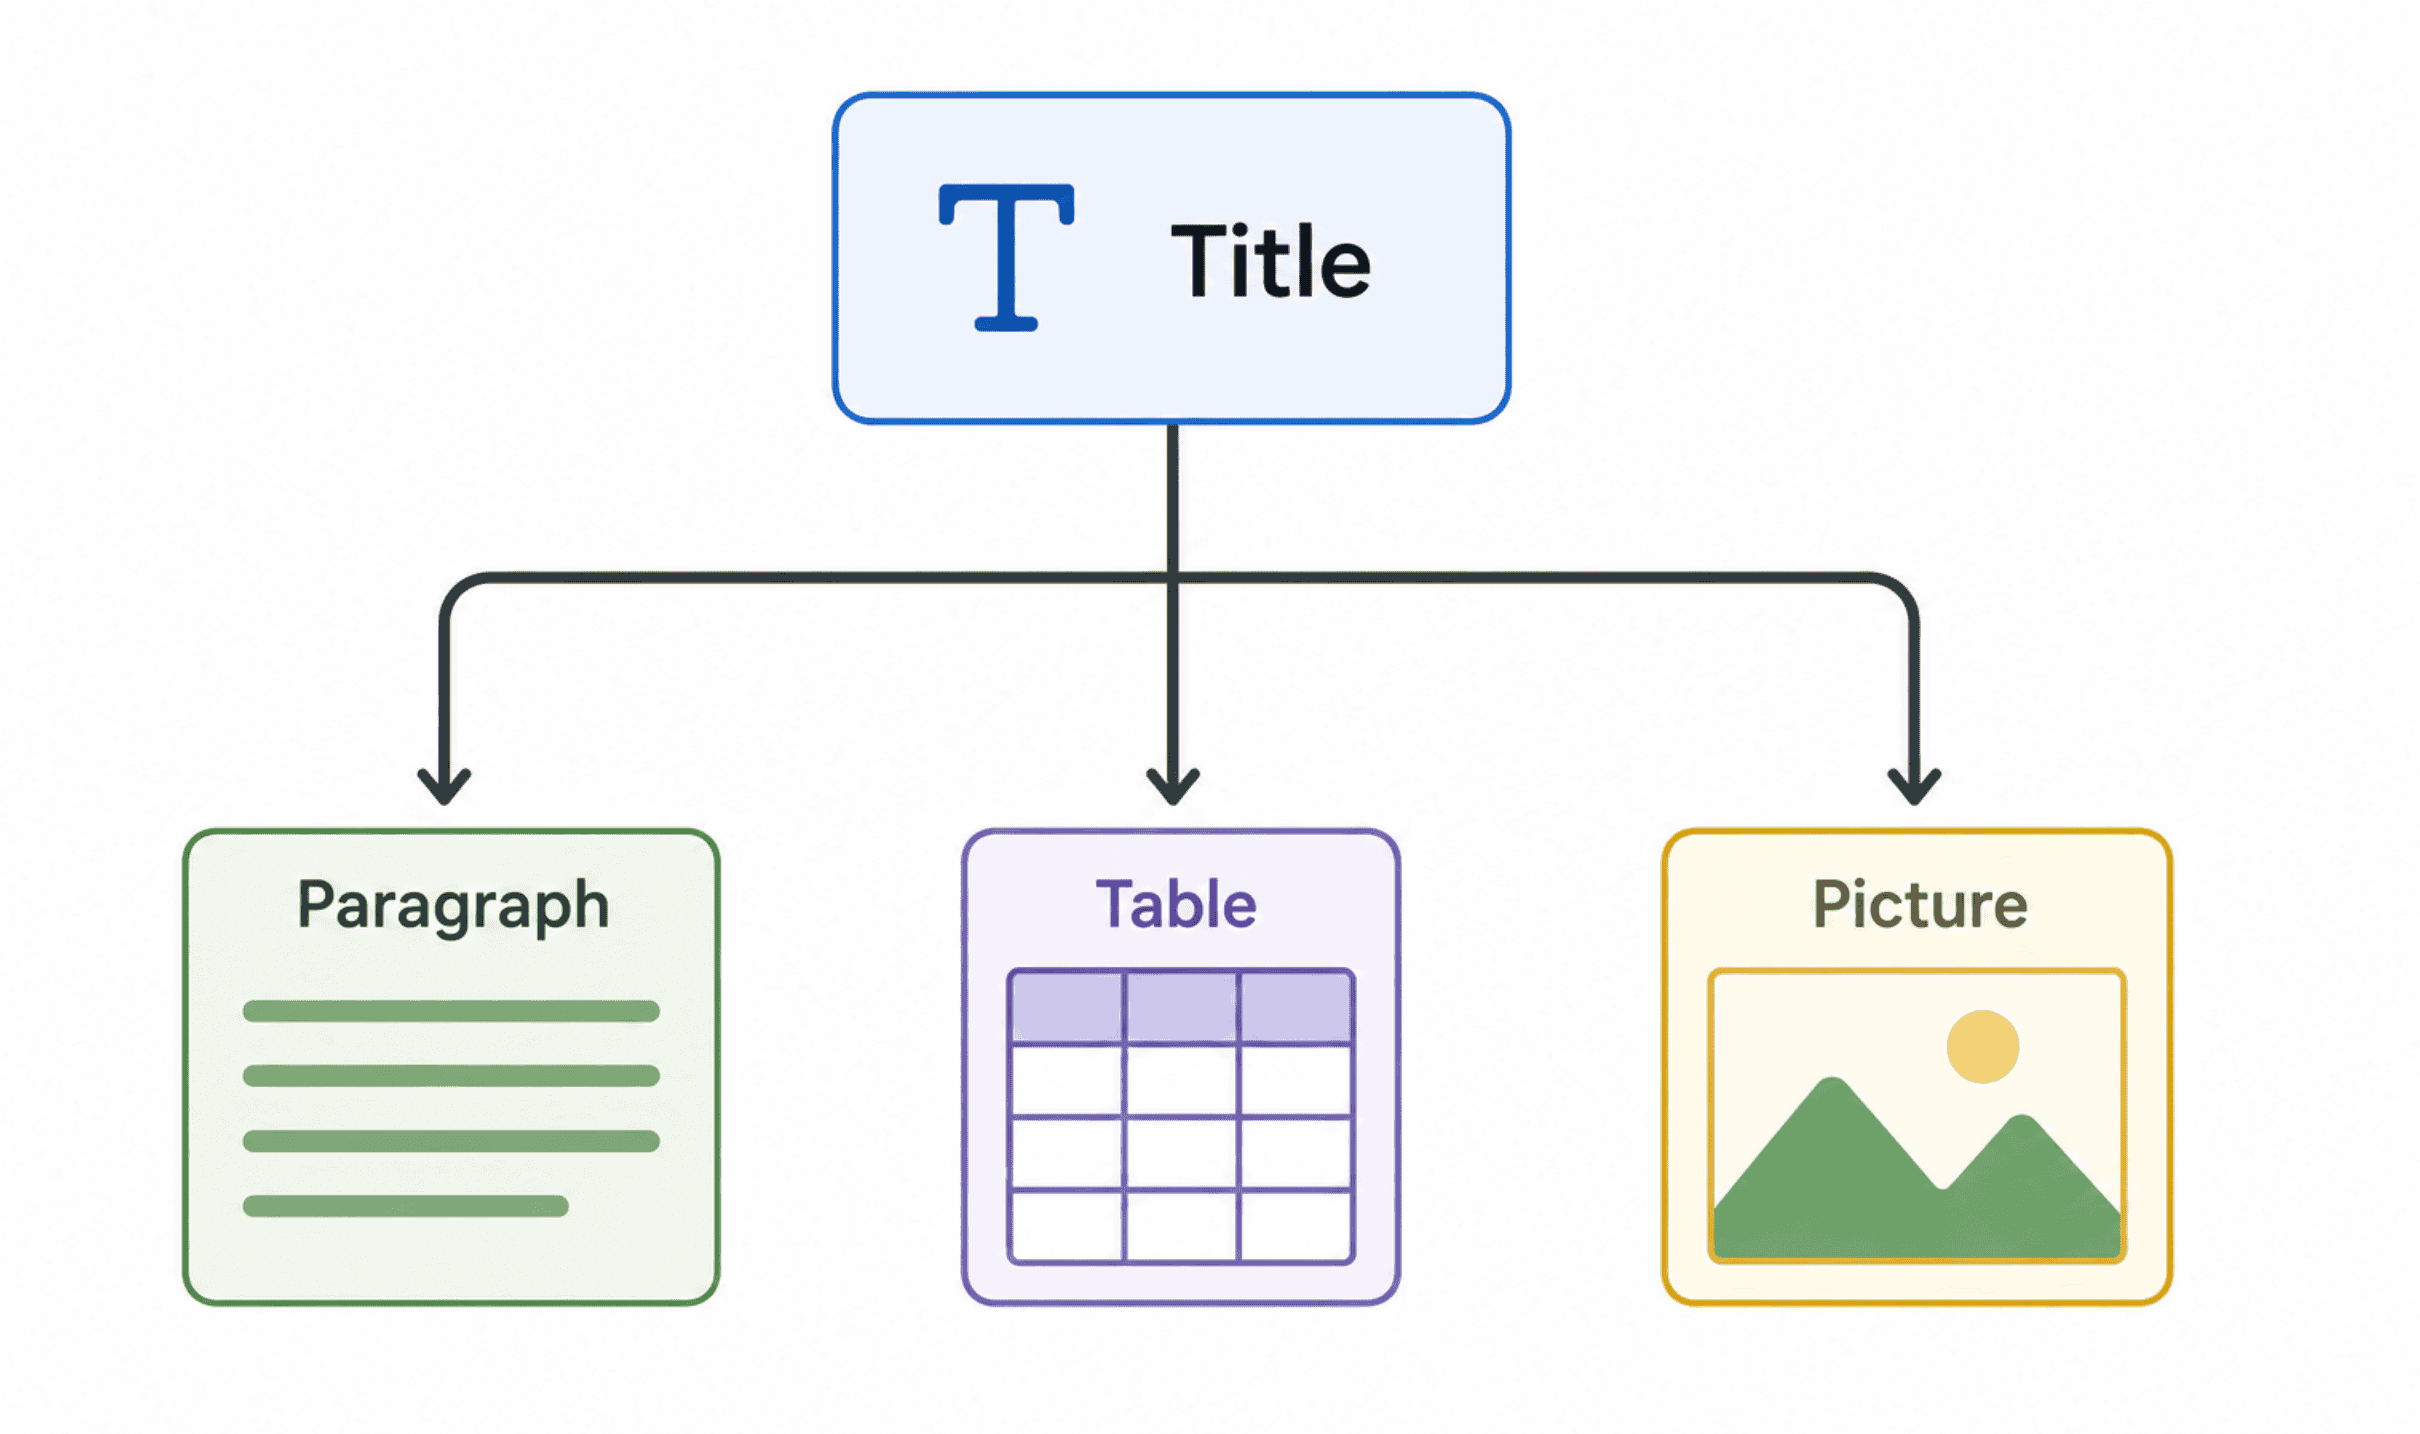
Docling แปลงทุกไฟล์ให้เป็นโครงสร้างมาตรฐานที่เรียกว่า DoclingDocument ซึ่งจัดระเบียบเนื้อหาเป็น 2 หมวดหมู่หลัก ได้แก่ รายการเนื้อหา (texts, tables, pictures, key_value_items) และโครงสร้างเนื้อหา (body, furniture, groups) เพื่อรักษารูปทรงและลำดับการอ่านของเอกสารต้นฉบับ
โครงสร้างต้นไม้ใน body คือคีย์สำคัญที่ช่วยแก้ปัญหาลำดับการอ่าน โดยจะเก็บเนื้อหาเป็นโหนด (node) ที่ซ้อนกันตามความสัมพันธ์จริง เช่น ย่อหน้าที่อยู่ภายใต้หัวข้อหนึ่งๆ ทำให้ระบบเข้าใจบริบทได้เหมือนที่มนุษย์อ่าน
ขั้นตอนที่ 3: การส่งออกไปยังรูปแบบที่ Pipeline ของคุณต้องการ
คุณสามารถเลือกส่งออกข้อมูลได้หลากหลายรูปแบบตามความต้องการของระบบปลายน้ำ:
from docling.document_converter import DocumentConverter

converter = DocumentConverter()
doc = converter.convert("quarterly_report.pdf").document

# Markdown: เหมาะสำหรับ LLM prompt หรือ RAG pipeline
markdown_output = doc.export_to_markdown()

# JSON: เก็บข้อมูลครบถ้วน เหมาะสำหรับการแยกวิเคราะห์ด้วยโปรแกรม
json_output = doc.export_to_dict()

# HTML: สำหรับการแสดงผลผ่านเบราว์เซอร์โดยรักษาโครงสร้างทางสายตา
html_output = doc.export_to_html()
ขั้นตอนที่ 4: การจัดการกับสิ่งที่ยุ่งเหยิงอย่างแท้จริง
สำหรับเอกสารสแกนที่ไม่มีเลเยอร์ข้อความ Docling สามารถเปิดใช้งาน OCR และการวิเคราะห์โครงสร้างตารางเชิงลึกได้:
from docling.document_converter import DocumentConverter, PdfFormatOption
from docling.datamodel.pipeline_options import PdfPipelineOptions
from docling.datamodel.base_models import InputFormat

pipeline_options = PdfPipelineOptions()
pipeline_options.do_ocr = True
pipeline_options.do_table_structure = True

converter = DocumentConverter(
    format_options={
        InputFormat.PDF: PdfFormatOption(pipeline_options=pipeline_options)
    }
)

doc = converter.convert("scanned_invoice.pdf").document
print(doc.export_to_markdown())
ฟีเจอร์ do_table_structure โดดเด่นกว่าตัวสกัดทั่วไปตรงที่สามารถสร้างแถว คอลัมน์ และส่วนหัวหลายระดับขึ้นมาใหม่ได้ แม้กระทั่งในเซลล์ที่มีข้อมูลซ้อนกันอย่างซับซ้อน
ขั้นตอนที่ 5: การแบ่งชิ้นส่วนเอกสารสำหรับ RAG และ AI Pipeline
การแบ่งชิ้นส่วนข้อมูล (chunking) ที่ดีต้องไม่ตัดประโยคขาดกลางหรือแยกหัวตารางออกจากข้อมูล HybridChunker ของ Docling จึงเริ่มแบ่งจากโครงสร้างจริงของเอกสารและปรับแต่งตามโทเค็นเพื่อให้ได้ชิ้นส่วนที่มีบริบทครบถ้วน
from docling.document_converter import DocumentConverter
from docling.chunking import HybridChunker

converter = DocumentConverter()
doc = converter.convert("employee_handbook.pdf").document

chunker = HybridChunker()
chunks = list(chunker.chunk(dl_doc=doc))

for chunk in chunks[:3]:
    # contextualize() จะช่วยเติม metadata เช่น หัวข้อส่วนนั้นๆ เข้าไปในชิ้นส่วนข้อความ
    print(chunker.contextualize(chunk))
    print("---")
ขั้นตอนที่ 6: การสกัดข้อมูลตามโครงสร้าง Schema
นี่คือฟีเจอร์เด็ดที่เปลี่ยนเอกสารให้เป็นข้อมูลเฉพาะที่คุณต้องการ โดยใช้โมเดล Pydantic เพื่อกำหนด schema และรับข้อมูลที่ผ่านการตรวจสอบประเภท (typed data) กลับมา
from docling.document_extractor import DocumentExtractor
from pydantic import BaseModel, Field
from typing import Optional

extractor = DocumentExtractor(allowed_formats=[InputFormat.IMAGE, InputFormat.PDF])

class Invoice(BaseModel):
    bill_no: str = Field(examples=["A123"])
    total: float = Field(default=10, examples=[20])
    tax_id: Optional[str] = Field(default=None)

result = extractor.extract(source="invoice_scan.jpg", template=Invoice)
print(result.pages[0].extracted_data)
การใช้ Field(examples=[...]) ช่วยให้โมเดลมีความแม่นยำสูงขึ้นในการระบุข้อมูลที่อาจกำกวม นอกจากนี้คุณยังสามารถใช้โมเดล Pydantic แบบซ้อน (nested) เพื่อสกัดข้อมูลที่ซับซ้อน เช่น ชื่อและที่อยู่ของผู้ส่งและผู้รับ ได้อย่างมีระบบ
สิ่งนี้เหมาะสมตรงไหนใน Pipeline จริง
Docling รองรับการผสานการทำงานกับเฟรมเวิร์กยอดนิยมอย่าง LangChain, LlamaIndex, และ Haystack นอกจากนี้ยังมี เซิร์ฟเวอร์ MCP สำหรับ AI agent เรียกใช้งานเครื่องมือได้โดยตรง
หากไม่ต้องการรันเอง คุณสามารถใช้ Docling Serve เพื่อทำ REST API หรือใช้บริการบน watsonx จาก IBM ที่เริ่มให้บริการตั้งแต่วันที่ 15 มิถุนายน 2026 ซึ่งเป็นเอนจินตัวเดียวกัน
สิ่งที่กำลังจะมาถึง และสิ่งที่ควรระวัง
ปัจจุบัน Docling ยังคงพัฒนาฟีเจอร์ใหม่ๆ เช่น การสกัด metadata อัตโนมัติ และการวิเคราะห์โครงสร้างโมเลกุลทางเคมีที่ซับซ้อน ซึ่งระบุไว้ในโร้ดแมปว่ากำลังจะมาในเร็วๆ นี้
ในแง่ทรัพยากร เนื่องจากการประมวลผลเกิดขึ้นในเครื่อง ระยะเวลาและหน่วยความจำที่ใช้จะขึ้นอยู่กับความซับซ้อนของเอกสาร สำหรับการประมวลผลในระดับสเกลใหญ่ การใช้ GPU จะช่วยเพิ่มประสิทธิภาพได้อย่างมีนัยสำคัญ
บทสรุป
ความคุ้มค่าที่แท้จริงของ Docling ไม่ใช่แค่การเปลี่ยนไฟล์จากฟอร์แมตหนึ่งไปสู่อีกฟอร์แมตหนึ่ง แต่คือการเปลี่ยนข้อมูลที่มนุษย์ต้องนั่งอ่านเอง ให้กลายเป็นข้อมูลที่โปรแกรมเชื่อถือและนำไปใช้งานต่อได้ทันที โดยไม่ต้องเสียเวลาคัดลอกและวางด้วยมืออีกต่อไป
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร