
Google เปิดตัว Harness² โอเพนซอร์ส AI Agent ปรับปรุงตัวเองได้
Google Research ได้เปิดตัวโอเพนซอร์ส Harness² (หรือ Harness2) ซึ่งเป็นเฟรมเวิร์กที่ช่วยให้ AI agent ปรับปรุงตัวเองได้โดยไม่ต้องเทรนโมเดลพื้นฐานใหม่ แทนที่จะไปยุ่งกับ model weights Harness² จะทำการเขียน "harness" (ส่วนควบคุม) รอบโมเดลใหม่ ไม่ว่าจะเป็น prompt, เครื่องมือ, หน่วยความจำ, ทักษะ และสคริปต์ จากนั้นมันจะนำสิ่งที่เรียนรู้ไปใช้ในงานถัดไป
โค้ดนี้เผยแพร่ภายใต้ Apache 2.0 license พร้อมกับเอกสารงานวิจัย Harness²: Recursive Agent Harnessing for an Open World และ เว็บไซต์โครงการ ซึ่งการเปิดตัวครั้งนี้เริ่มเป็นที่ พูดถึงบน X เป็นวงกว้าง
บทความนี้จะอธิบายการทำงานของ Harness² และผลการทดสอบ benchmark จากนั้นจะพาคุณไปดูเดโมฟรีของ Google และการรัน benchmark จริงบน Vertex AI หากคุณกำลังมองหาเฟรมเวิร์ก agent แบบโอเพนซอร์สสำหรับ AI agent ที่พัฒนาตัวเองได้ ให้เริ่มศึกษาจากที่นี่ได้เลย
Harness² คืออะไร?
harness คือทุกสิ่งที่อยู่รอบโมเดลซึ่งช่วยให้มันทำงานในฐานะ agent ได้ เช่น prompt, เครื่องมือ, หน่วยความจำ, ทักษะ และการจัดการ (orchestration) ส่วน Harnessing คือกระบวนการปรับแต่งสิ่งเหล่านั้น
ปัจจุบันทีมส่วนใหญ่ยังคงใช้วิธีปรับแต่งด้วยมือ โดยวิศวกรต้องเฝ้าดู agent ทำงานพลาดแล้วค่อยแก้ prompt หรือเพิ่มเครื่องมือ แต่วิธีนี้มักล้มเหลวในสถานการณ์ที่เรียกว่า open world ซึ่ง agent ต้องเผชิญกับงานที่ไม่มีใครคาดคิดมาก่อน
Harness² เข้ามาทำให้การปรับแต่งนั้นเป็นไปโดยอัตโนมัติในขณะที่ค่าน้ำหนักโมเดลยังคงคงที่ โดยไม่มีการทำ fine-tuning หรือเพิ่มข้อมูลเทรนใหม่ แต่จะเปลี่ยนเฉพาะสภาพแวดล้อมรอบตัวโมเดลผ่าน องค์ประกอบ 8 อย่าง ได้แก่:
| องค์ประกอบ | หน้าที่ใน agent |
|---|---|
| System prompt | คำสั่งหลักที่โมเดลอ่านเป็นอันดับแรก |
| Guardrails | กฎเกณฑ์เกี่ยวกับสิ่งที่ agent ต้องทำหรือไม่ควรทำ |
| Memory | บันทึกระยะยาวที่ส่งต่อระหว่างขั้นตอน |
| Skills | คำสั่งที่ใช้ซ้ำได้สำหรับงานเฉพาะด้าน |
| Tool guidance | วิธีและเวลาที่ควรใช้เครื่องมือแต่ละชนิด |
| Scripts | โค้ดช่วยเหลือที่ agent สามารถรันได้ |
| Subagents | ผู้ช่วยที่ได้รับมอบหมายงานเฉพาะส่วน |
| Plugins | มิดเดิลแวร์ที่กำหนดพฤติกรรมภายใน tool loop |
ตามข้อมูลจาก README สี่รายการแรกจะสร้างบริบทของโมเดล ส่วน tool guidance และ scripts จะกำหนดอินเทอร์เฟซเครื่องมือ subagents จัดการเรื่องการมอบหมายงาน และ plugins ควบคุมมิดเดิลแวร์ ซึ่งครอบคลุมเกือบทุกพฤติกรรมของ agent ยกเว้นตัวโมเดลเอง
การทำงานของ Harness²: การทำรีเคอร์ซีฟสองระดับ
ตัวยก "2" ในชื่อหมายถึงลูปสองวง วงหนึ่งปรับปรุง harness สำหรับงานปัจจุบัน อีกวงปรับปรุงวิธีการที่ harness ถูกพัฒนาข้ามงานต่างๆ
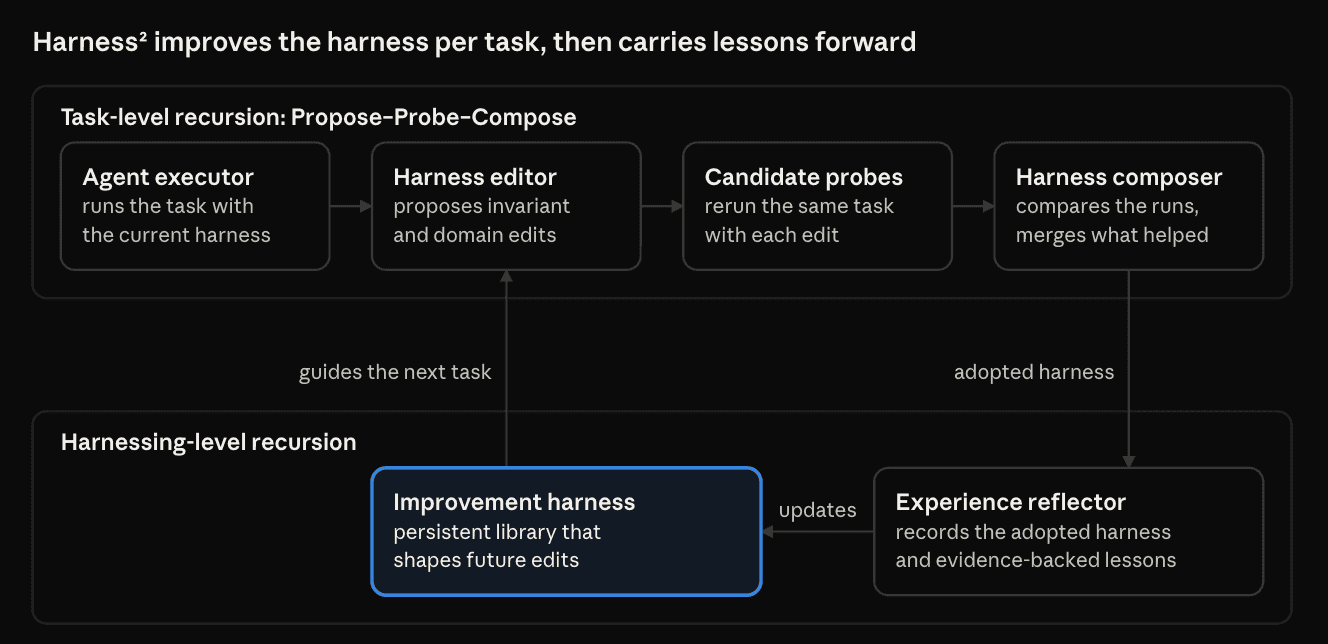
ลูปบนสุดจะรันในทุกงาน โดย improvement harness ที่ได้รับการปรับปรุงแล้วจะคงอยู่ระหว่างงานและเป็นตัวกำหนดทิศทางการแก้ไขในรอบถัดไป
Loop 1: รีเคอร์ซีฟระดับงาน (Propose: Probe: Compose)
- Propose: ตัวแก้ไข harness จะเสนอการแก้ไขแบบทั่วไป (invariant) และแบบเฉพาะทาง (domain)
- Probe: agent จะรันงานเดิมซ้ำด้วยแต่ละ harness ที่ถูกแก้ไข
- Compose: ตัวประสม (composer) จะเปรียบเทียบการรันแต่ละครั้งและรวมการแก้ไขที่ช่วยให้งานดีขึ้นเข้าด้วยกัน
จุดเด่นสำคัญคือ Harness² เรียนรู้จากความแตกต่างทางพฤติกรรมระหว่างการรัน โดยไม่ต้องมีฟีดแบ็กที่เป็นคำตอบที่ถูกต้อง (ground-truth) ซึ่งสำคัญมากในโลกกว้าง (open world) ที่ไม่มีเฉลยเตรียมไว้ให้
Loop 2: รีเคอร์ซีฟระดับการจัดการ (Harnessing-Level Recursion)
หลังจากจบแต่ละงาน experience reflector จะจัดเก็บ harness ที่ถูกเลือกและ "บทเรียนที่มีหลักฐานสนับสนุน" ไว้ใน improvement harness ที่คงอยู่ถาวร เพื่อใช้เป็นแนวทางในงานถัดไป ลูปแรกจึงทำให้ agent เก่งขึ้นในงานปัจจุบัน ส่วนลูปที่สองทำให้เฟรมเวิร์กเก่งขึ้นในการพัฒนา agent สำหรับงานในอนาคต
รีเคอร์ซีฟแบบคู่ขนาน (Parallel) เทียบกับแบบลำดับ (Sequential)
ผู้ใช้สามารถจัดการทรัพยากรคำนวณใน Loop 1 ได้ผ่านงบประมาณ k และโหมดการทำงานตาม experiment guide ดังนี้:
- Parallel: จะเสนอ candidate แบบ invariant และ domain อย่างละ k รายการ แล้วรันการประสมอิสระ k ครั้ง เน้นการสำรวจที่กว้างขวาง
- Sequential: จะรันขั้นตอน Propose: Probe: Compose ต่อเนื่องกัน k ครั้ง โดยส่งต่อ harness ที่พัฒนาแล้วไปข้างหน้า เน้นการขัดเกลาที่ลงลึก
ทั้งนี้งบประมาณคือตัวกำหนดต้นทุน โดยแต่ละงานจะใช้ 4k executor rollouts และ 3k improver sessions อ้างอิงจาก run_sweep.py การตั้งค่า --k 3 จึงหมายถึง 12 rollouts และ 9 improver sessions ต่องาน
ผลการทดสอบ Benchmark
Google ทดสอบ GLM-5 และ Gemini 3.5 Flash บนสาม benchmark พบว่าเพียงขั้นตอนเดียว (k = 1) ก็สามารถปรับปรุงประสิทธิภาพได้ดีกว่า harness พื้นฐาน:
| Benchmark | สิ่งที่ทดสอบ | ผลกำไรสูงสุดที่รายงาน |
|---|---|---|
| WorkBuddy-Bench | งานสำนักงาน เว็บ และโค้ด | สูงถึง +11.5 คะแนน |
| LAB | งานกฎหมาย | สูงถึง +11.8 เปอร์เซ็นต์ |
| JobBench | งานวิชาชีพ | สูงถึง +4.5 คะแนน |
ตัวเลขเหล่านี้คือกรณีที่ดีที่สุด ไม่ใช่ค่าเฉลี่ย โดย README เสริมว่าหากใช้ k ที่ใหญ่ขึ้น จะให้ผลกำไรเพิ่มขึ้นอีก ซึ่งรายละเอียดแยกตามการกำหนดค่าสามารถดูได้ใน paper
ทำไมสิ่งนี้ถึงสำคัญ
ปกติการพัฒนาโมเดลต้องใช้ข้อมูลมหาศาลและ GPU ในการเทรนใหม่ แต่ Harness² เก็บการปรับปรุงไว้ในไฟล์ธรรมดา เช่น prompt ที่เขียนใหม่ หรือสคริปต์ที่แก้ไข ซึ่งมีข้อดีคือ:
- ตรวจสอบได้: harness ที่ปรับปรุงแล้วเป็นข้อความและโค้ด ทำให้รีวิวและเปรียบเทียบ (diff) กับของเดิมได้ง่าย
- ใช้ได้กับทุกโมเดล: ใช้งานได้แม้เป็นโมเดลที่เข้าถึง weights ไม่ได้ โดยเรียกผ่าน API ของ Vertex Gemini หรือ Claude
- ไม่ต้องมีเฉลย: การขัดเกลามาจากการเปรียบเทียบความแตกต่างระหว่างการรัน จึงใช้กับงานใหม่ๆ ที่ยังไม่มีเลเบลข้อมูลได้
การรันเดโม Harness² (ไม่ต้องใช้ API Key)
เดโมของ Google รันโหมดรีเคอร์ซีฟด้วยตัวแก้ไขแบบคงที่ (deterministic) และไม่ต้องการ API key จึงใช้งานได้ฟรี
สิ่งที่ต้องมีก่อน
- Linux หรือ WSL สำหรับ Windows
- Python 3.12 ขึ้นไป ตามที่ระบุใน pyproject.toml
- uv เครื่องมือจัดการแพ็กเกจของ Astral
- git
ขั้นตอนที่ 1: ติดตั้ง uv
curl -LsSf https://astral.sh/uv/install.sh | shหรือจะใช้ pip install uv ก็ได้เช่นกัน
ขั้นตอนที่ 2: โคลน Repository
git clone https://github.com/google-research/harness2.git
cd harness2
ขั้นตอนที่ 3: สร้างและเปิดใช้งาน Virtual Environment
uv venv --python 3.12 .venv
source .venv/bin/activate
ขั้นตอนที่ 4: ติดตั้ง Harness²
uv pip install -e '.[render]'การติดตั้งโหมด editable นี้จะลงทะเบียนคำสั่งต่างๆ เช่น harness2, harness2-demo และเครื่องมือช่วยอื่นๆ
ขั้นตอนที่ 5: รันเดโม
harness2-demo --output runs/demo --k 2เดโมจะรันงานในโดเมน accounting ซึ่งจะเห็นผลลัพธ์ใน demo.json เมื่อรันเสร็จสิ้น
ขั้นตอนที่ 6: ดูสิ่งที่ Harness² แก้ไข
สคริปต์ช่วยเหลือเริ่มต้นมีบั๊กที่กรองเฉพาะค่าบวก (if amount > 0) ทำให้ยอดรวมบัญชีผิดพลาด:
cat runs/demo/base/scripts/summarize.pyเมื่อ Harness² ทำงาน มันจะแก้ไขสคริปต์ให้คำนวณค่าที่ถูกต้องโดยรวมยอดติดลบเข้าไปด้วย:
python runs/demo/library/k2/seq/accounting/harnesses/ledger-1/harness/scripts/summarize.py runs/demo/sources/ledger-1/ledger.csvขั้นตอนที่ 7: อ่านบทเรียนที่มันบันทึกไว้
คุณสามารถตรวจสอบเหตุผลที่ Harness² เลือกการแก้ไขนั้นได้ในไฟล์ EXPERIENCE.md:
cat runs/demo/library/k2/seq/accounting/harnesses/ledger-1/EXPERIENCE.mdบันทึกจะแสดงให้เห็นว่ามันเลือกการแก้ไขเพราะ "signed total matches the source ledger" พร้อมระบุบทเรียนที่ส่งต่อไปยังงานถัดไป
การรัน Benchmark จริง (LAB บน Vertex AI)
การรันจริงต้องใช้โมเดลในทุกบทบาทและมีค่าใช้จ่ายเกิดขึ้น โดยต้องติดตั้งเพิ่มเติมดังนี้:
- Node.js 20+, Google Cloud CLI และเครื่องมือจัดการเอกสารอย่าง Pandoc และ Poppler
sudo apt-get update
sudo apt-get install -y git curl unzip ca-certificates pandoc poppler-utils
ขั้นตอนที่ 1: สร้างไฟล์ .env
สร้างไฟล์ .env ใน root ของโปรเจกต์ตาม setup guide:
GOOGLE_CLOUD_PROJECT=your-gcp-project-id
GOOGLE_CLOUD_LOCATION=global
HARNESS2_SOLVER_MODEL=google-vertex/YOUR_GEMINI_MODEL_ID
HARNESS2_IMPROVER_MODEL=google-vertex/YOUR_GEMINI_MODEL_ID
HARNESS2_JUDGE_MODEL=YOUR_GEMINI_MODEL_ID
ขั้นตอนที่ 2: ยืนยันตัวตนและติดตั้ง Benchmark
gloud auth application-default login
harness2-setup lab
ขั้นตอนที่ 3: รันการขัดเกลาและตัดสินผล
เริ่มจากการทดสอบด้วย --dry-run เพื่อดูแผนงาน จากนั้นรันจริงเพื่อขัดเกลาและตัดสินผล:
harness2 --bench lab --k 1 --mode parallel --only-domains antitrust-competition --max-tasks 1
harness2-judge --bench lab --k 1 --mode parallel
harness2-report --bench lab --k 1 --mode parallel
บทสรุป
Harness² ชี้ให้เห็นอนาคตของ AI agent ที่สามารถเก่งขึ้นได้จากประสบการณ์สะสม โดยไม่ต้องเทรนใหม่ทุกครั้ง สิ่งที่ต้องติดตามต่อคือความสามารถในการส่งต่อบทเรียนข้ามโดเมนและความปลอดภัยในการให้ agent แก้ไขตัวเองได้ ซึ่งการเปิดโค้ดครั้งนี้จะช่วยให้ชุมชนร่วมกันพัฒนาและหาคำตอบเหล่านี้ได้รวดเร็วขึ้น
สำหรับรายละเอียดเชิงลึก สามารถศึกษาได้จาก paper บน arXiv หรือลองรันเดโมจาก GitHub ได้ทันที
แหล่งที่มา
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร