
Google Gemini 4 Argon โชว์ฟอร์มโหดทำคะแนน ARC-AGI-3 ทะลุ 97.5%
Google Deepmind กลายเป็นแล็บ AI รายใหญ่แห่งที่สองที่สามารถทำคะแนนผ่านระดับ 95 เปอร์เซ็นต์ในเกณฑ์วัด ARC-AGI-3 ได้สำเร็จ อย่างไรก็ตาม ข้อมูลจาก Epoch AI ชี้ให้เห็นว่าผลลัพธ์ดังกล่าวยังคงขึ้นอยู่กับวิธีการทดสอบอย่างมาก และตัวโมเดล Argon ยังคงตามหลังคู่แข่งในด้านคณิตศาสตร์และวิศวกรรมซอฟต์แวร์
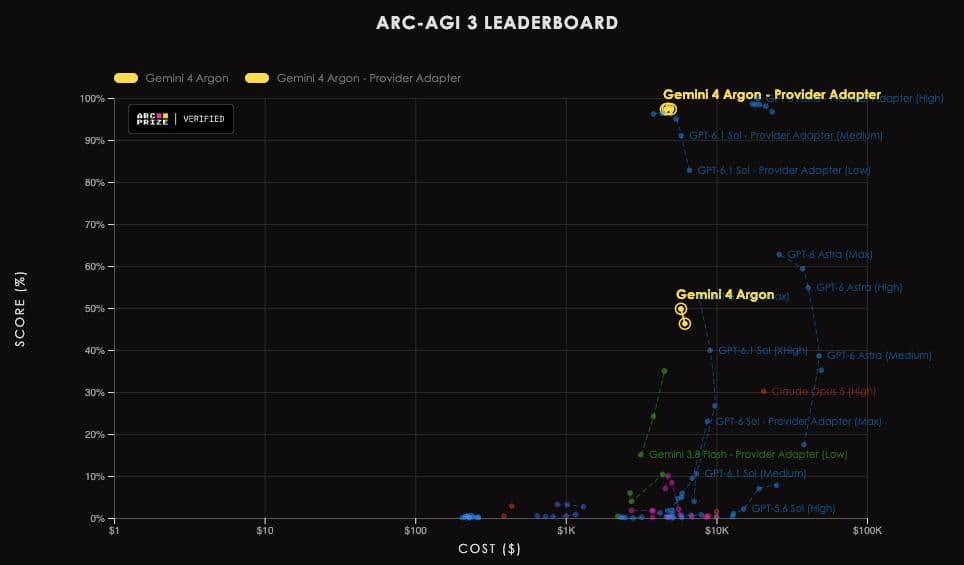
Gemini 4 Argon ซึ่งเป็นโมเดลระดับ frontier ตัวใหม่จาก Google Deepmind ทำคะแนนได้สูงถึง 97.5 เปอร์เซ็นต์ใน ARC-AGI-3 โดยมีค่าใช้จ่ายในการทดสอบ 4,800 ดอลลาร์ ผ่านการใช้ "Provider Adapter Harness" ซึ่งเป็นการตั้งค่าที่ดึงฟีเจอร์เฉพาะของผู้ให้บริการมาใช้ เช่น retained reasoning และ context compaction ส่งผลให้ Google เป็นรองเพียง GPT-6 Astra ของ OpenAI ที่ครองอันดับหนึ่งด้วยคะแนน 99.9 เปอร์เซ็นต์
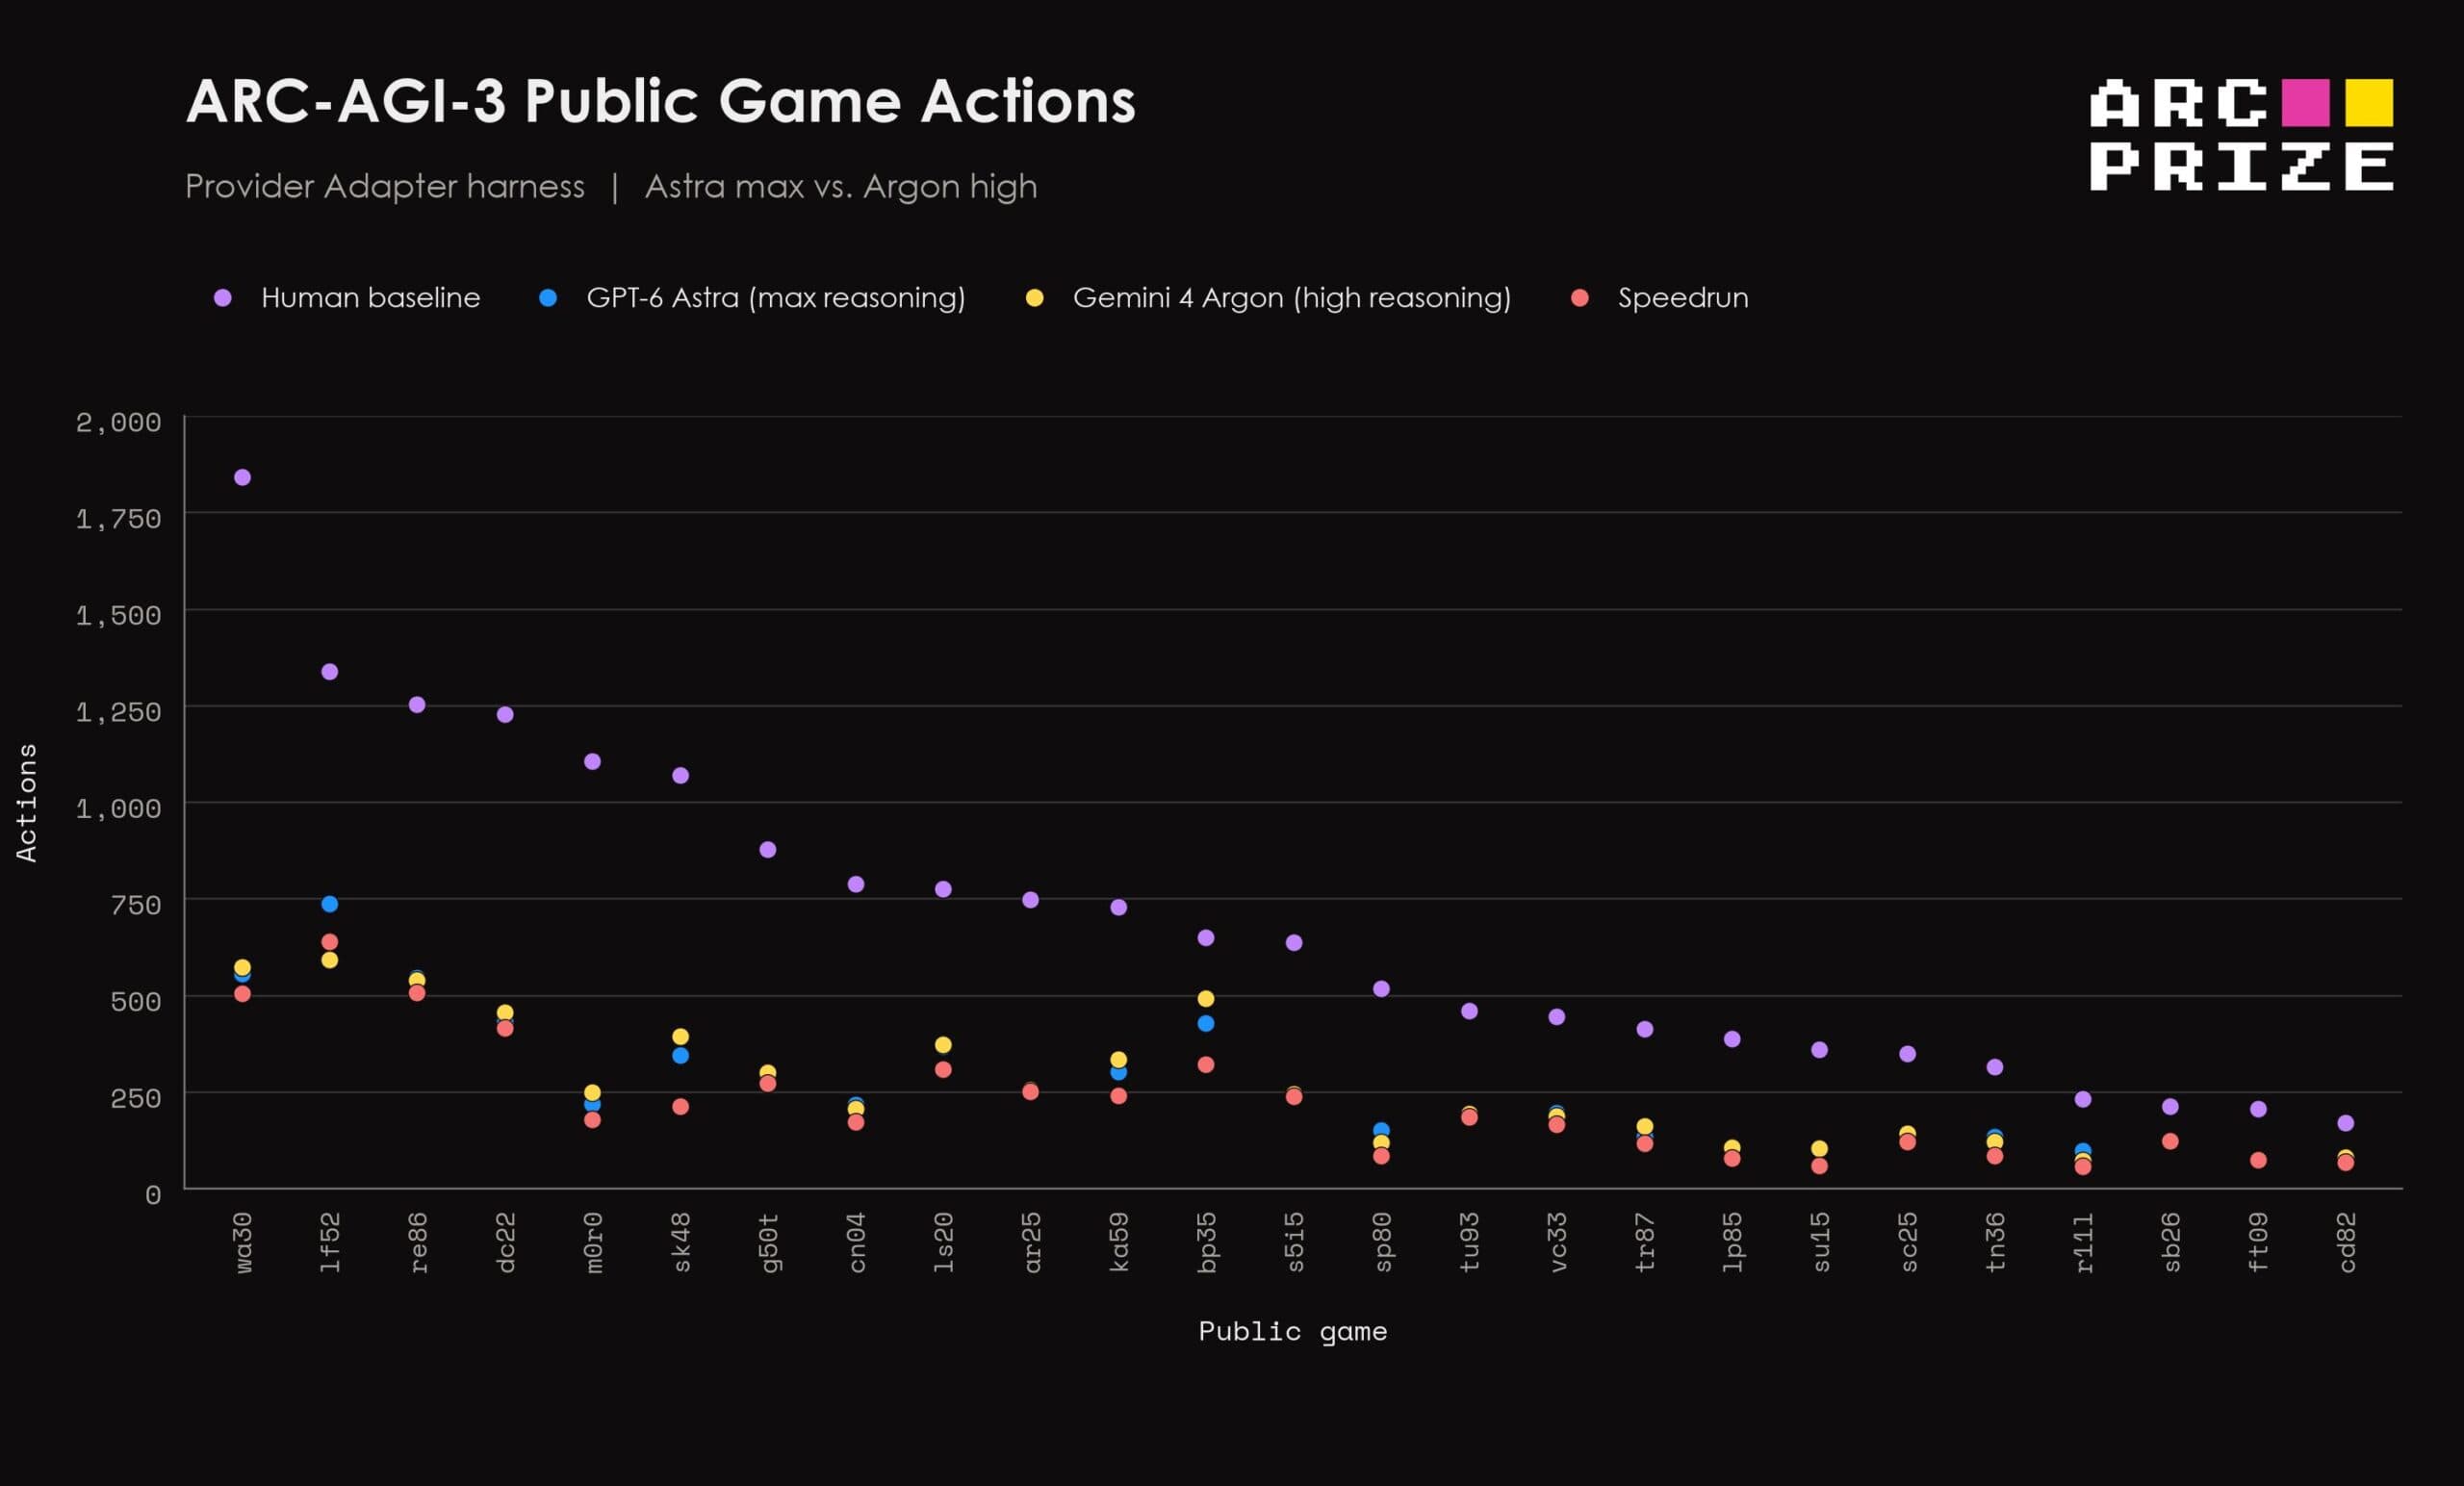
ในการทดสอบผ่านเกมสาธารณะ 25 เกม พบว่า Argon ใช้จำนวนการกระทำน้อยกว่าเกณฑ์พื้นฐานของมนุษย์ถึง 62 เปอร์เซ็นต์ โดยทำความเร็วได้เทียบเท่าหรือดีกว่าสถิติ speedrun ใน 3 เกม และเข้าใกล้เวลาที่ดีที่สุดในอีก 6 เกม ส่วนเกณฑ์วัดเวอร์ชันเก่าอย่าง ARC-AGI-2 ทำได้ 91.3 เปอร์เซ็นต์ และ ARC-AGI-1 ทำได้ 98.5 เปอร์เซ็นต์ โดยคำนวณจากราคาเริ่มต้นที่ 2 ดอลลาร์ต่อล้าน input tokens และ 10 ดอลลาร์ต่อล้าน output tokens
ผลลัพธ์ของ Benchmark ขึ้นอยู่กับการตั้งค่าการทดสอบอย่างมาก
เมื่อทดสอบในระบบ "Standard Harness" ที่จำกัดการจดบันทึกระหว่างรอบ คะแนนของ Argon กลับลดลงเหลือเพียง 49.8 เปอร์เซ็นต์ด้วยค่าใช้จ่ายสูงถึง 5,800 ดอลลาร์ ช่องว่างของคะแนนนี้สะท้อนถึงข้อพิพาทในอดีตเมื่อเดือนกรกฎาคม 2026 กรณีที่ GPT-5.6 Sol ของ OpenAI เอาชนะ Claude Opus 5 ใน ARC-AGI-3 โดยใช้การตั้งค่า API สองแบบ
ในครั้งนั้น GPT-5.6 Sol ทำคะแนนได้เพียง 7.8 เปอร์เซ็นต์ในสภาพแวดล้อมมาตรฐานที่ไม่มีระบบจำการใช้เหตุผล แต่เมื่อเปลี่ยนมาใช้ Responses API ของ OpenAI ที่มีระบบ "Retained Reasoning" และ context "Compaction" คะแนนกลับพุ่งสูงถึง 38.3 เปอร์เซ็นต์จนเอาชนะ Opus 5 ได้ ทำให้ Francois Chollet ผู้ร่วมก่อตั้ง ARC Prize อนุญาตให้ใช้การตั้งค่า API ทั่วไปที่มีให้บริการสาธารณะในการทดสอบได้
นอกจากนี้ ปัญหาด้าน API ยังทำให้ Argon ไม่สามารถเล่นเกมได้ครบทั้ง 55 เกมใน Standard Harness ตามข้อมูลจากผู้ทดสอบ โดยในระดับการใช้เหตุผลสูงสุดเล่นจบเพียง 19 เกมเท่านั้น ด้วยเหตุนี้ ARC Prize จึงยังไม่ได้เผยแพร่คะแนนอย่างเป็นทางการ และผลลัพธ์ที่รายงานในปัจจุบันเป็นการรวมคะแนนบางส่วนจากการรันที่ไม่สมบูรณ์
Argon ลดช่องว่างลงแต่ยังล้าหลังในด้านคณิตศาสตร์และการเขียนโค้ด
สถาบันวิจัย Epoch AI ระบุว่า Argon ทำได้ 165 คะแนน ในดัชนี Epoch Capabilities Index (ECI) ซึ่งใกล้เคียงกับ Fable 5.1 และตามหลัง Opus 5.5 กับ GPT-6 Astra เพียงเล็กน้อย โดย ECI เป็นการรวมเกณฑ์วัดมากกว่า 50 รายการเพื่อประเมินศักยภาพของ AI ในภาพรวม
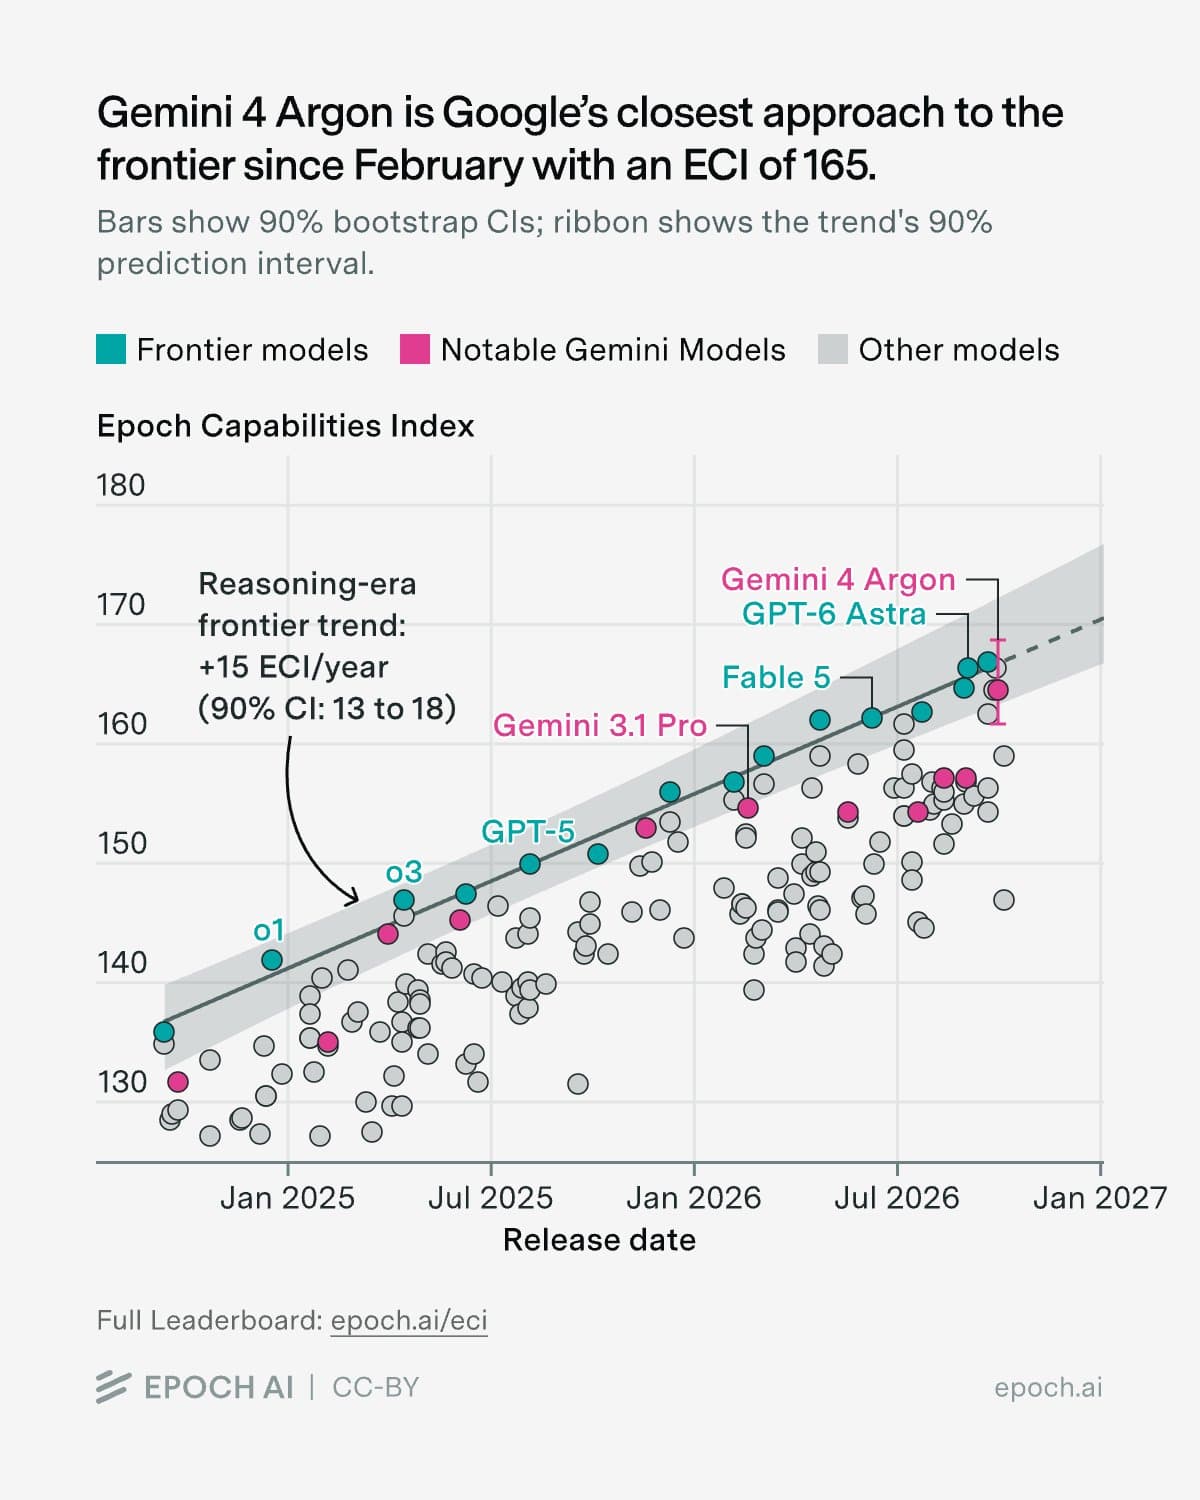
แม้ Argon จะพัฒนาขึ้นอย่างมากจาก Gemini 3.8 Flash และทำให้ Google กลับมาอยู่ในจุดที่ใกล้เคียงกับผู้นำตลาดตามรายงานของ Artificial Analysis และ Vals.ai แต่ความสามารถในบางด้านยังคงเป็นรอง ข้อมูลจาก Epoch AI เผยว่าแม้ Argon จะเด่นด้านความรู้และวิสัยทัศน์ แต่ในด้านคณิตศาสตร์ (Math ECI) และวิศวกรรมซอฟต์แวร์ (SWE ECI) ยังคงอยู่อันดับที่ 8 และ 6 ตามลำดับ
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร