
IBM เปิดตัว Granite Speech 5.0 ยกระดับการถอดความและแปลภาษาแม่นยำยิ่งขึ้น
เราตื่นเต้นที่จะแบ่งปันการอัปเดต 3 รายการสำหรับคอลเลกชัน Granite Speech ของ IBM ประกอบด้วยโมเดลภาษาพูดตัวใหม่ granite-speech-5.0-2b และเวอร์ชันปรับปรุงของอีก 2 โมเดลที่ชุมชนใช้งานอยู่แล้ว ได้แก่ granite-speech-5.0-470m-turboctc และ granite-speech-4.1-2b-plus
การอัปเดตครั้งนี้ครอบคลุมงานด้านเสียงในระดับองค์กรอย่างครบถ้วน ทั้งการถอดความและแปลภาษาที่มีความแม่นยำสูง การประมวลผลที่รวดเร็วเป็นพิเศษที่ edge และการบันทึกเสียงที่สามารถระบุได้ว่าใครพูดและพูดเมื่อไหร่ ซึ่งมีความสำคัญไม่แพ้กับเนื้อหาที่พูด
| Model | สถานะ | สิ่งใหม่ | เหมาะสำหรับ |
|---|---|---|---|
granite-speech-5.0-2b | ใหม่ | automatic speech recognition (ASR) ที่แม่นยำขึ้น ทนต่อเสียงรบกวนและเสียงก้อง, language-ID prompting, keyword biasing 2,000 คำ, การแปลเนื้อหาขนาดยาวที่ดีขึ้น | การถอดความและแปลภาษาหลายภาษาความแม่นยำสูง |
granite-speech-5.0-470m-turboctc | อัปเดต | รองรับหลายภาษา, เว้นวรรคและใช้ตัวพิมพ์ใหญ่ในตัว และทนต่อเสียงรบกวนและเสียงก้องมากขึ้น | การถอดความที่มีปริมาณงานสูงและบนอุปกรณ์ (on-device) |
granite-speech-4.1-2b-plus | อัปเดต | ปรับปรุงการระบุตัวตนผู้พูด, timestamps, keyword biasing และประสิทธิภาพสำหรับเสียงพูดที่ยาว | การประชุม, การโทรศัพท์ และการบันทึกเสียงที่มีผู้พูดหลายคน |
Granite Speech 5.0 2B: แม่นยำขึ้น ทนทานขึ้น ควบคุมได้มากขึ้น
granite-speech-5.0-2b เป็นรุ่นต่อยอดจาก 4.1 2B โดยมีจำนวนพารามิเตอร์เท่าเดิม รองรับการถอดความภาษาอังกฤษ ฝรั่งเศส เยอรมัน สเปน โปรตุเกส และญี่ปุ่น รวมถึงการแปลจากและเข้าสู่ภาษาอังกฤษในภาษาเหล่านี้ พร้อมเพิ่มการแปลภาษาอังกฤษเป็นภาษาอิตาลีและจีนกลาง
โมเดลนี้ได้รับการฝึกฝนด้วยข้อมูลเสียงสาธารณะ 390,000 ชั่วโมง ร่วมกับข้อมูลสังเคราะห์ที่สร้างขึ้นสำหรับ Japanese ASR, keyword biasing และการแปลโดยเฉพาะ
ไฮไลท์ฟีเจอร์ใหม่เมื่อเทียบกับรุ่น 4.1 2B:
- English ASR ที่แม่นยำและทนทานขึ้น: จัดการเสียงรบกวน เสียงก้อง และเสียงจากไมโครโฟนระยะไกลได้ดีขึ้น
- Language ID prompting: ระบุภาษาใน prompt เพื่อควบคุมการถอดความหลายภาษาได้แม่นยำ
- การแปลบทสนทนาและเนื้อหาขนาดยาว: คงคุณภาพการแปลได้ยาวนานและเป็นธรรมชาติมากขึ้น
- Keyword biasing สูงถึง 2,000 คำ: ปรับปรุงการถอดความชื่อเฉพาะและคำย่อในทุกภาษาที่รองรับ
- จัดรูปแบบข้อความตามสั่ง: สามารถขอให้เว้นวรรคและใช้ตัวพิมพ์ใหญ่ตามรูปแบบที่กำหนดใน prompt โดยมีค่า F1 ของตัวพิมพ์ใหญ่อยู่ในช่วง 89.7 ถึง 99.5
โมเดลนี้เผยแพร่ภายใต้ Apache 2.0 รองรับการใช้งานใน Transformers, vLLM, llama.cpp และ mlx-audio สำหรับ Apple Silicon
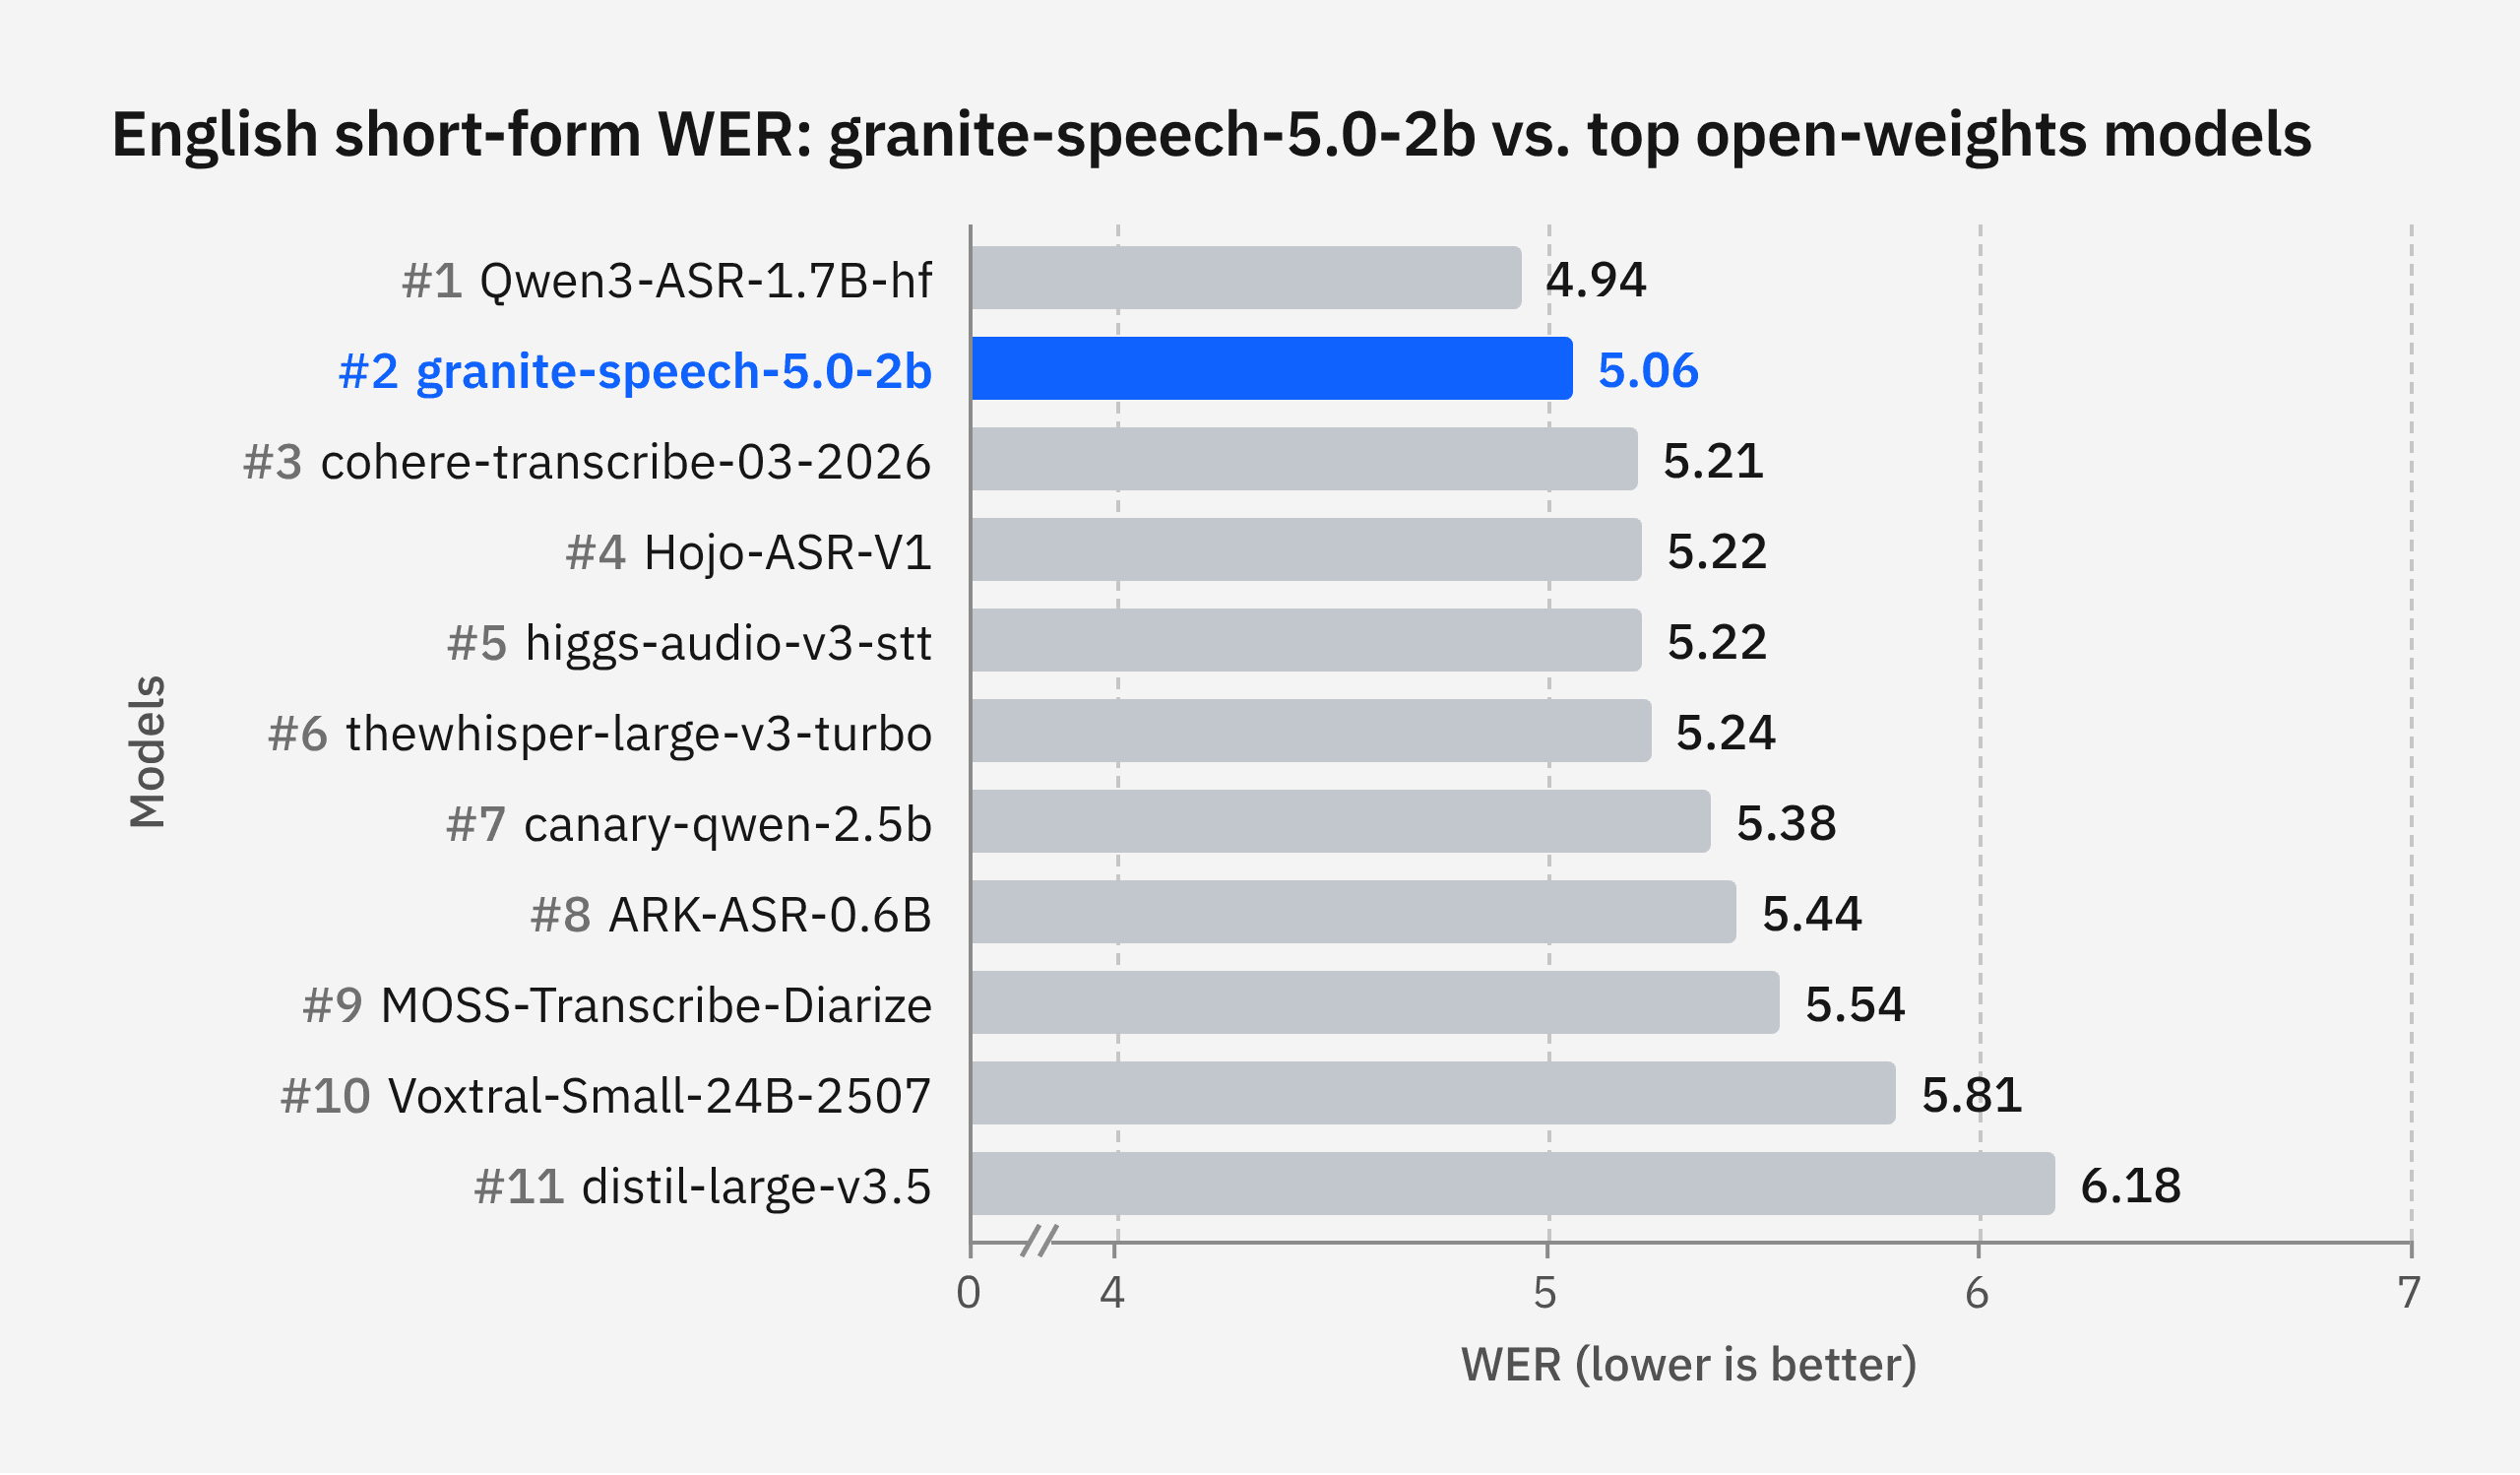
แผนภูมิที่ 1: granite-speech-5.0-2b ติดอันดับ 2 ของโมเดล ASR แบบ open-weight ชั้นนำในค่าเฉลี่ย English WER (5.06%) ค่ายิ่งน้อยยิ่งดี ผลลัพธ์อย่างไม่เป็นทางการ ณ วันที่ 15 ตุลาคม 2026
Granite Speech 5.0 Turbo CTC: รองรับหลายภาษาและเร็วขึ้นกว่าเดิม
จากที่ เปิดตัว Turbo CTC ในเดือนสิงหาคม ซึ่งเป็นโมเดลขนาด 470M parameter เพื่อเน้นความเร็ว การอัปเดตครั้งนี้ยังคงขนาดเท่าเดิมแต่เพิ่มความสามารถใหม่ ได้แก่ การรองรับหลายภาษา (อังกฤษ, ญี่ปุ่น, สเปน, เยอรมัน, ฝรั่งเศส, อิตาลี และโปรตุเกส) พร้อมระบบเว้นวรรคและใช้ตัวพิมพ์ใหญ่ในตัว และทนทานต่อเสียงก้องได้ดียิ่งขึ้น
ในด้านประสิทธิภาพ โมเดลนี้เร็วขึ้นกว่าเดิมโดยลดเวลา warmup และเพิ่มความเร็วไปที่ 19,870 RTFx บน Open ASR Leaderboard จากเดิม 12,600 RTFx หรือเร็วขึ้นประมาณ 1.6 เท่า โดยที่ยังรักษาความแม่นยำไว้ได้เท่าเดิม
แผนภูมิที่ 2: ค่าเฉลี่ย WER เทียบกับ RTFx บน Open ASR Leaderboard (ภาษาอังกฤษแบบสั้น ณ เดือนตุลาคม 2026) WER ยิ่งต่ำและ RTFx ยิ่งสูงยิ่งดี
Granite Speech 4.1 2B Plus: ระบุตัวตนผู้พูดได้แม่นยำยิ่งขึ้น
granite-speech-4.1-2b-plus รุ่นอัปเกรดถูกปรับจูนเพื่อเน้นการใช้งานจริงในองค์กร เช่น การประชุมหรือการโทรสนับสนุนลูกค้าที่มีผู้พูดหลายคน โดยยังคงโครงสร้างเดิมเพื่อให้ผู้ใช้สามารถเปลี่ยนมาใช้น้ำหนัก (weights) ใหม่ได้ทันที
การปรับปรุงครอบคลุม 4 ด้านสำคัญ ได้แก่ การระบุตัวตนผู้พูด (Speaker attribution) ที่ลดอัตราความผิดพลาดลง 7%, การทำ Timestamps ที่มีความคลาดเคลื่อนลดลงกว่าครึ่ง, ประสิทธิภาพในเสียงพูดขนาดยาวที่แม่นยำขึ้น 24% และ Keyword biasing ที่แม่นยำขึ้น 45%
| ความสามารถ | มาตรวัด | รุ่นก่อนหน้า | โมเดลที่อัปเดต |
|---|---|---|---|
| Timestamps, เสียงพูดทั้งหมด | AAS (ค่าเฉลี่ยการเลื่อนของ timestamp) | 210.86 | 98.54 |
| Timestamps, เสียงพูดสั้นๆ | AAS (ค่าเฉลี่ยการเลื่อนของ timestamp) | 29.27 | 26.20 |
| Keyword biasing | WER คำที่เน้น, รายการ 20 คำ | 11.79 | 6.48 |
| เสียงพูดขนาดยาว | WER, ชุดทดสอบแบบยาว | 13.53 | 10.22 |
| การระบุตัวตนผู้พูด | WDER | 4.40 | 4.10 |
| ข้อความถอดความระบุตัวผู้พูด | cpWER | 30.50 | 28.48 |
เริ่มต้นใช้งาน
หากคุณกำลังเลือกโมเดลที่เหมาะสมกับการใช้งาน:
- เน้นความแม่นยำ การแปล หรือเน้นคำเฉพาะ: เลือก granite-speech-5.0-2b
- เน้นความเร็วหรือใช้งานบนอุปกรณ์ (On-device): เลือก granite-speech-5.0-470m-turboctc
- เน้นงานประชุมที่มีผู้พูดหลายคน: เลือก granite-speech-4.1-2b-plus
ทุกโมเดลเปิดให้ใช้งานภายใต้ใบอนุญาต Apache 2.0 และแนะนำให้ใช้ร่วมกับ Granite Guardian เพื่อเพิ่มความปลอดภัยในการตรวจจับความเสี่ยงสำหรับการใช้งานจริง
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร