
Ai2 เผยเทคนิคจัดลำดับงาน GPU Cluster ให้มีประสิทธิภาพสูงสุด
การสร้างระบบจัดลำดับงานในคลัสเตอร์ (Cluster Scheduler) เพื่อจัดลำดับความสำคัญของงานวิจัยที่มีผลกระทบสูง ในขณะที่ยังคงการใช้งานทรัพยากรได้อย่างเต็มประสิทธิภาพตลอดเวลา
ทีม AI Infrastructure ที่ Ai2 รับผิดชอบการจัดสรรขีดความสามารถ GPU สำหรับการเทรนโมเดลแบบกระจายตัวขนาดใหญ่ เรามองการทำงานเป็นพีระมิด 4 ระดับ เริ่มจากฐานคือ Availability (ความพร้อมของฮาร์ดแวร์), Occupancy (อัตราการครองทรัพยากร), Impact (ผลกระทบของงานที่เลือก) และยอดสูงสุดคือ Utilization (การใช้งานจริงตลอดอายุงาน)
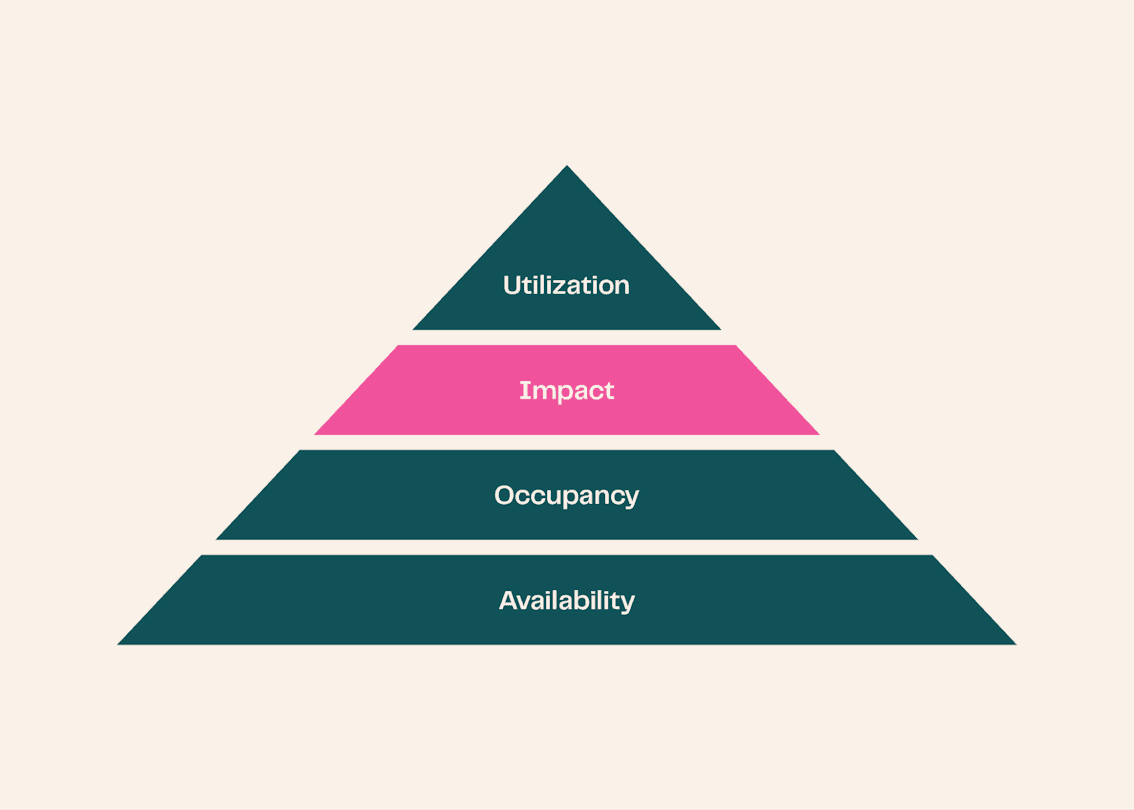
บทความนี้เน้นเรื่องการปรับปรุง Impact ผ่านการเปลี่ยนตัวจัดลำดับงานแบบ Priority-based มาเป็นระบบที่ใช้การจัดสรรแบบแบ่งปันที่เป็นธรรมตามลำดับชั้น (Hierarchical fair-share allocation) และข้อตกลงการแบ่งส่วนเวลา (Time-slicing contract) ซึ่งเปลี่ยนการตัดสินใจรายกรณีไปสู่ระบบงบประมาณที่โปร่งใส
การจองเกินขนาด (Overcommitting)
ปัจจุบัน Ai2 จัดการ GPU NVIDIA H100, B200 และ B300 หลายพันตัว เพื่อรองรับนักวิจัย 150 คนที่ทำงานหลากหลาย ตั้งแต่โมเดล LLM, VLM ไปจนถึงหุ่นยนต์ ซึ่งความต้องการใช้งานจริงสูงกว่าทรัพยากรที่มีอยู่ถึง 2-3 เท่า ทำให้เกิดการแข่งขันแย่งชิงทรัพยากรในทุกชั่วโมง
ในอดีต ระบบ Priority-based แบบเดิมทำให้เกิดพฤติกรรมผิดปกติ เช่น "การจับจองพื้นที่" (Squatting) โดยผู้ใช้วางงานที่ไม่มีการทำงานจริง (No-op) ทิ้งไว้เพื่อกันที่ รวมถึงเกิดภาวะเงินเฟ้อของลำดับความสำคัญ (Priority inflation) จนงานเกือบทั้งหมดถูกตั้งค่าเป็น HIGH ส่งผลให้งานระดับรองถูกตัดขาดจากระบบโดยสิ้นเชิง
โศกนาฏกรรมของส่วนรวม (Tragedy of the commons)
ปัญหาที่เกิดขึ้นสะท้อนถึง "โศกนาฏกรรมของส่วนรวม" เมื่อทุกคนพยายามรักษาผลประโยชน์ส่วนตนจนทำให้ทรัพยากรส่วนรวมสูญเสียประสิทธิภาพ เช่น การใส่ลูปไม่รู้จบ (Infinite loops) เพื่อรักษาการใช้งานให้สูงตามเกณฑ์ ซึ่งปัญหาพื้นฐานเหล่านี้ยังคงอยู่แม้เทคโนโลยีฮาร์ดแวร์จะเปลี่ยนไป
งบประมาณ ไม่ใช่ตารางเวลา
เราเปลี่ยนวิธีคิดจากการแก้โจทย์ Knapsack problem ที่พยายามยัดงานลงตารางเวลา มาเป็นการมอบสิทธิการเข้าครองในรูปแบบ "ส่วนแบ่งของเวลา GPU" แทนการระบุตัวเครื่อง ซึ่งช่วยลดปัญหาเครื่องว่างในช่วงที่บางทีมไม่มีงานรัน
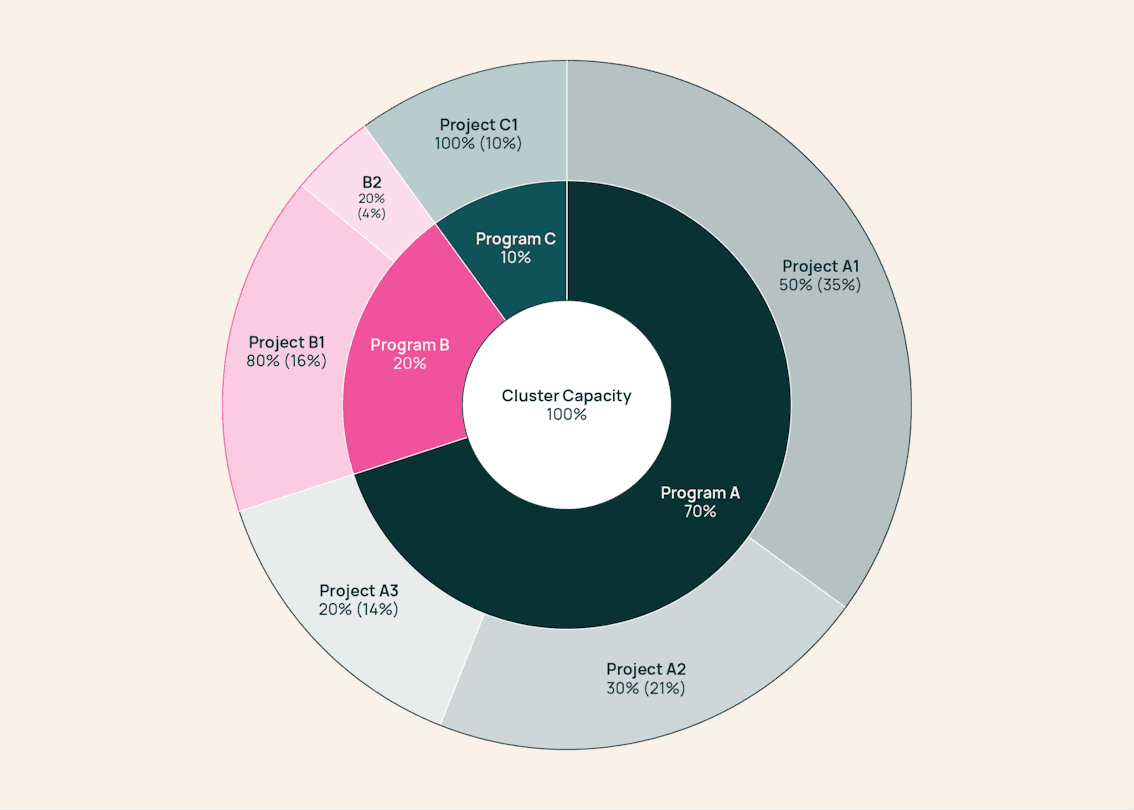
ค่าในวงเล็บแสดงถึงขีดความสามารถรวมของคลัสเตอร์ที่มอบหมายให้กับโครงการระดับใบ (Leaf project)
ในระบบใหม่นี้ ทุกงานต้องใช้ต้นทุนจากงบประมาณที่มีจำกัด การจับจองพื้นที่ (Squatting) จึงมีราคาที่ต้องจ่ายสูงกว่าการเจรจาของบประมาณเพิ่มอย่างตรงไปตรงมา โดยมีผู้จัดการและหัวหน้านักวิจัยเป็นผู้ตัดสินใจเรื่องการแลกเปลี่ยนผลประโยชน์ (Tradeoffs)
Fair-share
เราสร้าง Hierarchical fair-share scheduler โดยต่อยอดจากหลักการของ Hadoop และ SLURM อัลกอริทึมจะติดตามการใช้งานย้อนหลัง 7 วัน เพื่อจัดลำดับงานที่ยังใช้โควตาไม่ถึงเกณฑ์ (Under-utilized) ไว้เหนือกลุ่มที่ใช้เกินเกณฑ์ (Over-utilized)
Chris Clark ระบุว่าระบบใหม่ช่วยให้รู้สึกเหมือนมีกำลังประมวลผลเพิ่มขึ้นถึง 30% เพราะงานที่มีลักษณะมาเป็นพักๆ (Bursty) สามารถเรียกคืนกำลังประมวลผลที่เคยเสียเปล่ากลับมาใช้ได้เมื่อต้องการ
ข้อตกลงการจัดลำดับงาน (The scheduling contract) เพื่อแก้ปัญหางานที่รันค้างไว้นานเกินไป เรากำหนด "ระยะเวลารันขั้นต่ำ" (Minimum runtime) เพื่อรับประกันความคืบหน้าของงานวิจัย โดยหลังจากครบกำหนด ระบบสามารถแทรกงาน (Preemption) และนำงานเดิมกลับเข้าคิวใหม่ได้โดยอัตโนมัติ ซึ่งช่วยลดภาระงานซ่อมแซมที่ต้องใช้มนุษย์ได้ถึง 74%
วงจรชีวิตของเวิร์กโหลดจะเป็นไปตามรูปแบบนี้:
- ส่งงานพร้อมระบุระยะเวลารันขั้นต่ำและสถานะ Resumable
- จัดตารางตาม Fair-share ถ่วงน้ำหนักด้วยประวัติการใช้งานย้อนหลัง
- รันตามเวลาขั้นต่ำโดยหักจากงบประมาณ
- รันต่อได้หากลำดับความสำคัญยังสูงกว่างานอื่น
- อาจถูกแทรกและกลับไปรอในคิวใหม่
- ปล่อยทรัพยากรเมื่อเสร็จสิ้น
การจำลองสถานการณ์ (Simulations)
เราใช้การจำลองเพื่อพยากรณ์ผลกระทบก่อนใช้งานจริง ผลการทดสอบพบว่างานขนาดเล็กสำหรับดีบัก (ใช้ GPU น้อย รันไม่เกิน 15 นาที) มีเวลารอคิวลดลงอย่างมากจาก 6 ชั่วโมงเหลือเพียง 5 นาที ซึ่งช่วยให้นักวิจัยทำงานได้รวดเร็วขึ้น
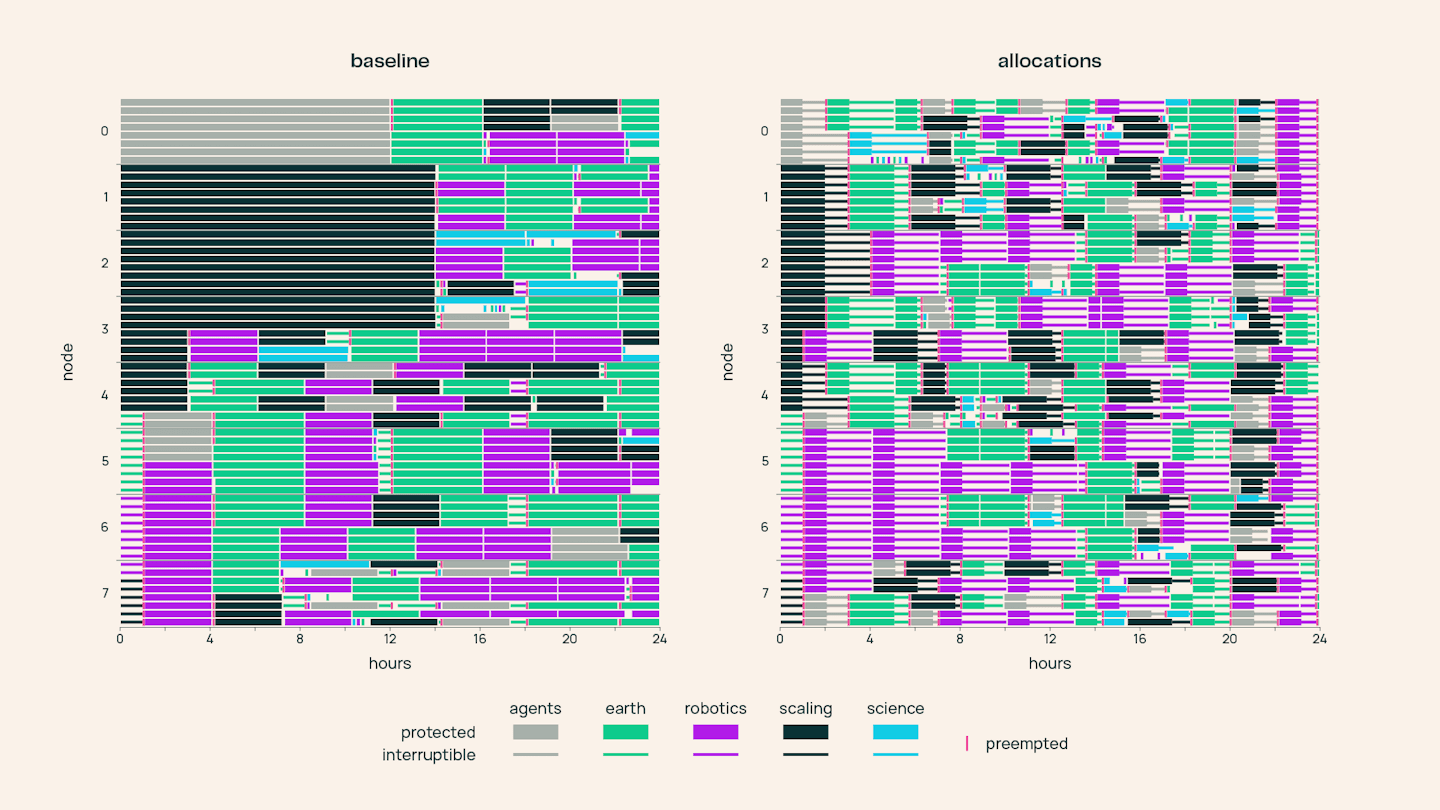
การแสดงภาพจำลอง: ด้านซ้ายคือ Baseline เดิม ด้านขวาคือระบบ Allocations ใหม่ ซึ่งมีการหมุนเวียนการเข้าครอง GPU ระหว่างทีมได้ดีกว่า
ผลลัพธ์และอนาคต
หลังใช้งานจริงในเดือนกรกฎาคม พบว่าทีมวิจัยได้รับเวลา GPU ตามจัดสรรถึง 98% ขณะที่อัตราการครองเครื่อง (Occupancy) ยังคงสูงถึง 98% นอกจากนี้ยังลดเวลารอคิวมัธยฐานในคลัสเตอร์ H100 จาก 5 นาทีเหลือเพียง 24 วินาที
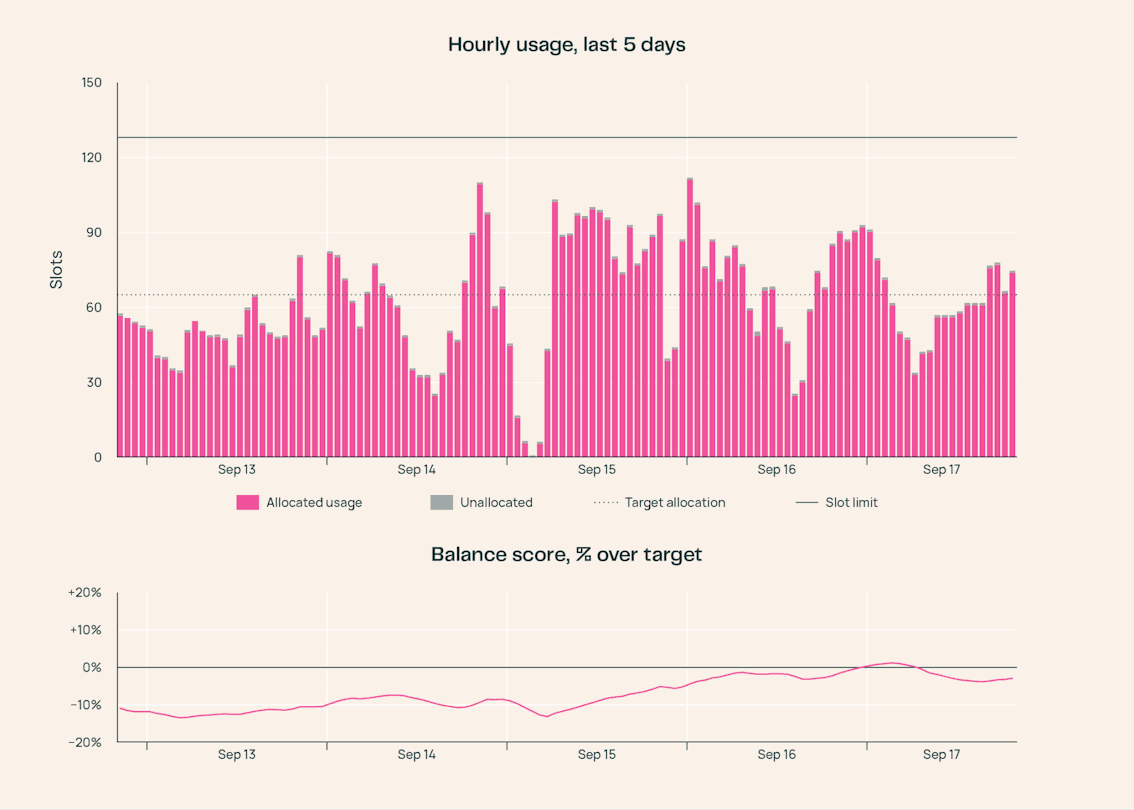
ตัวอย่างการแสดงภาพการใช้งานการจัดสรรเมื่อเวลาผ่านไป
แม้จะมีความท้าทายเรื่อง Interactive sessions ที่อาจถูกแทรกงานได้ แต่เรากำลังแก้ปัญหาด้วยการสร้างคลัสเตอร์ CPU แยกต่างหากและระบบกู้คืนเซสชัน เป้าหมายถัดไปคือการก้าวไปสู่ยอดพีระมิดเพื่อรีด Utilization จากทุกเวิร์กโหลดให้เกิดมูลค่าสูงสุด หากสนใจร่วมงานด้านนี้ เราขอแนะนำให้คุณสำรวจบทบาททางวิศวกรรมที่เปิดรับที่ Ai2
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร