
เปิดตัว Rumble-2-Flash โมเดลเสียงโอเพนซอร์สขนาดจิ๋วแต่ทรงพลัง
วันนี้เรากำลังเปิดตัว Rumble-2-Flash ในรูปแบบโอเพนซอร์สภายใต้สัญญาอนุญาต Apache 2.0 โดยเป็นโมเดลการจดจำเสียง (speech recognition) ขนาด 0.5B พารามิเตอร์ รองรับมากกว่า 40 ภาษา ซึ่งมีสมรรถนะแข่งขันกับโมเดลที่มีขนาดใหญ่กว่า 3-60 เท่าได้อย่างสูสี
จุดเด่นของโมเดลประกอบด้วย:
- รันได้ทุกที่: รองรับแบบ native ใน 🤗 Transformers และ vLLM โดยไม่ต้องใช้โค้ดปรับแต่ง
- 40+ ภาษา: มีระบบตรวจจับภาษาอัตโนมัติ
- ควบคุมผลลัพธ์ได้: กำหนดรูปแบบตัวเลขเป็นหลักดิจิทัลหรือตัวอักษร, จัดการคำอุทาน (fillers), การพูดซ้ำตามต้นฉบับ (verbatim repeats) และการบังคับภาษา
- เร็วอย่างยิ่ง: ประมวลผลเสียงหนึ่งชั่วโมงใช้เวลาเพียงครึ่งวินาที ด้วยค่า RTFx มากกว่า 7,000 บน full batches
- ใช้งานจริงกับการโทรศัพท์: ประสิทธิภาพเทียบเท่า Nemotron 3.5 Transcribe (30B) ของ NVIDIA จากการทดสอบ benchmark คอลเซ็นเตอร์ความยาว 302 ชั่วโมง
Quickstart
เริ่มต้นถอดความด้วย 🤗 Transformers
uv pip install torch transformers acceleratefrom transformers import AutoProcessor, AutoModelForMultimodalLM
model_id = "Reson8/Rumble-2-Flash"
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForMultimodalLM.from_pretrained(model_id, device_map="auto")
inputs = processor.apply_transcription_request(
audio="https://hf.co/datasets/hf-internal-testing/dummy-audio-samples/resolve/main/bcn_weather.mp3",
language="English", # omit to detect automatically
).to(model.device, dtype=model.dtype)
output = model.generate(**inputs, max_new_tokens=512)
generated = output[:, inputs["input_ids"].shape[-1]:]
print(processor.decode(generated, return_format="transcription_only")[0]) # return_format="parsed" if detecting languageในส่วนของ audio นั้นรองรับทั้งที่อยู่ไฟล์ในเครื่อง, URL, NumPy array หรือรายการของข้อมูลเหล่านี้
วิธีการสร้าง
Rumble-2-Flash ใช้สถาปัตยกรรม Qwen3-ASR เพื่อให้รองรับการใช้งานได้ทันทีตั้งแต่วันแรก หากระบบของคุณรัน Transformers หรือ vLLM ได้ ก็สามารถรัน Rumble-2-Flash ได้โดยไม่ต้องใช้ forked runtime หรือ trust_remote_code เพื่อให้ได้โมเดลขนาดเล็กที่มีความแม่นยำสูง เราใช้วิธีการทำ distillation จาก Rumble-2 ซึ่งเป็นโมเดลหลักของเรา ผ่านเทคนิค on-policy distillation โดยตัว student จะถอดความเสียงด้วยตัวเอง และตัว teacher จะให้คะแนนบทถอดความนั้นทีละ token ในทุกตำแหน่ง teacher จะส่งค่าความน่าจะเป็นที่ควรจะเป็น และ student จะเรียนรู้เพื่อปรับให้ตรงกัน วิธีนี้ช่วยให้ student ได้รับการแก้ไขข้อผิดพลาดที่เกิดขึ้นจริงในทุกขั้นตอน แทนที่จะได้รับคะแนนรวมเพียงอย่างเดียว โดยทั่วไป on-policy distillation กำหนดให้ทั้งสองส่วนใช้ tokenizer ร่วมกัน แต่เราเลือกใช้ GOLD เพื่อขจัดข้อจำกัดนั้น ทำให้สามารถใช้ Qwen3-ASR ที่มี vocabulary เฉพาะตัวได้ โดย GOLD จะทำหน้าที่รวม token ในจุดที่การแบ่งข้อความต่างกัน ทำให้โมเดลทั้งสองถูกเปรียบเทียบจากข้อความเดียวกันได้อย่างแม่นยำ
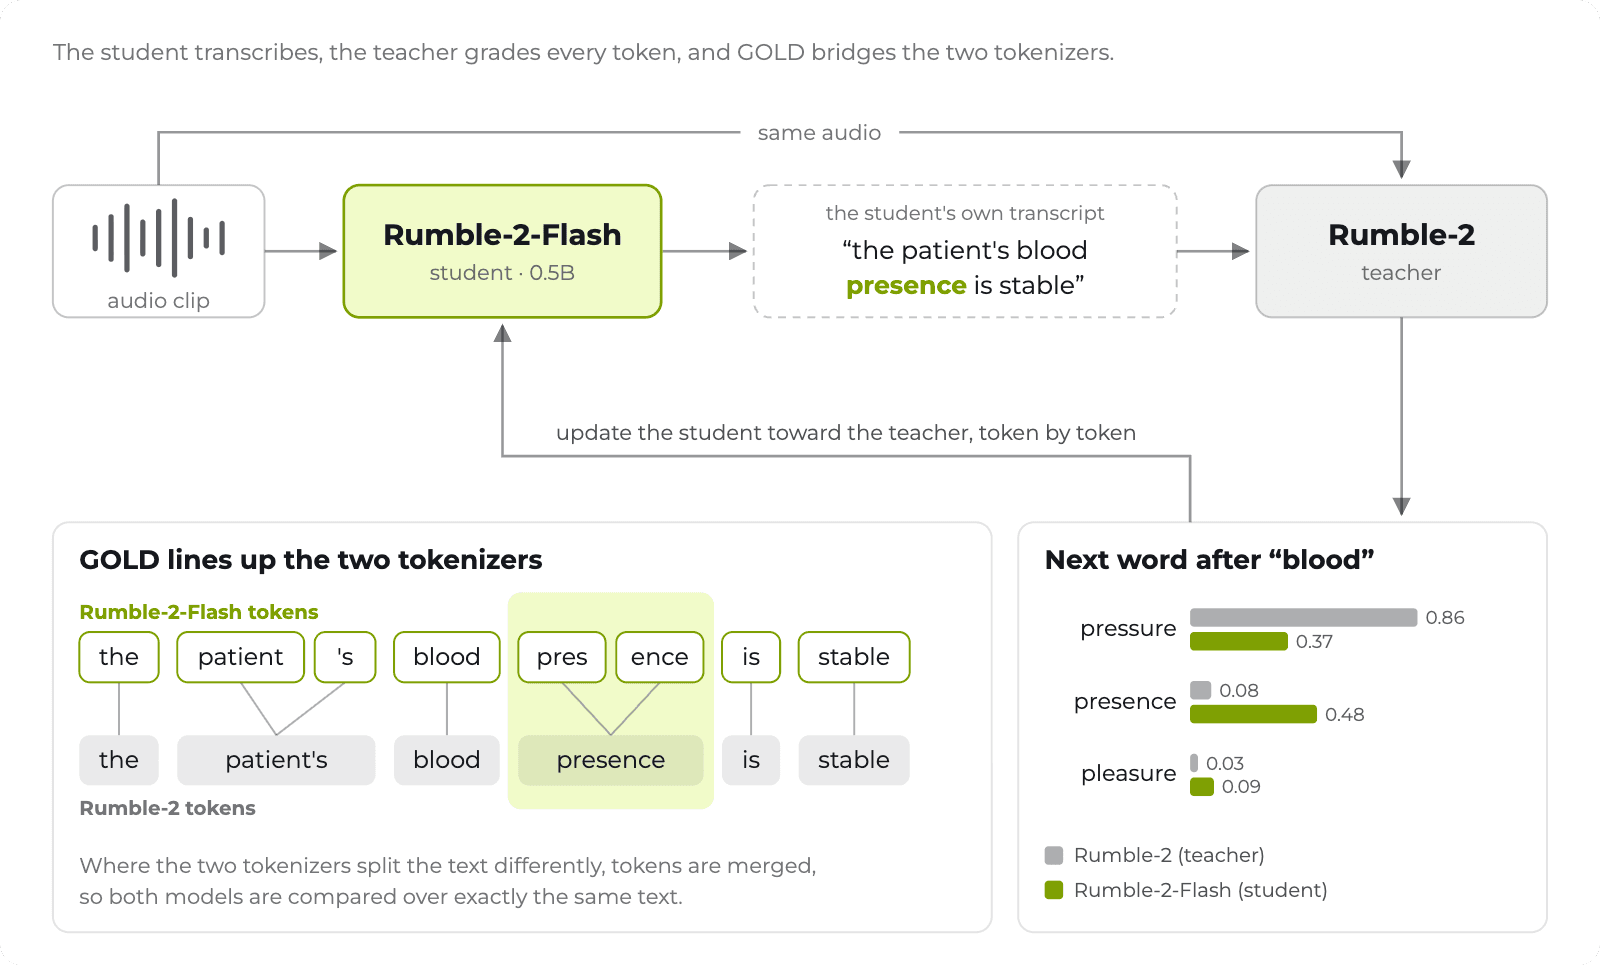
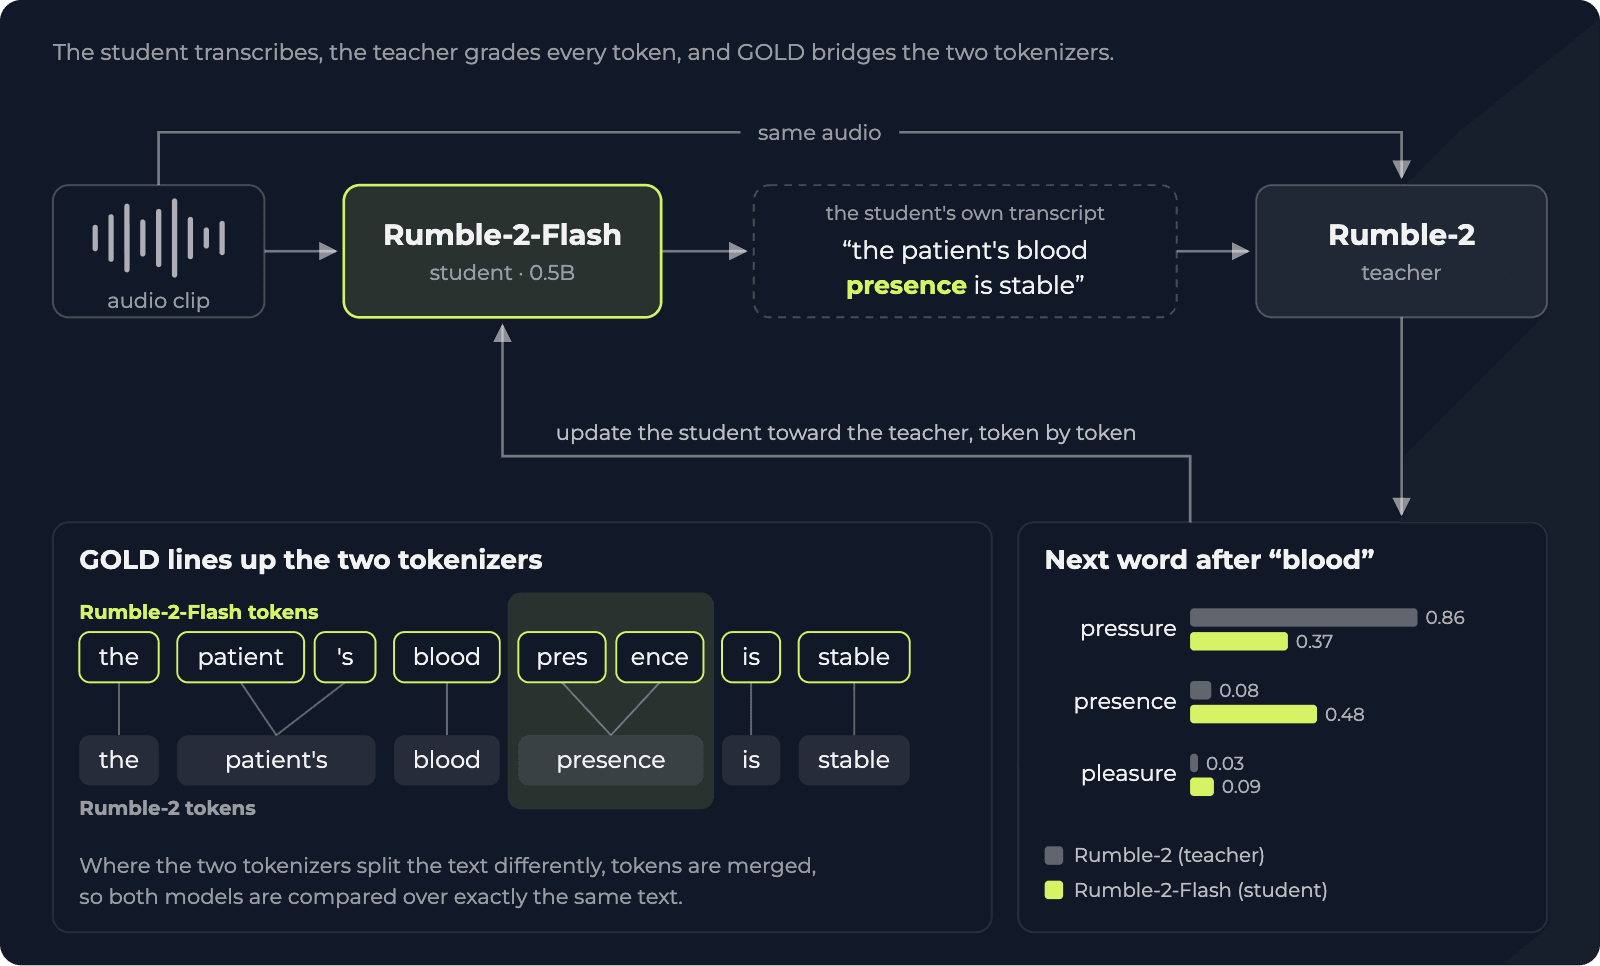
ภาพประกอบ: On-policy distillation ด้วย GOLD
ผลลัพธ์
ความแม่นยำเทียบกับขนาด
จากการจัดอันดับ multilingual บน Open ASR Leaderboard พบว่า Rumble-2-Flash มี อัตราข้อผิดพลาดเฉลี่ย 6.96% ในกลุ่มภาษาหลัก เช่น จีน เยอรมัน ฝรั่งเศส อิตาลี สเปน โปรตุเกส ฮินดี ดัตช์ และอังกฤษ ซึ่งทำคะแนนได้ดีกว่า omniASR-LLM 7B ของ Meta ที่มีขนาดใหญ่กว่าถึง 15 เท่า และในรายการ English ยังมีค่าเฉลี่ย WER ที่ 6.6% ซึ่งนำหน้า Whisper large-v3 อีกด้วย
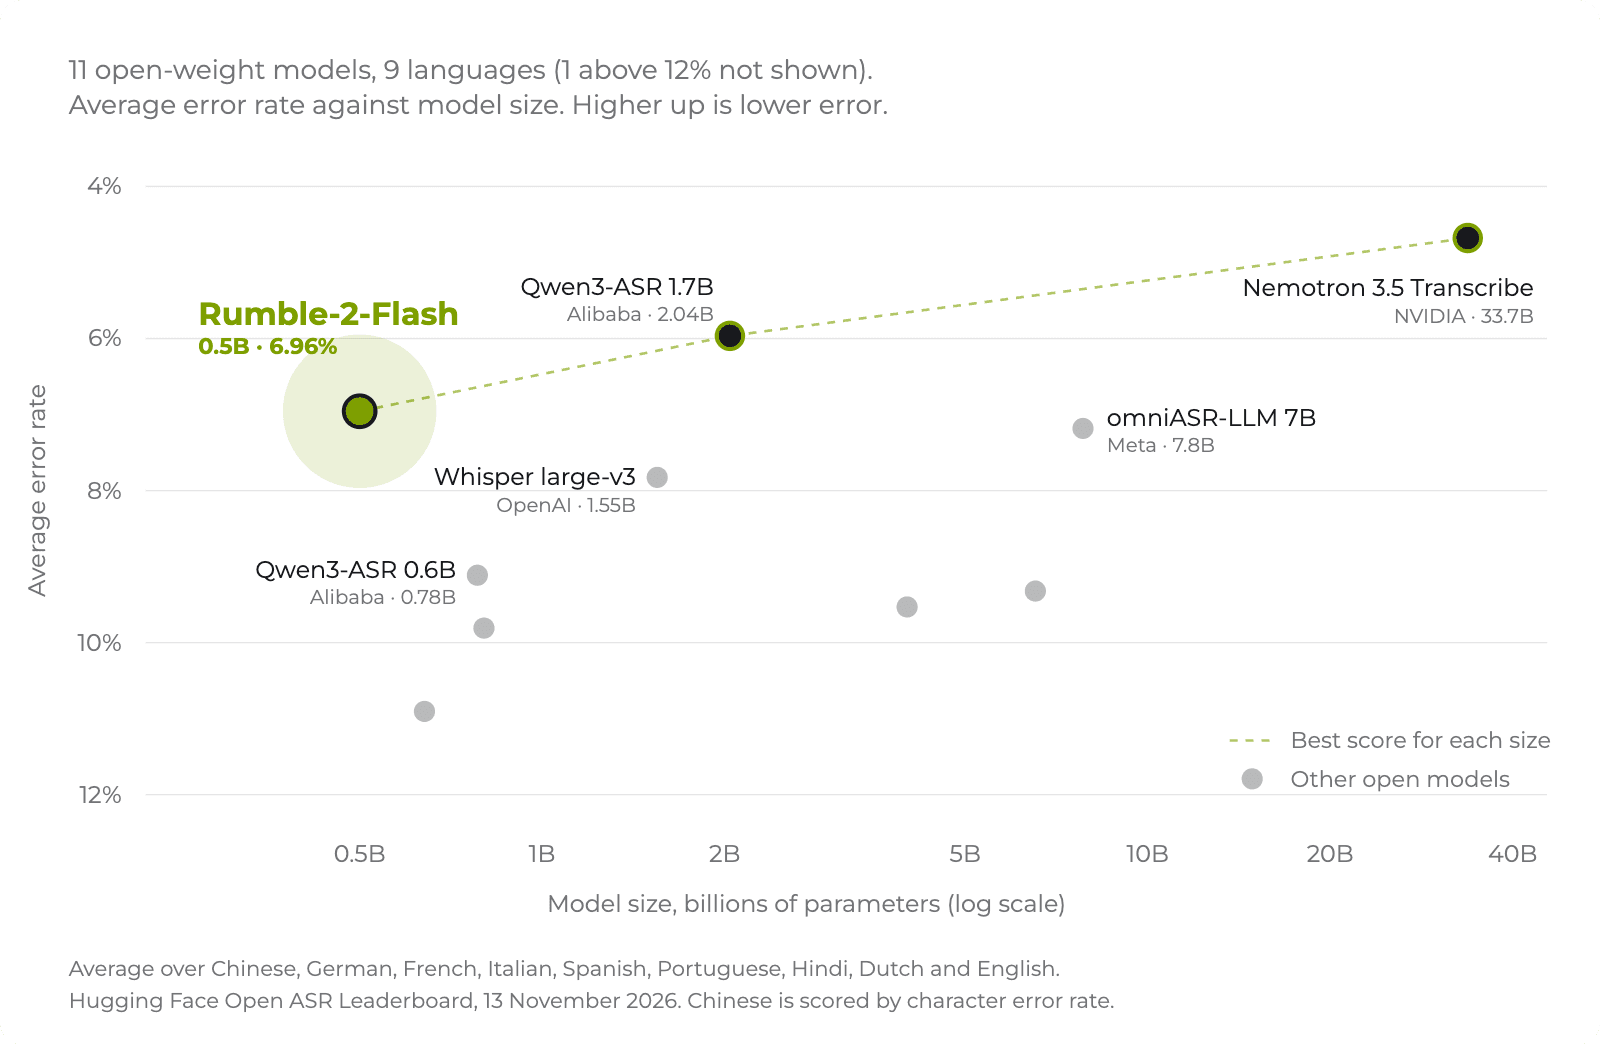
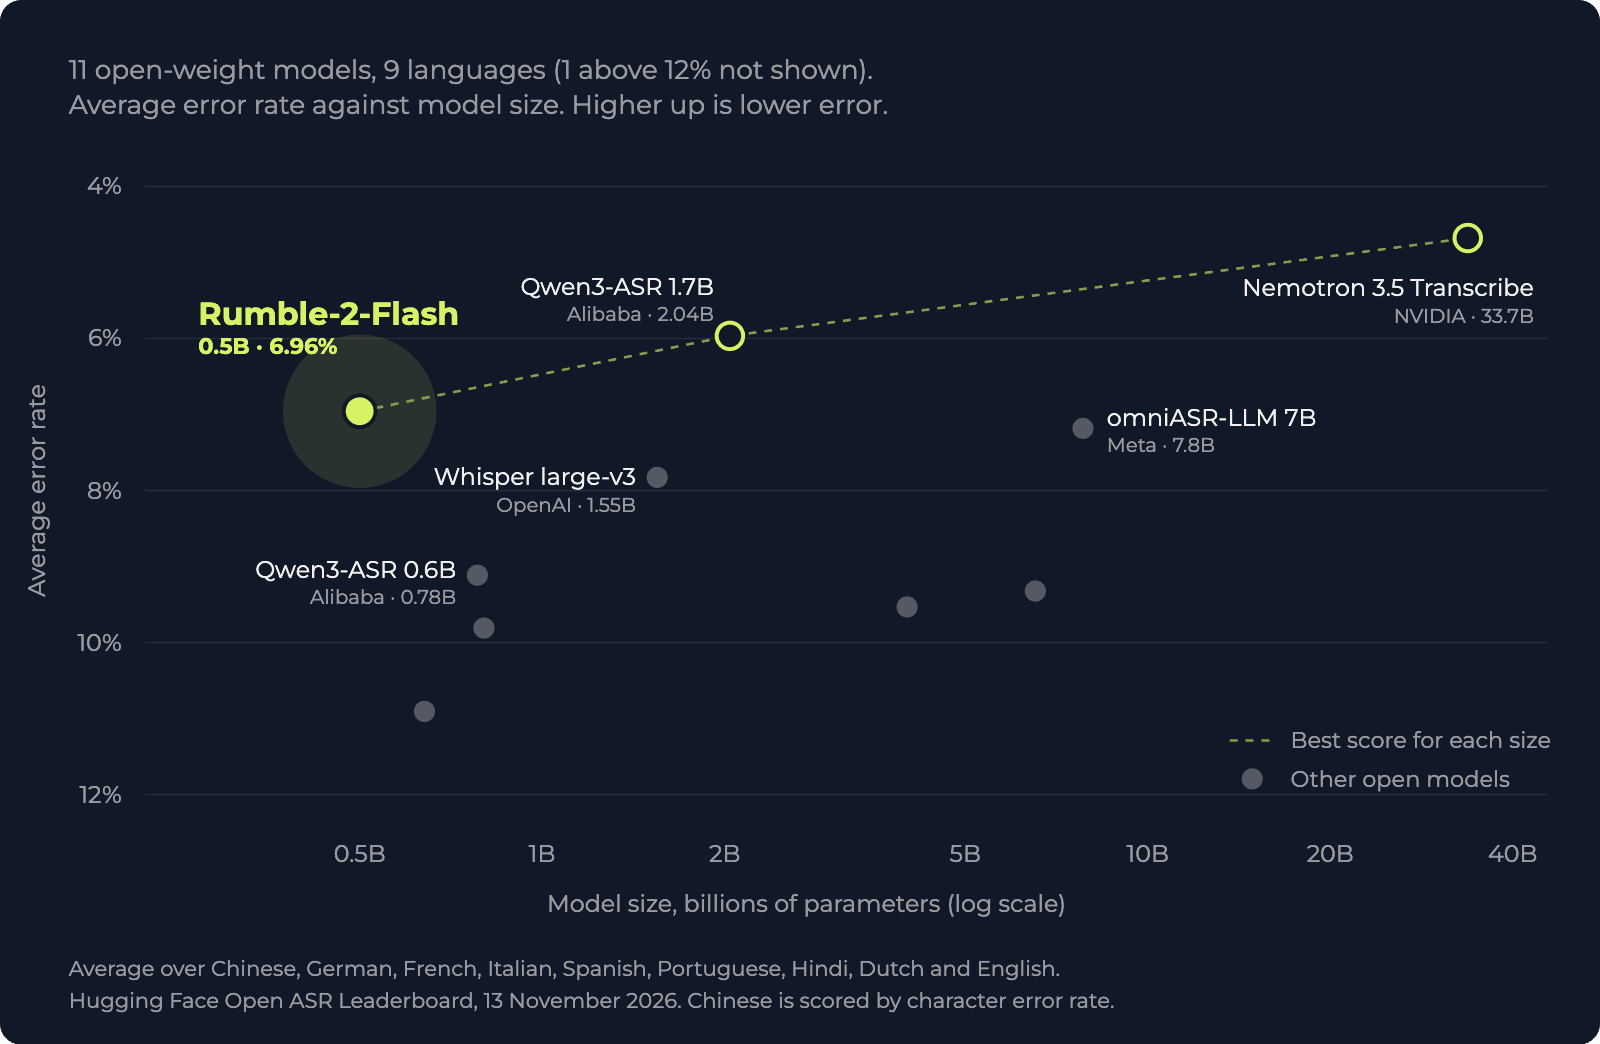
กราฟแสดงคะแนนที่ดีที่สุดสำหรับโมเดลขนาดเล็กในกลุ่มนี้
ความเร็ว
Rumble-2-Flash โดดเด่นเรื่องความเร็วอย่างมาก โดยค่า throughput เมื่อใช้งานบนชุดข้อมูลขนาดใหญ่ของ Open ASR Leaderboard ที่มีการใช้ batch เต็มพิกัด สามารถทำความเร็วได้ มากกว่า 7,000 RTFx หรือเทียบเท่าการประมวลผลเสียงหนึ่งชั่วโมงเสร็จสิ้นในเวลาประมาณครึ่งวินาที
การใช้งานจริงในสายโทรศัพท์
การถอดความเสียงที่ชัดเจนอาจเป็นเรื่องง่าย แต่เสียงจากการโทรศัพท์มักมีการบีบอัด มีเสียงรบกวน และสำเนียงที่หลากหลาย ในการทดสอบ AppTek's call-centre benchmark ซึ่งเป็นข้อมูลการโทรจริง 302 ชั่วโมง 14 สำเนียงภาษาอังกฤษ Rumble-2-Flash ทำค่า WER ได้ 7.86% ซึ่งใกล้เคียงกับ Nemotron 3.5 Transcribe (30B) ของ NVIDIA ที่ทำได้ 7.78% และดีกว่า Qwen3-ASR 0.6B (8.7%) อย่างเห็นได้ชัด
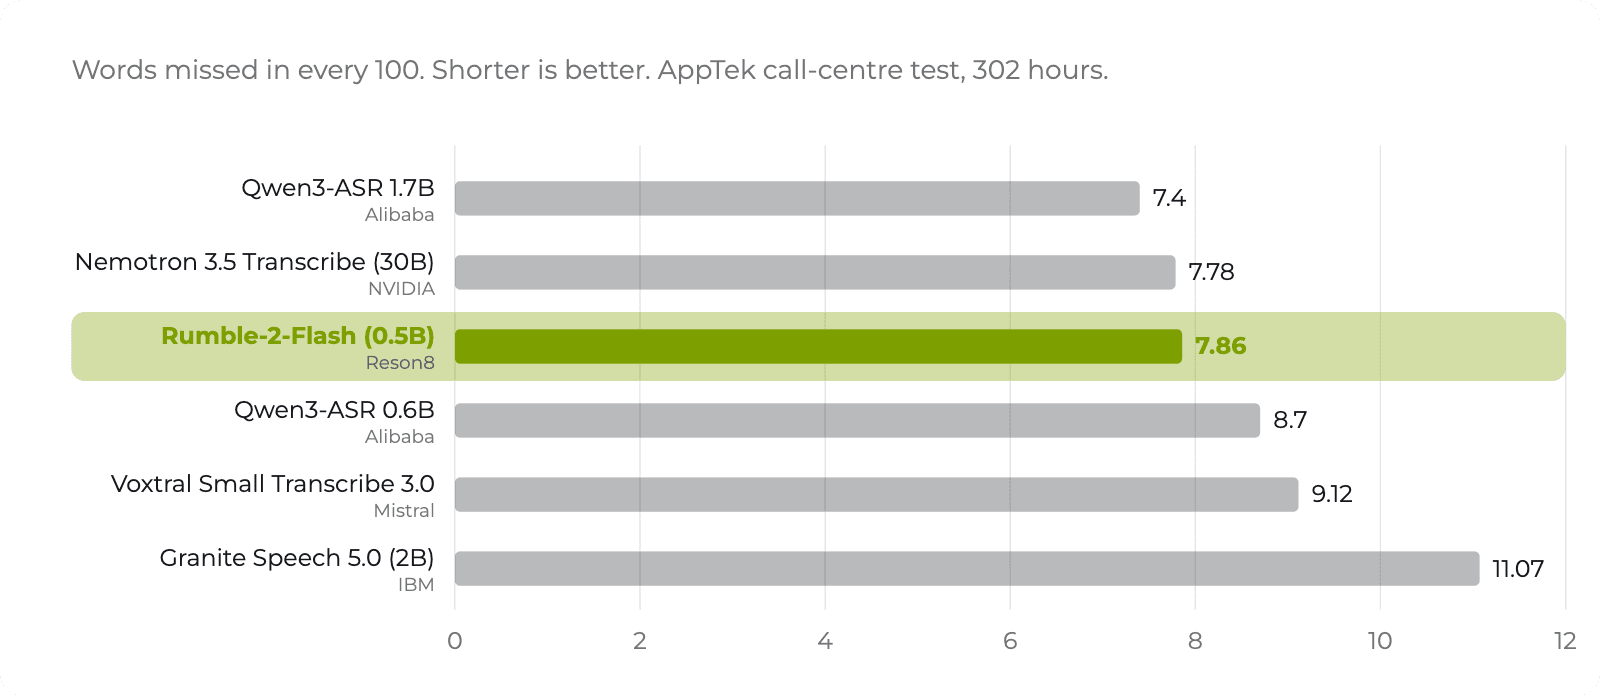
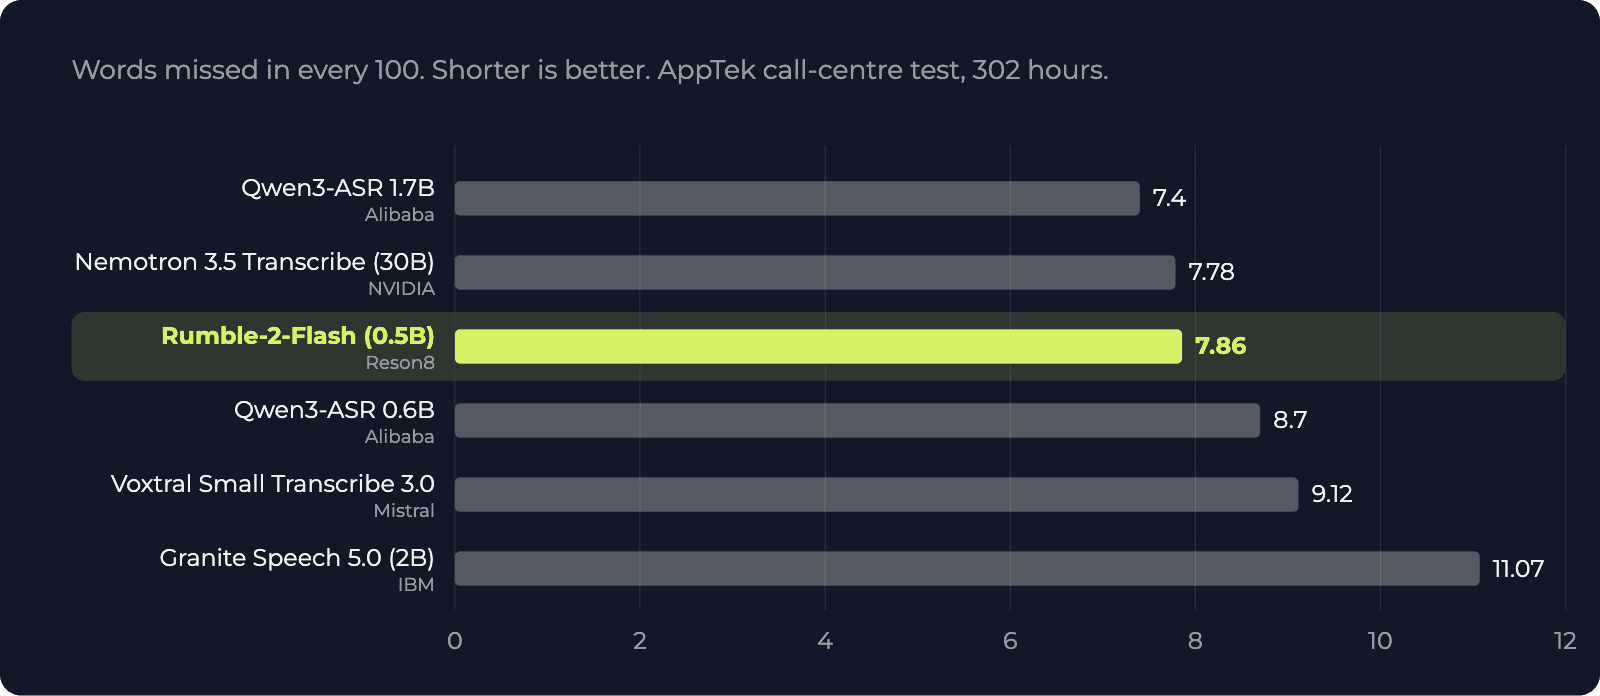
ผลการทดสอบกับการโทรศัพท์จริงใน 14 สำเนียงภาษาอังกฤษ
ทดลองใช้งาน
คุณสามารถดาวน์โหลดน้ำหนักโมเดล (weights) ได้ที่ Reson8/Rumble-2-Flash หรือใช้งานผ่าน API ของเรา
เรายินดีรับฟังความคิดเห็นเกี่ยวกับสิ่งที่คุณสร้างขึ้นจากโมเดลนี้ โดยสามารถร่วมพูดคุยได้ที่ Discussions tab เพื่อแบ่งปันผลงานและข้อเสนอแนะสำหรับการพัฒนาในเวอร์ชันถัดไป
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร