
Runway พลิกโฉมวิดีโอ AI สู่การสตรีมสดควบคุมได้แบบเรียลไทม์
Runway เปิดตัวงานวิจัยใหม่ที่เปลี่ยนรูปแบบการสร้างวิดีโอจากเดิมที่ต้องรอประมวลผล ให้กลายเป็นการสตรีมวิดีโอได้ทันทีในขณะที่ผู้ใช้งานกำลังป้อนคำสั่ง (Prompt)
โมเดลวิดีโอในปัจจุบันยังมีข้อจำกัดเรื่องขั้นตอนการทำงานที่แยกส่วน ผู้ใช้ต้องป้อนคำสั่งแล้วรอหลายนาทีกว่าจะเห็นผลลัพธ์ ซึ่งหากผลออกมาไม่ตรงใจก็ต้องเริ่มกระบวนการใหม่ทั้งหมด Runway พบว่าผู้ใช้เสียเวลาไปกับขั้นตอนนี้มากที่สุด จึงมุ่งเน้นลดเวลาสร้างเฟรมแรกให้เหลือน้อยที่สุดเพื่อเริ่มสตรีมวิดีโอได้ทันที
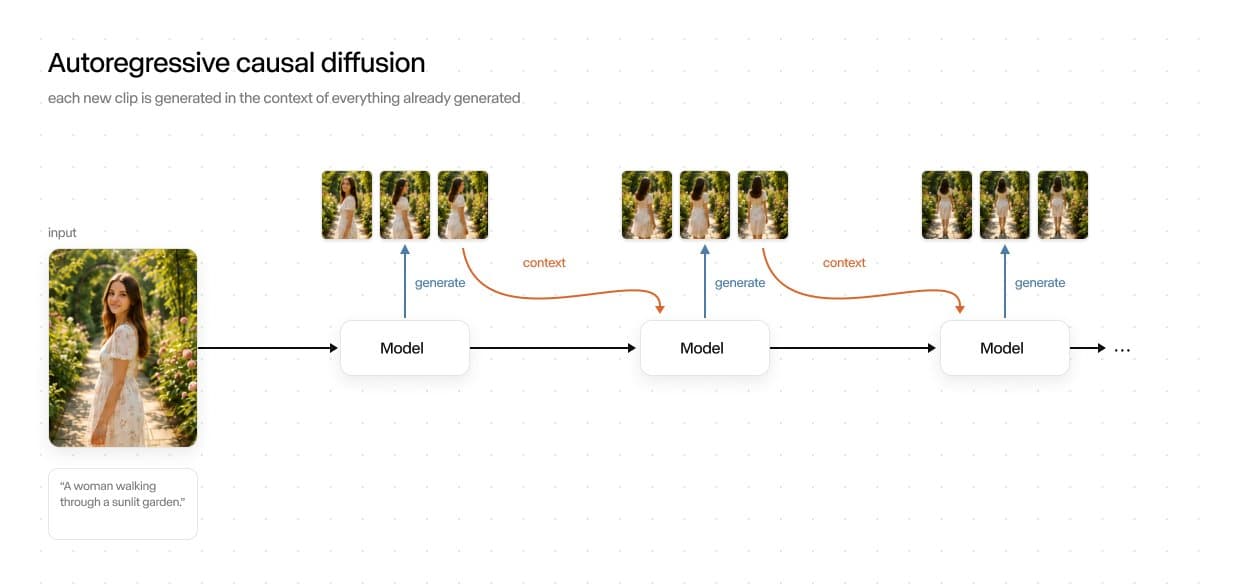
แนวทางนี้ถูกพูดถึงครั้งแรกเมื่อเดือนมีนาคมผ่าน Runway Characters โดยใช้ GWM-1 ซึ่งเป็น "General World Model" ตัวแรกของบริษัทที่เปิดตัวในเดือนธันวาคม 2025 โดย GWM-1 ต่อยอดมาจาก Gen-4.5 ที่สามารถสร้างวิดีโอแบบเฟรมต่อเฟรม และรองรับการควบคุมผ่านมุมกล้อง คำสั่งหุ่นยนต์ หรือแม้แต่เสียง
นอกจากนี้ Runway ยังได้แสดงประสิทธิภาพของ Solaris ระบบที่ใช้ Gen-4.5 สร้างอินเทอร์เฟซผู้ใช้แบบเรียลไทม์ซึ่งตอบสนองต่อการคลิกและการสั่งงานด้วยเสียงได้อย่างลื่นไหล
การสร้างแบบเรียลไทม์: ลดเวลารอและประหยัดต้นทุน GPU
Runway ระบุว่าการสร้างวิดีโอแบบเรียลไทม์ช่วยทลายกำแพงระหว่างจินตนาการกับการลงมือทำ การตอบสนองที่ทันท่วงทีช่วยให้ผู้ใช้จดจ่อกับการควบคุมทิศทางของวิดีโอได้อย่างต่อเนื่อง แทนที่จะต้องเสียเวลาไปกับการนั่งรอ
ในเชิงเศรษฐกิจ โมเดลที่ทำงานเร็วขึ้นจะใช้ทรัพยากร GPU น้อยลง ส่งผลให้ต้นทุนต่อผลลัพธ์ลดต่ำลงด้วย การลดเกณฑ์ด้านต้นทุนนี้จะช่วยให้แอปพลิเคชันต่างๆ ที่เคยถูกมองว่าไม่คุ้มทุน สามารถนำมาใช้งานจริงได้กว้างขวางยิ่งขึ้น
แก้โจทย์ความผิดเพี้ยนของภาพด้วยการฝึกจากข้อผิดพลาด
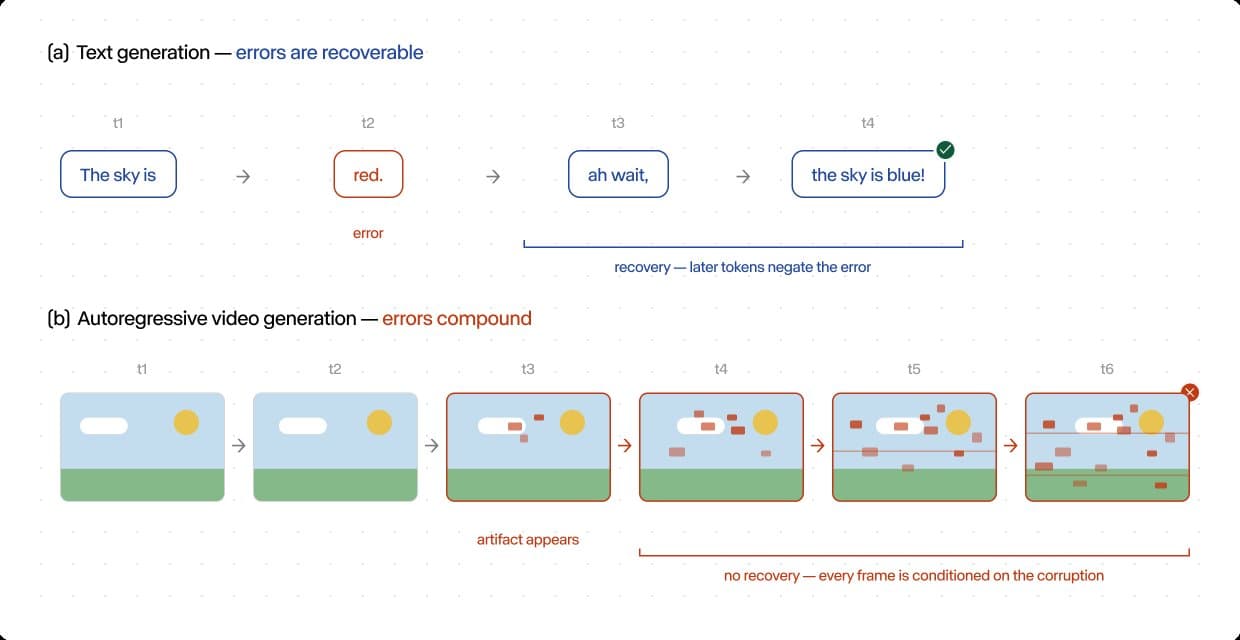
ปัญหาหลักของโมเดลวิดีโอคือการสร้างแต่ละเฟรมอ้างอิงจากเฟรมก่อนหน้า ทำให้ข้อผิดพลาดเพียงเล็กน้อยสามารถสะสมจนกลายเป็นภาพที่บิดเบือนอย่างรุนแรงเมื่อเวลาผ่านไป ซึ่งแตกต่างจากโมเดลข้อความที่สามารถแก้ไขตัวเองได้กลางประโยค
Runway แก้ปัญหานี้ด้วยการฝึกโมเดลจากผลลัพธ์ของตัวมันเอง แทนที่จะใช้เพียงข้อมูลที่สมบูรณ์แบบ เพื่อสอนให้ AI รู้จักแก้ไขการเบี่ยงเบนของภาพด้วยตัวเองแทนที่จะขยายความผิดพลาดนั้นออกไป
ปัจจุบันสตาร์ทอัพอย่าง Decart ก็ใช้แนวทางใกล้เคียงกันกับโมเดล MirageLSD ขณะที่ Google Deepmind อ้างว่า Genie 3 สามารถรักษาความต่อเนื่องของโลกจำลองได้นานหลายนาทีที่ความละเอียด 720p 24fps
จากงานสร้างสรรค์สู่การฝึกหุ่นยนต์และรถไร้คนขับ
ในระยะยาว Runway มองเห็นศักยภาพของ AI ในกลุ่มแอปพลิเคชันที่มีปฏิสัมพันธ์สูง เช่น การศึกษา เกม และหุ่นยนต์ ซึ่งต้องการวิดีโอที่ตอบสนองรวดเร็วเท่ากับความเร็วของมนุษย์ การทดสอบหุ่นยนต์หรือรถยนต์ไร้คนขับในโลกจริงจำเป็นต้องมีสภาพแวดล้อมจำลองที่สร้างขึ้นแบบเรียลไทม์และตอบสนองต่อสถานการณ์ผิดปกติ (Edge cases) ได้ทันที
บริษัทได้เปิดตัว GWM Robotics ซึ่งเป็น ตัวแปรหนึ่งของ GWM-1 เพื่อสร้างข้อมูลจำลองสำหรับการฝึกหุ่นยนต์โดยเฉพาะ เช่นเดียวกับ Waymo ที่ใช้ Waymo World Model (อิงจาก Genie 3) ในการจำลองเหตุการณ์ที่ไม่คาดฝันบนท้องถนน เช่น การเจอสัตว์ป่าหรือภัยพิบัติ เพื่อฝึกฝนระบบก่อนนำไปขับขี่จริงบนถนนสาธารณะ
ล่าสุดในงาน GTC ของ Nvidia ทาง Runway ได้ แสดงตัวอย่างงานวิจัย โมเดลเรียลไทม์ที่ทำงานบนแพลตฟอร์ม Vera Rubin ซึ่งสามารถแสดงเฟรมแรกได้ในเวลาไม่ถึง 100 มิลลิวินาที อย่างไรก็ตาม บริษัทยังไม่ได้กำหนดวันเปิดใช้งานอย่างเป็นทางการ
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร