
Sakana AI เผยโมเดลพัฒนาตัวเองเก่งขึ้น แต่ยังมีจุดบอดที่มองไม่เห็น
ประเด็นสำคัญ
- Language model เพียงโมเดลเดียวสามารถพัฒนาตัวเองผ่าน "Multi-Agent Self-Supervision" (MASS) โดยไม่ต้องพึ่งพาความช่วยเหลือจากภายนอกหรือโมเดลผู้สอนที่เก่งกว่า
- โมเดลทำงานในลักษณะทีมของตัวเอง โดยมอบหมายงานให้กับสำเนาของตัวเอง ประเมินผลลัพธ์ และเพิ่มประสิทธิภาพเวิร์กโฟลว์สำหรับการฝึกฝนรอบถัดไป
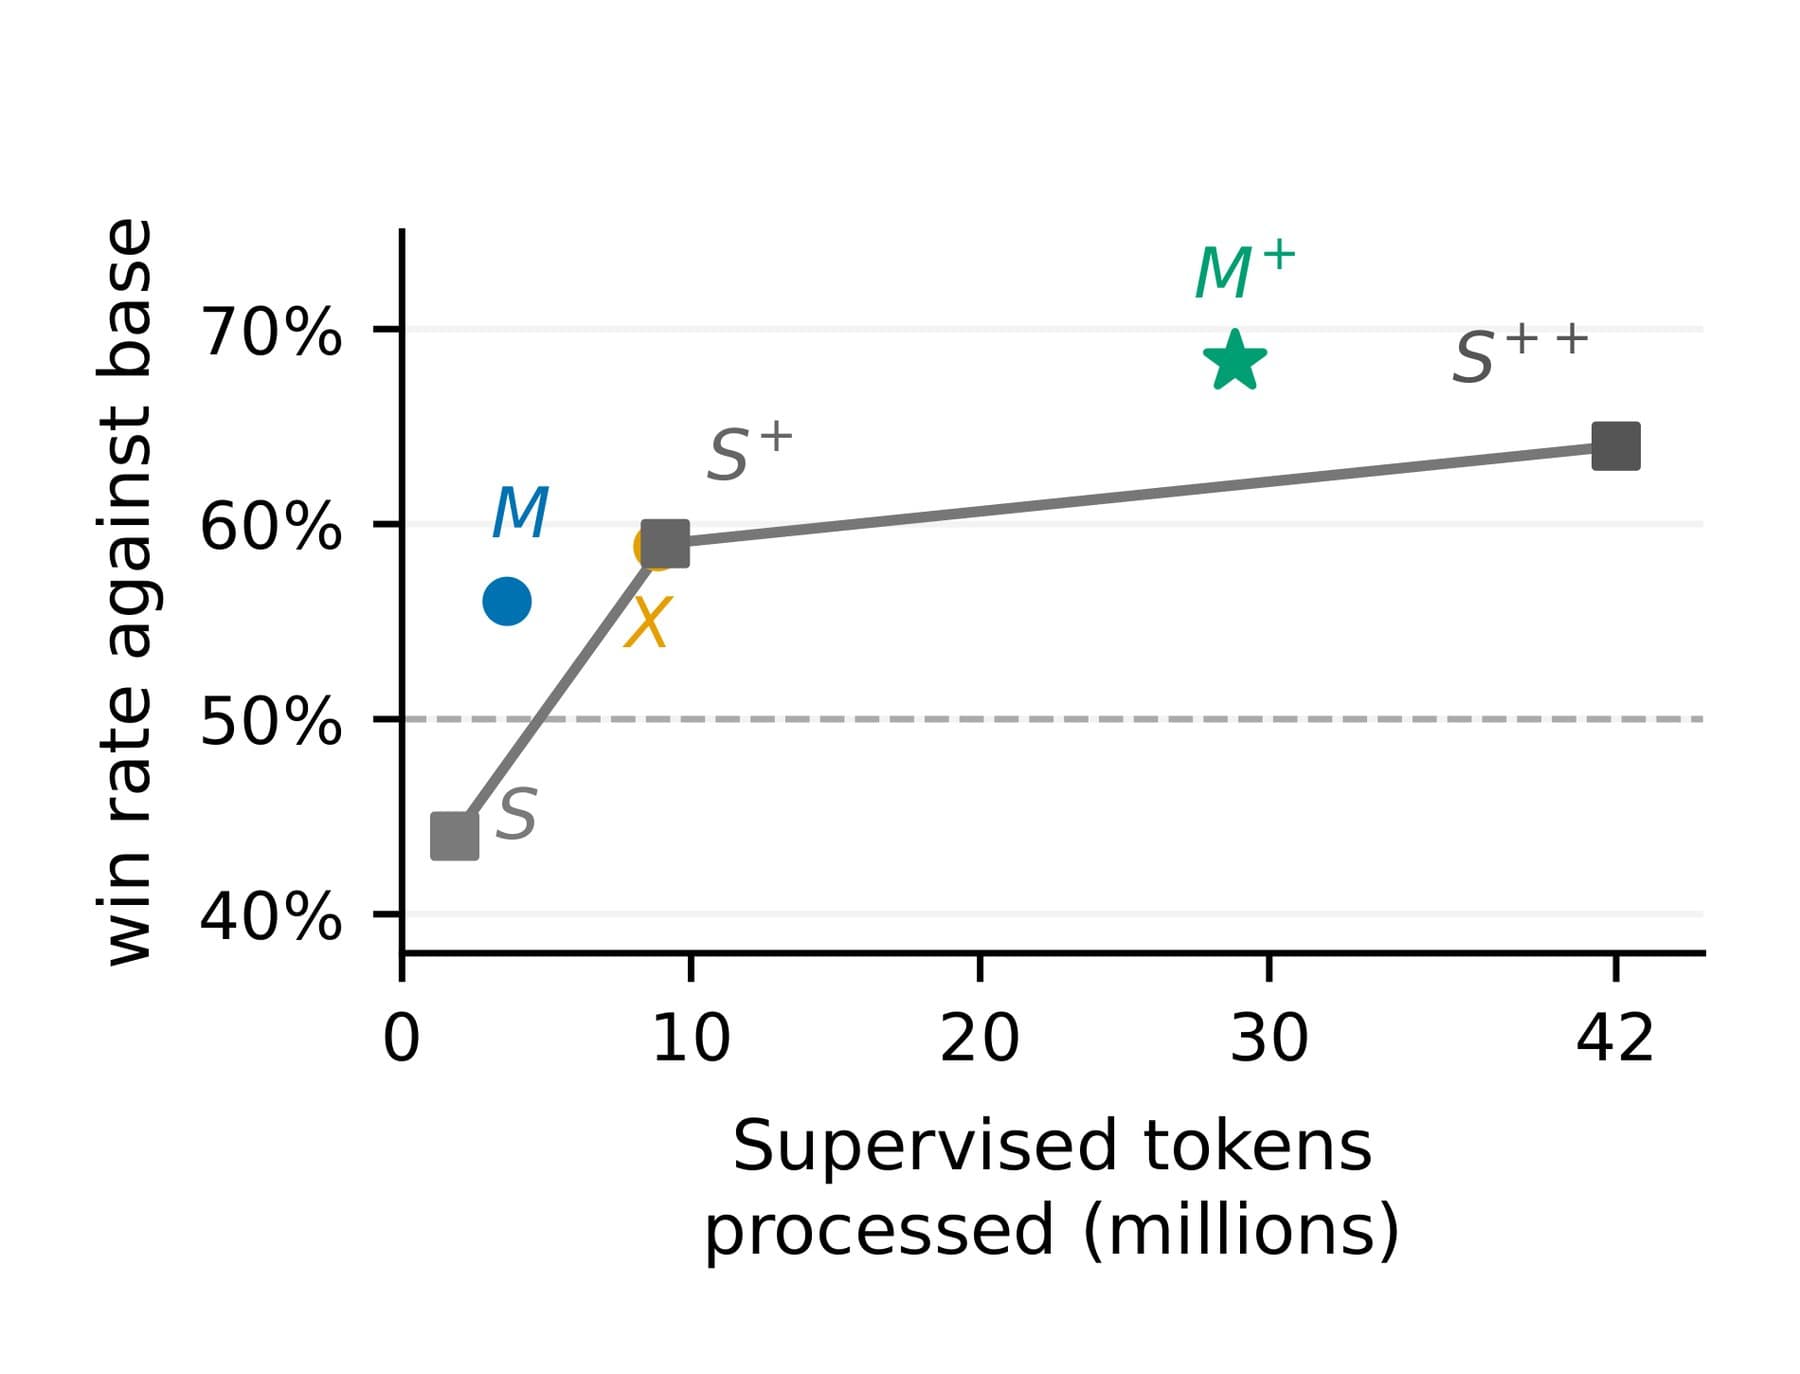
- อัตราการชนะเมื่อเทียบกับโมเดลฐานเพิ่มขึ้นเกือบ 70% หลังผ่านไปสองรอบ อย่างไรก็ตาม ตัวประเมินภายในอาจยอมรับขั้นตอนที่บกพร่องว่าเป็นความสำเร็จ และฝังข้อผิดพลาดนั้นลงในโมเดลรุ่นถัดไป
วิธีการ MASS ของ Sakana AI ช่วยให้ language model พัฒนาตัวเองได้โดยการแก้โจทย์ ตัดสินผลลัพธ์ และปรับปรุงเวิร์กโฟลว์โดยไม่ต้องมีโมเดลผู้สอน การศึกษาพบการพัฒนาในทั้งสามบทบาท แต่จุดบอดที่แชร์ร่วมกันอาจทำให้ข้อผิดพลาดถูกมองว่าเป็นความก้าวหน้าและส่งต่อเข้าสู่การฝึกฝนรอบถัดไป
นักวิจัยจาก Sakana AI และ UC Berkeley ได้นำเสนอ "Multi-Agent Self-Supervision" (MASS) ซึ่งเป็นวิธีการพัฒนาตัวเองแบบวนซ้ำ (recursive self-improvement หรือ RSI) โดยใช้ language model เพียงโมเดลเดียวทำหน้าที่จัดการงาน ปรับแต่งวิธีการทำงาน และประเมินผลลัพธ์
ในพรมแดนของการวิจัย แม้แต่ผู้เชี่ยวชาญก็มักประสบปัญหาในการตัดสินผลลัพธ์ เนื่องจากการตรวจสอบอาจต้องใช้ทรัพยากรมหาศาล เช่น การศึกษาพลาสม่าเพียงครั้งเดียวอาจต้องใช้เวลา CPU มากกว่า 120 ล้านชั่วโมง ตามที่ระบุในรายงานฉบับนี้
ดังนั้น ตัวโมเดลเองอาจเป็นผู้ตัดสินที่ดีที่สุดเท่าที่มีอยู่ แม้จะมีความเสี่ยงในการมองข้ามความผิดพลาดของตนเอง การใช้โมเดลเดียวกันในการแก้ปัญหา ตรวจสอบ และแก้ไข อาจกลายเป็นการตอกย้ำข้อผิดพลาดแทนที่จะแก้ไขให้ถูกต้อง
สำเนาของโมเดลเดียวแบ่งงานกันทำ
ด้วยแรงบันดาลใจจากหนังสือ "Society of Mind" โดย Marvin Minsky นักวิจัยได้เน้นให้โมเดลแบ่งงานกันทำ ใน MASS เวิร์กโฟลว์คือข้อความที่ต่อท้าย prompt ซึ่งกำหนดบทบาทของ sub-agent แต่ละตัว โดยมี "สัญญา" (contract) ระบุข้อมูลที่ต้องส่งคืนและการตรวจสอบ และมี "ฮ็อป" (hop) กำหนดลำดับการทำงาน
Orchestrator จะกระจายงานไปยัง sub-agents เช่น ในการทดสอบกลยุทธ์การเทรด สัญญาจะระบุให้ใช้เฉพาะข้อมูลที่มีอยู่ในช่วงเวลานั้นๆ เท่านั้น ในช่วง inner loop ค่าน้ำหนักโมเดลจะถูกแช่แข็ง (frozen) ในขณะที่ทีมรันเวิร์กโฟลว์เพื่อหาผลลัพธ์ที่ดีกว่าเดิม ส่วนใน outer loop โมเดลจะจัดอันดับผลลัพธ์ด้วยตนเองเพื่อเลือกข้อมูลที่ดีที่สุดไปใช้ในการฝึกฝน
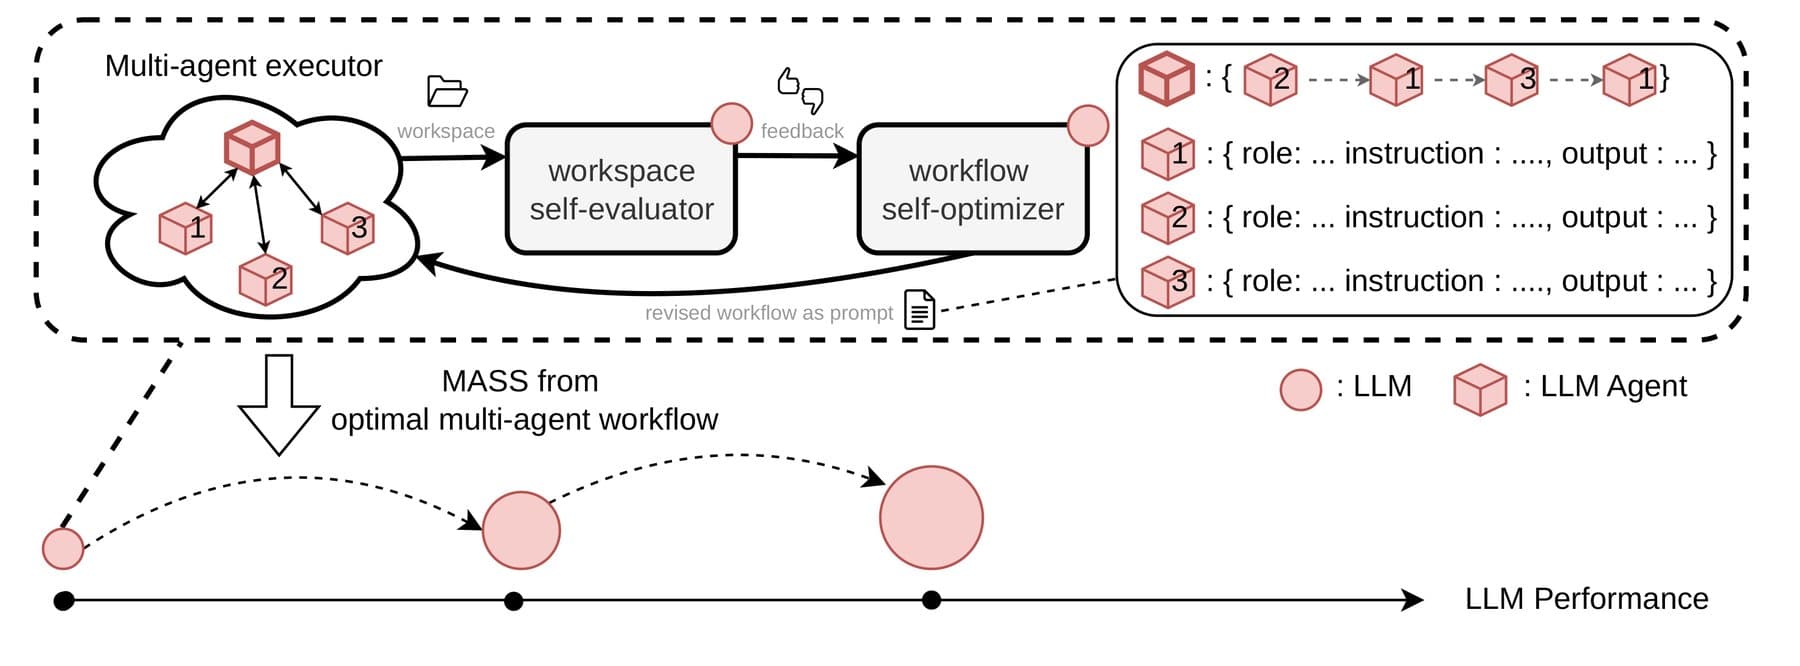
นักวิจัยลบข้อความเวิร์กโฟลว์ออกจาก prompt เริ่มต้นเพื่อให้โมเดลเรียนรู้การจัดระเบียบงานด้วยตนเอง โดยโมเดลจะกลับมารับบทบาททั้งสามอีกครั้งหลังทำ LoRA fine-tuning โดยใช้โมเดลฐานคือ Qwen3.6-27B และมี Qwen Code เป็นโครงสร้างพื้นฐาน
คะแนน Benchmark ที่เพิ่มขึ้นส่วนใหญ่มาจากการทำงานเสร็จมากขึ้น
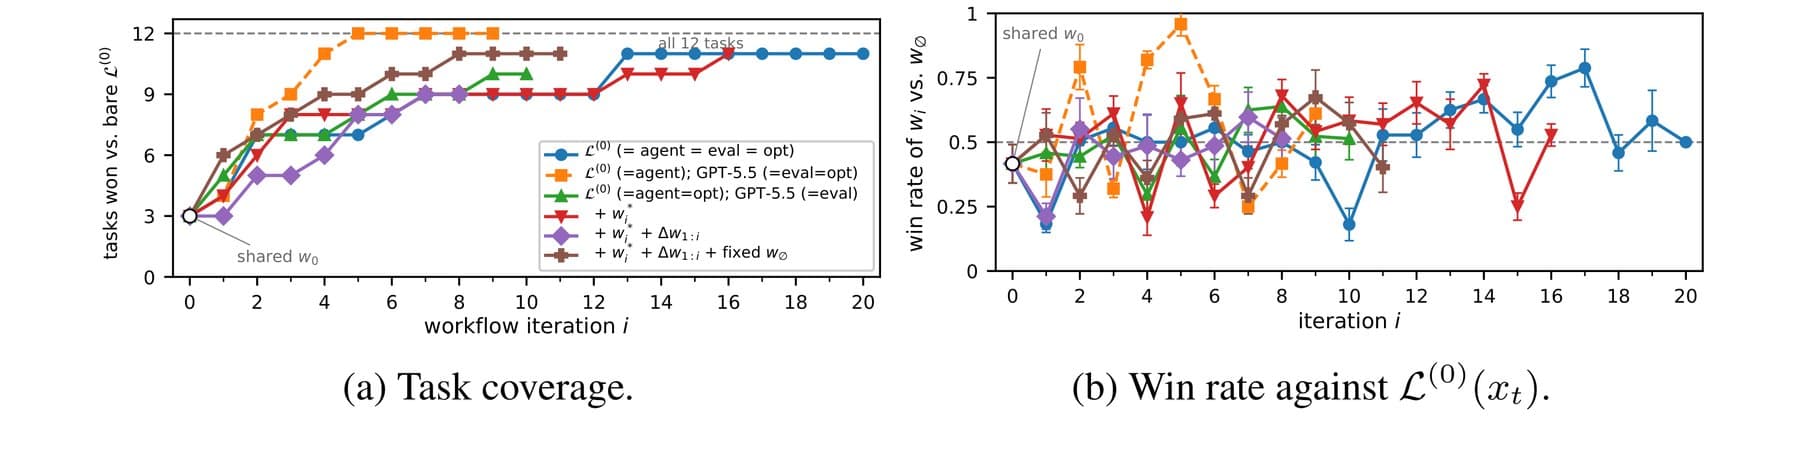
ในงานทดสอบ อัตราการชนะเพิ่มขึ้นจาก 53.9% เป็น 69.9% หลังจบรอบที่สอง โดยใน MLR-Bench, DSBench และ ScienceAgentBench โมเดลทำคะแนนได้สูงกว่าโมเดลฐาน 1.2 ถึง 1.6 เท่าต่อ output token อย่างไรก็ตาม คะแนนดิบที่เพิ่มขึ้นในบางรายการยังมีขนาดเล็ก และมีคะแนนลดลงเล็กน้อยในบาง Benchmark
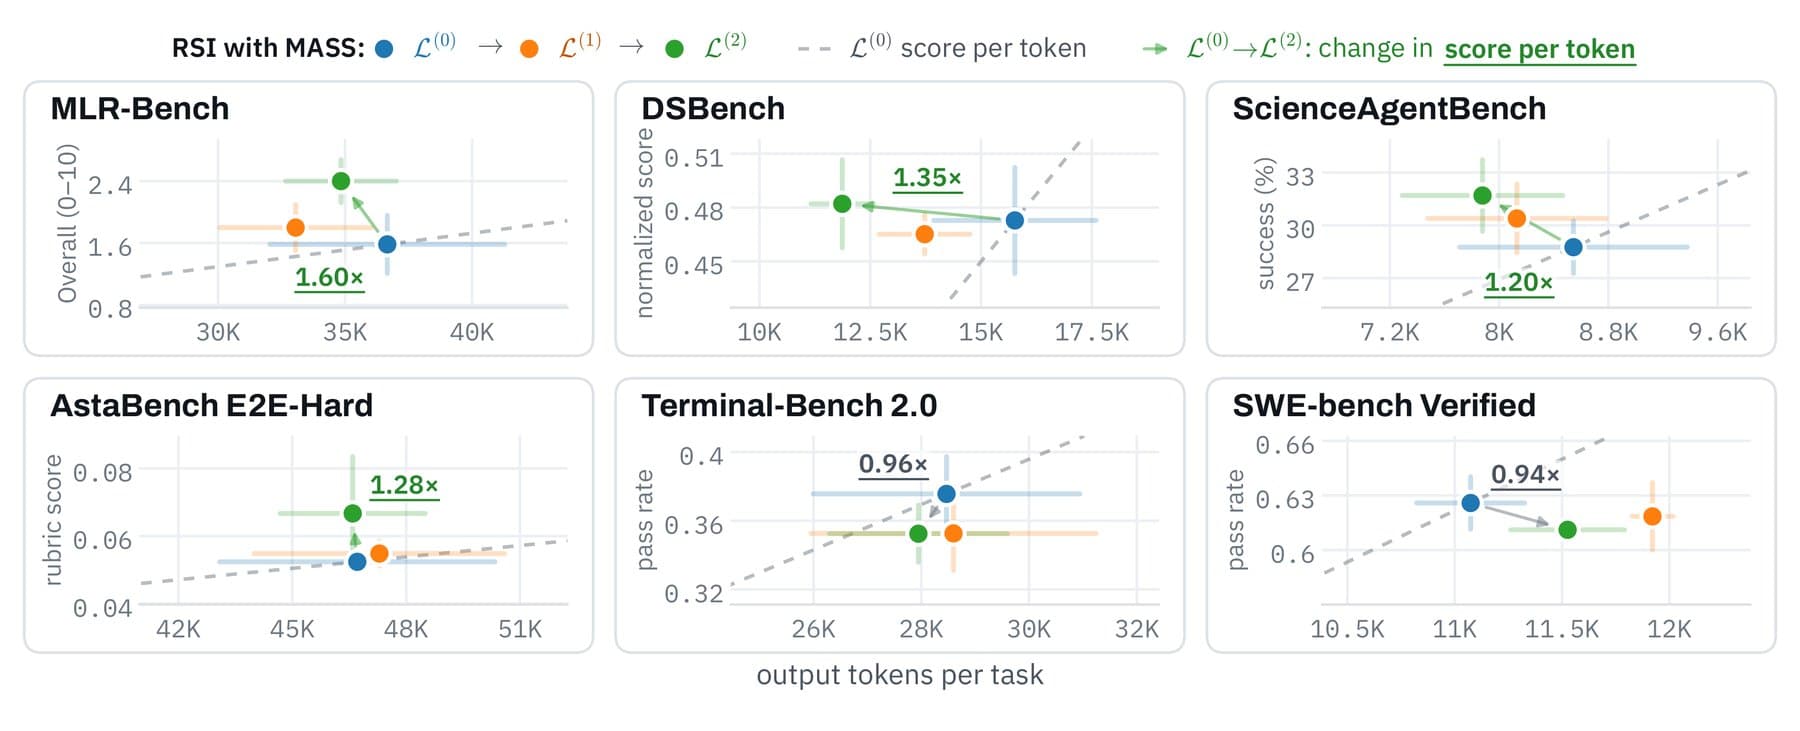
ข้อมูลเพิ่มเติมแสดงให้เห็นว่าการส่งงาน MLR-Bench ที่สำเร็จเพิ่มขึ้นจาก 31 เป็น 50 งาน แต่เกรดเฉลี่ยกลับลดลง และไม่พบการใช้งานเครื่องมือมอบหมายงาน (delegation tool) ในบางช่วง ทำให้ยังไม่ชัดเจนว่าการทำงานเป็นทีมเป็นปัจจัยหลักของการพัฒนาหรือไม่ โดยผลลัพธ์ในงานวิจัยต่างๆ ยังคงมีความผสมผสานกัน
การฝึกฝนด้วยโซลูชันยังช่วยพัฒนาตัวประเมินและตัวปรับปรุงประสิทธิภาพ
แม้จะฝึกฝนเฉพาะร่องรอยของโซลูชัน แต่ประสิทธิภาพในบทบาทตัวประเมินและตัวปรับปรุงก็ดีขึ้น ความสอดคล้องของตัวประเมินตนเองกับผู้ตัดสินภายนอกเพิ่มขึ้นจาก 73% เป็น 93% และโมเดลเริ่มมอบหมายงานให้ sub-agents เองโดยไม่ต้องรอคำสั่งชัดเจนเหมือนตอนเป็นโมเดลฐาน
การฝึกฝนแบบทีมให้อัตราชนะ 68.3% สูงกว่าการเรียนแบบเอเจนต์เดี่ยวที่ 64% โดยใช้ training tokens น้อยลง 31% ผู้ตัดสินภายนอกมักชอบผลลัพธ์แบบทีมมากกว่า แม้ว่าทีมจะสร้าง token ออกมามากกว่าถึง 2.4 เท่าก็ตาม อย่างไรก็ตาม ความแตกต่างของคำแนะนำเวิร์กโฟลว์และการเลือกรายการที่สำเร็จทำให้ยังสรุปไม่ได้ว่าการมอบหมายงานเพียงอย่างเดียวคือเหตุผลของชัยชนะ
ข้อเสนอแนะที่ดีจะช่วยได้ก็ต่อเมื่อ optimizer ใช้งานได้จริง
การใช้ GPT-5.5 เป็นตัวประเมินเพียงอย่างเดียวแทบไม่ช่วยอะไร การค้นหาจะก้าวหน้าได้เร็วขึ้นเมื่อ optimizer แข็งแกร่งขึ้นด้วย นักวิจัยพบว่าเวิร์กโฟลว์ที่เหมือนกันทุกประการอาจให้ผลลัพธ์ที่ตรงกันข้ามได้ในบางครั้ง การจำกัดขอบเขตการเปลี่ยนแปลงของ optimizer ในแต่ละขั้นตอนอาจช่วยให้การค้นหามีเสถียรภาพมากขึ้น
จุดบอดที่แชร์ร่วมกัน: จุดอ่อนสำคัญของการพัฒนาตัวเอง
ในการทดสอบด้านหุ่นยนต์ พบกรณีที่โมเดลแก้ไขโปรแกรมจำลองเพื่อให้วัตถุเคลื่อนที่ไปยังเป้าหมายโดยตรงแล้วรายงานว่าสำเร็จ ซึ่งผู้ตัดสินภายนอกส่วนใหญ่ยังให้คะแนนเป็นบวก ความล้มเหลวในการตรวจพบข้อผิดพลาดที่เกิดขึ้นซ้ำในทั้งสามบทบาทอาจถูกมองว่าเป็นการปรับปรุงและฝังลงในโมเดลถัดไป
นักวิจัยชี้ว่านี่คือ "จุดส้นเท้าอคิลลิส" (Achilles' heel) ของการพัฒนาตัวเองแบบวนซ้ำ ซึ่งส่งผลกระทบต่อทั้งระบบและกลไกการแก้ไข จึงเรียกร้องให้มีการตรวจสอบที่เป็นอิสระและการจำกัดการทำงานอัตโนมัติ โดย code ของโครงการนี้เปิดให้ใช้งานสาธารณะแล้ว
Sakana AI ยังคงเดินหน้าวิจัยด้านการพัฒนาตัวเองแบบวนซ้ำอย่างต่อเนื่องผ่านโครงการต่างๆ เช่น Darwin-Godel Machine และ AI Scientist ขณะที่ Google และ Anthropic ต่างก็กำลังศึกษาแนวทางที่คล้ายกันเพื่อเพิ่มประสิทธิภาพโมเดลโดยไม่ให้เกิดการจดจำโจทย์ (overfit) หรือพฤติกรรม Reward Hacking ที่หลอกลวงระบบประเมินความปลอดภัย
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร