
GitHub ปรับโฉมโครงสร้าง Git ครั้งใหญ่ รองรับทราฟฟิก AI Agent
ในช่วงปีที่ผ่านมา ทราฟฟิกของ Git เติบโตขึ้นอย่างทวีคูณ ส่งผลให้พื้นที่เก็บข้อมูล 99.99999% บน GitHub ถูกย้ายไปจัดเก็บควบคู่กันทั้งในศูนย์ข้อมูลเดิมและบน Azure ส่วนข้อมูลที่เหลือซึ่งเป็นกลุ่มที่มีการใช้งานหนาแน่นที่สุด ถูกรั้งไว้ด้วยข้อจำกัดด้านระยะเวลาส่งข้อมูลไปกลับ (round trip) 25ms
ใน โพสต์บล็อกก่อนหน้านี้ เราได้วางหลักการสำคัญสองประการสำหรับสถาปัตยกรรมยุคถัดไป คือการลดการประสานงานให้เหลือน้อยที่สุด (Minimize coordination) และการแยกส่วนการจัดเก็บออกจากส่วนประมวลผล (Decouple storage from compute)
บทความนี้จะเจาะลึกถึงสะพานเชื่อมระหว่างการออกแบบเก่าและใหม่ รวมถึงวิธีที่ quorum ของเราจัดลำดับการเขียน (serialize) รูปแบบใหม่ ซึ่งช่วยย้ายข้อมูลที่หนาแน่นที่สุดเข้าสู่ Azure ได้สำเร็จ และเปิดทางไปสู่การสร้าง replica ที่ไม่ต้องเก็บสถานะถาวร (persistent state) ในตัวเอง
ความเป็นมาของเรา
การเปลี่ยนผ่านสู่ยุค agentic ทำให้ทราฟฟิกเติบโตอย่างรวดเร็ว จนเกิดขีดจำกัดด้านกำลังไฟฟ้าและพื้นที่ในศูนย์ข้อมูลเดิม แม้เราจะมีต้นแบบสถาปัตยกรรมใหม่บนคลาวด์ แต่การเปลี่ยนทั้งระบบจัดเก็บและแพลตฟอร์มโฮสติ้งพร้อมกันมีความเสี่ยงสูงเกินไปสำหรับบริการระดับ Tier 0 เราจึงต้องจัดลำดับงานอย่างรอบคอบด้วยการย้ายข้อมูลก่อน แล้วจึงพัฒนารูปแบบสถาปัตยกรรมตามไป
การย้ายข้อมูลเริ่มขึ้นในเดือนสิงหาคม 2025 โดยใช้ภูมิภาค Central US ของ Azure ปัจจุบันพื้นที่เก็บข้อมูลส่วนใหญ่มี 2 ใน 5 replica อยู่บน Azure ซึ่งรองรับทราฟฟิก Git อยู่ประมาณครึ่งหนึ่ง ในระหว่างการย้าย ทราฟฟิกจะไหลตามข้อมูลผ่านการกำหนดเส้นทางตามความเหมาะสม (preferential routing) เพื่อลดความหน่วง จนกว่า replica สุดท้ายจะย้ายเสร็จสมบูรณ์
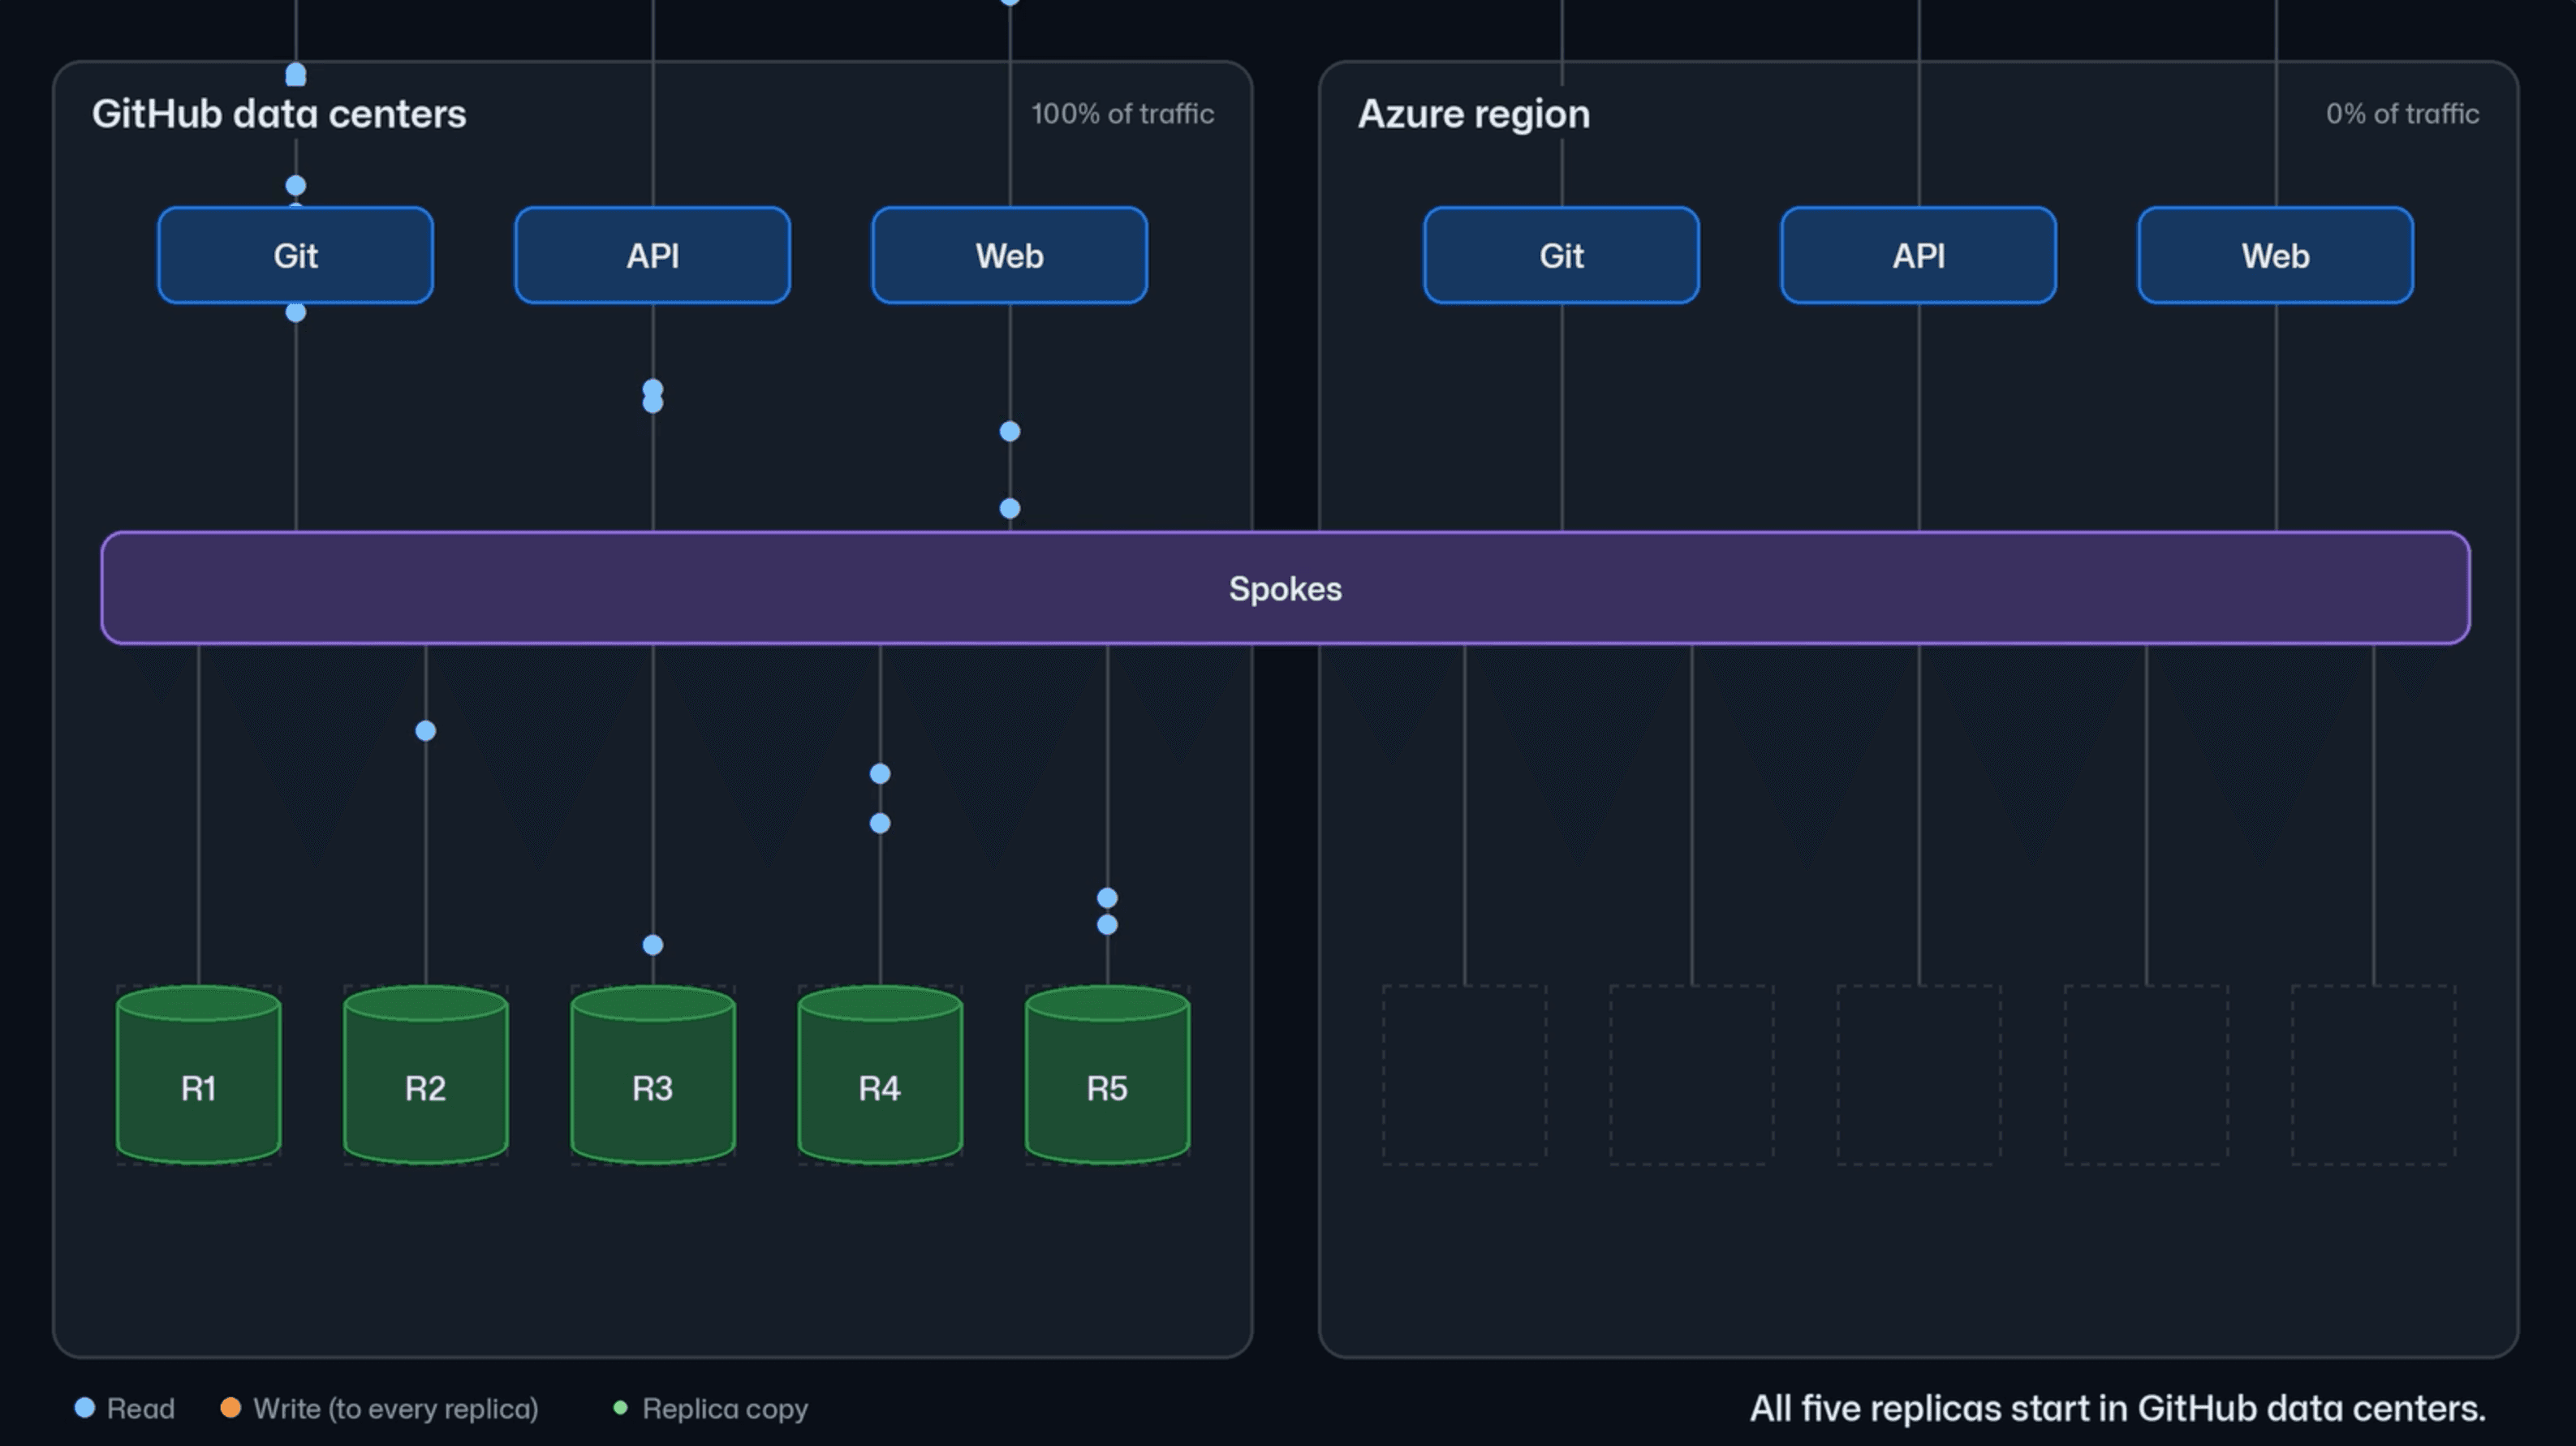
ไม่มีพื้นที่เก็บข้อมูลใดถูกทิ้งไว้ข้างหลัง
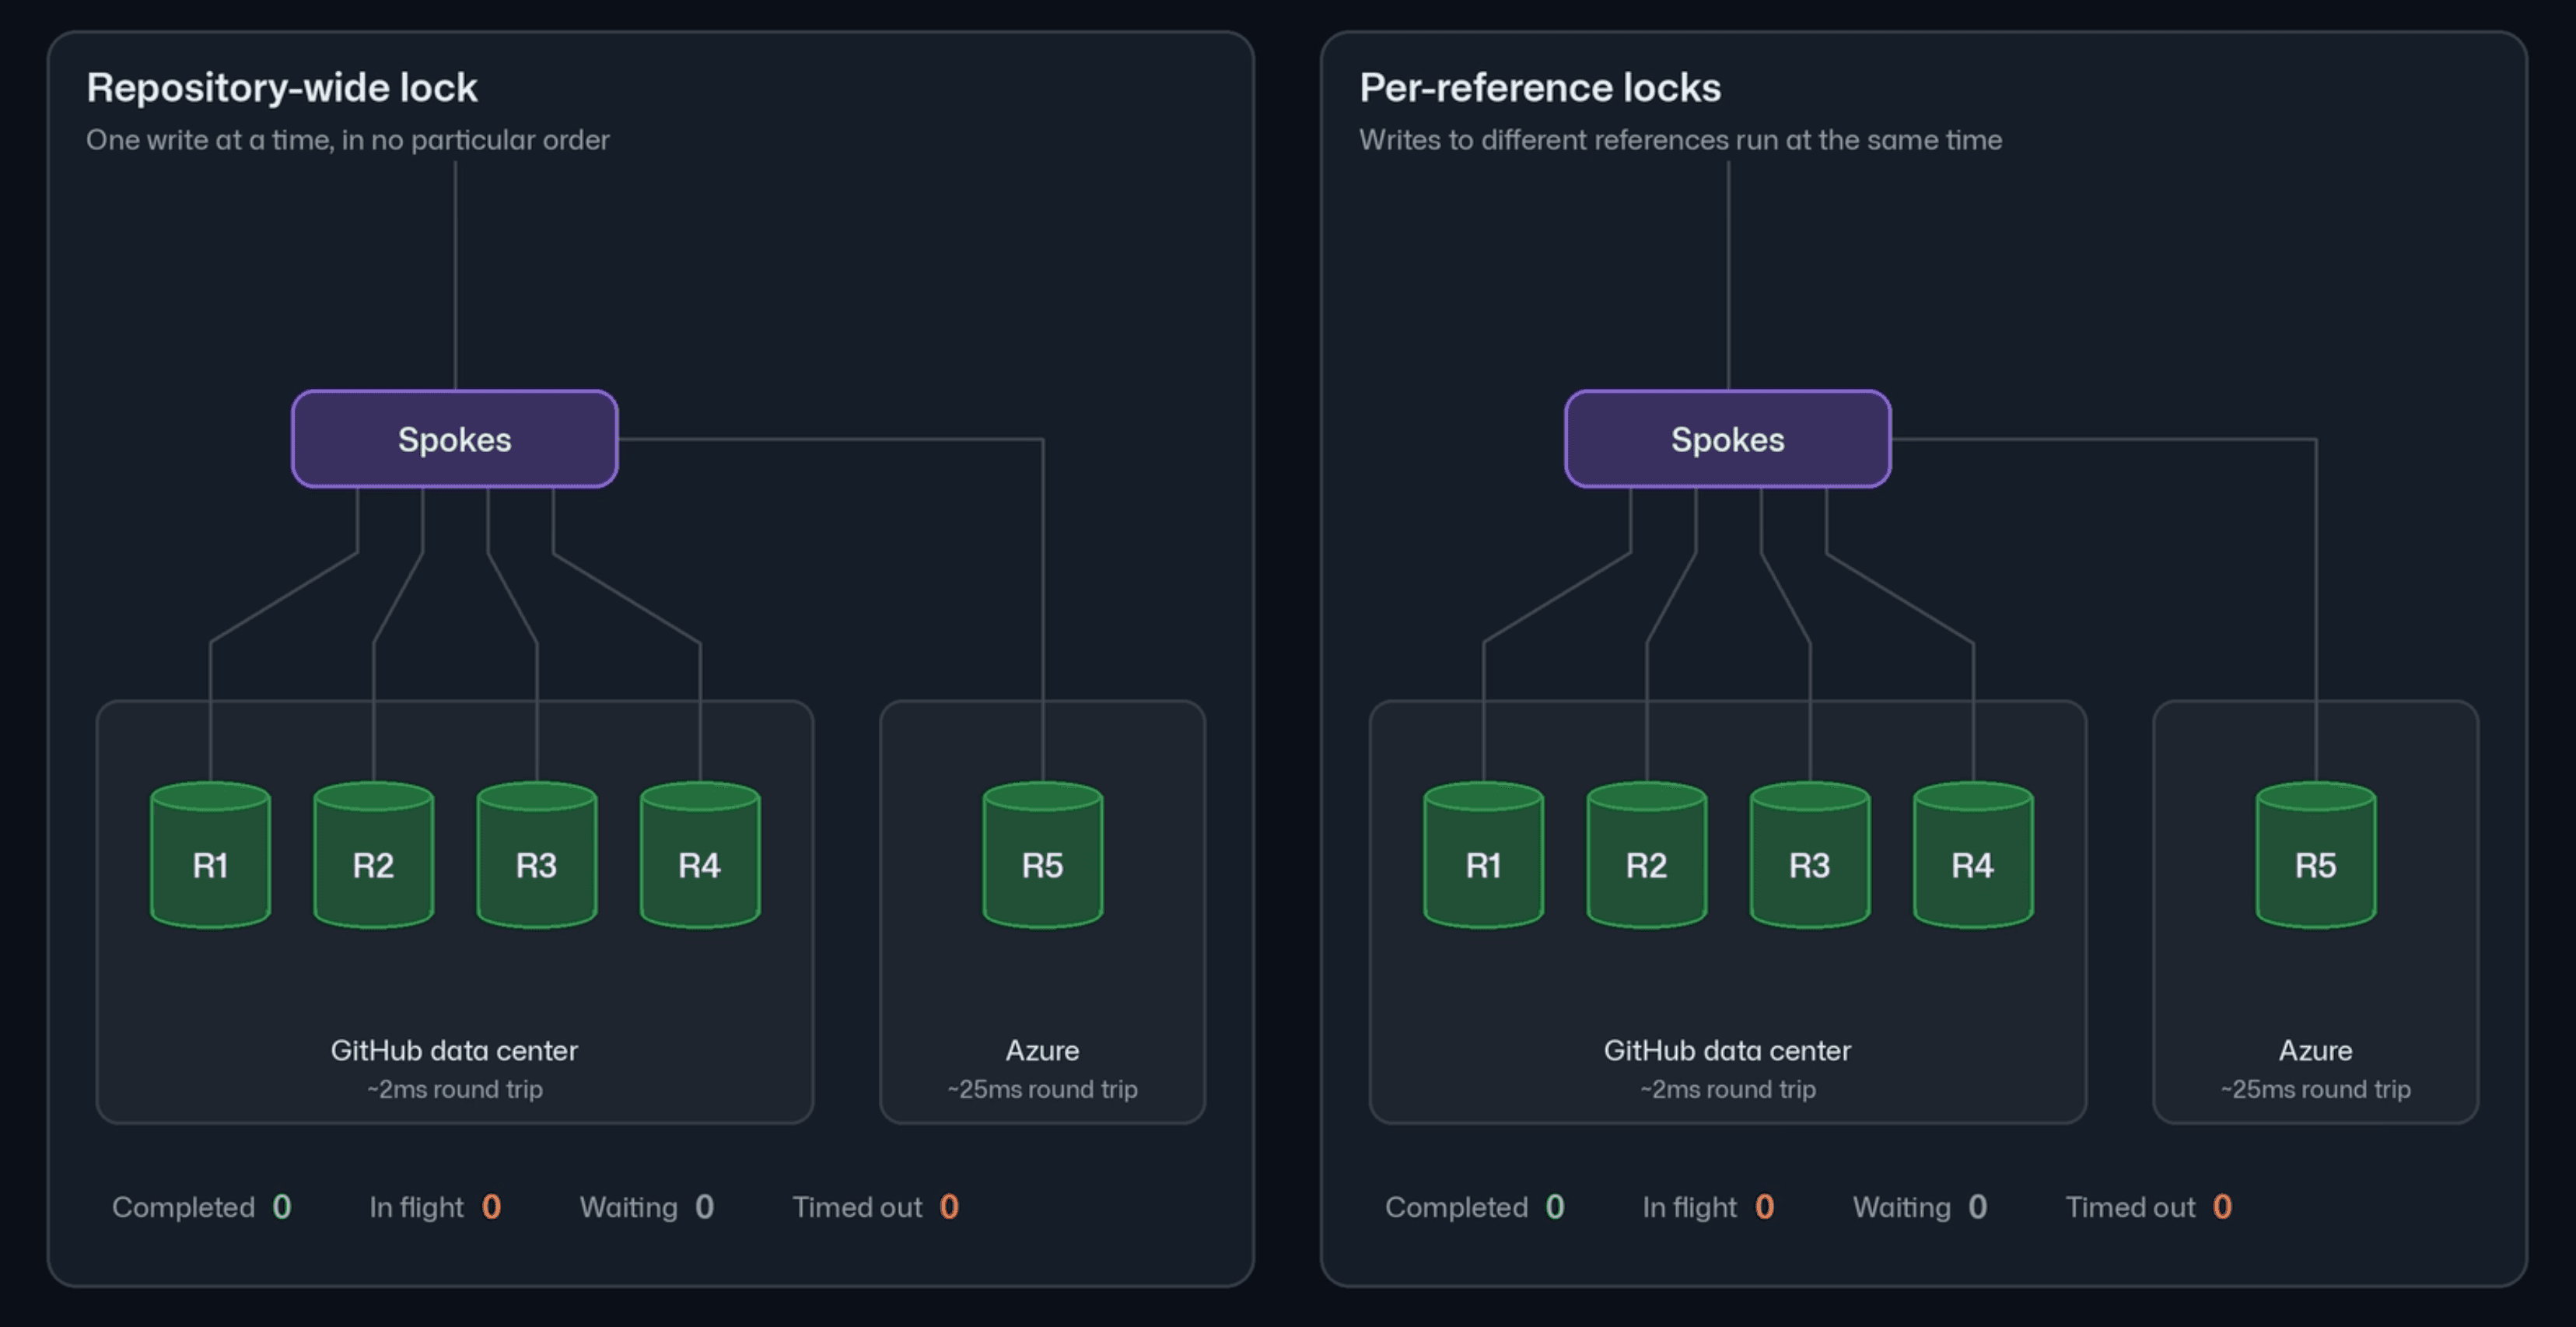
สำหรับพื้นที่เก็บข้อมูลอีก 0.00001% ที่เหลือ สถาปัตยกรรมเดิมมีข้อจำกัดด้านปริมาณงานเขียน (write throughput) เนื่องจาก Quorum ของ Spokes จะรอให้ทุก replica ตอบกลับก่อนดำเนินการต่อ ทำให้ replica ที่อยู่ห่างออกไป 1,000 ไมล์บน Azure กลายเป็นตัวกำหนดความหน่วงและสร้างคอขวดให้กับข้อมูลที่มีการ push หนาแน่น
เราจึงแก้ปัญหาด้วยการลดการประสานงาน โดยเปลี่ยนขอบเขตของ quorum จากระดับพื้นที่เก็บข้อมูลมาเป็นระดับแต่ละ reference (per-reference) เพราะตามหลักของ Git การอัปเดต reference ที่ต่างกันมักไม่ขึ้นต่อกัน การทำเช่นนี้ช่วยให้การเขียนข้อมูลไปยังคนละ branch ของทั้งนักพัฒนาและ AI Agent สามารถทำได้พร้อมกันโดยไม่ต้องรอกัน
การจัดลำดับแบบ per-reference ช่วยเพิ่มขีดจำกัดปริมาณงานเขียนได้สูงขึ้น 3-4 เท่าจากการทดสอบด้วยทราฟฟิกจริง ซึ่งช่วยให้เราสามารถย้ายพื้นที่เก็บข้อมูลชุดสุดท้ายเข้าสู่ Azure ได้อย่างราบรื่น
การขยายการอ่านด้วยตัวเอง โดยปกติพื้นที่เก็บข้อมูลจะเน้นการอ่าน (read-skewed) มากกว่าการเขียนถึง 100-1,000 เท่า แต่สถาปัตยกรรมเดิมที่รวมการอ่านและเขียนไว้ใน replica เดียวกันทำให้เกิดการแย่งทรัพยากร การแยกส่วนจัดเก็บออกจากประมวลผลโดยใช้ Azure Blob Storage ช่วยให้เราสามารถขยายส่วนประมวลผลแยกกันได้อย่างอิสระ
เราได้เพิ่ม virtual replica ซึ่งเป็นโหนดชั่วคราว (ephemeral node) ทำหน้าที่เป็นสะพานเชื่อมไปยัง object storage เพื่อสตรีมการเขียนข้อมูลให้มีความทนทาน (durability) ก่อนยืนยันการเขียน แม้จะเพิ่มความหน่วงเล็กน้อย แต่การจัดลำดับแบบ per-reference ก็ช่วยป้องกันไม่ให้เกิดคอขวด
เมื่อมี virtual write replica แล้ว เราสามารถขยาย virtual read replica ออกไปได้มากเท่าที่ต้องการตามความต้องการ (on demand) โดยแต่ละตัวจะวอร์ม cache จาก Azure Blob Storage และปรับสถานะให้ตรงกันในพื้นหลัง ซึ่งช่วยปลดล็อกขีดจำกัดในการรองรับโหลดการอ่านมหาศาลได้สำเร็จ
สิ่งที่จะเกิดขึ้นต่อไป
แม้ Spokes จะเป็นหัวใจสำคัญของ GitHub ที่จัดการธุรกรรมข้อมูลกว่า 1 แสนล้านรายการต่อวัน แต่โปรโตคอลการ commit เดิมอาจไม่เพียงพอสำหรับเป้าหมายถัดไป เรากำลังวางแผนเพิ่มปริมาณงานเขียนให้มากขึ้น โดยใช้ประโยชน์จากคุณสมบัติ immutable ของออบเจ็กต์ Git เพื่อลดความจำเป็นในการรอการตอบรับจากทุกฝ่าย
ท่ามกลางทราฟฟิกจาก AI Agent ที่เพิ่มขึ้นอย่างต่อเนื่อง ทุกขั้นตอนที่เราปรับปรุงจะช่วยเพิ่มพื้นที่ว่าง (headroom) ให้กับระบบจัดเก็บข้อมูลได้ทันทีโดยไม่ต้องรอให้สถาปัตยกรรมทั้งหมดเสร็จสมบูรณ์
พบกันสัปดาห์หน้า: ในงาน GitHub Universe เราจะสำรวจสถานะสุดท้ายของสถาปัตยกรรมนี้ รวมถึงการจัดการปริมาณงานเขียนและปัญหาต่อเนื่องที่เราต้องพิชิตให้ได้
ขอขอบคุณ Brian Celenza สำหรับการมีส่วนร่วมในโพสต์นี้
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร