
รู้จัก Pathways: ระบบฝึก AI ขนาดใหญ่แบบ Single-controller จาก Google
9 พ.ย. 2026
Google ประกาศเปิดใช้งานทั่วไป (General Availability) ของ Pathways บน Google Cloud Platform ระบบประมวลผลแบบกระจายตัวที่อยู่เบื้องหลังการฝึกโมเดลทรงพลังอย่าง Gemini
ในบทความนี้ เราจะเจาะลึกวิธีที่ Pathways จัดการความท้าทายด้านการประสานงาน โดยนำเสนอไคลเอนต์เดียวที่อธิบายการคำนวณทั้งหมดเป็นกราฟ พร้อมรันไทม์อัจฉริยะที่ช่วยจัดวางตำแหน่ง ย้าย tensors และบริหารจัดการตัวเร่งความเร็วให้ทำงานได้อย่างเต็มประสิทธิภาพตลอดเวลา
ข้อจำกัดของโมเดล SPMD ในปัจจุบัน
การฝึกโมเดลขนาดใหญ่ส่วนใหญ่มักใช้รูปแบบ Single Program, Multiple Data (SPMD) ซึ่งตัวเร่งความเร็วทุกตัวจะรันโปรแกรมเดียวกันพร้อมกันและประสานงานผ่าน collective เช่น AllReduce แม้วิธีนี้จะใช้งานได้ดีกับโปรแกรมที่เหมือนกันทุกอุปกรณ์ แต่จะเริ่มมีปัญหาเมื่อจ็อบมีความซับซ้อน เช่น ลูป RL ที่ประกอบด้วยโปรแกรม sampler, reward model และ trainer ที่แตกต่างกันและต้องทำงานซ้อนทับกัน
นอกจากนี้ ระบบ SPMD ยังมีจุดอ่อนเรื่องความทนทานต่อฮาร์ดแวร์ที่ล้มเหลว ซึ่งเคยขัดจังหวะ การฝึกฝน Gemini 2.5 หลายครั้งต่อชั่วโมง หากเครื่องใดเครื่องหนึ่งหายไป ระบบจะหยุดทำงานทั้งหมดและต้องย้อนกลับไปเริ่มใหม่ที่ checkpoint ล่าสุดทันที
หากคุณฝึกโมเดล PyTorch คุณอาจคุ้นเคยกับ Distributed Data Parallel (DDP) หรือ Fully Sharded Data Parallel (FSDP) ซึ่งใช้โมเดล SPMD เช่นกัน โดยอาศัย interconnect ที่รวดเร็วภายในกลุ่มตัวเร่งความเร็ว
ทว่าเมื่อต้องขยายจ็อบข้ามกลุ่ม ข้อมูลต้องผ่านเครือข่ายศูนย์ข้อมูลที่ช้ากว่าเดิมมาก เช่นใน TPU v5p แบนด์วิดท์ระหว่างชิปสูงถึง 1,200 GB/s แต่เครือข่ายศูนย์ข้อมูลกลับเหลือเพียง 50 Gb/s ซึ่งช้ากว่ากันถึงสองอันดับหลัก ส่งผลให้ประสิทธิภาพการประมวลผลลดลงเมื่อเพิ่มจำนวนอุปกรณ์
ก้าวข้ามขีดจำกัดด้วย Pipeline Parallelism
เมื่อใช้ pipeline parallelism ในการแบ่งโมเดลข้ามอุปกรณ์ อุปกรณ์แต่ละตัวจะต้องรันโค้ดที่ต่างกันและรอคอยกันเอง ทำให้เกิด "pipeline bubble" หรือช่วงเวลาที่ตัวเร่งความเร็วว่างงานแต่คุณยังต้องจ่ายค่าเช่า
ในสถานการณ์ที่จ็อบประกอบด้วยหลายโปรแกรมทำงานร่วมกัน เช่น ลูป RL การประสานงาน dependencies ระหว่างเครื่องกลายเป็นเรื่องยากลำบาก เพราะ worker แต่ละตัวมองเห็นเพียงข้อมูลในเครื่องตนเอง ไม่มีจุดใดที่เห็นภาพรวมทั้งหมด ทำให้ไม่สามารถใช้ทรัพยากรได้อย่างยืดหยุ่นหรือกู้คืนระบบเมื่อเกิดความเสียหายได้โดยไม่หยุดชะงัก
Pathways: ทางออกสำหรับการประสานงานยุคใหม่
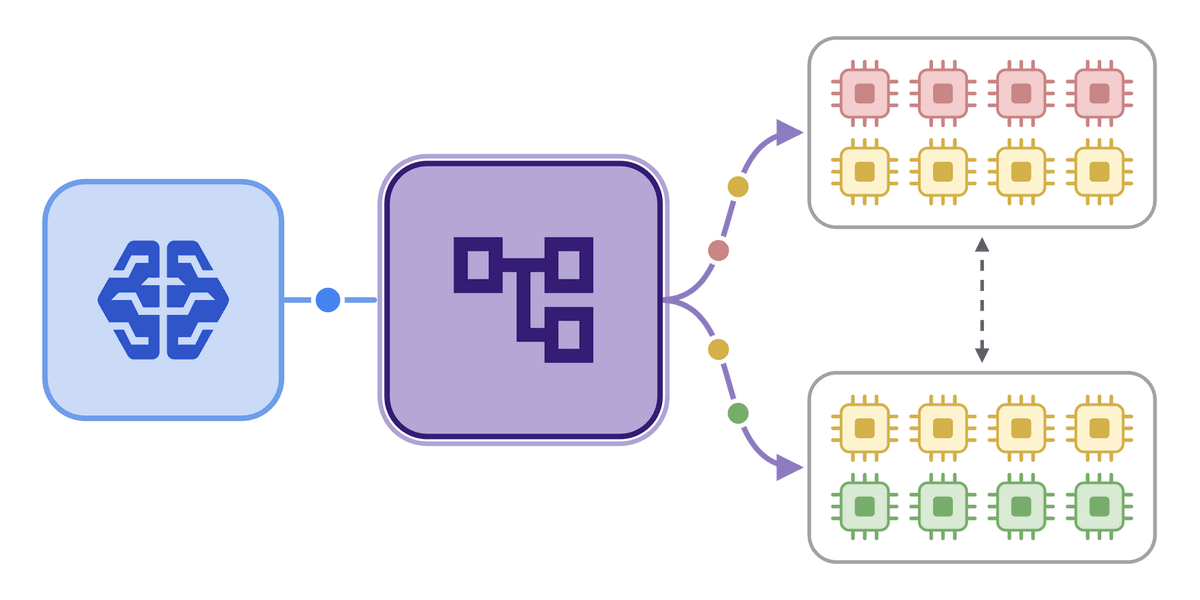
Pathways ถูกออกแบบมาเพื่อแก้ปัญหาเหล่านี้ โดยเปลี่ยนจากการประสานงานทีละเครื่อง มาเป็นการใช้ไคลเอนต์เดียวประกาศกราฟการคำนวณทั้งหมด ซึ่งขณะนี้ เปิดใช้งานแล้วบน Google Cloud โดยทำงานร่วมกับ JAX บน TPUs
ระบบนี้แยกไคลเอนต์ออกจากฮาร์ดแวร์จริง โดยให้เขียนโปรแกรมอ้างอิงกับ "อุปกรณ์เสมือน" (virtual devices) แล้วให้ตัวจัดการทรัพยากรจับคู่เข้ากับชิปจริง วิธีนี้ช่วยให้ระบบมีความยืดหยุ่นสูง เช่น เมื่อโฮสต์หนึ่งล้มเหลว ระบบจะจับคู่งานใหม่ไปยังชิปที่เหลืออยู่และทำงานต่อได้ทันทีโดยไม่ต้องเริ่มใหม่ ซึ่งเป็นพื้นฐานของ elastic training
การมีตัวจัดการทรัพยากรส่วนกลางยังหมายความว่าคลัสเตอร์ Pathways สามารถแบ่งปันกันในทีมได้ผ่าน Shared Pathways Service ช่วยให้นักวิจัยสามารถขอใช้งานชิป TPU เฉพาะส่วนที่ต้องการและคืนเข้าระบบเมื่อใช้งานเสร็จ
การทำงานแบบ Dataflow และประสิทธิภาพที่เหนือกว่า
Pathways มองการคำนวณเป็นกราฟข้อมูลไหล (distributed dataflow graph) รันไทม์จะทำหน้าที่ย้ายและ reshard tensor ให้โดยอัตโนมัติผ่านเครือข่ายที่รวดเร็ว เพื่อป้องกันไม่ให้ไคลเอนต์กลายเป็นคอขวด Pathways จะใช้การสั่งการแบบอะซิงโครนัสขนาน (parallel asynchronous dispatch) เตรียมบัฟเฟอร์และตารางโอนย้ายข้อมูลล่วงหน้าก่อนที่การคำนวณก่อนหน้าจะเสร็จสิ้น
นอกจากนี้ ยังมีตัวจัดตารางงานส่วนกลาง (central scheduler) ที่คอยเรียงลำดับการทำงานของทุกโปรแกรมให้สอดคล้องกัน ป้องกันปัญหา deadlock ที่อาจเกิดขึ้นเมื่ออุปกรณ์ต่างกลุ่มพยายามสื่อสารกันโดยไม่มีการจัดระเบียบ
ด้วยลักษณะการเป็นไคลเอนต์เดียว นักพัฒนาสามารถดีบั็กโมเดลขนาดใหญ่ได้เหมือนรันบนเครื่องเดียว สามารถ เข้าสู่ shell ตั้ง breakpoint และตรวจสอบสถานะของทุกอุปกรณ์ได้จากจุดเดียว
Pathways แตกต่างจาก Ray อย่างไร?
แม้ Pathways จะดูคล้ายกับ orchestrator อย่าง Ray แต่ทั้งสองทำงานในระดับที่ต่างกัน โดย Ray เน้นการประสานงานเวิร์กโหลด AI ในระดับ tasks and actors ทั่วทั้งคลัสเตอร์ แต่ไม่ได้เปลี่ยนวิธีที่การฝึกฝนรันบนชิป (ซึ่งยังเป็น SPMD)
ในขณะที่ Pathways เน้นไปที่ระดับการประมวลผล (execution) เปลี่ยนโมเดลเบื้องล่างให้เป็นระบบเดียวที่ขับเคลื่อนทั้งคลัสเตอร์ ทั้งสองเทคโนโลยีจึงสามารถทำงานร่วมกันได้อย่างลงตัว โดยใช้ Ray ในการจัดการภาพรวม และใช้ Pathways ในการขับเคลื่อนแต่ละขั้นตอนการฝึกฝนให้มีประสิทธิภาพสูงสุด
สรุปได้ว่า Pathways ช่วยแยกการสร้างโมเดลออกจากการจัดการฮาร์ดแวร์ ช่วยให้คุณโฟกัสกับการออกแบบโครงสร้างการคำนวณ โดยปล่อยให้รันไทม์ทำหน้าที่ที่ซับซ้อนในการจัดการทรัพยากรและการส่งข้อมูลข้ามคลัสเตอร์แทน
ผู้ที่สนใจสามารถศึกษาข้อมูลเพิ่มเติมได้ที่:
- Pathways on Google Cloud - เอกสารประกอบ
- Pathways: Asynchronous Distributed Dataflow for ML - งานวิจัย
- Resilient training with Pathways - เอกสารประกอบ
- Pathways utils - GitHub repository
- MaxText - GitHub repository
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร