
Yandex เปิดตัว Sona โมเดล AI เดี่ยวที่มาแทนระบบแนะนำแบบเดิมทั้งหมด
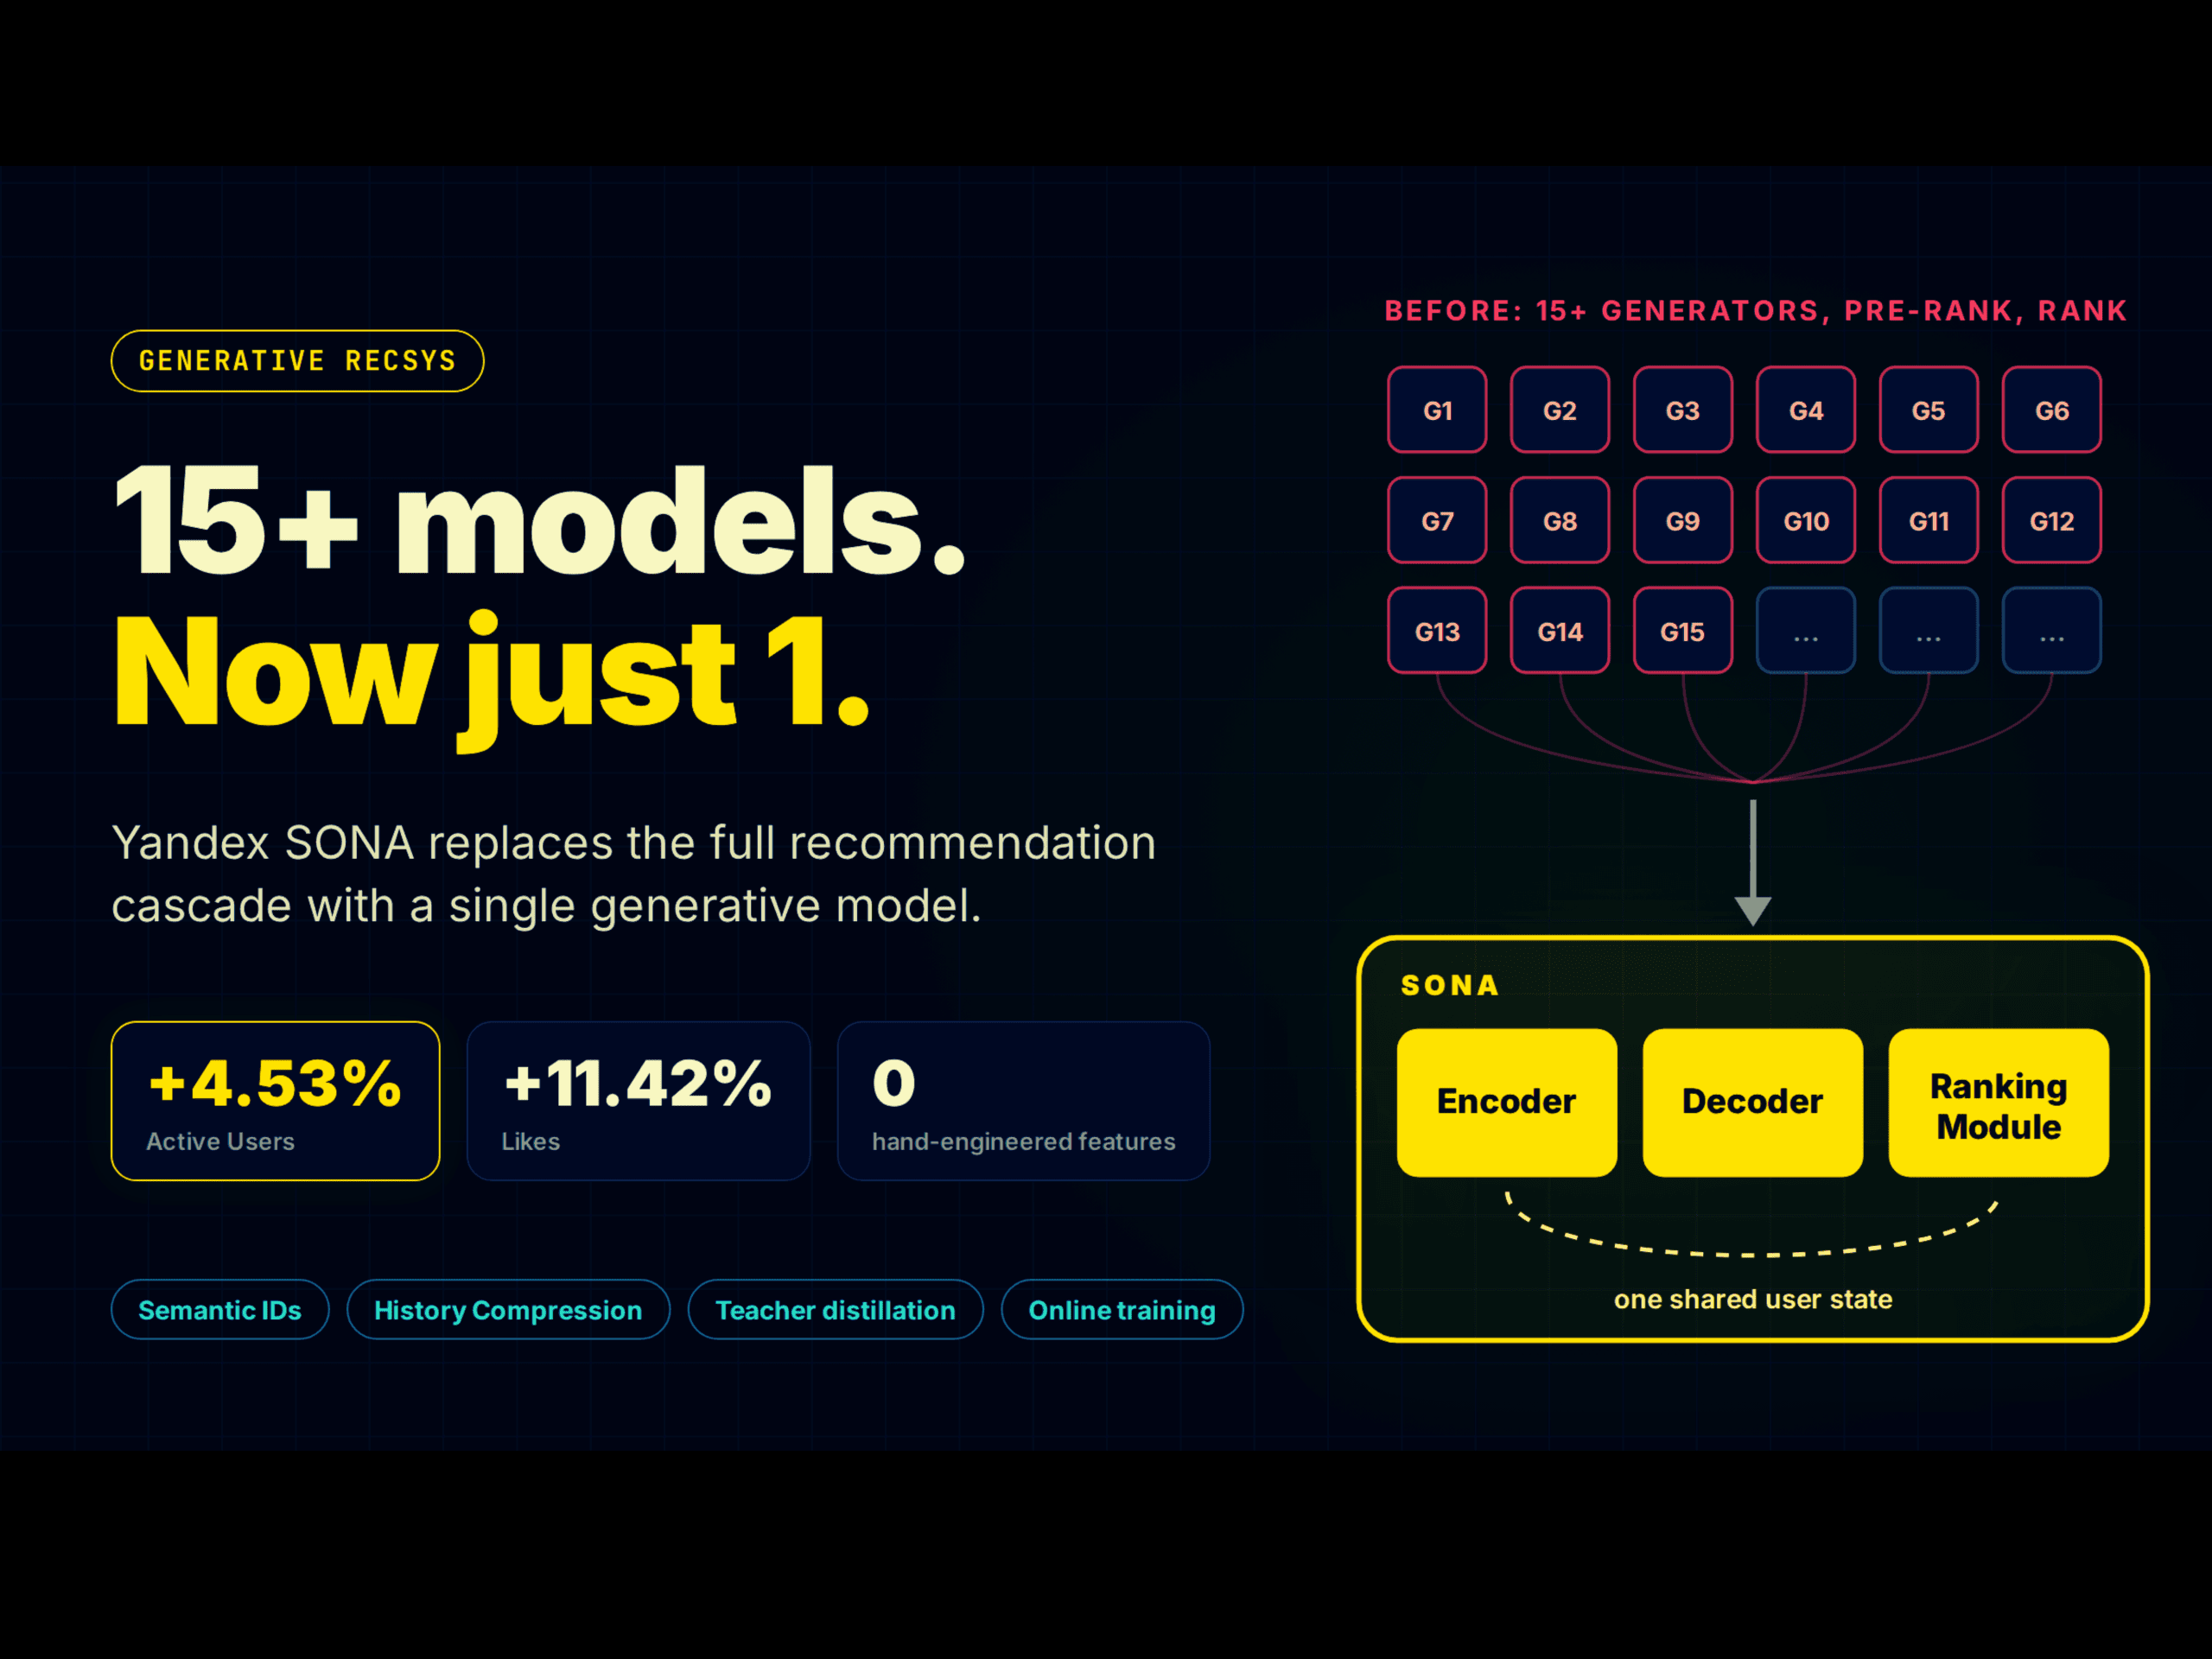
ระบบแนะนำส่วนใหญ่ที่ใช้งานจริงมักอยู่ในรูปแบบ Cascade โดยเริ่มจากตัวสร้างผู้สมัคร (candidate generators) ส่งข้อมูลไปยังตัวจัดลำดับเบื้องต้น (pre-ranker) และส่งต่อให้ตัวจัดลำดับหลัก (heavy ranker) ที่สร้างจากฟีเจอร์ที่ออกแบบมานับร้อย รายงานทางเทคนิคของ Sona Technical Report จาก Yandex ได้เผยถึงการออกแบบที่ต่างออกไป
Sona คือโมเดล AI แบบ Generative ที่รวมการสร้างผู้สมัครและการจัดลำดับเข้าไว้ในระบบเดียว โดยเข้ามาแทนที่หลายขั้นตอนใน recommendation pipeline ของ Yandex จากการทดลองใช้งานจริง 7 วันบนลำโพงอัจฉริยะ พบว่ามันสามารถแทนที่ตัวสร้างผู้สมัครกว่า 15 ตัว รวมถึงขั้นตอนจัดลำดับทั้งหมดได้ด้วย Transformer เพียงตัวเดียว
Sona แก้ปัญหาอะไร?
ระบบแบบ Cascade มักแบ่งการตัดสินใจไปยังโมเดลที่ฝึกแยกกัน ทำให้แต่ละขั้นตอนปรับปรุงแค่เป้าหมายของตัวเอง และตัวจัดลำดับจะเห็นเฉพาะสิ่งที่ขั้นตอนต้นน้ำคัดกรองมาเท่านั้น ซึ่งระบบเดิมของ Yandex Music ต้องใช้ฟีเจอร์นับร้อยและสัญญาณจาก Argus ซึ่งเป็นโมเดลรุ่นก่อนหน้า
Sona ปรับแนวทางใหม่โดยวางการสร้างผู้สมัครและการจัดลำดับไว้รอบตัวแทนผู้ใช้ (user representation) เพียงตัวเดียว โดยตัวเข้ารหัส (encoder) จะอ่านประวัติผู้ฟังหนึ่งครั้งต่อคำขอ ตัวถอดรหัส (decoder) จะสร้างรายการผู้สมัคร และโมดูลการจัดลำดับ (Ranking Module) จะให้คะแนนผู้สมัครเหล่านั้นทันที
ความโดดเด่นคือระบบนี้ไม่ใช้ฟีเจอร์ที่สร้างด้วยมือ (hand-engineered features) เลย แต่อาศัยข้อมูลเหตุการณ์ที่บันทึกไว้ เช่น track ID, artist ID, ระยะเวลาการฟัง และ Semantic ID ที่เรียนรู้มาเอง ซึ่งทีมวิจัยระบุว่าเหมาะอย่างยิ่งสำหรับสภาพแวดล้อมแบบ pure-recommendation บนลำโพงอัจฉริยะที่เล่นเพลงได้โดยผู้ใช้ไม่ต้องเลือกแนวเพลงก่อน
สถาปัตยกรรมของ Sona ทำงานอย่างไร
1. Semantic tokenizer
อ้างอิงตาม สูตร Semantic ID ของ Rajput และคณะ ทุกแทร็กจะถูกแปลงเป็นรหัสที่ไม่ต่อเนื่องกัน 3 ชุด โดยใช้ LLM แบบ multimodal ที่ถูกแช่แข็ง (frozen) อ่าน mel-spectrogram 90 วินาทีแรกพร้อมข้อมูลเพลง จากนั้นใช้ transformer ขนาด 4 เลเยอร์ ปรับแต่งฟีเจอร์ให้ตรงกับพฤติกรรมการฟังและทำ quantization เป็น codebook 3 ชุด ชุดละ 32,000 รายการ ซึ่งให้ผลลัพธ์ Recall@1000 ดีกว่าเกณฑ์มาตรฐานเดิม
2. Encoder พร้อมการบีบอัดประวัติ
Sona สามารถประมวลผลเหตุการณ์ในอดีตได้ถึง 8,192 รายการ แต่เพื่อลดต้นทุนการประมวลผล (inference cost) จึงใช้ความลึกของเลเยอร์ไม่เท่ากัน โดยเหตุการณ์ล่าสุด 2,048 รายการจะใช้ self-attention 7 เลเยอร์ ส่วนเหตุการณ์เก่ากว่าจะผ่าน cross-attention และเลเยอร์ประวัติเพียง 1 เลเยอร์ ช่วยให้คงคุณภาพไว้ได้ในขณะที่ประหยัดทรัพยากรไปครึ่งหนึ่ง
3. Decoder และ Ranking Module
ตัวถอดรหัส 2 เลเยอร์จะส่ง Semantic ID ออกมาผ่านการค้นหาแบบ constrained beam search โดยมีระบบตรวจสอบไม่ให้เกิดรหัสที่ผิดพลาด จากนั้น Ranking Module ที่มี cross-attention 4 เลเยอร์ จะให้คะแนนแทร็กเหล่านั้นเทียบกับหน่วยความจำของตัวเข้ารหัสที่ใช้ร่วมกัน
การฝึกฝน: ครูที่ไม่เคยถูกส่งออกไปใช้งาน
Ranking Module เรียนรู้ผ่านเทคนิค Rollout Distillation จาก Teacher Ranker ซึ่งเป็นโมเดล Transformer ขนาด 0.6 พันล้านพารามิเตอร์ที่ถูกฝึกด้วยข้อมูลการใช้งานย้อนหลัง 1 ปี ในช่วงการฝึก ตัวถอดรหัสจะสร้างรายการผู้สมัครและให้ "ครู" เป็นผู้ให้คะแนนเพื่อใช้ปรับปรุงตัวโมดูลจัดลำดับ แต่เมื่อถึงเวลาใช้งานจริง (serving time) ตัวโมเดลครูจะถูกนำออกไป
การฝึกฝนระบบยังคงเป็นแบบออนไลน์ โดยจะรวมกลุ่มข้อมูลเป็นเซสชันทุก 15 นาที และอัปเดตน้ำหนักใหม่ไปยังส่วนใช้งานจริงทุก 10 นาที ระบบรันบน NVIDIA Triton Inference Server พร้อม CUDA graphs ซึ่งช่วยให้การใช้ FLOPs ของโมเดลมีประสิทธิภาพสูงถึง 41%
ผลลัพธ์: การทดสอบ A/B ออนไลน์บนทราฟฟิกจริง
จากการทดสอบกับผู้ใช้ 15% เป็นเวลา 7 วัน พบว่าทุกตัวชี้วัดมีนัยสำคัญทางสถิติเมื่อเทียบกับระบบเดิม:
- ผู้ใช้ที่ใช้งานอยู่ (Active Users): +4.53%
- เวลาการฟังรวม: +6.30%
- ยอดไลก์: +11.42%
- คำสั่ง "เล่นซ้ำ": +17.99%
- ผู้ใช้ที่มีส่วนร่วมสูง: +7.37%
ตัวเลขเหล่านี้แสดงให้เห็นว่า Sona ให้ประสิทธิภาพดีกว่าโมเดล Argus รุ่นก่อนหน้าถึง 2.35 เท่าในแง่ของการเพิ่มจำนวนผู้ใช้ที่ใช้งานอยู่
Sona vs OneRec vs HSTU: การเปรียบเทียบฟีเจอร์
แม้จะมีโมเดลอย่าง OneRec ของ Kuaishou หรือ HSTU ของ Meta ที่ใช้สถาปัตยกรรมคล้ายกัน แต่จุดเด่นของ Sona คือการเข้ามาแทนที่ระบบ cascade ทั้งหมดโดยไม่พึ่งพาฟีเจอร์ที่มนุษย์สร้างขึ้นเลย
| ฟีเจอร์ | Sona (Yandex) | OneRec (Kuaishou) | HSTU GR (Meta) |
|---|---|---|---|
| โมเดลเดี่ยวแทนที่ cascade | ใช่ ใน A/B test | ใช่ ประมาณ 25% ของ QPS | ไม่ (ระบุเป็นสถาปัตยกรรมใหม่) |
| อินพุตของผู้ใช้ | ข้อมูลเหตุการณ์เท่านั้น | มีการวิศวกรรมฟีเจอร์ (อายุ, เพศ) | ลำดับการกระทำของผู้ใช้ |
| เอาต์พุตรายการ | Semantic IDs 3 ระดับ | Semantic IDs 3 ระดับ | Item IDs |
| ขนาดที่รายงาน | ครู 0.6B พารามิเตอร์ | FLOPs สูงกว่าเดิม 10 เท่า | 1.5 ล้านล้านพารามิเตอร์ |
| ผลกำไรออนไลน์ | +4.53% Active Users | +1.24% Time spent | +12.4% ใน A/B test |
หมายเหตุ: ผลกำไรออนไลน์มาจากแพลตฟอร์มและตัวชี้วัดที่ต่างกัน จึงไม่สามารถเปรียบเทียบกันได้โดยตรง
ประเด็นสำคัญ
- Sona รวมการทำงานของตัวสร้างผู้สมัครกว่า 15 ตัวและขั้นตอนจัดลำดับไว้ในโมเดลเดียว
- ใช้เพียงข้อมูลเหตุการณ์ที่บันทึกไว้และ Semantic ID ไม่ต้องออกแบบฟีเจอร์เอง
- ใช้การกลั่นกรองความรู้ (Distillation) จากโมเดลครูขนาด 0.6B ในช่วงการฝึก
- ให้ผลลัพธ์ใน A/B test ดีกว่าเทคโนโลยีเดิมอย่างเห็นได้ชัด แต่ปัจจุบันยังไม่มีการปล่อยโค้ดหรือน้ำหนักโมเดลสู่สาธารณะ
FAQ
Yandex Sona คืออะไร? โมเดล Generative Recommender ที่รวมทุกขั้นตอนของระบบแนะนำไว้ในสถาปัตยกรรม Transformer เดียว
Sona แตกต่างจาก OneRec อย่างไร? Sona มุ่งเน้นการไม่ใช้ฟีเจอร์ที่มนุษย์สร้างขึ้นและแทนที่ระบบ cascade ทั้งหมด ในขณะที่ OneRec ยังมีการใช้วิศวกรรมฟีเจอร์บางส่วน
ดูรายละเอียดทั้งหมดได้ที่ Paper
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร