
IBM Research เปิดตัวเครื่องมือแก้ปัญหา AI Agent ทำงานไม่สม่ำเสมอ
[Evelyn Duesterwald
evduester
Follow](/evduester)
[Lilian Ngweta
lilianngweta
Follow](/lilianngweta)
[Vatche Isahagian
Vatche
Follow](/Vatche)
[Jayaram Radhakrishnan
jayaramkr
Follow](/jayaramkr)
[Vinod Muthusamy
vinodmut
Follow](/vinodmut)
[Gaodan Fang
gaodan-fang
Follow](/gaodan-fang)
[Ashwath Vaithinathan Aravindan
ashwath-vaithina
Follow](/ashwath-vaithina)
[Punleuk Oum
illeatmyhat
Follow](/illeatmyhat)
[G Thomas
gsthomasx
Follow](/gsthomasx)
[Merve Unuvar
mrvnvr
Follow](/mrvnvr)
[Ayhan Sebin
ayhansebin
Follow](/ayhansebin)
[Michał Ulewicz
Michal
Follow](/Michal)
ปัญหาที่น่าหนักใจของนักพัฒนา AI คือการที่เอเจนต์ทำงานได้ดีในช่วงทดสอบ แต่เมื่อสาธิตสด (Live Demo) กลับเลือกเส้นทางที่ต่างออกไปจนล้มเหลวในภารกิจเดิม ซึ่งในสภาวะการใช้งานจริง (Production) นี่คือปัญหาด้านความน่าเชื่อถือที่ยอมรับไม่ได้
สำหรับงานสำคัญระดับวิกฤต (Mission-critical) เช่น การตรวจสอบรายการเดินบัญชีหรือตรวจสัญญา ข้อผิดพลาดที่เกิดขึ้นแบบสุ่มแม้จะใช้คำสั่งเดิม กลายเป็นอุปสรรคใหญ่ที่ขัดขวางการนำ AI ไปใช้งานจริง
เกณฑ์มาตรฐาน (Benchmarks) ส่วนใหญ่มักซ่อนความผันแปรนี้ไว้ภายใต้ค่าเฉลี่ย ยกตัวอย่างใน AppWorld เอเจนต์แบบ ReAct ที่ใช้ GPT-4.1 ประสบความสำเร็จเฉลี่ย 77.4% แต่กลับทำภารกิจเดิมสำเร็จครบทุกครั้งเพียง 53.0% เท่านั้น เกิดเป็น "ช่องว่างความสม่ำเสมอ" (Consistency Gap) ถึง 24.4 จุด
ทีมวิจัยจึงได้พัฒนา ALTK-Evolve ระบบที่เปลี่ยนเส้นทางการทำงานในอดีตให้กลายเป็นแนวทางที่นำกลับมาใช้ใหม่ได้ โดยล่าสุดได้เพิ่ม Consistency Guidelines ซึ่งทำงานร่วมกับเครื่องมือวินิจฉัย Consistency Analyzer เพื่อปิดช่องว่างความไม่แน่นอนนี้โดยตรง
สรุปประเด็นสำคัญ (TL;DR)
- ความแม่นยำบดบังความไม่น่าเชื่อถือ: เอเจนต์ที่สำเร็จเฉลี่ย 77.4% อาจสำเร็จครบ 5 ครั้งในภารกิจเดิมเพียง 53.0% โดยในภารกิจที่ยาก ช่องว่างความไม่สม่ำเสมออาจพุ่งสูงถึง 30 จุด
- เครื่องมือวินิจฉัยเฉพาะทาง: Consistency Analyzer จะสุ่มซ้ำ (Resample) จุดตัดสินใจที่เสี่ยงต่อการเปลี่ยนทิศทาง (Flip-prone) เพื่อหาจุดที่โมเดลอาจเลือกทำต่างไปเพียงเพราะการสุ่ม Token โดยใช้ร่องรอยการทำงาน (Trace) เพียงชุดเดียว
- ลดช่องว่างความสม่ำเสมอลงครึ่งหนึ่ง: วิธีนี้ช่วยลดช่องว่างจาก 24.4 จุด เหลือเพียง 12.0 จุด โดยไม่เสียค่าความแม่นยำเฉลี่ย
- รายละเอียดเพิ่มเติม: สามารถอ่านระเบียบวิธีวิจัยฉบับเต็มได้ที่ รายงานทางเทคนิคบน arXiv
ตัวชี้วัดที่มักถูกมองข้าม
การประเมินเอเจนต์ทั่วไปมักใช้ Mean@k ซึ่งเป็นการรันเกณฑ์มาตรฐานหลายครั้งแล้วหาค่าเฉลี่ย แต่มันไม่ได้ตอบคำถามว่า "มันจะยังทำได้ดีเหมือนเดิมไหมถ้าถามคำถามเดิมซ้ำ?" ซึ่งคำตอบนั้นต้องดูที่ Pass^k หรือสัดส่วนภารกิจที่สำเร็จในทุกการรัน
⚠️ ข้อควรระวัง: Pass^k ต่างจาก Pass@k โดยที่ Pass@k จะมองโลกในแง่ดีว่าสำเร็จ "อย่างน้อยหนึ่งครั้ง" แต่ Pass^k คือการมองในแง่ร้ายว่า "ทุกครั้ง" ต้องสำเร็จ ซึ่งสะท้อนความเชื่อมั่นในการใช้งานจริงได้ดีกว่า
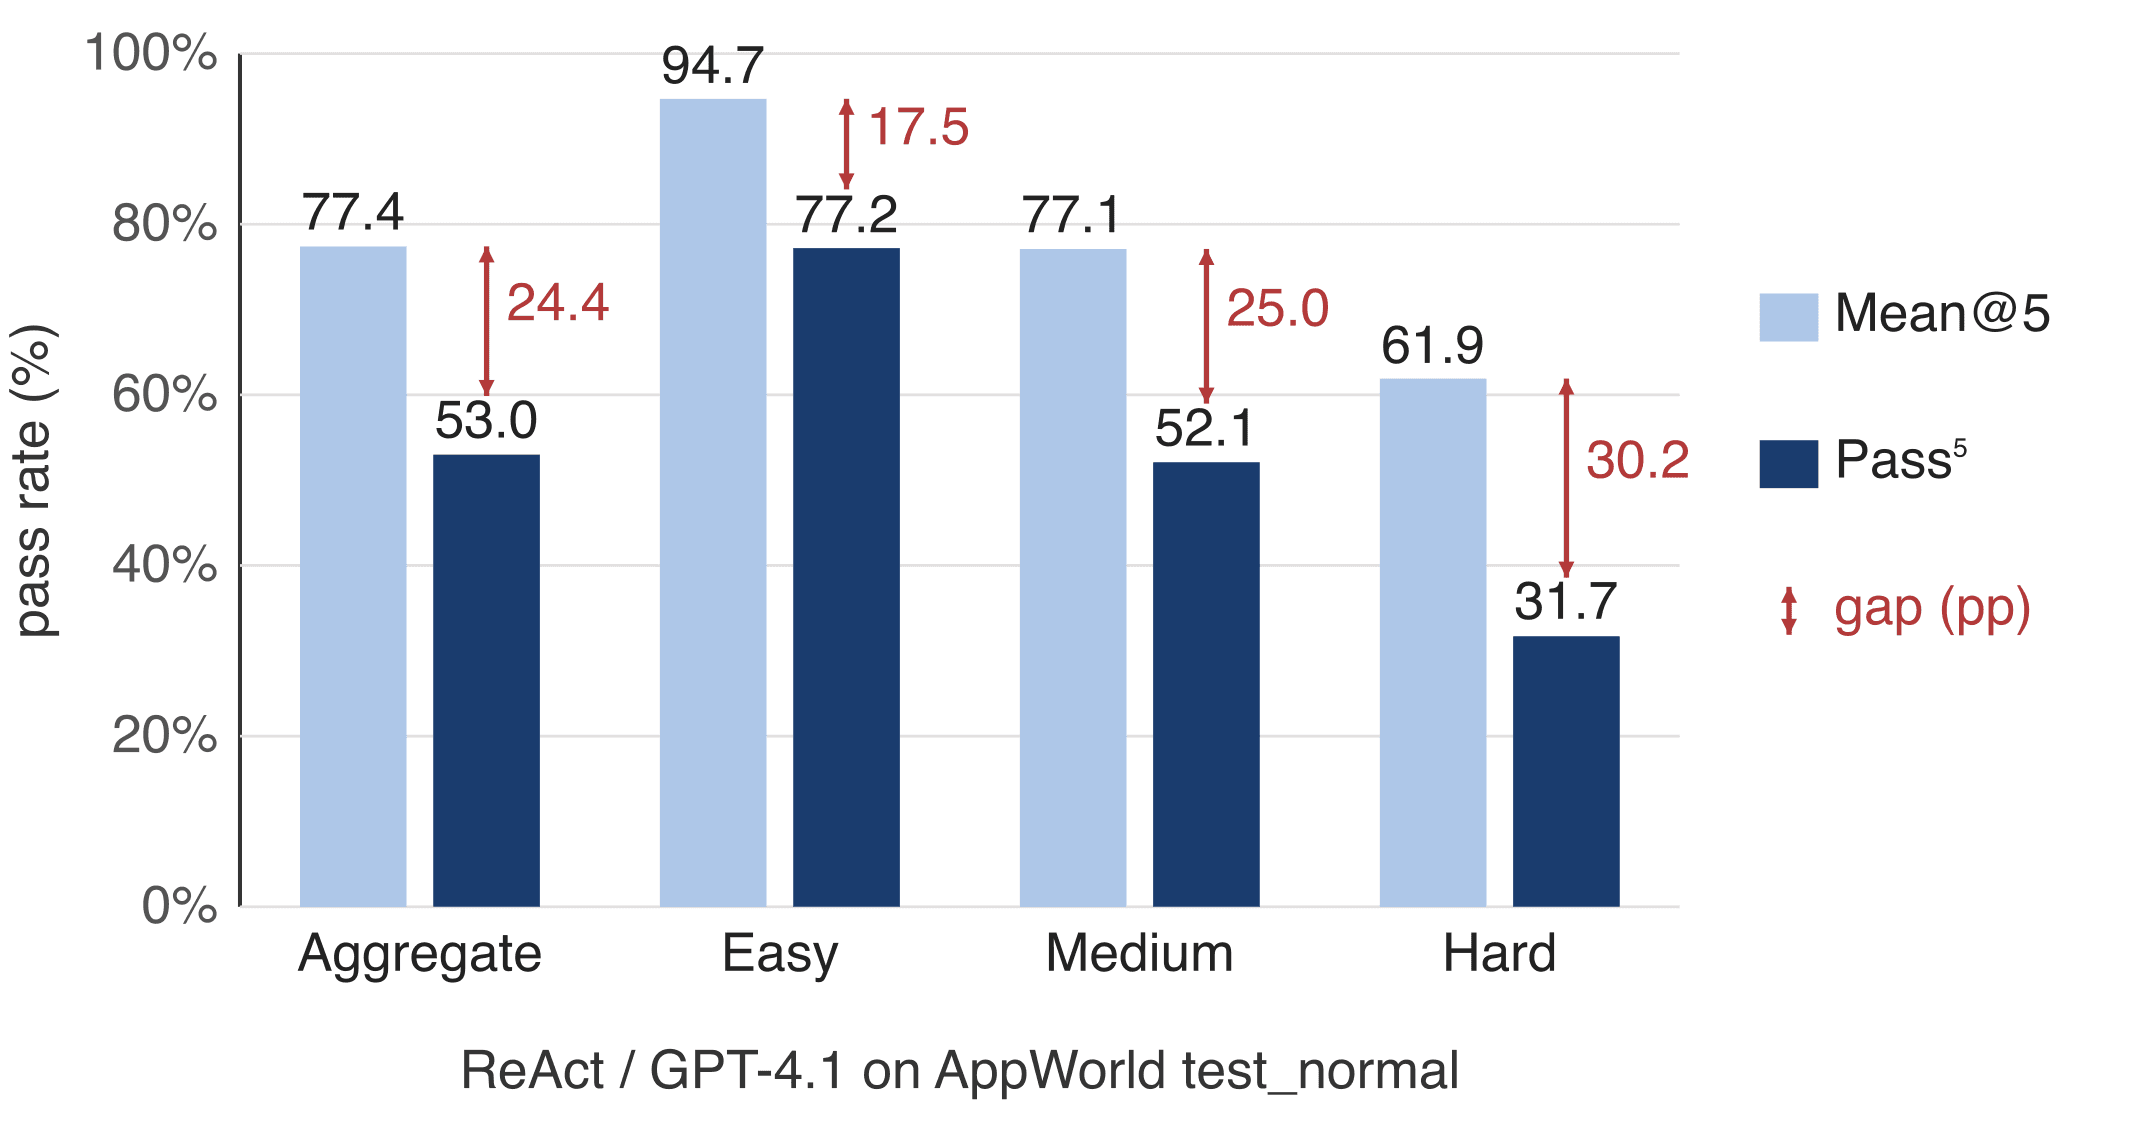
ช่องว่างความสม่ำเสมอ (Consistency Gap) นี้ไม่ใช่ปัญหาที่แก้ได้ง่ายๆ เพียงแค่เปลี่ยนไปใช้โมเดลที่ใหญ่ขึ้น เพราะเอเจนต์ที่มีความสามารถสูงก็อาจขาดความสม่ำเสมอได้ในเวลาเดียวกัน
ทำไมเอเจนต์ถึงเปลี่ยนทิศทาง?
การตัดสินใจของ LLM ขึ้นอยู่กับการกระจายความน่าจะเป็น (Probability Distribution) หากเป็นการตัดสินใจแบบ "เฉียบขาด" (Sharp) โมเดลจะเลือกตัวเลือกเดิมเสมอ แต่หากเป็นการตัดสินใจแบบ "คลุมเครือ" (Flat) ตัวเลือกที่สูสีกันอาจสลับอันดับได้ง่ายๆ จากสัญญาณรบกวนเพียงเล็กน้อย
แม้จะตั้งค่า Temperature เป็น 0.0 หรือล็อกค่า Seed แล้วก็ตาม ความผันแปรในการคำนวณบน GPU หรือการจัดการคำขอของแพลตฟอร์มก็อาจส่งผลให้ผลลัพธ์ต่างไปจากเดิมได้
วินิจฉัย แล้วจึงแก้ไข
Consistency Guidelines ทำงานผ่าน 2 ขั้นตอนสำคัญที่เชื่อมต่อกับกลไกของ ALTK-Evolve:
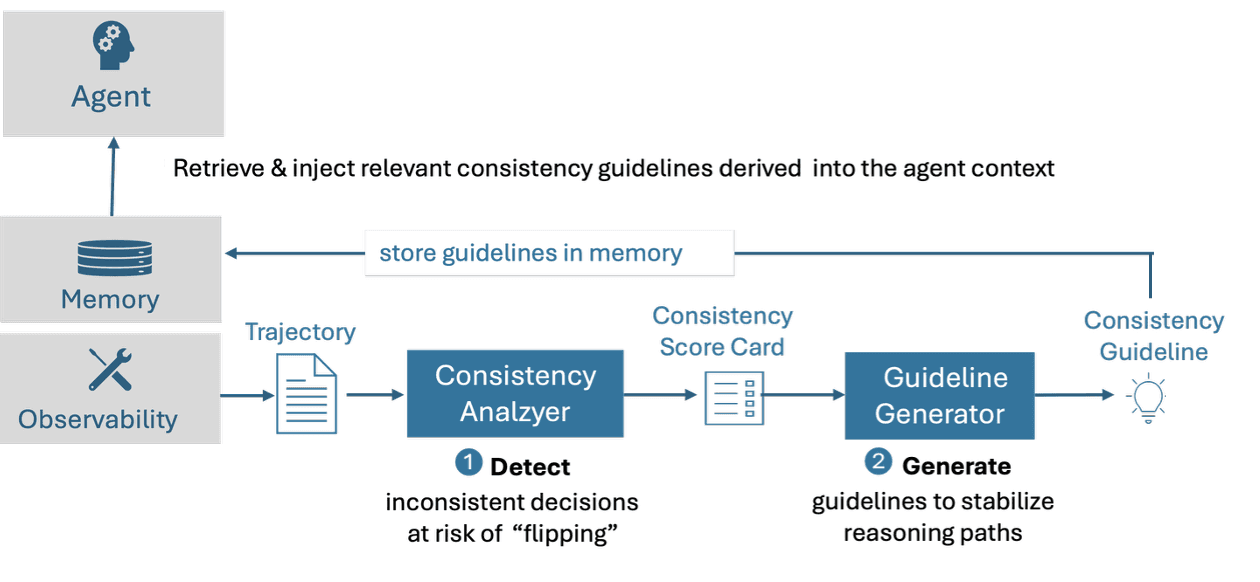
- ตรวจสอบด้วย Consistency Analyzer: ทำการจำลองขั้นตอนการตัดสินใจแต่ละขั้นออฟไลน์ เพื่อระบุจุดที่เสี่ยงต่อการเปลี่ยนทิศทางโดยไม่ต้องใช้ Logits หรือเข้าถึงภายในโมเดล
- สร้างแนวทางที่เจาะจงเป้าหมาย: จุดที่ผันแปรจะถูกสรุปเป็นแนวทางปฏิบัติ เช่น การระบุให้ใช้ Regex ในการนับแทนการนับ String ปกติ เพื่อลดความสับสนของเอเจนต์ในภารกิจที่คล้ายกัน
รับชมวิดีโอสาธิต 2 นาที - วิดีโอนี้แสดงให้เห็นว่าแนวทางดังกล่าวช่วยให้การรันเอเจนต์ 5 ครั้งที่เคยได้ผลต่างกัน กลับมาให้ผลลัพธ์ตรงกันทั้งหมดได้
ผลลัพธ์: เพิ่มความเชื่อมั่นโดยไม่ลดประสิทธิภาพ
จากการทดสอบบน AppWorld test_normal พบว่าช่องว่างความสม่ำเสมอถูกลดลงเหลือประมาณครึ่งหนึ่ง โดย Pass^5 เพิ่มขึ้นจาก 53.0% เป็น 69.0% ในขณะที่ค่าเฉลี่ย Mean@5 ยังคงเดิมหรือดีขึ้น
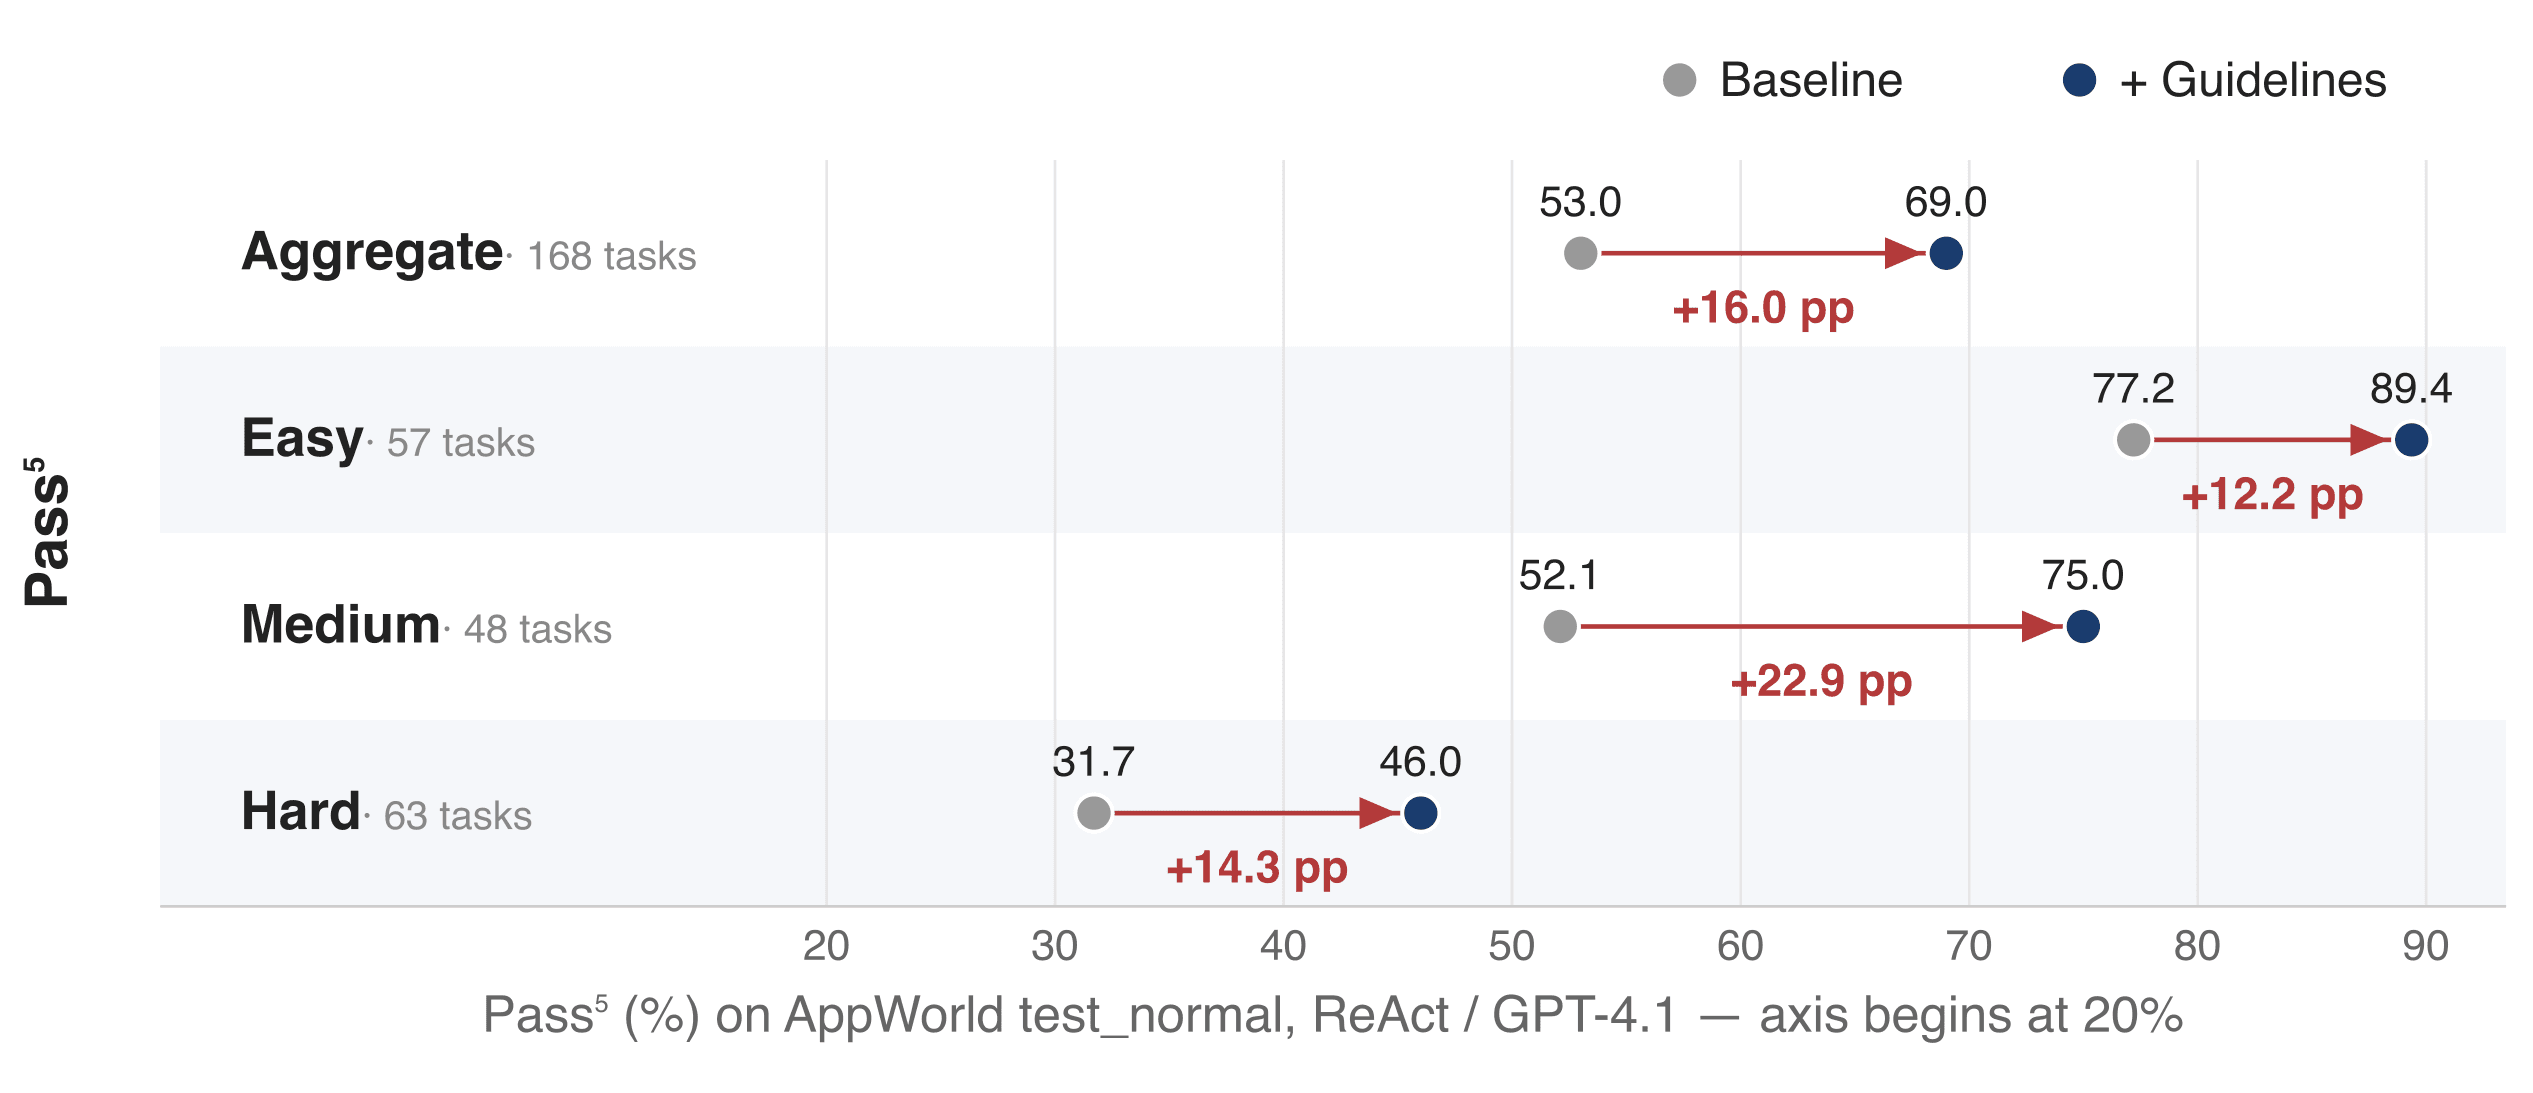
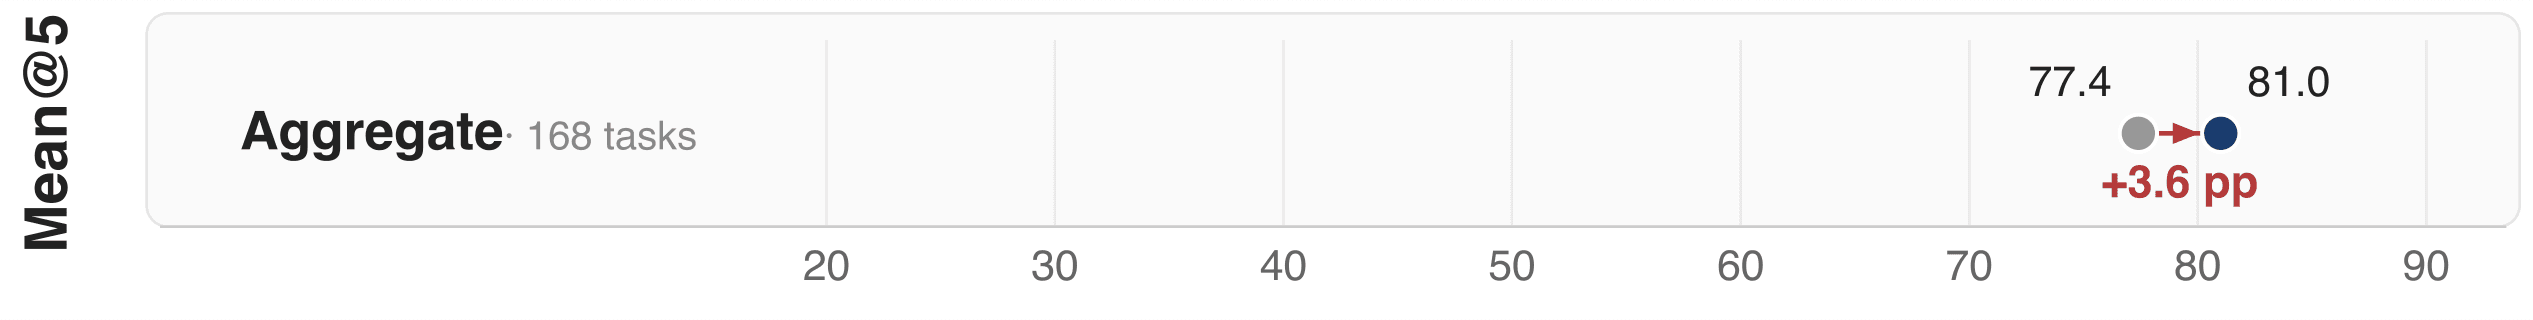
ภารกิจในระดับปานกลางและระดับยากได้รับประโยชน์สูงสุด โดยเพิ่มความสม่ำเสมอขึ้นกว่า 40% ซึ่งพิสูจน์ว่าแนวทางนี้สามารถใช้ได้ทั่วไปกับภารกิจที่เกี่ยวข้อง ไม่ใช่เพียงแค่การแก้ปัญหาเฉพาะจุดในเส้นทางเดียว
ข้อแนะนำสำหรับผู้ให้บริการเอเจนต์
- รายงาน Pass^k เสมอ: เพื่อแยกเอเจนต์ที่เชื่อถือได้ออกจากเอเจนต์ที่แค่โชคดี
- ความสม่ำเสมอไม่ใช่ความสามารถ: อย่าคาดหวังว่าโมเดลที่ใหญ่ขึ้นจะแก้ปัญหานี้ได้เสมอไป
- การวินิจฉัยทำได้ง่าย: ไม่จำเป็นต้องมีคำตอบที่ถูกต้อง (Ground Truth) ก็สามารถตรวจสอบความไม่แน่นอนได้ผ่านการสุ่มซ้ำในจุดตัดสินใจ
ผู้ที่สนใจสามารถทดลองใช้งานได้ที่ ALTK-Evolve toolkit ซึ่งเป็นโอเพนซอร์สที่รวมเครื่องมือเหล่านี้ไว้เรียบร้อยแล้ว หรือศึกษาจาก รายงานทางเทคนิคบน arXiv เพื่อดูรายละเอียดระเบียบวิธีวิจัย
ภาคผนวก: ตัวชี้วัดสำคัญ
- Mean@k: อัตราการผ่านเฉลี่ย (ความแม่นยำทั่วไป)
- Pass^k: อัตราความสำเร็จเมื่อต้องผ่านทุกครั้ง (ความเชื่อมั่น)
- Pass@k: อัตราความสำเร็จอย่างน้อยหนึ่งครั้ง (การมองในแง่ดี)
- Consistency Gap: ส่วนต่างระหว่าง Mean@k และ Pass^k
ข้อมูลอ้างอิง
- ALTK-Evolve Repo: github.com/AgentToolkit/altk-evolve
- Technical Report: arXiv
- Demo Video: วิดีโอสาธิต
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร