
เจาะลึก 3 ตัวอย่างจำลองด้วยภาพ พิสูจน์ความมหัศจรรย์ของ Central Limit Theorem
ทฤษฎีบทขีดจำกัดล่างส่วนกลาง (Central Limit Theorem - CLT) บอกเราว่าเส้นโค้งรูประฆังคว่ำที่ดูเหมือนความบังเอิญอันมหัศจรรย์ของการแจกแจงแบบปกติ (Normal Distribution) นั้นเกิดขึ้นบ่อยมากในโลกแห่งความเป็นจริง โดยมักจะไม่ขึ้นอยู่กับรูปแบบดั้งเดิมของข้อมูล แต่คุณเคยสงสัยหรือไม่ว่าทำไมปรากฏการณ์นี้จึงเกิดขึ้น?
หัวใจสำคัญของ CLT คือกฎทางสถิติพื้นฐานที่ระบุว่า หากคุณสุ่มตัวอย่างจากข้อมูลชุดใดก็ตามในปริมาณที่มากพอ แล้วนำค่าเหล่านั้นมาคำนวณหาค่าเฉลี่ย ผลลัพธ์ที่ได้จะค่อยๆ เข้าใกล้การแจกแจงแบบปกติเสมอ ไม่ว่าข้อมูลตั้งต้นจะมีหน้าตาเป็นอย่างไร เพื่อให้เห็นภาพชัดเจนขึ้น บทความนี้จะแสดงข้อพิสูจน์ด้วยภาพ 3 ประการที่ทำให้เห็นว่าเส้นโค้งรูประฆังคว่ำปรากฏขึ้นได้อย่างไรในสถานการณ์ที่แตกต่างกัน
1. การทอดลูกเต๋าหลายลูก
เมื่อเราทอดลูกเต๋าหกหน้าหนึ่งลูกหลายๆ ครั้ง ตามสัญชาตญาณแล้วเราจะได้การแจกแจงแบบสม่ำเสมอที่หน้าจอแสดงผลแบนราบ อย่างไรก็ตาม เรื่องราวจะเปลี่ยนไปทันทีเมื่อเราทอดลูกเต๋าหลายลูกพร้อมกัน เช่น ทอด 5 ลูกพร้อมกันแล้วนำค่าที่ได้มาหาค่าเฉลี่ย
หากเราพล็อตกราฟจากค่าเฉลี่ยเหล่านี้ เส้นโค้งรูประฆังคว่ำจะปรากฏขึ้นโดยมีจุดสูงสุดอยู่บริเวณค่าเฉลี่ย 3 และ 4 เนื่องจากคะแนนเฉลี่ยเหล่านี้มีโอกาสเกิดขึ้นได้บ่อยกว่าคะแนนสุดโต่งอย่าง 1 หรือ 6 เพราะการจะได้ค่าเฉลี่ยที่น้อยหรือมากขนาดนั้น จำเป็นต้องให้ลูกเต๋า ทุก ลูกออกแต้มต่ำหรือสูงเหมือนกันหมด ซึ่งเป็นเรื่องยากกว่าการที่แต้มแต่ละลูกจะผสมกันจนเกิดค่ากลางๆ
import numpy as np
import matplotlib.pyplot as plt

# Simulating 100,000 averages of 5 dice rolls: upper bound of 7 is excluded in randint()
dice_averages = [np.mean(np.random.randint(1, 7, 5)) for _ in range(100000)]

plt.hist(dice_averages, bins=20, edgecolor='black', color='skyblue')

plt.title("Distribution of 5-Dice Averages")
plt.show()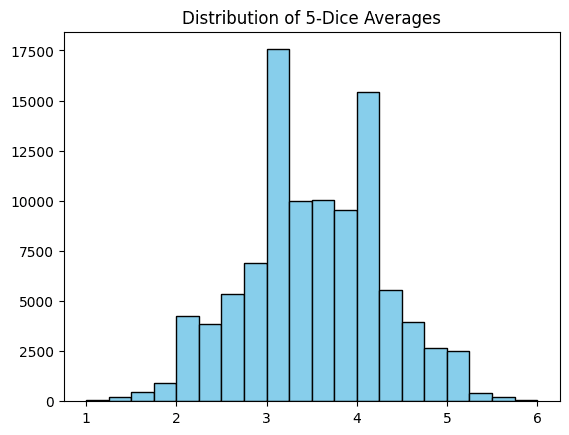
การแจกแจงค่าเฉลี่ยจากการทอดลูกเต๋า 5 ลูก จำนวน 100,000 ครั้ง
2. การหาค่าเฉลี่ยจากกลุ่มคนที่แตกแยก: เวลาการใช้งานหน้าจอแบบ Bimodal
สมมติว่ามีแอปวิดีโอที่มีพฤติกรรมผู้ใช้แบ่งเป็นสองขั้วชัดเจน คือกลุ่มที่เข้ามาดูเพียง 1-2 นาที กับกลุ่ม "Deep Scrollers" ที่ดูนานกว่า 30 นาที โดยไม่มีใครอยู่ตรงกลางเลย หากเราพล็อตข้อมูลดิบจะได้การแจกแจงแบบ Bimodal ที่มีจุดสูงสุดสองตำแหน่งและมีหุบเขาลึกอยู่ตรงกลาง
ทว่าหากเราสุ่มหยิบกลุ่มผู้ใช้มาครั้งละ 40 คนซ้ำๆ แล้วคำนวณเวลาหน้าจอเฉลี่ยของแต่ละกลุ่มมาพล็อตกราฟ การแจกแจงของค่าเฉลี่ยจะมองข้ามหุบเขาตรงกลางนั้นไปโดยสิ้นเชิง และกลับกลายเป็นรูปทรงระฆังคว่ำที่สวยงามแทน
# Creating a bimodal distribution (quick checkers and deep scrollers)
quick = np.random.normal(2, 0.5, 50000)
deep = np.random.normal(30, 5, 50000)
bimodal_population = np.concatenate([quick, deep])

# Taking 10,000 samples of 40 users each, and averaging screen times
screen_time_averages = [np.mean(np.random.choice(bimodal_population, 40)) for _ in range(10000)]

plt.hist(screen_time_averages, bins=30, edgecolor='black', color='mediumpurple')
plt.title("Averages of Bimodal Screen Times for 10K 40-user samples")
plt.show()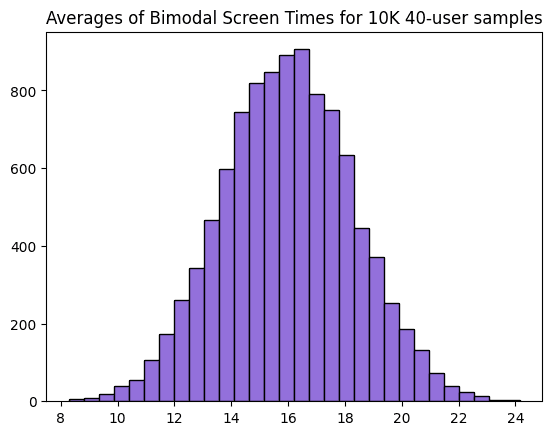
การแจกแจงค่าเฉลี่ยจากการสุ่มตัวอย่างประชากรที่มีเวลาหน้าจอแบบ Bimodal
3. การทำให้ความเบ้ที่วุ่นวายราบเรียบ: รายได้เฉลี่ย
ตัวอย่างที่เห็นภาพชัดที่สุดในโลกจริงคือการกระจายรายได้ ซึ่งมักจะมีความเบ้ขวาอย่างรุนแรง ประชากรส่วนใหญ่อยู่ในกลุ่มรายได้น้อย ในขณะที่เศรษฐีจำนวนหนึ่งทำให้เกิดส่วนหางยาว (Long Tail) ทอดยาวไปทางขวาของกราฟ
ภาพความเหลื่อมล้ำนี้จะถูกปรับให้สมมาตรเมื่อเราสุ่มเลือกคนมา 50 คนแล้วหาค่าเฉลี่ยรายได้ของกลุ่มนั้น หากทำซ้ำหลายพันครั้งผลลัพธ์ที่ได้ก็คือเส้นโค้งรูประฆังคว่ำที่เกือบจะสมบูรณ์แบบ เนื่องจากค่ารายได้ที่สูงผิดปกติของคนรวยเพียงไม่กี่คน จะถูกเจือจางและทำให้ราบเรียบเมื่อรวมเข้ากับค่าเฉลี่ยของคนส่วนใหญ่นั่นเอง
# Generating heavily skewed "income" data (exponential distribution)
population = np.random.exponential(scale=50000, size=100000)

# Taking 10,000 samples of 50 people and averaging them
income_averages = [np.mean(np.random.choice(population, 50)) for _ in range(10000)]

plt.hist(income_averages, bins=30, edgecolor='black', color='salmon')
plt.title("Averages of Skewed Wealth Samples")
plt.show()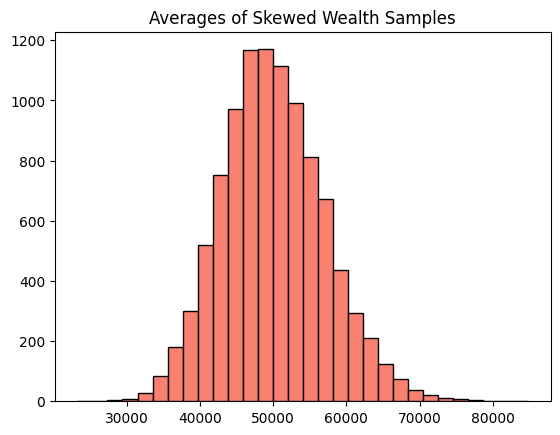
การแจกแจงค่าเฉลี่ยจากการสุ่มตัวอย่างประชากรที่มีรายได้แบบเบ้ขวา
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร