
7 Design Patterns ขั้นสูงใน Python สำหรับนักวิทยาศาสตร์ข้อมูล
ฟังก์ชันการเทรนโมเดลมักเริ่มต้นด้วยโค้ดขนาดเล็กที่อ่านง่าย แต่เมื่อผ่านการใช้งานร่วมกันใน repository นานเข้า มักจะเกิดการสะสมของเงื่อนไขเฉพาะตัว ทั้งประเภทโมเดล แหล่งข้อมูล และระบบ logging จนกลายเป็นความยุ่งเหยิงที่ผู้เรียกใช้งานทุกคนต้องแบกรับมรดกความซับซ้อนนี้ไป
KDnuggets เคยนำเสนอ Python patterns for intermediate data scientists ซึ่งครอบคลุมเรื่อง pipeline, factory และ decorator ไปแล้ว บทความนี้จะต่อยอดไปสู่ 7 รูปแบบที่ตอบโจทย์ปัญหาเฉพาะหน้า เมื่อโค้ดใน notebook ต้องถูกพัฒนาเป็นระบบที่ใช้งานได้จริงโดยผู้อื่น
อย่างไรก็ตาม กฎเหล็กที่สำคัญคือหากไม่มีความจำเป็นต้องเรียกใช้โค้ดนั้นซ้ำ การใช้ pattern อาจเป็นการเพิ่มพิธีรีตองโดยไม่จำเป็น และฟังก์ชันธรรมดายังคงเป็นทางเลือกที่ดีกว่า Pattern จะคุ้มค่าก็ต่อเมื่อมันช่วยขจัดต้นเหตุของการเปลี่ยนแปลงที่เกิดขึ้นซ้ำๆ เท่านั้น
| Pattern | Recurring pressure | Python shape | Main caveat |
|---|---|---|---|
| Strategy | มีเงื่อนไขแยกตาม metric หรือนโยบายการตรวจสอบ | evaluate(y_true, y_pred, scorer) รับค่า callable | พฤติกรรมที่ไม่มีสถานะ (Stateless) ควรเป็นฟังก์ชันธรรมดา ไม่ใช่ class |
| Adapter | API ของ model และรูปแบบ output ต่างกันตาม library | ใช้ Protocol ท้องถิ่นหนึ่งตัว พร้อม wrapper บางๆ เพื่อจัดรูปแบบ output | แปลเฉพาะ interface เท่านั้น แต่ความหมาย (semantics) ยังคงถูกส่งผ่านไป |
| Template Method | การทดลองที่คล้ายกันมีการก๊อปปี้ลำดับการรันแบบเดียวกัน | ABC เป็นเจ้าของ run(); subclass เติมเต็ม hook ที่เลือกไว้ | การสืบทอด (Inheritance) ทำให้ตัวแปรต่างๆ ยึดติดกัน; ควรใช้ Strategy หากต้องการผสมผสานอย่างอิสระ |
| Observer | Loop การเทรนเชื่อมต่อกับ logger และ dashboard โดยตรง | ส่ง frozen event dataclass ไปยังรายการของ callback | ลำดับ, ข้อผิดพลาด และต้นทุนต้องชัดเจนเมื่อจำนวน callback เพิ่มขึ้น |
| Command | การรันที่ต้องเข้าคิว, ลองใหม่ หรือส่งต่อ | Frozen dataclass พร้อม ID และ execute(runner) | Seed, ข้อมูล และเวอร์ชันของโค้ด ยังคงต้องระบุ ID อย่างชัดเจน |
| Facade | ต้อง import ห้าอย่างและตั้งค่ามากมายเพื่องานเดียว | มี method ระดับงานหนึ่งตัวที่มอบหมายงานให้ส่วนประกอบต่างๆ | คุมให้บางเข้าไว้ ไม่อย่างนั้นมันจะกลายเป็น monolith ตัวใหม่ |
| Proxy | Model หรือ dataset ราคาแพงถูกโหลดก่อนความจำเป็น | ใช้สัญญา predict() เดิม; _load() รันครั้งเดียวเมื่อใช้งานครั้งแรก | การล้างแคช, thread safety และความล้มเหลวในการโหลดต้องมีการตัดสินใจรองรับ |
ตารางที่ 1. Pattern ทั้ง 7 รูปแบบที่จับคู่กับปัญหา โครงสร้างใน Python และข้อควรระวัง (ตรวจสอบบน Python 3.10)
1. สลับตรรกะการประเมินผลด้วย Strategy
การใช้ if metric == "accuracy" ในตัวรันการทดลองจะทำให้โค้ดบวมขึ้นทุกครั้งที่มี metric ใหม่ Strategy จะช่วยขจัดเงื่อนไขเหล่านี้โดยเปลี่ยนพฤติกรรมการให้คะแนนเป็นค่าที่ผู้เรียกส่งเข้ามาแทน:
def evaluate(y_true, y_pred, scorer):
        return scorer(y_true, y_pred)

evaluate(y_true, y_pred, accuracy)          # 0.6
evaluate(y_true, y_pred, recall_pos)        # 0.667
วิธีนี้ช่วยให้สามารถทดสอบ scorer แยกกันได้ และการเพิ่มฟังก์ชันใหม่ทำได้โดยไม่ต้องแก้ไขโค้ดการทดลองเดิม ทั้งนี้ Strategy มักถูกสับสนกับ Command โดยความแตกต่างคือ Strategy เน้นการทำงานทันที ส่วน Command จะรวมการทำงานเพื่อนำไปรันภายหลังหรือรันที่อื่น
2. ปรับ API ของ Model ให้เป็นมาตรฐานด้วย Adapter
เมื่อโค้ดประเมินผลต้องคอยเช็คว่า library ไหนสร้างโมเดลขึ้นมา แสดงว่าเกิดปัญหา interface รั่วไหล วิธีแก้คือการใช้ typing.Protocol สร้างสัญญา (contract) ท้องถิ่น และใช้ wrapper หุ้มสิ่งที่ไม่ตรงกับสัญญานั้น:
class Predictor(Protocol):
        def predict_proba(self, X) -> list: ...

class LegacyAdapter:
        def __init__(self, model):
            self._model = model

def predict_proba(self, X):
            scores = self._model.score_rows(X)
            return [[1 - s, s] for s in scores]
ข้อควรระวังคือ Adapter แปลงเพียง interface แต่ไม่ได้เปลี่ยนความหมายเชิงลึก (semantics) เช่น เกณฑ์การตัดสินใจหรือการปรับเทียบความน่าจะเป็น ซึ่งอาจกลายเป็นบั๊กที่ซ่อนอยู่ในชุดคอสตูมความเข้ากันได้
3. แก้ไขโครงสร้างการทดลองด้วย Template Method เพื่อป้องกันการก๊อปปี้โค้ดการทดลองที่คล้ายกันจนเกิดการเพี้ยน Template Method จะกำหนดขั้นตอนหลักใน base class ที่สร้างบน abc และให้ subclass เติมรายละเอียดเฉพาะ:
class Experiment(ABC):
        def run(self):
            self.load()
            self.fit()
            self.evaluate()
            self.save()

@abstractmethod
        def fit(self):
            ...
วิธีนี้ช่วยให้วงจรชีวิตการทำงานเสถียร แต่มีข้อแลกเปลี่ยนคือทุกตัวแปรจะยึดติดกับโครงสร้างหลัก หากต้องการความยืดหยุ่นในการผสมผสานขั้นตอน ควรพิจารณาใช้ Strategy แทน
4. กระจายเหตุการณ์การรันด้วย Observer
แทนที่จะให้ loop การเทรนเรียกใช้ tracker หรือ dashboard โดยตรง Observer จะให้ loop ส่งเหตุการณ์ (event) ที่ไม่สามารถเปลี่ยนแปลงได้ (immutable) ออกมา เพื่อให้ callback ต่างๆ ตัดสินใจเอง:
@dataclass(frozen=True)
class EpochEnded:
        epoch: int
        loss: float

for cb in observers:
        cb(EpochEnded(epoch, loss))
การใช้ frozen=True ช่วยป้องกันไม่ให้ observer ตัวหนึ่งทำข้อมูลเสียหายจนกระทบตัวถัดไป อย่างไรก็ตาม เมื่อจำนวน callback เพิ่มขึ้น ต้องระวังเรื่องลำดับเหตุการณ์และต้นทุนการทำงานที่อาจมองไม่เห็น
5. รวมชุดการรันที่ทำซ้ำได้เป็น Commands
Command เปลี่ยนคำขอให้กลายเป็นวัตถุที่สร้างจาก dataclass แบบแช่แข็ง เพื่อให้สามารถบันทึก log, เข้าคิว หรือส่งไปรันในเครื่องอื่นได้:
@dataclass(frozen=True)
class TrainModel:
        dataset_id: str
        model_name: str
        config_id: str

def execute(self, runner):
            return runner(self)
สิ่งที่ต้องระวังคือ Command บันทึกแค่ "คำขอ" ไม่ใช่สภาพแวดล้อมทั้งหมด ดังนั้นต้องระบุ ID ของ dataset, เวอร์ชันโค้ด และ random seed ให้ชัดเจนเพื่อให้การรันซ้ำได้ผลลัพธ์คงเดิม
6. ซ่อนความวุ่นวายของระบบย่อยไว้หลัง Facade
Facade ช่วยลดภาระของผู้ใช้โดยรวบรวมขั้นตอนที่ซับซ้อนและการ import หลายอย่างไว้ภายใต้ method เดียว:
class ExperimentFacade:
        def train_and_report(self, config):
            cleaned = self._preprocessor.clean(config)
            model = self._trainer.fit(cleaned)
            return self._reporter.report(model)
หน้าที่ของ Facade คือการมอบหมายงาน ไม่ใช่การทำงานเอง จึงควรควบคุมให้มีขนาดเล็กและบางที่สุดเพื่อไม่ให้กลายเป็นโมโนลิท (monolith) ตัวใหม่ที่จัดการยาก
7. ควบคุมการเข้าถึงราคาแพงด้วย Proxy
Proxy ช่วยชะลอการโหลดโมเดลหรือ dataset ขนาดใหญ่จนกว่าจะจำเป็นต้องใช้งานจริง เพื่อประหยัดทรัพยากรตอนเริ่มต้นระบบ:
class LazyModelProxy:
        def __init__(self):
            self._model = None

def predict(self, X):
            if self._model is None:
                self._model = RealModel()
            return self._model.predict(X)
หัวใจสำคัญของการใช้ Proxy คือการออกแบบระบบรองรับความล้มเหลวในการโหลด และการจัดการ thread safety เพื่อไม่ให้ส่งมอบ artifact ที่ล้าสมัยโดยไม่รู้ตัว
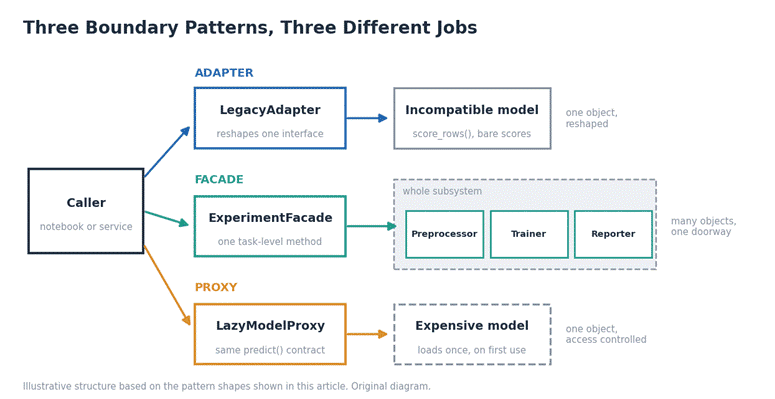
รูปที่ 1. การแบ่งงานของ boundary patterns ทั้งสาม: Adapter ปรับรูปแบบวัตถุ, Facade เป็นหน้าด่านระบบย่อย และ Proxy ควบคุมการเข้าถึงวัตถุราคาแพง
ระบุปัญหาให้ชัดก่อนเรียกชื่อ Pattern
ก่อนเริ่มใช้ pattern ควรตอบคำถาม 3 ข้อ: อะไรที่เปลี่ยนซ้ำๆ? สัญญาอะไรที่ต้องคงที่? และ abstraction นี้สร้างความล้มเหลวรูปแบบใหม่หรือไม่? การเลือก pattern ที่ถูกต้องจะช่วยให้โค้ดทดสอบง่ายขึ้นและผู้เรียกใช้งานสะดวกขึ้น
สำหรับผู้ที่สนใจการจัดการโครงสร้างในระดับโปรเจกต์ สามารถศึกษาต่อได้ที่ structuring a data science project และหากปัญหาขยายไปสู่ระดับ MLOps แนะนำให้อ่านเรื่อง design patterns for MLOps เพิ่มเติม
[Nahla Davies](http://nahlawrites.com/) เป็นนักพัฒนาซอฟต์แวร์และนักเขียนด้านเทคนิคที่เคยร่วมงานกับองค์กรระดับโลกมากมาย เช่น Samsung, Netflix และ Sony
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร