
Nanbeige เปิดตัว Nanbeige4.3-33B โมเดล Agentic Coding แบบโอเพนซอร์ส
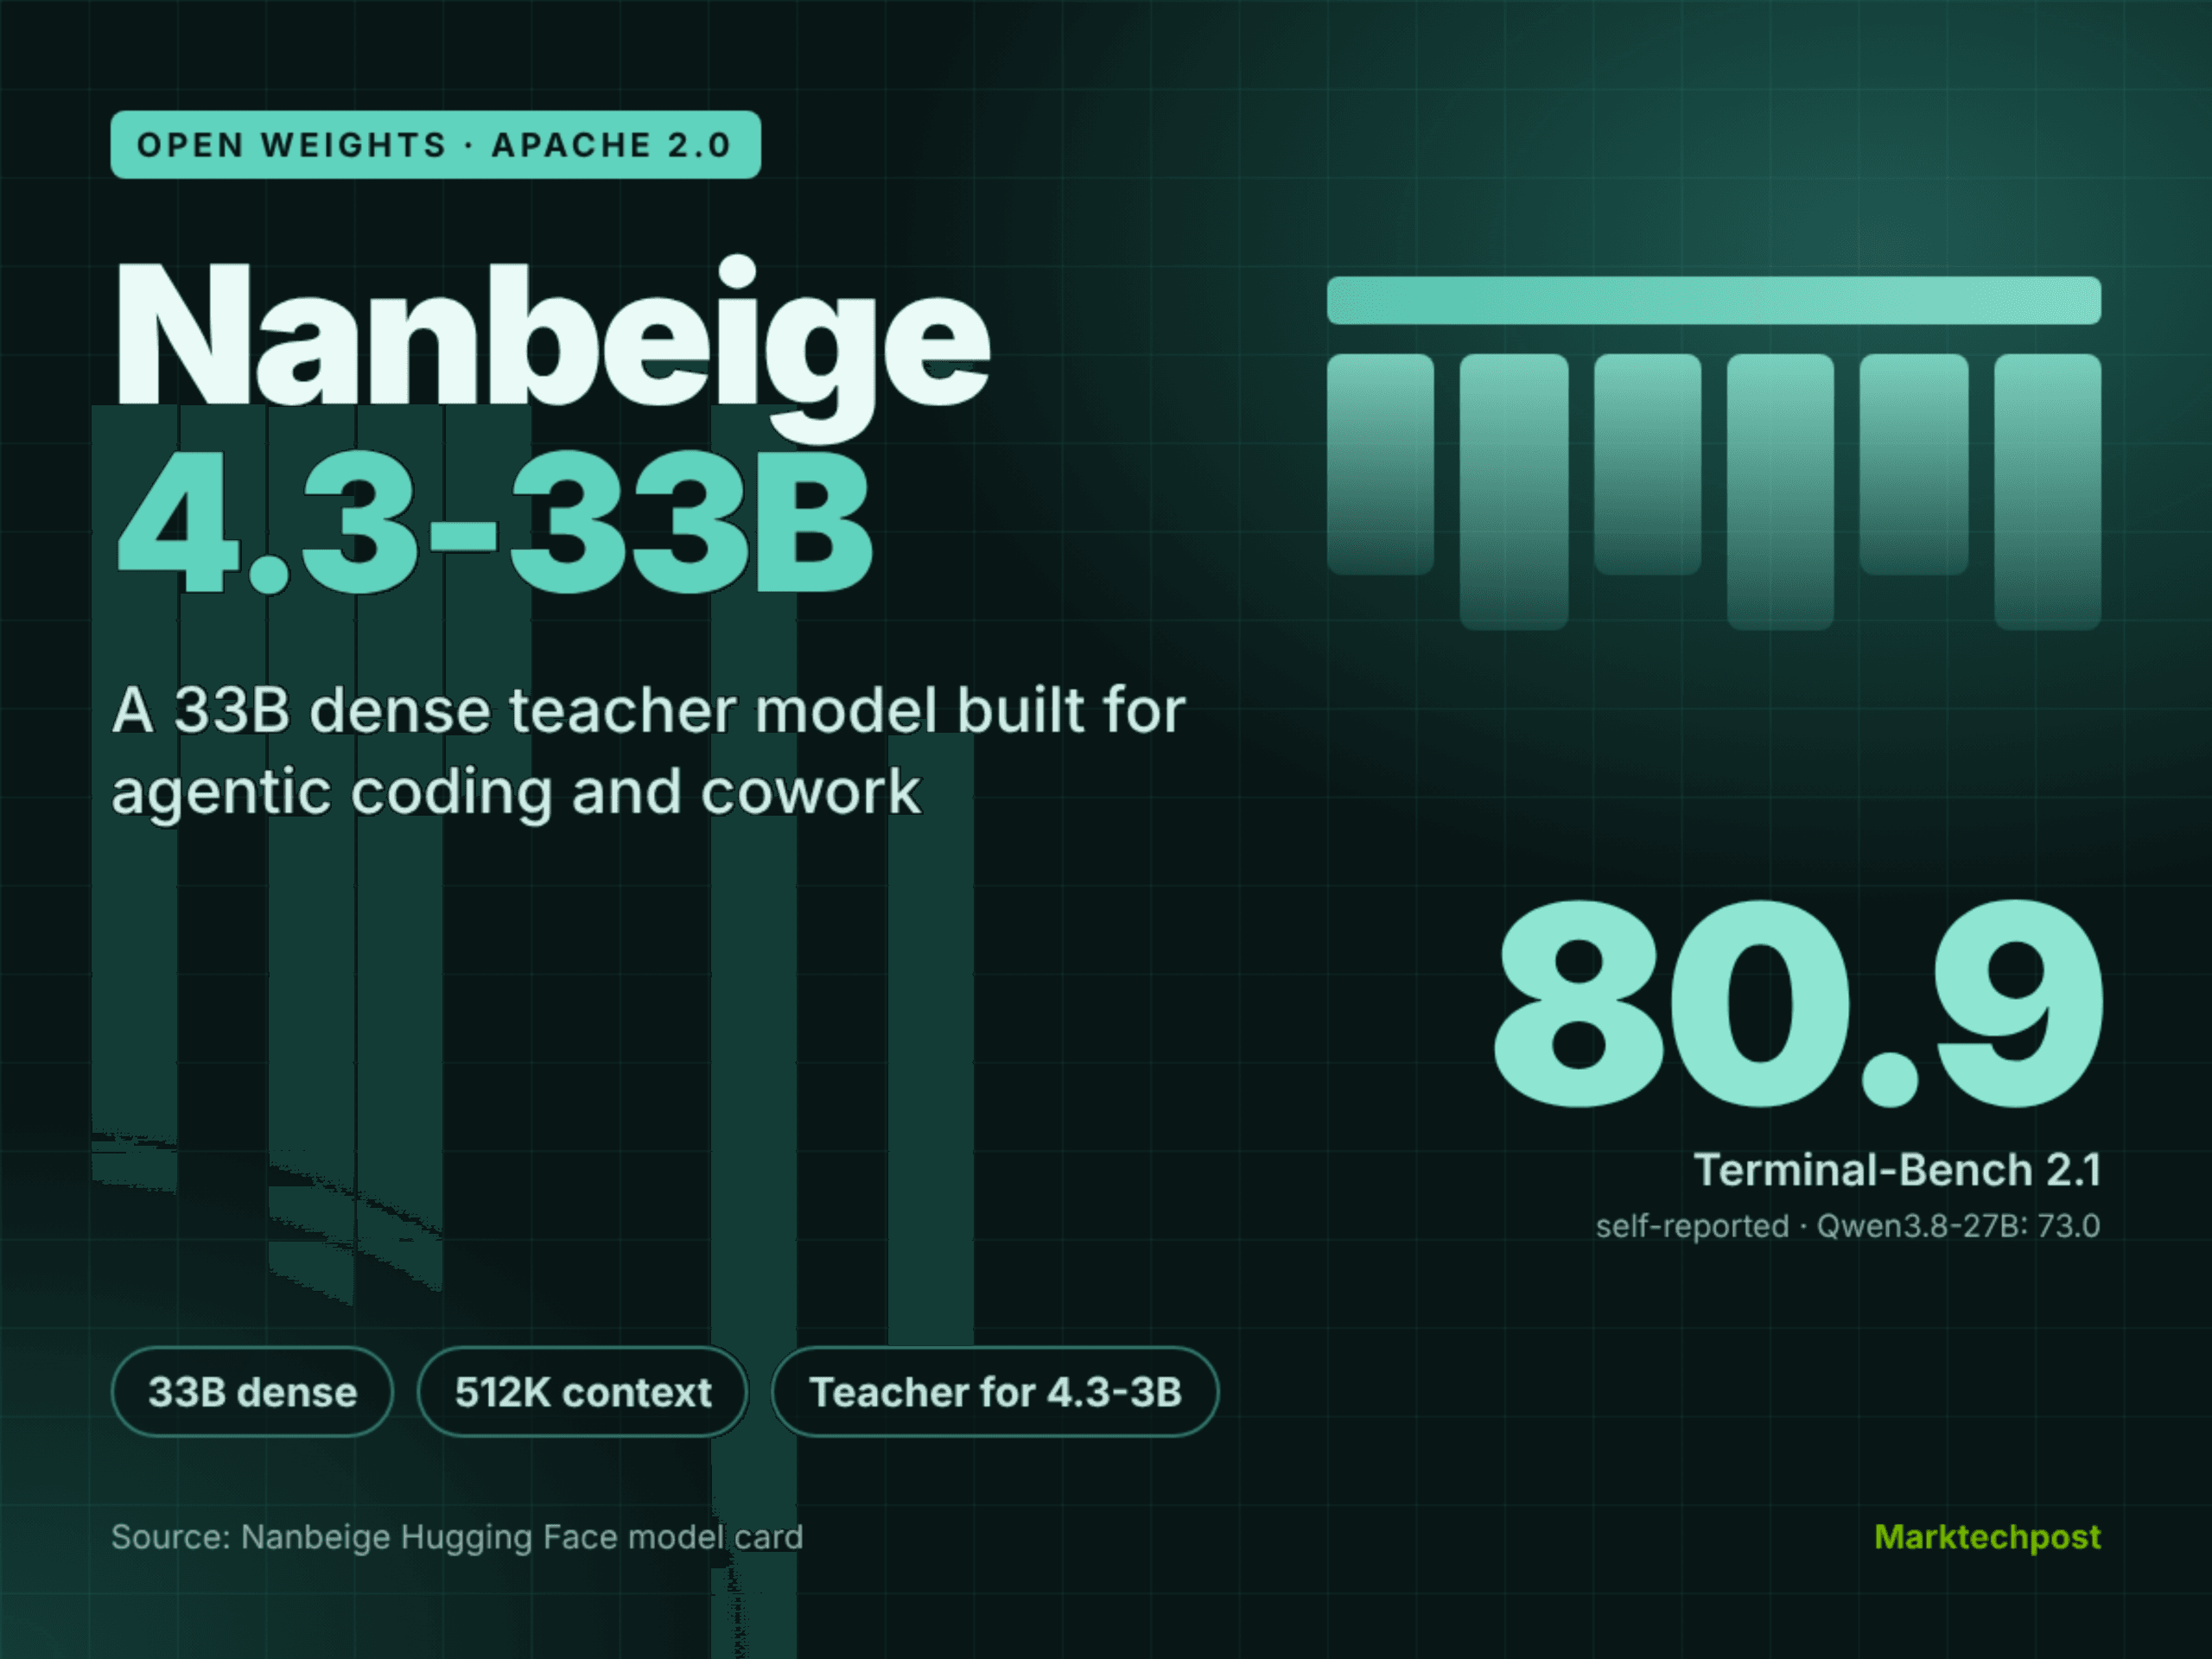
Nanbeige LLM Lab เปิดตัว Nanbeige4.3-33B บน Hugging Face ภายใต้ลิขสิทธิ์ Apache 2.0 โดยเป็นโมเดลภาษาแบบ dense ขนาด 33B ที่ถูกออกแบบมาเพื่อรองรับ agentic coding และการทำงานร่วมกัน (cowork) ในรูปแบบสำนักงาน พัฒนาโดยแล็บภายในแพลตฟอร์มรับสมัครงานชื่อดังอย่าง BOSS Zhipin นอกจากนี้ยังมีการปล่อยรุ่น Nanbeige4.3-33B-Base สำหรับการทำ post-training เพิ่มเติม โดยตัวโมเดลรองรับ context window สูงสุดถึง 524,288 token และมีคะแนนทดสอบนำคู่แข่งในระดับ 30B ถึง 17 จาก 20 รายการ
การใช้งานโมเดลนี้จำเป็นต้องใช้เซิร์ฟเวอร์ Multi-GPU โดยมีสูตรการตั้งค่าผ่าน SGLang และ vLLM ที่ใช้ tensor parallelism แบบ 4 ทาง ซึ่งไฟล์ Weight รูปแบบ BF16 จะใช้พื้นที่ประมาณ 66 GB และเริ่มมีชุมชนนักพัฒนาจัดทำไฟล์ quantization ออกมาบ้างแล้ว
ในด้านประสิทธิภาพ Nanbeige4.3-33B ทำคะแนนได้โดดเด่นในผลการทดสอบของตนเอง โดยสามารถเอาชนะคู่แข่งอย่าง Qwen3.8-27B, Muse-Glimmer-30B และ Gemma4-31B ในหลายด้าน โดยเฉพาะคะแนน 80.9 บน Terminal-Bench 2.1 ซึ่งสูงกว่า Qwen3.8-27B ที่ทำได้ 73.0 อย่างไรก็ตาม ยังมีจุดที่ทำคะแนนได้น้อยคือ Terminal-Bench 4.0 ที่ 23.8 และตามหลัง Qwen3.8-27B เล็กน้อยใน SWE-Bench Pro ด้วยคะแนน 60.3 ต่อ 61.7
Nanbeige4.3-33B คืออะไร?
Nanbeige4.3-33B วางตำแหน่งเป็นโมเดลเรือธงระดับ 'teacher' ของซีรีส์ Nanbeige4.3 โดยกลยุทธ์ของแล็บคือการพัฒนาโมเดลขนาดใหญ่ที่มีความสามารถสูงก่อน เพื่อใช้เป็นต้นแบบในการกลั่นกรอง (distill) ทักษะด้าน agentic ลงสู่โมเดลขนาดเล็กที่มีประสิทธิภาพสูงอย่าง Nanbeige4.3-3B ที่มีกำหนดเปิดตัวตามมา
Nanbeige4.3-33B ถูกสร้างขึ้นอย่างไร?
สถาปัตยกรรมของโมเดลอ้างอิงตามมาตรฐาน LlamaForCausalLM ที่ระบุไว้ใน config.json โดยเป็นโมเดลที่ไม่มีการทำ expert routing ทำให้พารามิเตอร์ทั้งหมด 33B จะถูกประมวลผลในทุกๆ token
- โครงสร้างประกอบด้วย 52 layers, hidden size 7,168
- ใช้ 56 query heads และ 8 key-value heads (grouped-query attention) พร้อม head dimension 128
- FFN intermediate size 22,016 และมี vocabulary ขนาด 166,912 tokens
- กำหนด RoPE theta ที่ 120,000,000 และรองรับตำแหน่งสูงสุด 524,288
ในส่วนของ chat template มีระบบควบคุม 3 ฟังก์ชันหลัก ได้แก่ enable_thinking สำหรับเปิดระบบ reasoning (เปิดเป็นค่าเริ่มต้น), preserve_thinking สำหรับเก็บข้อมูลการคิดจากรอบก่อนหน้าซึ่งเหมาะสำหรับ code agents และการใช้เครื่องมือหลายรอบ และรองรับการส่งค่า tools เพื่อทำ tool calling ผ่านรูปแบบ XML
Nanbeige4.3-33B มีประสิทธิภาพอย่างไรใน benchmark?
Nanbeige ได้เปรียบเทียบผลทดสอบกับ Qwen3.8-27B, Muse-Glimmer-30B และ Gemma4-31B โดยรันทุกโมเดลด้วยระดับ thinking effort สูงสุด ซึ่งเป็นการรายงานผลด้วยตนเอง (self-reported):
- Agentic coding: ทำได้ 80.9 บน Terminal-Bench 2.1 เหนือกว่า Qwen3.8-27B และแสดงประสิทธิภาพสูงสุดบน DeepSWE ที่ 65.5 ส่วนบน Terminal-Bench 4.0 ทำได้ 23.8 ในขณะที่ Gemma4-31B ไม่สามารถทำคะแนนได้
- Agentic cowork: ได้คะแนน 54.2 บน Automation Bench และทำรายได้จำลองสูงถึง $1,025,437 บน YC-bench ซึ่งสูงกว่าคู่แข่งอย่างเห็นได้ชัด
- Reasoning: รายงานผลที่ 95.2 บน AIME 2026 และ 84.0 บน AA-LCR
อย่างไรก็ตาม โมเดลนี้ยังแพ้คู่แข่งในบางรายการ เช่น SWE-Bench Pro และ GDPval ที่ Qwen3.8-27B นำอยู่ รวมถึง GPQA Diamond ที่ Gemma4-31B ทำคะแนนได้ดีกว่า ในขณะที่รุ่น Base ของ Nanbeige สามารถเอาชนะ Gemma4-31B-Base ได้ในทุกรายการที่รายงาน เช่น MMLU-Pro (66.9 ต่อ 59.3)
เปรียบเทียบกับ model card ของคู่แข่งอย่างไร?
| Spec | Nanbeige4.3-33B | Qwen3.8-27B | Muse-Glimmer-30B | Gemma 4 31B |
|---|---|---|---|---|
| Developer | Nanbeige LLM Lab (BOSS Zhipin) | Qwen (Alibaba) | Meta Superintelligence Lab | Google DeepMind |
| Parameters | 33B dense | 27B dense LM plus vision encoder | ~29.6B dense, incl. ~1.8B vision encoder | 30.7B dense |
| Context | 524,288 | 262,144 native, up to 1M | 131,072+ | 256K |
| Input modality | Text | Text, image, video | Text, image | Text, image |
| License | Apache 2.0 | Apache 2.0 | Apache 2.0 | Apache 2.0 |
| Terminal-Bench 2.1 | 80.9* | 73.0 | 51.7 | Not disclosed |
| SWE-Bench Pro | 60.3* | 61.7 | 51.2 | Not disclosed |
| GPQA Diamond | 89.5* | 89.2 | 83.5 (AA) | 84.3 |
| AIME 2026 | 95.2* | Not disclosed | 94.7 | 89.2 |
| Local hardware guidance | 4-GPU tensor-parallel recipe | Not disclosed | 24 GB or 32 GB VRAM at ~4-bit | Consumer GPUs and workstations |
*รายงานผลโดย Nanbeige ส่วนค่าของคู่แข่งมาจาก Hugging Face model card ของแต่ละแล็บเอง
เป็นที่น่าสังเกตว่าตัวเลขของคู่แข่งบางรายการในตารางของ Nanbeige มีความคลาดเคลื่อนจากข้อมูลที่ผู้พัฒนาต้นสังกัดเผยแพร่ เช่น ข้อมูลของ Muse-Glimmer-30B และ Gemma4-31B ใน SWE-Bench Pro ที่อาจมีการสลับกัน หรือคะแนน GPQA Diamond ของ Google ที่แสดงผลต่างกัน ซึ่งอาจเกิดจากความแตกต่างของ harness ที่ใช้ทดสอบ จึงควรพิจารณาข้อมูลส่วนนี้เป็นข้อมูลชั่วคราวจนกว่าจะมีผลการทดสอบอิสระ
จะ Deploy Nanbeige4.3-33B อย่างไร?
ผู้พัฒนาได้ให้แนวทางการใช้งานผ่าน Transformers, SGLang และ vLLM โดยแนะนำให้ใช้ tensor parallelism แบบ 4 ทาง พร้อมตัวแยกส่วน reasoning และ tool-call ของ Qwen3 สำหรับงาน agent แนะนำให้ใช้ temperature 1.0 ส่วนงานแชททั่วไปแนะนำที่ 0.6
ในด้านทรัพยากร weight แบบ BF16 ต้องใช้พื้นที่ประมาณ 66 GB ขณะที่ KV cache สำหรับ context window 524,288 token เต็มรูปแบบจะต้องใช้พื้นที่เพิ่มอีกประมาณ 112 GB ซึ่งในปัจจุบันยังไม่มีผู้ให้บริการ Cloud Inference รายใดรองรับการโฮสต์โมเดลนี้
ประเด็นสำคัญ
- เป็นโมเดล 33B แบบ dense ใช้ลิขสิทธิ์ Apache 2.0 รองรับข้อความล้วนและ context 512K
- ทำคะแนนทดสอบด้าน Agentic Coding ได้สูงถึง 80.9 บน Terminal-Bench 2.1
- มีผลการทดสอบนำใน 17 จาก 20 รายการตามรายงานของ Nanbeige
- ข้อมูลเปรียบเทียบกับคู่แข่งบางส่วนยังมีความขัดแย้งกับข้อมูลทางการของผู้พัฒนาอื่น
- ถูกออกแบบมาเพื่อเป็นโมเดลต้นแบบในการพัฒนา Nanbeige4.3-3B รุ่นเล็กที่จะตามมา
Asif Razzaq ซีอีโอของ Marktechpost AI Media Inc. และวิศวกรผู้มีวิสัยทัศน์ มุ่งเน้นการนำ Artificial Intelligence มาใช้เพื่อประโยชน์ต่อสาธารณะ โดย Marktechpost เป็นแพลตฟอร์มสื่อด้าน AI ที่นำเสนอข้อมูล machine learning และ deep learning ในรูปแบบที่เข้าใจง่ายสำหรับคนทั่วไปและมีความถูกต้องทางเทคนิค ซึ่งมียอดผู้เข้าชมสูงถึง 2 ล้านครั้งต่อเดือน
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร