tag: LLM

r/OpenAIQuestion

OpenAI และ Anthropic หั่นราคา LLM ถึง 80% สงครามราคาหรือแผนระยะยาว

· By: TanasakP
ชาว Reddit วิเคราะห์สาเหตุที่ยักษ์ใหญ่ AI ลดราคาบริการลงอย่างรวดเร็ว ทั้งเพื่อสู้กับโมเดลจากจีน แย่งชิงฐานผู้ใช้ก่อนเข้าตลาดหุ้น และการพัฒนาเทคนิคใหม่ที่ทำให้ต้นทุนถูกลง
r/LocalLLaMANews

Mistral AI ปล่อย Mistral Large 4 โมเดลใหญ่ขนาด 1T แบบ open weight

· By: SirilukP
ชาว Reddit ให้ความสนใจหลัง Mistral AI เปิดตัวโมเดลเรือธงรุ่นใหม่ Mistral Large 4 ที่เน้นงาน coding และความปลอดภัย แม้ขนาดโมเดลจะใหญ่ยักษ์จนรันยากก็ตาม
r/LocalLLaMAMeme

ความปวดหัวเมื่อลองเขียน Inference Engine ด้วยตัวเอง
· By: SirilukP
ผู้ใช้ Reddit แชร์ความล้มเหลวสุดฮาหลังพยายามเขียนระบบรันโมเดลภาษาด้วย WebGL2 จน AI ตอบกลับเป็นภาษาประหลาดและเครื่องหมายตกใจรัวๆ
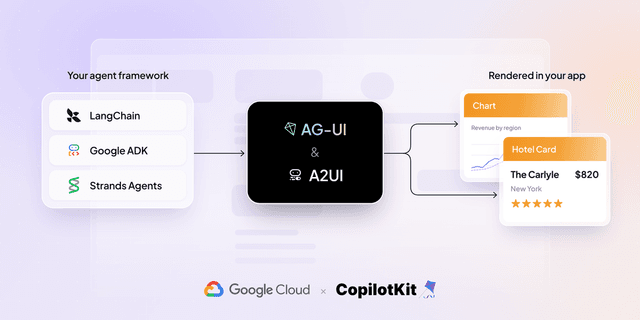
สร้าง Generative UI ด้วย A2UI และ CopilotKit บน Google Devs

สร้าง Generative UI ด้วย A2UI และ CopilotKit บน Google Devs

· By: TanasakP
เรียนรู้วิธีสร้าง Generative UI ที่โต้ตอบได้จริงโดยใช้มาตรฐานเปิด A2UI ของ Google ร่วมกับ CopilotKit เพื่อยกระดับเอเจนต์ AI จากการตอบข้อความสู่หน้าจอ UI ที่สมบูรณ์
r/OpenAIDiscussion

นักวิจัยพบ Evil Neuron ที่เปลี่ยน AI ให้กลายเป็นวายร้ายได้ทันที

· By: SirilukP
ชาว Reddit ถกเถียงหลังมีการเผยแพร่ภาพอ้างการค้นพบเซลล์ประสาทตัวร้ายใน LLM ที่เพียงแค่เปลี่ยนค่าเล็กน้อยก็ทำให้ AI เปลี่ยนพฤติกรรมทางศีลธรรมไปอย่างสิ้นเชิง
r/singularityImage

Google เปิดตัว Gemini 4 Carbon โชว์ศักยภาพเหนือชั้นจนคนอึ้ง

· By: SirilukP
ชาว Reddit แห่ถกเถียงหลัง Google DeepMind เปิดตัวโมเดล Gemini 4 Carbon ที่ทำผลงานได้น่าประทับใจจนลบคำสบประมาทเรื่องบริษัทกำลังถดถอยได้สำเร็จ
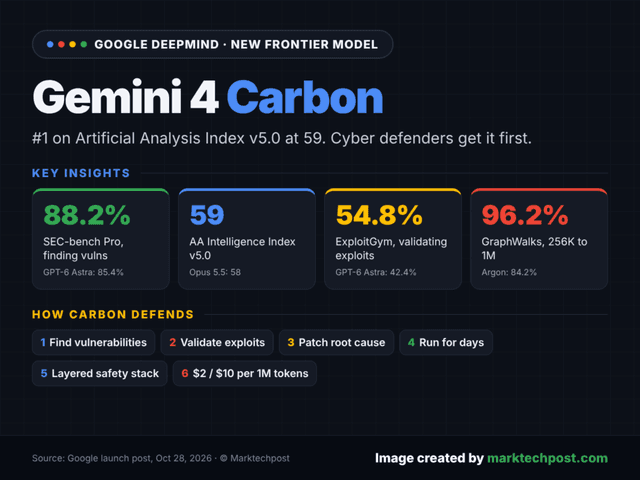
Google DeepMind เปิดตัว Gemini 4 Carbon โมเดลท็อปสาย Cyber Defense

Google DeepMind เปิดตัว Gemini 4 Carbon โมเดลท็อปสาย Cyber Defense

· By: SirilukP
Google DeepMind เปิดตัว Gemini 4 Carbon โมเดลระดับ Frontier ที่ทำคะแนนสูงสุดบนดัชนี Artificial Analysis และ SEC-bench Pro เน้นเจาะกลุ่มผู้เชี่ยวชาญด้านความปลอดภัยไซเบอร์โดยเฉพาะ
Meta จับมือ 5 มหาวิทยาลัยสหรัฐฯ ใช้ AI เร่งวิจัยการแพทย์และวิทยาศาสตร์

Meta จับมือ 5 มหาวิทยาลัยสหรัฐฯ ใช้ AI เร่งวิจัยการแพทย์และวิทยาศาสตร์

· By: TanasakP
Meta ประกาศสนับสนุน 5 มหาวิทยาลัยชั้นนำในสหรัฐฯ โดยมอบโมเดล AI รุ่นล่าสุดและทุนวิจัย เพื่อเร่งการพัฒนาด้านการแพทย์ วิทยาศาสตร์พื้นฐาน และวิศวกรรมด้วยเทคโนโลยี Open-weight
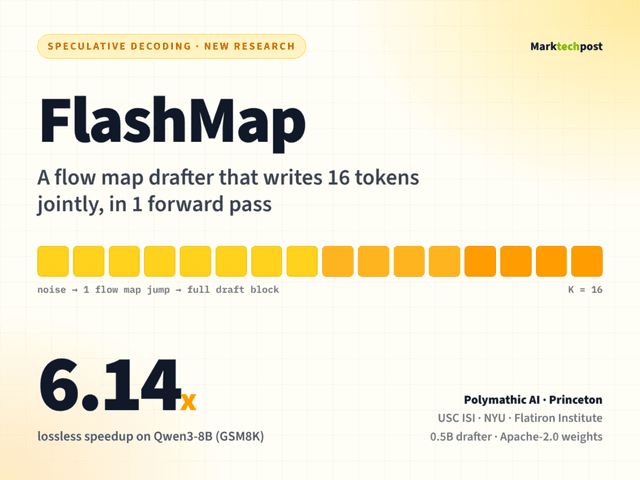
เปิดตัว FlashMap ระบบร่าง Token ใหม่ เร่งความเร็ว LLM สูงสุด 6.14 เท่า

เปิดตัว FlashMap ระบบร่าง Token ใหม่ เร่งความเร็ว LLM สูงสุด 6.14 เท่า

· By: AttapolK
คณะวิจัยจาก Polymathic AI และ Princeton เปิดตัว FlashMap ตัวร่างสำหรับ speculative decoding ที่ใช้เทคนิค continuous flow map ช่วยให้ร่าง 16 token ได้พร้อมกันในครั้งเดียวและเร่งความเร็วแบบ lossless ได้มหาศาล
r/LocalLLaMAMeme

ความแตกต่างระหว่างคนรัน AI ใช้เองกับนักพัฒนาสายเปย์

· By: SirilukP
กระทู้ล้อเลียนความภูมิใจของคนรันโมเดลท้องถิ่นที่ใช้ 12 ล้านโทเค็นต่อวัน แต่ต้องจอดเมื่อเจอข่าวโปรแกรมเมอร์ดังใช้มากถึง 34 ล้านโทเค็นต่อนาที
r/LocalLLaMAMeme

พบหลักฐานเด็ด Qwen แอบส่งข้อมูลกลับเซิร์ฟเวอร์จีน

· By: NatapolK
ผู้ใช้ Reddit โพสต์ประชดประชันประเด็นความปลอดภัยของโมเดล Qwen โดยการตั้งค่าระบบให้แอบส่งข้อมูลกลับจีนเองแล้วทำเป็นตกใจ จนกลายเป็นประเด็นถกเถียงเรื่องความปลอดภัยจริงจัง
เผยโครงสร้าง Sleep: แนวคิดใหม่ช่วย LLM เรียนรู้ต่อเนื่องไม่หยุดยั้ง

เผยโครงสร้าง Sleep: แนวคิดใหม่ช่วย LLM เรียนรู้ต่อเนื่องไม่หยุดยั้ง

· By: SirilukP
นักวิจัยนำแรงบันดาลใจจากการพักผ่อนของสมองมนุษย์มาสร้าง framework ใหม่ ช่วยให้ AI สามารถจดจำข้อมูลระยะยาวและพัฒนาตนเองได้โดยไม่ลืมความรู้เก่า

วิธีสร้าง AI Agent ตัวแรกด้วย OpenAI Agents SDK ใน Python

· By: SirilukP
เรียนรู้วิธีสร้าง AI Agent โดยใช้ OpenAI Agents SDK พร้อมฟีเจอร์ค้นหาเว็บ เชื่อมต่อเครื่องมือ Python และระบบจดจำการสนทนาในเวิร์กโฟลว์แบบครบวงจร
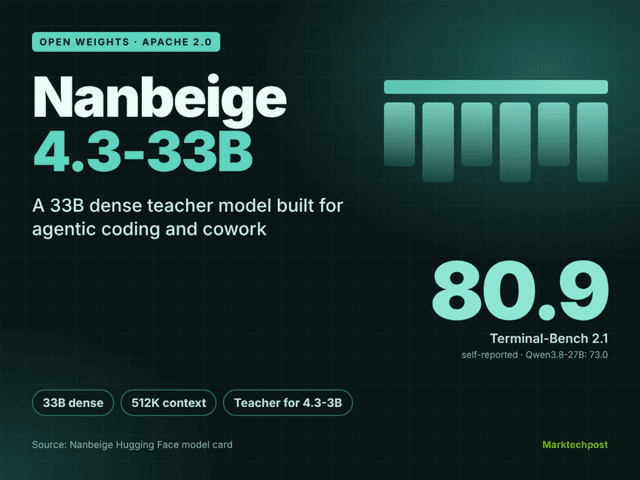
Nanbeige เปิดตัว Nanbeige4.3-33B โมเดล Agentic Coding แบบโอเพนซอร์ส

Nanbeige เปิดตัว Nanbeige4.3-33B โมเดล Agentic Coding แบบโอเพนซอร์ส

· By: NatapolK
Nanbeige LLM Lab เปิดตัวโมเดลภาษาแบบ Dense ขนาด 33B ภายใต้ลิขสิทธิ์ Apache 2.0 ชูจุดเด่นด้านงาน Coding และ Context Window ขนาดใหญ่ถึง 512K เพื่อใช้เป็นโมเดลต้นแบบสำหรับรุ่นย่อส่วนในอนาคต
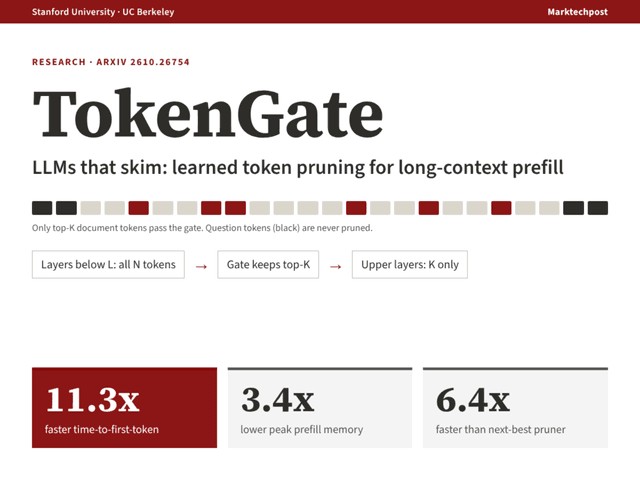
Stanford เปิดตัว TokenGate เร่งความเร็ว Prefill ใน LLM สูงสุด 11.3 เท่า

Stanford เปิดตัว TokenGate เร่งความเร็ว Prefill ใน LLM สูงสุด 11.3 เท่า

· By: SirilukP
นักวิจัยจาก Stanford และ UC Berkeley พัฒนา TokenGate ระบบตัดโทเคนแบบเรียนรู้ได้ ช่วยลดเวลาการประมวลผลบริบทขนาดยาวและประหยัดหน่วยความจำสูงสุด 3.4 เท่าโดยไม่เสียความแม่นยำ
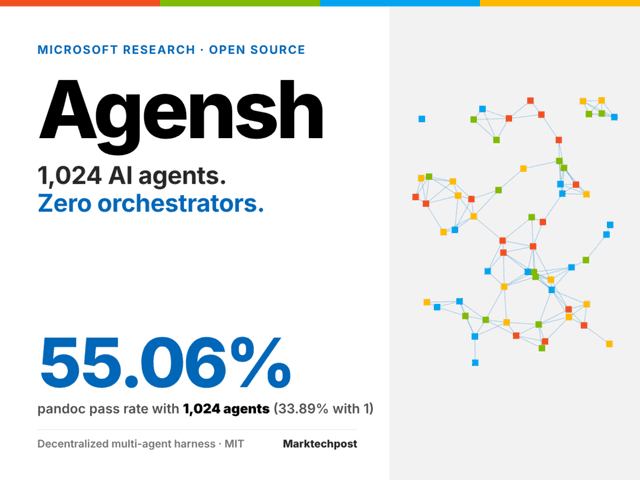
Microsoft เปิดซอร์ส Agensh ระบบรันเอเจนต์ 1,024 ตัวไร้ตัวคุมกลาง

Microsoft เปิดซอร์ส Agensh ระบบรันเอเจนต์ 1,024 ตัวไร้ตัวคุมกลาง

· By: TanasakP
Microsoft Research เปิดตัว Agensh ระบบ Multi-agent Harness แบบกระจายศูนย์ที่ช่วยให้เอเจนต์เขียนโค้ดประสานงานกันเองได้สูงสุดถึง 1,024 ตัวโดยไม่ต้องมีผู้นำ
r/LocalLLaMADiscussion

ผู้ใช้กังวลโมเดลหายจาก Hugging Face สงสัยถูกลบหรือแค่เปลี่ยนชื่อ

· By: AttapolK
ชาว Reddit ตั้งข้อสังเกตโมเดลภาษาหลายตัวบน Hugging Face เริ่มหายไปอย่างไร้ร่องรอย ท่ามกลางการวิเคราะห์ว่าอาจเกิดจากนโยบายการใช้งาน ปัญหาค่าใช้จ่ายในการฝากไฟล์ หรือแค่ผู้พัฒนาลบเอง
r/singularityVideo

ผู้พัฒนา Mod เกม Skyrim ถูกถล่มยับหลังโชว์ผลงาน AI สร้างเพลงสด

· By: AttapolK
ผู้พัฒนา Mod เกม Skyrim เผยแพร่ผลงานที่ใช้ AI สร้างเพลงตามเหตุการณ์ในเกมได้ทันที แต่กลับถูกวิจารณ์อย่างหนักจนต้องลบโพสต์ในชุมชน Modding อื่นๆ
ความปลอดภัยซอฟต์แวร์ AI: หัวใจสำคัญคือความพร้อมไม่ใช่แค่ความเร็ว

ความปลอดภัยซอฟต์แวร์ AI: หัวใจสำคัญคือความพร้อมไม่ใช่แค่ความเร็ว

· By: SirilukP
ระดับความพร้อมในการนำ AI มาใช้ของนักพัฒนาส่งผลกระทบโดยตรงต่อการบริหารจัดการความเสี่ยงด้านความปลอดภัยขององค์กร
PyTorch 2.15 อัปเกรด MPS ครั้งใหญ่ เร่งสปีด LLM บน Mac

PyTorch 2.15 อัปเกรด MPS ครั้งใหญ่ เร่งสปีด LLM บน Mac

· By: TanasakP
PyTorch 2.15 ปรับปรุงประสิทธิภาพบน Mac ครั้งสำคัญด้วยการรองรับ FP8 เร่งการ decode โมเดลภาษาเร็วขึ้นสูงสุด 6.5 เท่า และลดการใช้หน่วยความจำในการสร้างวิดีโอลงมหาศาล
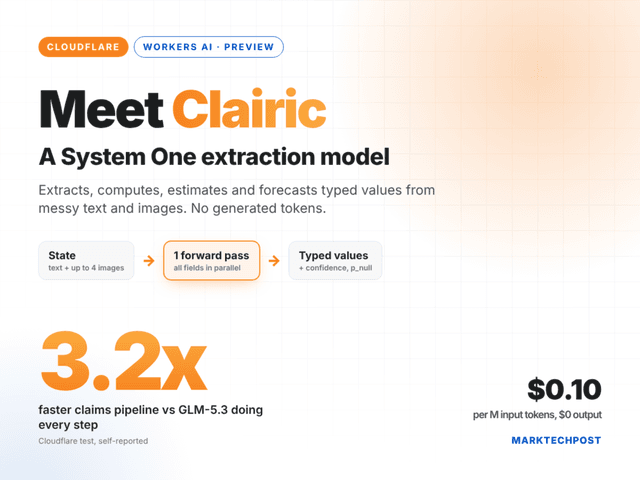
Cloudflare เปิดตัว Clairic โมเดลสกัดข้อมูลความเร็วสูงบน Workers AI

Cloudflare เปิดตัว Clairic โมเดลสกัดข้อมูลความเร็วสูงบน Workers AI

· By: AttapolK
Cloudflare เปิดตัว Clairic โมเดลสกัดข้อมูลแบบ System One ที่เน้นความรวดเร็วและแม่นยำด้วยการประมวลผลแบบ forward pass ครั้งเดียว ในราคาเพียง 0.10 ดอลลาร์ต่อหนึ่งล้าน input tokens
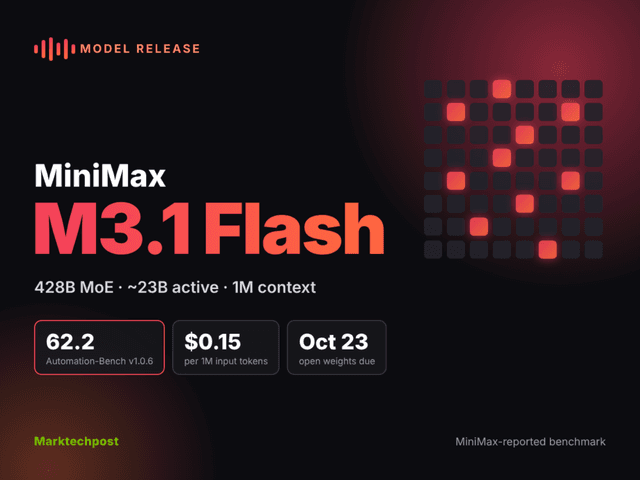
MiniMax เปิดตัว M3.1 Flash โมเดล Agentic MoE ราคาประหยัด

MiniMax เปิดตัว M3.1 Flash โมเดล Agentic MoE ราคาประหยัด

· By: SirilukP
MiniMax เปิดตัวโมเดล M3.1 Flash สถาปัตยกรรม MoE ขนาด 428B พารามิเตอร์ ชูจุดเด่นด้านงาน Agentic และ context window 1M ในราคาเพียง $0.15 ต่อ 1 ล้าน input tokens
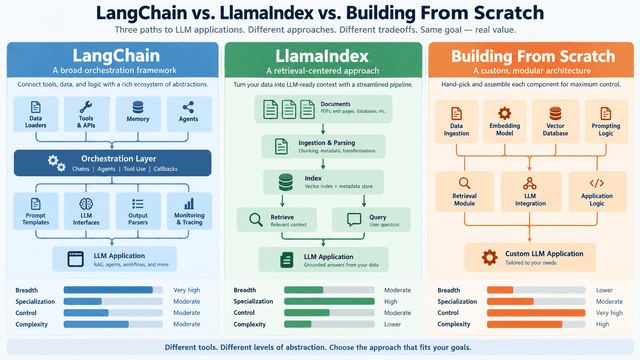
LangChain vs LlamaIndex vs สร้างเอง: เลือกแบบไหนดีสำหรับแอป LLM

LangChain vs LlamaIndex vs สร้างเอง: เลือกแบบไหนดีสำหรับแอป LLM

· By: SirilukP
สรุปแนวทางการเลือกเครื่องมือสำหรับพัฒนาแอปพลิเคชัน LLM ระหว่างการใช้ framework ยอดนิยมกับการเขียนระบบขึ้นเอง เพื่อตอบโจทย์การใช้งานจริงที่มีประสิทธิภาพสูงสุด
r/LocalLLaMAProject

Google เปิดตัว Harness2 เครื่องมือ Open Source ช่วยให้ AI เก่งขึ้นเองได้

· By: NatapolK
Google ปล่อย Harness2 เครื่องมือโอเพนซอร์สที่ช่วยให้ AI เอเจนท์สามารถปรับปรุงระบบการทำงานและคำสั่งของตัวเองให้เหมาะกับแต่ละงานได้โดยอัตโนมัติ
r/artificialNews

PS5 สายมืดอาจรัน AI ได้เร็ว 100 token ต่อวินาทีด้วยโปรเจกต์ใหม่

· By: NatapolK
ชาว Reddit ถกเถียงเรื่องการดัดแปลงเครื่อง PS5 ให้สามารถรันโมเดล AI ในตัวเครื่องได้สำเร็จ โดยเข้าถึงทั้ง CPU และ GPU แต่ยังมีข้อสงสัยเรื่องคุณภาพของโมเดลที่นำมารัน
r/LocalLLaMADiscussion

Linux creator มองกฎห้ามใช้ AI เขียนโค้ดเป็นเรื่องไร้สาระ

· By: SirilukP
Linus Torvalds ผู้สร้าง Linux มองว่าการแบน AI เป็นเรื่องไม่สมเหตุสมผล โดยเน้นที่คุณภาพงานและความเข้าใจในสิ่งที่ทำมากกว่าวิธีการสร้าง
r/LocalLLaMADiscussion

DeepSeek เปิดตัว V4.1-Flash รุ่นอัปเดตย่อยที่ประสิทธิภาพจัดเต็ม

· By: AttapolK
DeepSeek ปล่อยโมเดล V4.1-Flash บน Hugging Face แม้จะเป็นอัปเดตย่อยแต่มีขนาดใหญ่ถึง 763B และทำประสิทธิภาพแซงหน้าคู่แข่งหลายราย
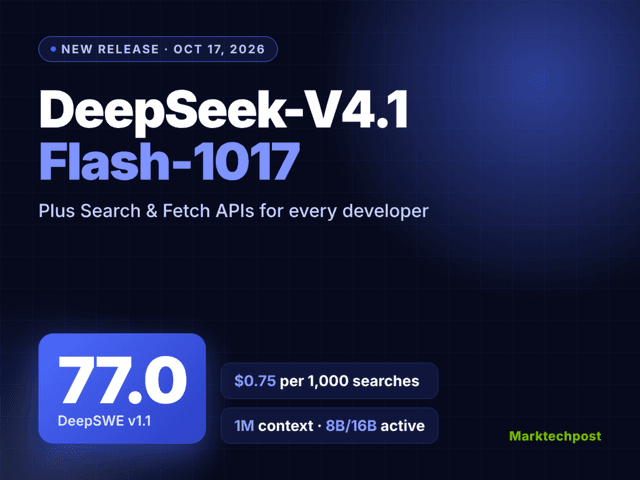
DeepSeek เปิดตัว V4.1-Flash-1017 พร้อม Search API ใหม่

DeepSeek เปิดตัว V4.1-Flash-1017 พร้อม Search API ใหม่

· By: AttapolK
DeepSeek อัปเกรดโมเดล V4.1-Flash-1017 ชูประสิทธิภาพการทำงานที่เร็วและประหยัดขึ้น พร้อมเปิดให้เข้าถึง Search API สำหรับนักพัฒนาแล้ววันนี้
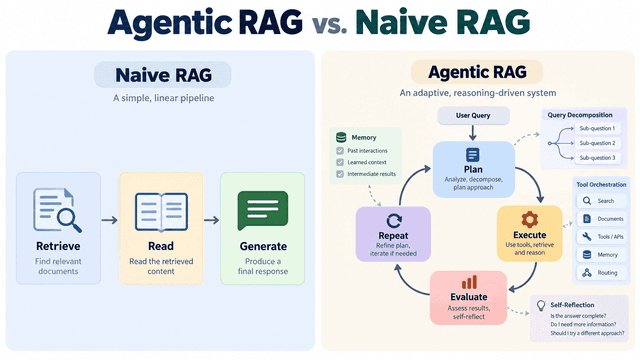
Agentic RAG vs Naive RAG: เมื่อระบบค้นข้อมูลต้องคิดเองได้

Agentic RAG vs Naive RAG: เมื่อระบบค้นข้อมูลต้องคิดเองได้

· By: SirilukP
เปรียบเทียบสถาปัตยกรรม RAG จากแบบท่อส่งข้อมูลคงที่สู่ระบบคิดวิเคราะห์อัตโนมัติ เพื่อทำความเข้าใจจุดอ่อนและวิธีเลือกใช้งานให้เหมาะสมกับความต้องการขององค์กร
หน้า 1 · 136 ข่าวถัดไป →