r/LocalLLaMAMemeความปวดหัวเมื่อลองเขียน Inference Engine ด้วยตัวเองtag: GLSL, Inference Engine, Llama.cpp, LLM, Qwen, WebGL2Oct 30, 2026 · By: SirilukPผู้ใช้ Reddit แชร์ความล้มเหลวสุดฮาหลังพยายามเขียนระบบรันโมเดลภาษาด้วย WebGL2 จน AI ตอบกลับเป็นภาษาประหลาดและเครื่องหมายตกใจรัวๆ
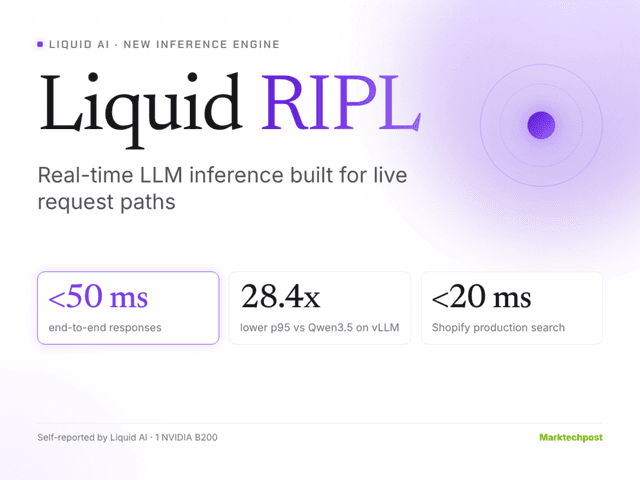
Liquid AI เปิดตัว RIPL เอ็นจิน Inference เรียลไทม์ เร็วกว่า vLLM สูงสุด 28 เท่าtag: Inference Engine, LFM2.5, Liquid AI, NVIDIA B200, RIPL, ShopifyOct 23, 2026 · By: SirilukPสรุปข่าว 1:29Liquid AI เปิดตัว RIPL เอ็นจินสำหรับโมเดล LFM ที่ทำความหน่วงต่ำกว่า 50 ms โดยผลทดสอบบน NVIDIA B200 พบว่าเร็วกว่าการรัน Qwen3.5 บน vLLM สูงสุดถึง 28.4 เท่า
รู้จัก FreeToken: Engine ประมวลผล MoE ที่รันโมเดล GLM-5.2 ขนาด 753B ได้บน GPU เวิร์กสเตชันเพียงตัวเดียวtag: DeepSeek-V4-Flash, FreeToken, GLM-5.2, Inference Engine, MoE, NvidiaAug 24, 2026 · By: AttapolKFreeToken เป็นระบบประมวลผล MoE แบบ Edge-Native ที่ช่วยให้นักพัฒนาสามารถรันโมเดลขนาดใหญ่ระดับ 753B บนเครื่องส่วนตัวได้ด้วยการบริหารแบนด์วิดท์ PCIe และ CPU อย่างมีประสิทธิภาพ