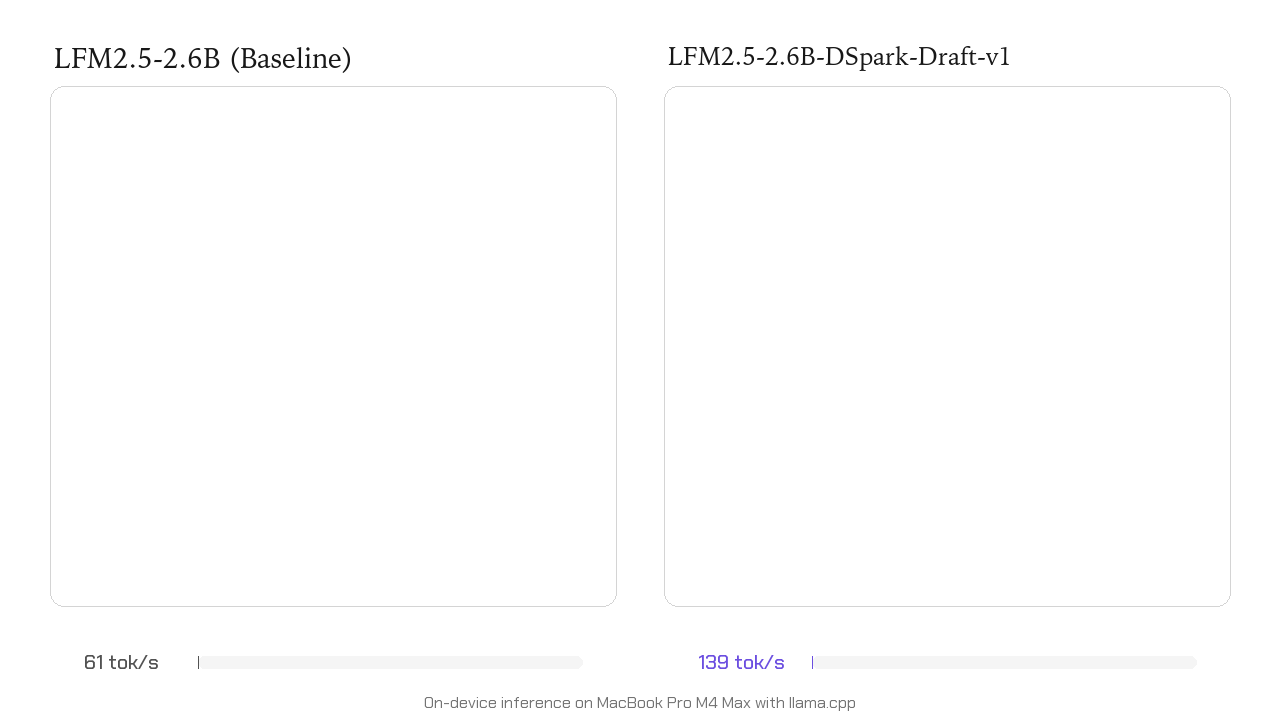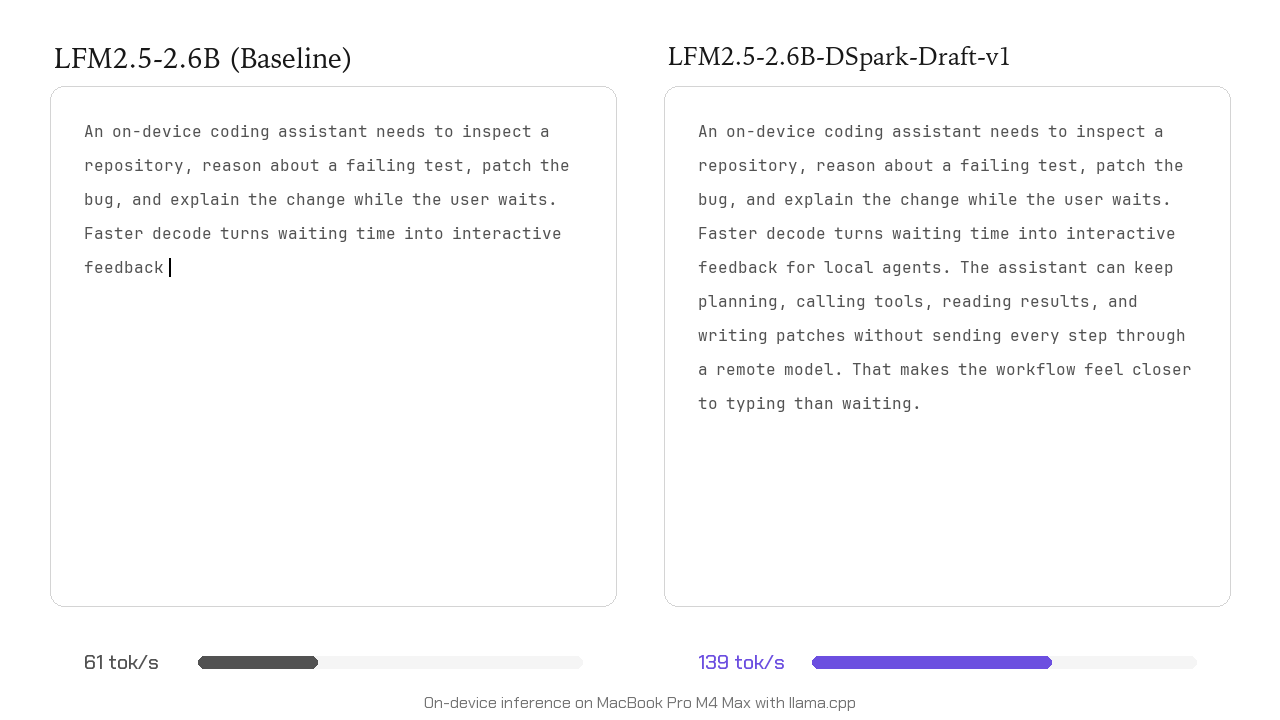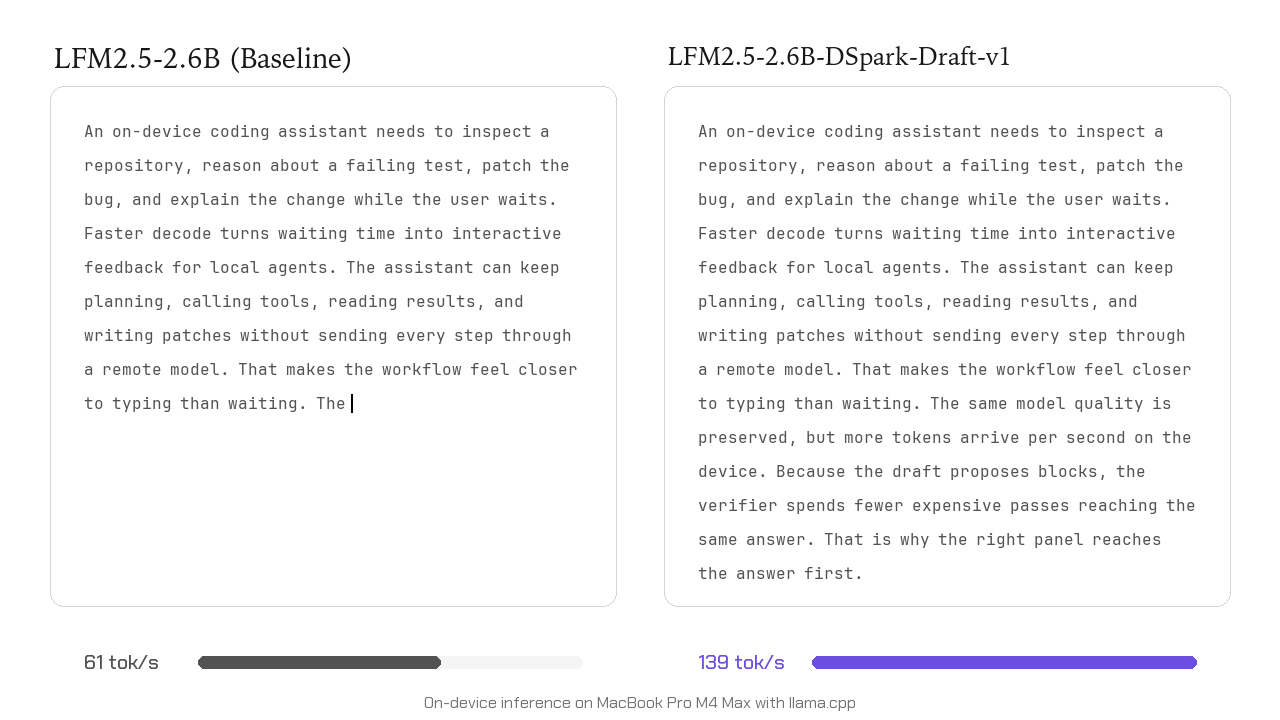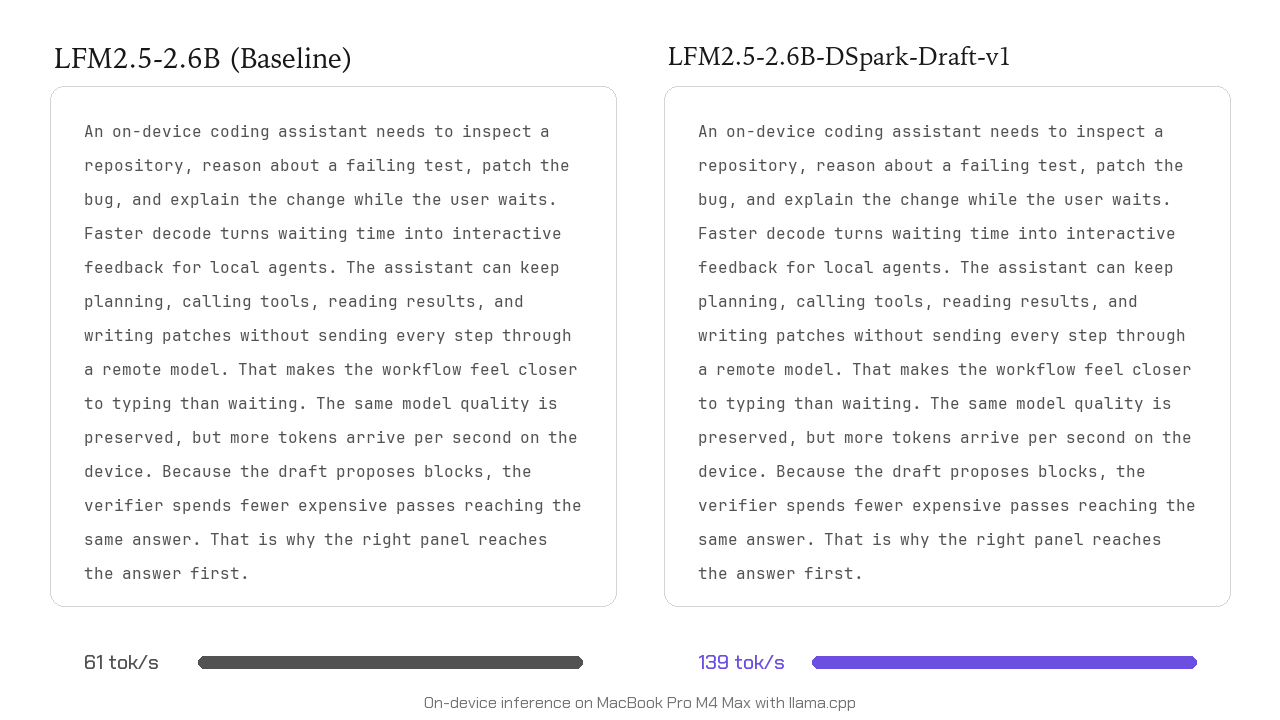
Liquid AI เปิดตัว LFM2.5-DSpark เร่งความเร็วการประมวลผลโมเดลภาษาได้สูงสุด 3.2 เท่าtag: DSpark, LFM2.5, Liquid AI, LLM Inference, Speculative DecodingAug 21, 2026 · By: SirilukPLiquid AI เปิดตัว DSpark draft model สำหรับโมเดลตระกูล LFM2.5 ช่วยเร่งความเร็วการประมวลผล (inference) สูงสุด 3.2 เท่าบน GPU และอุปกรณ์พกพา ผ่านเทคนิค speculative decoding โดยยังคงคุณภาพของผลลัพธ์ไว้เท่าเดิม พร้อมรองรับ llama.cpp และ SGLang ทันที
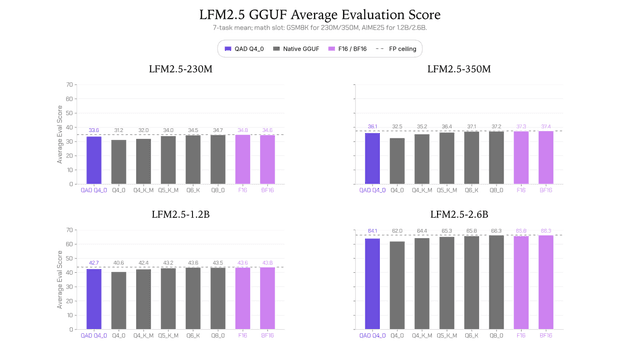
Liquid AI เปิดตัว Checkpoints LFM2.5 Q4_0 ที่ผ่านการเทรนด้วย Quantization-Aware Distillationtag: Edge AI, GGUF, LFM2.5, Liquid AI, QuantizationAug 19, 2026 · By: SirilukPLiquid AI เปิดตัวโมเดล LFM2.5 ในรูปแบบ GGUF 4-bit ที่ใช้เทคนิค Quantization-Aware Distillation (QAD) ช่วยให้คงประสิทธิภาพได้สูงถึง 97% ของรุ่น BF16 เดิม แต่ยังประหยัดหน่วยความจำและทำงานได้รวดเร็วตามมาตรฐาน Q4_0
Liquid AI เปิดตัว LFM2.5 Encoder รุ่นใหม่ โดดเด่นด้วยความเร็วระดับ 8K แม้ประมวลผลบน CPUtag: Encoder, LFM2.5, Liquid AI, Machine Learning, Open-weightJul 30, 2026 · By: AttapolKLiquid AI เปิดตัว LFM2.5-Encoder-230M และ 350M โมเดล Bidirectional Encoder แบบ open-weight ที่รองรับ Context สูงถึง 8,192 โทเค็น โดยรุ่น 350M ทำคะแนนทดสอบเป็นอันดับ 4 ของโลกเมื่อเทียบกับโมเดลกลุ่มเดียวกัน