
Liquid AI เปิดตัว Checkpoints LFM2.5 Q4_0 ที่ผ่านการเทรนด้วย Quantization-Aware Distillation
Liquid AI ประกาศเปิดตัว QAD Q4_0 GGUFs ซึ่งเป็น checkpoint แบบ 4-bit รุ่นอัปเดตใหม่สำหรับโมเดลตระกูล LFM2.5 ทั้งสี่รุ่น ได้แก่ LFM2.5-230M, LFM2.5-350M, LFM2.5-1.2B-Instruct และ LFM2.5-2.6B เพื่อให้นักพัฒนาสามารถรันโมเดลด้วยความเร็วและใช้หน่วยความจำในระดับ Q4_0 ได้ โดยไม่ต้องยอมแลกกับคุณภาพที่ลดลงเหมือนกระบวนการทั่วไป
หัวใจสำคัญของเทคโนโลยีนี้คือการใช้ Quantization-Aware Distillation (QAD) ซึ่งเป็นการกลั่นกรองความรู้ (distilled) จากโมเดลต้นแบบ (teacher) ที่มีความแม่นยำสูงลงสู่โมเดลขนาดเล็ก (student) ที่ผ่านการทำ quantization ผลลัพธ์ที่ได้คือโมเดลที่ยังคงรักษาพื้นที่การใช้หน่วยความจำต่ำและมี throughput สูงตามมาตรฐาน Q4_0 GGUFs ดั้งเดิม แต่สามารถกู้คืนความแม่นยำเฉลี่ยที่เคยสูญเสียไปจากการทำ quantization ได้สูงถึง 97% เมื่อเทียบกับแบบ BF16
ผลลัพธ์ Benchmark
ในการทดสอบประสิทธิภาพ ทีมงานได้เปรียบเทียบ GGUF รุ่นเดิมที่ใช้เทคนิค post-training quantization (PTQ) กับ checkpoint QAD Q4_0 ใหม่ ผ่านชุดทดสอบที่ครอบคลุมทั้งด้านการใช้เหตุผล การทำตามคำสั่ง การใช้เครื่องมือ และความสามารถด้าน agentic เช่น GPQA Diamond, MMLU-Pro, IFEval และ BFCLv4 โดยใช้ BF16 GGUF เป็นเกณฑ์มาตรฐานสูงสุด นอกจากนี้ยังมีการทดสอบด้านคณิตศาสตร์ผ่าน GSM8K สำหรับรุ่นเล็ก และ AIME25 สำหรับรุ่นใหญ่อีกด้วย
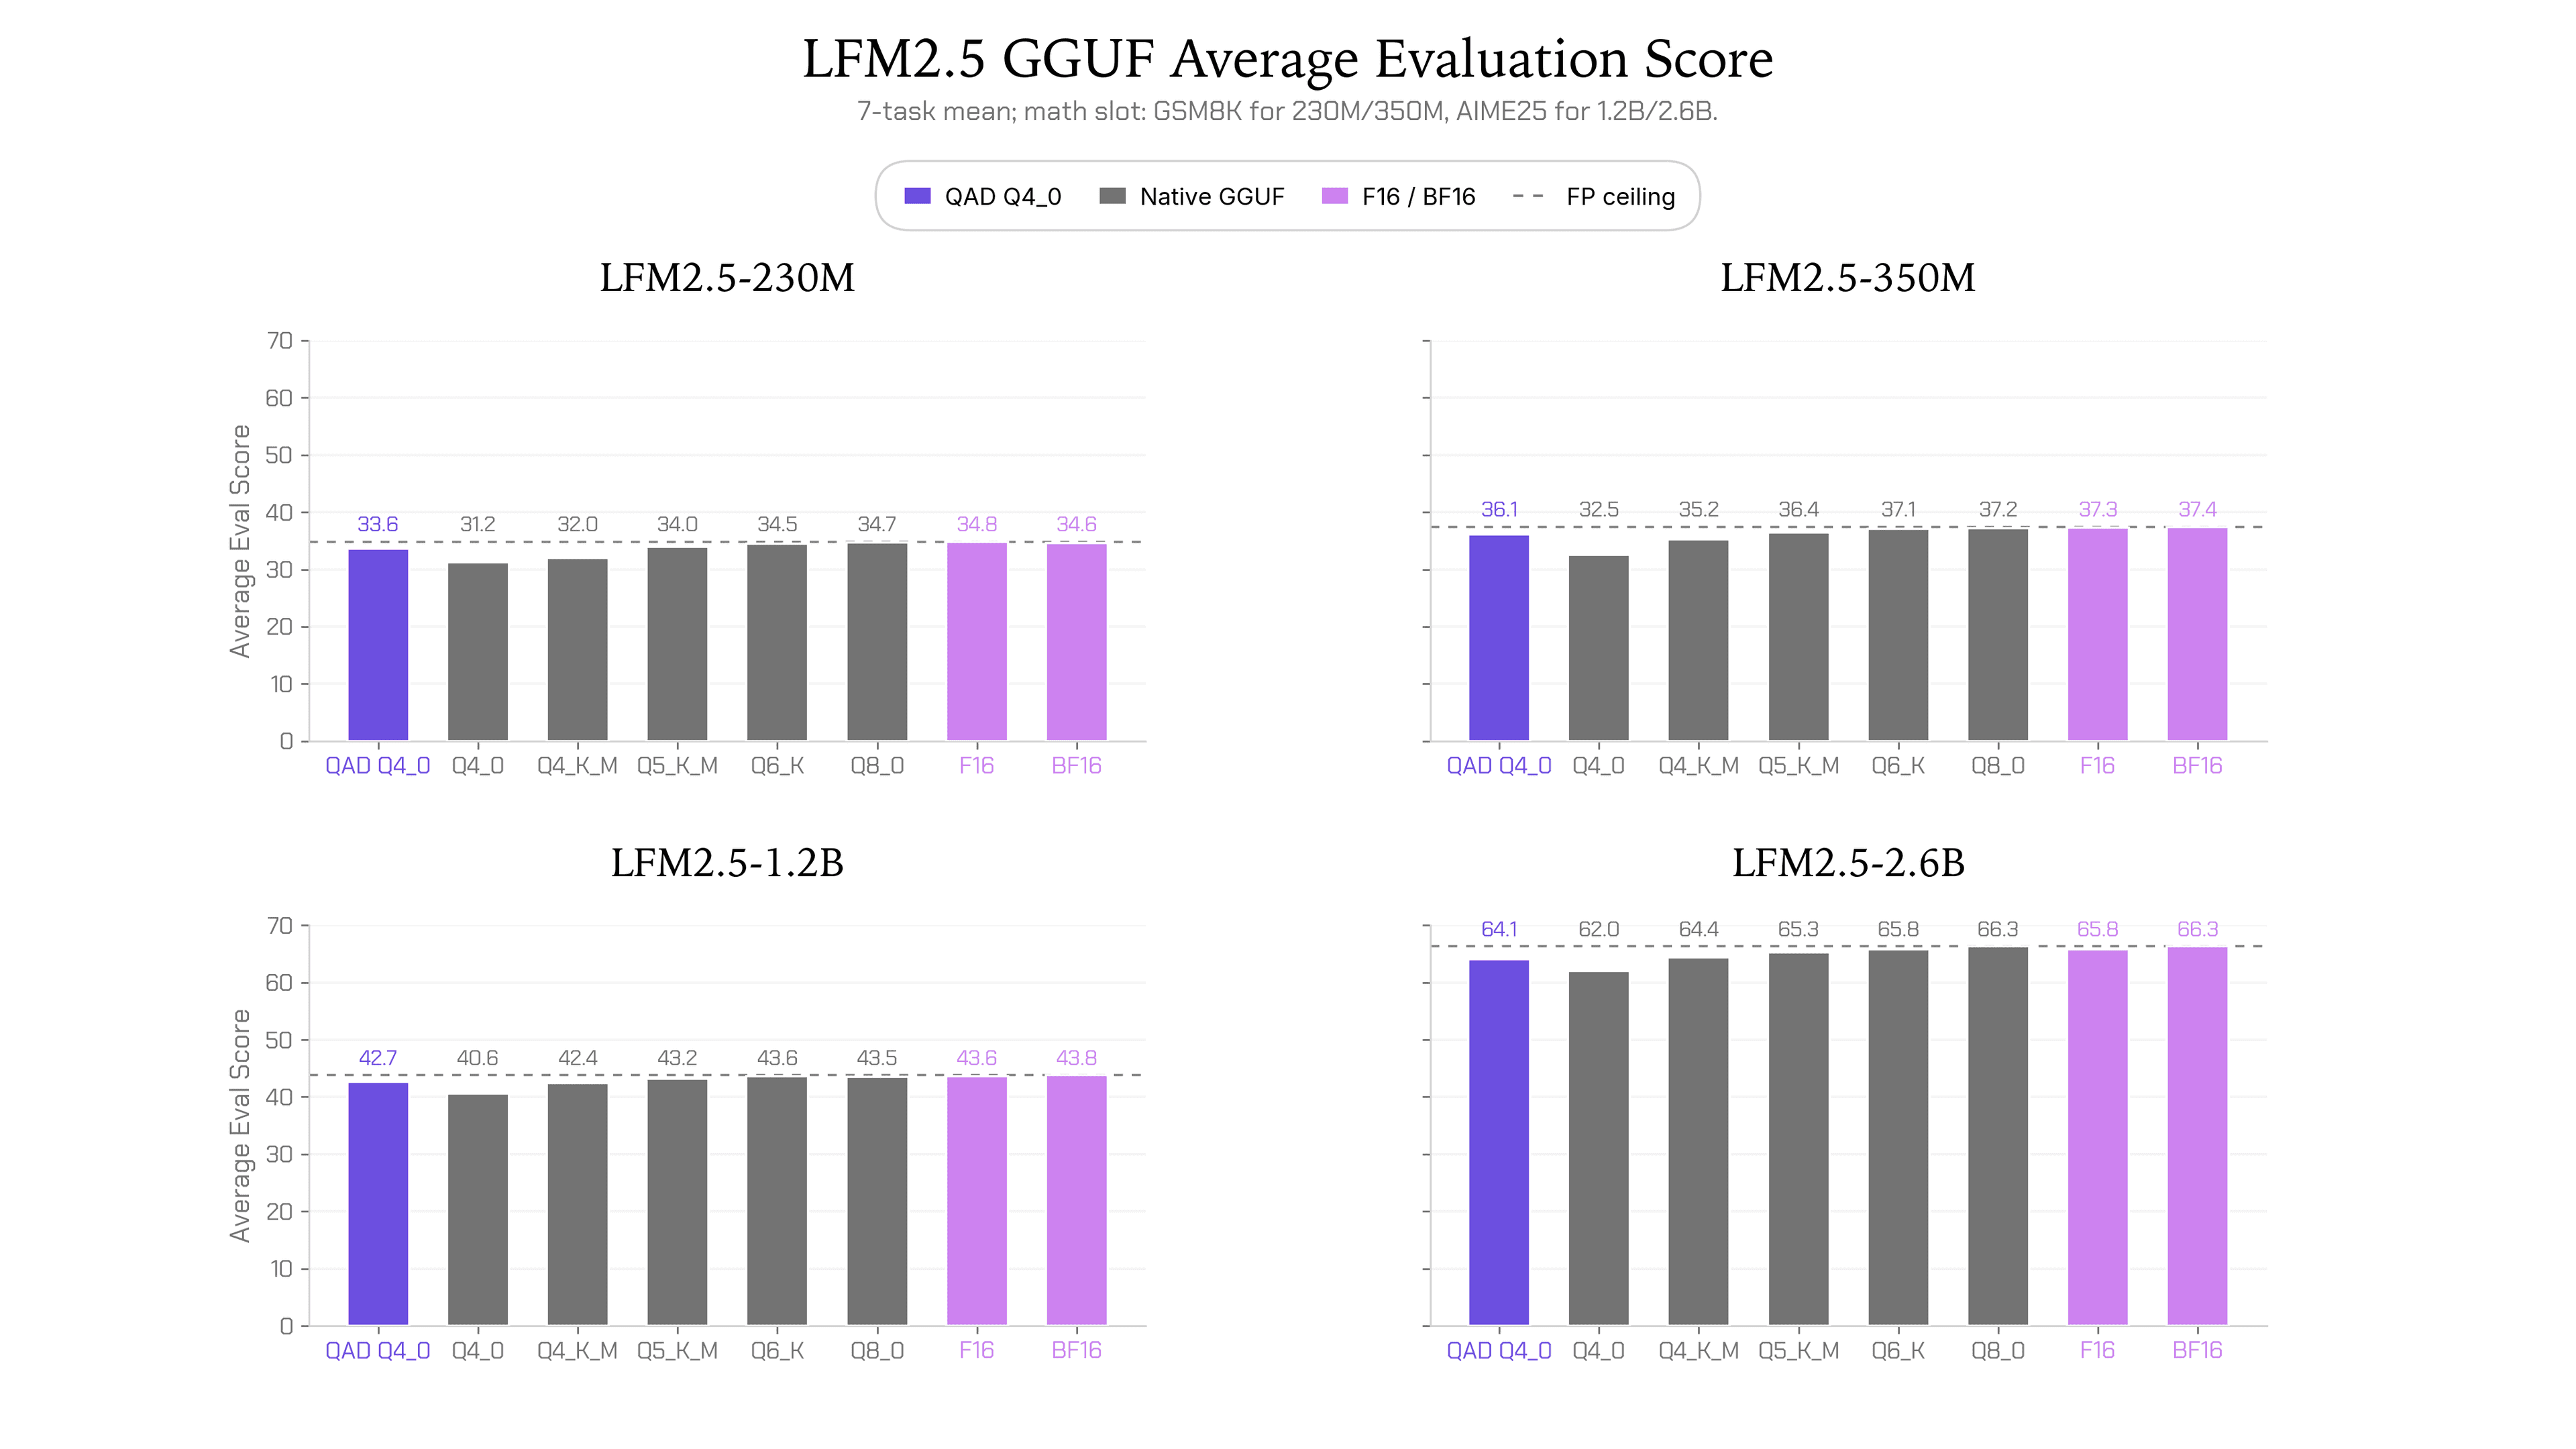
ผลการทดสอบพบว่า QAD ช่วยปรับปรุงประสิทธิภาพของ checkpoint Q4_0 ได้อย่างมีนัยสำคัญในทุกรุ่น โดยสามารถรักษาประสิทธิภาพไว้ได้สูงถึง 97.1%, 96.5%, 97.4% และ 96.6% ของประสิทธิภาพพื้นฐานแบบ BF16 ตามลำดับ ซึ่งถือเป็นก้าวกระโดดที่สำคัญสำหรับการนำโมเดลไปใช้งานจริง
ความเร็วและขนาดบนฮาร์ดแวร์ Edge จริง
สำหรับการทดสอบความเร็วในการประมวลผล (decode throughput) ทีมงานได้ทดลองบนอุปกรณ์ Edge สี่ประเภท ได้แก่ MacBook Pro และ NucBox EVO-X2 ที่ใช้ GPU รวมถึง Samsung Galaxy S26 Ultra และ Raspberry Pi 5 ที่ประมวลผลผ่าน Arm CPU เพื่อแสดงให้เห็นถึงการใช้งานในสภาพแวดล้อมที่หลากหลาย
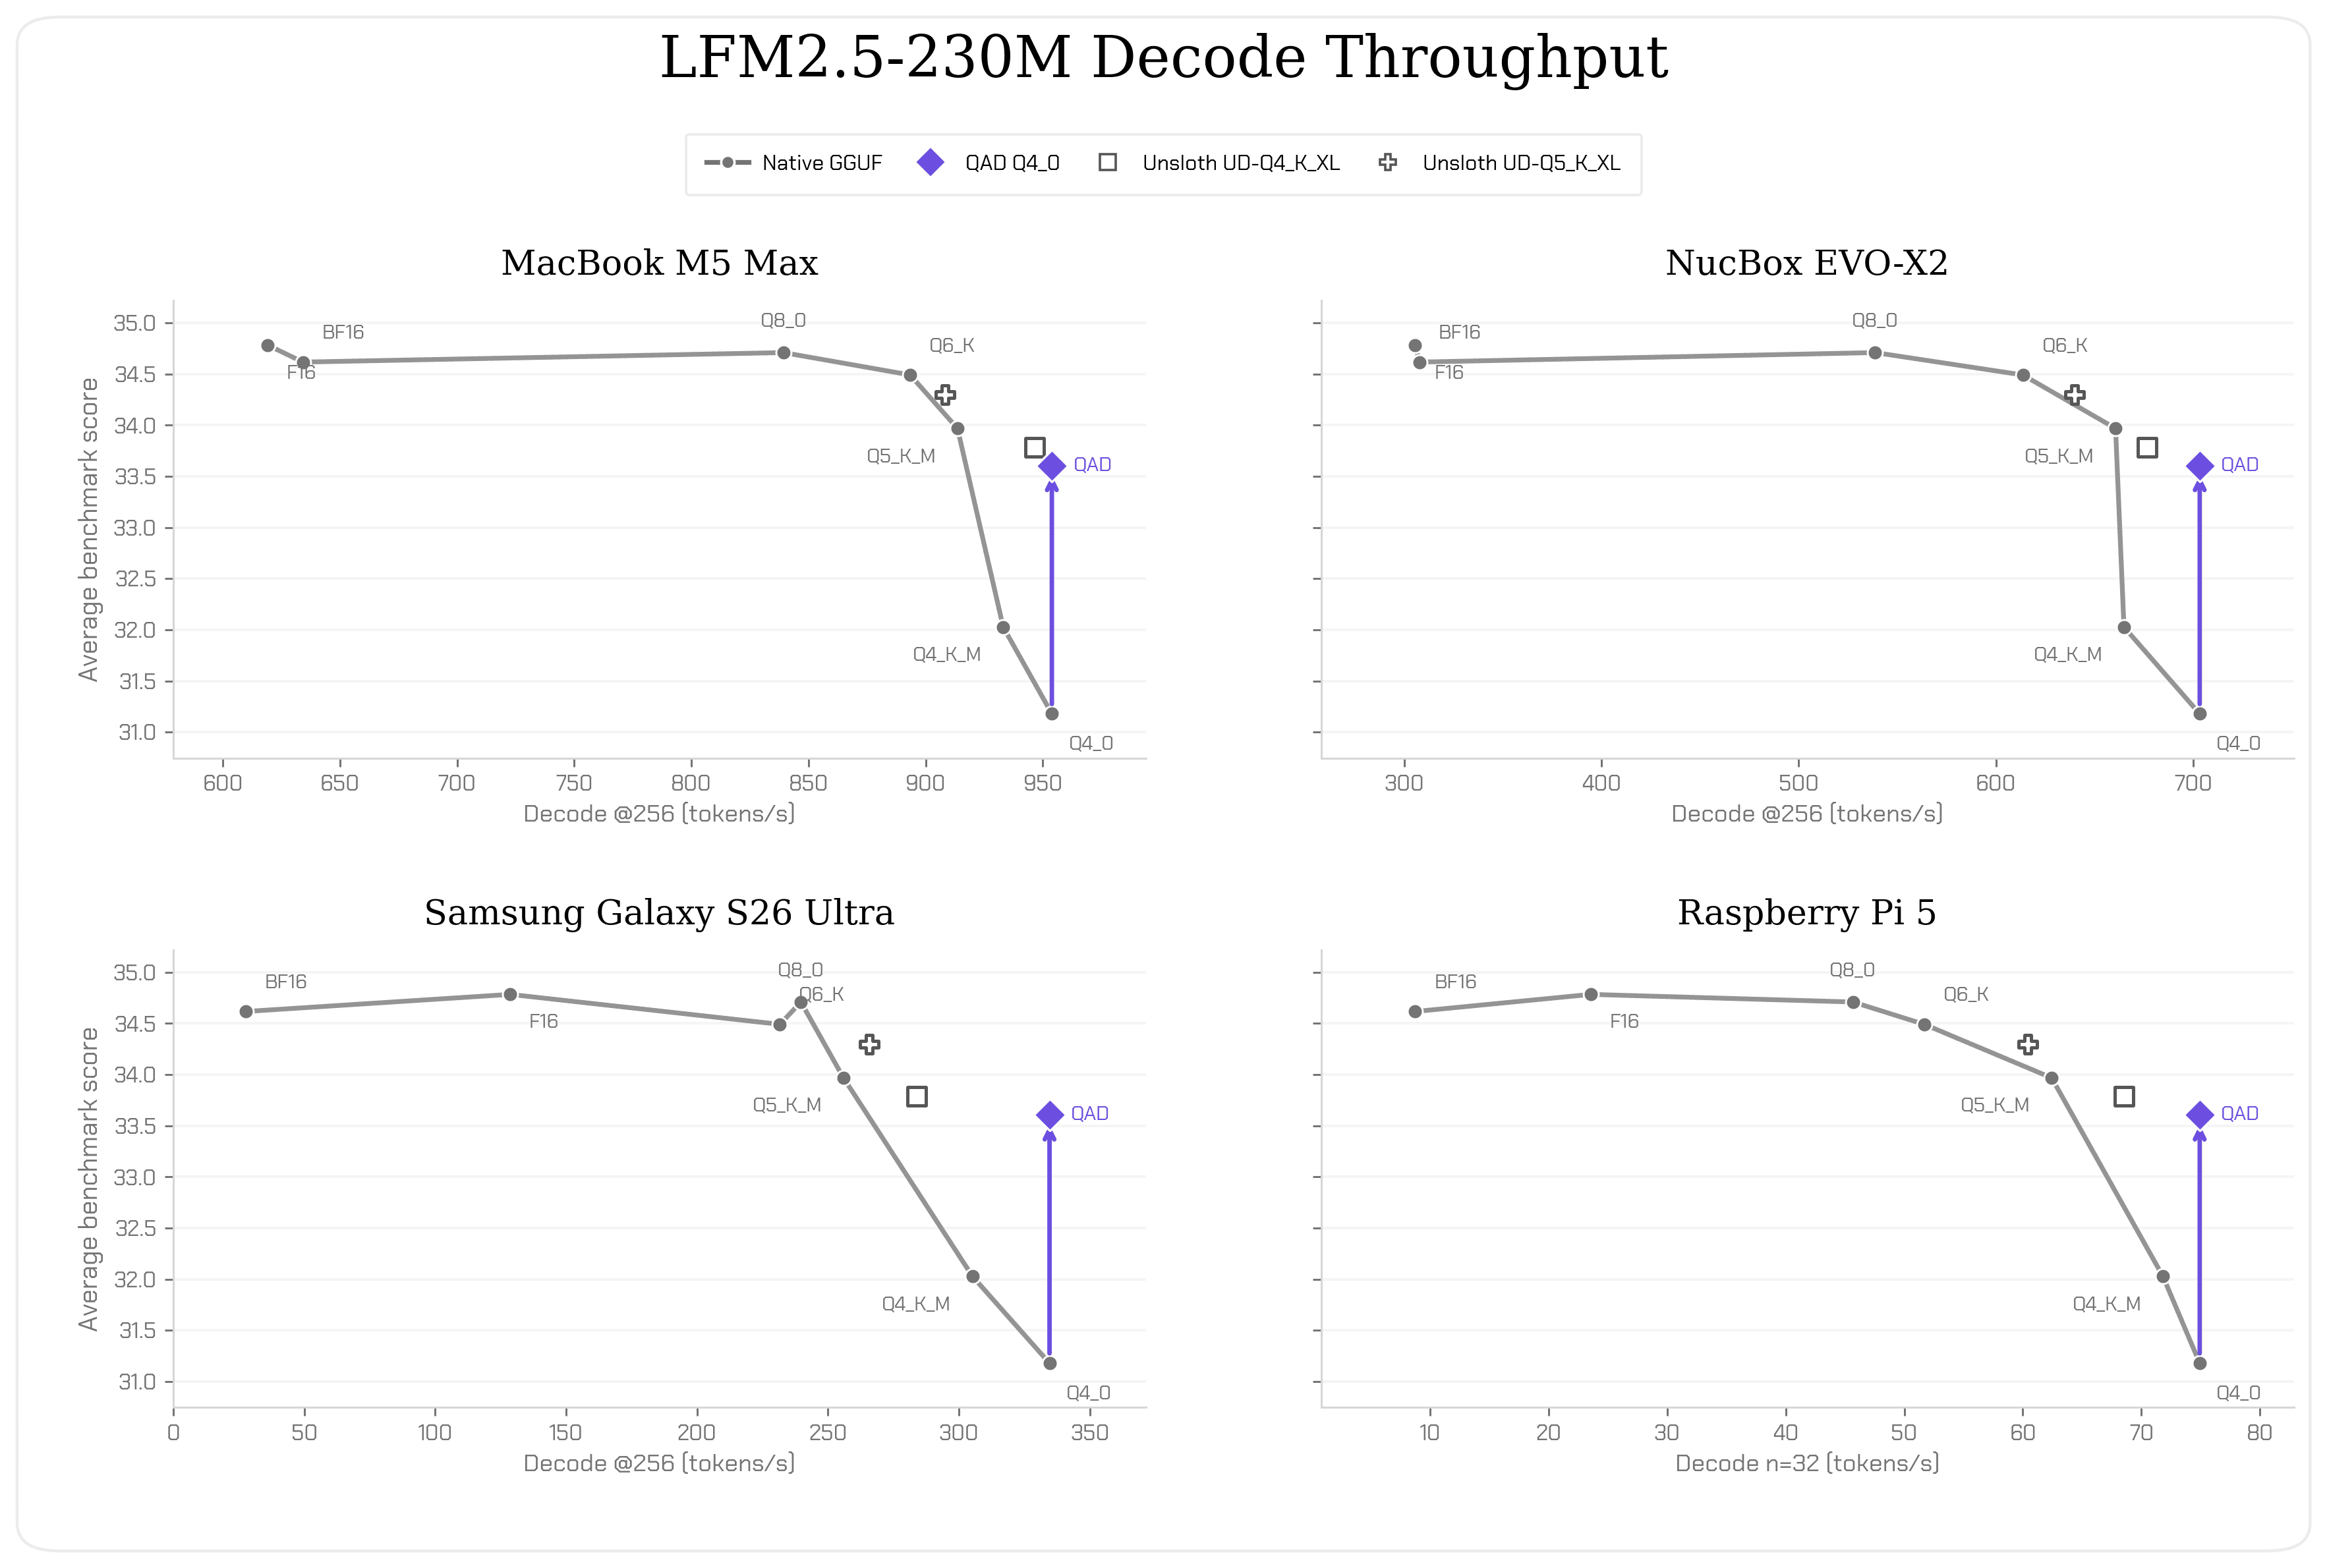
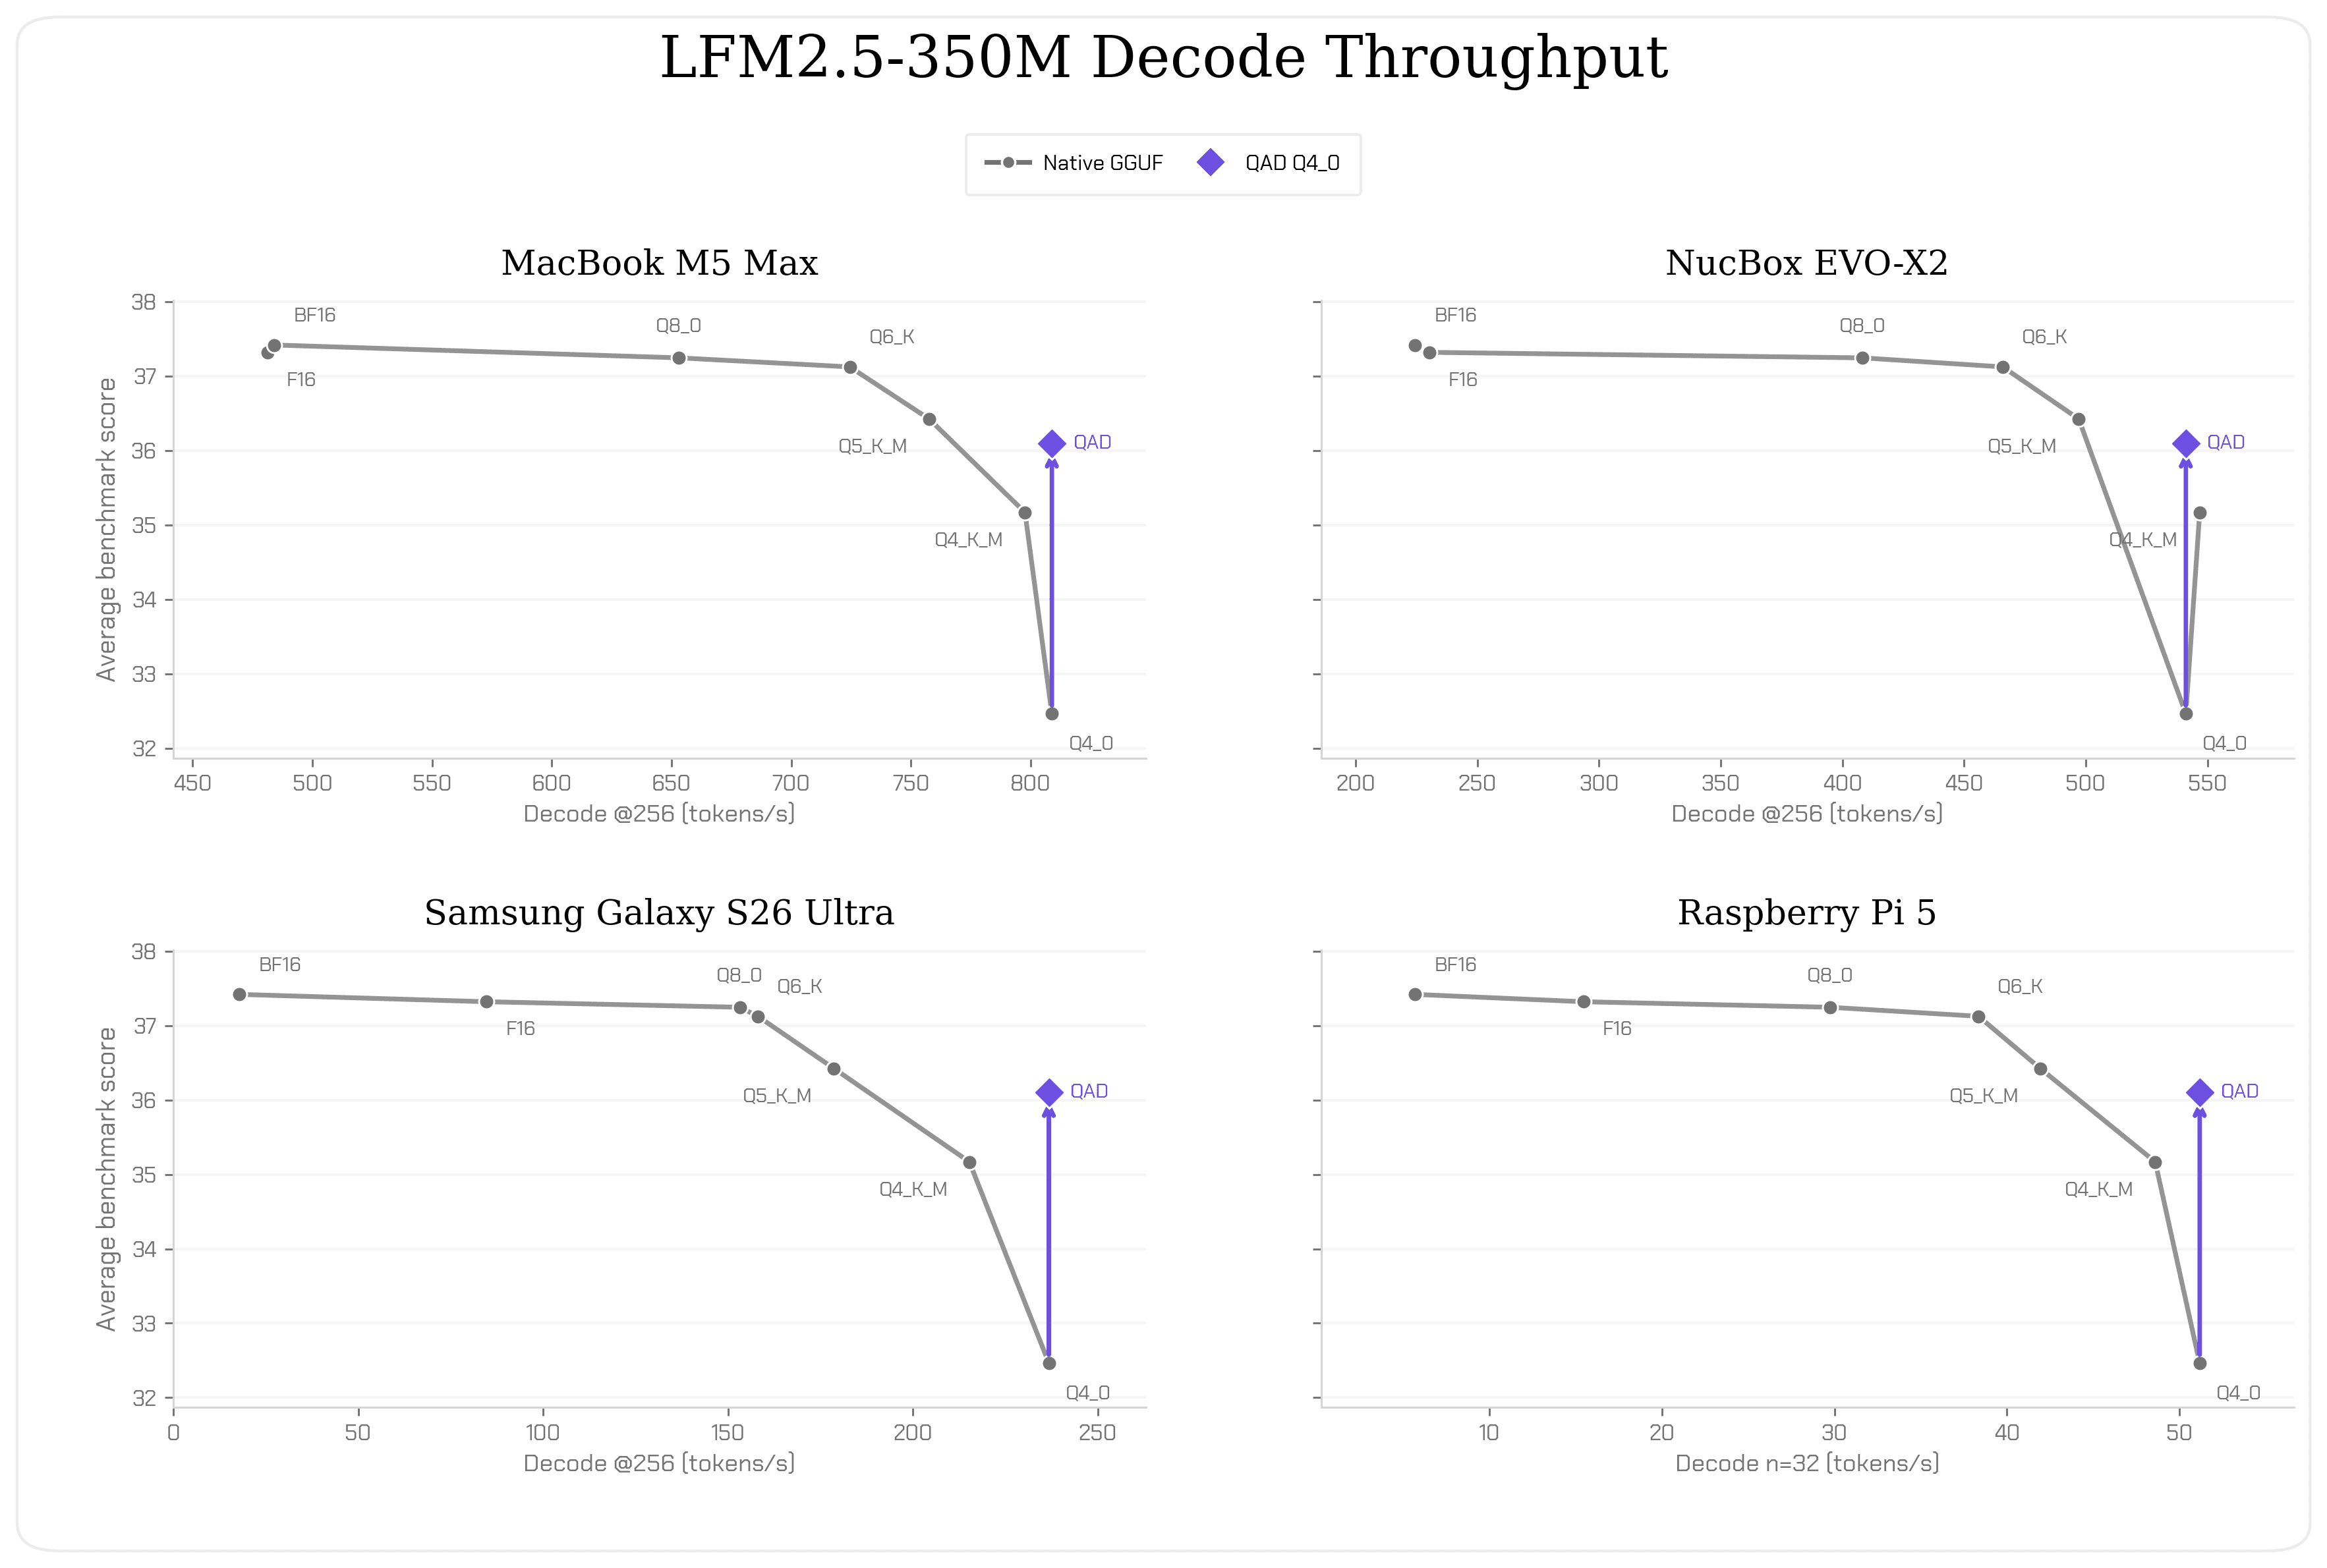
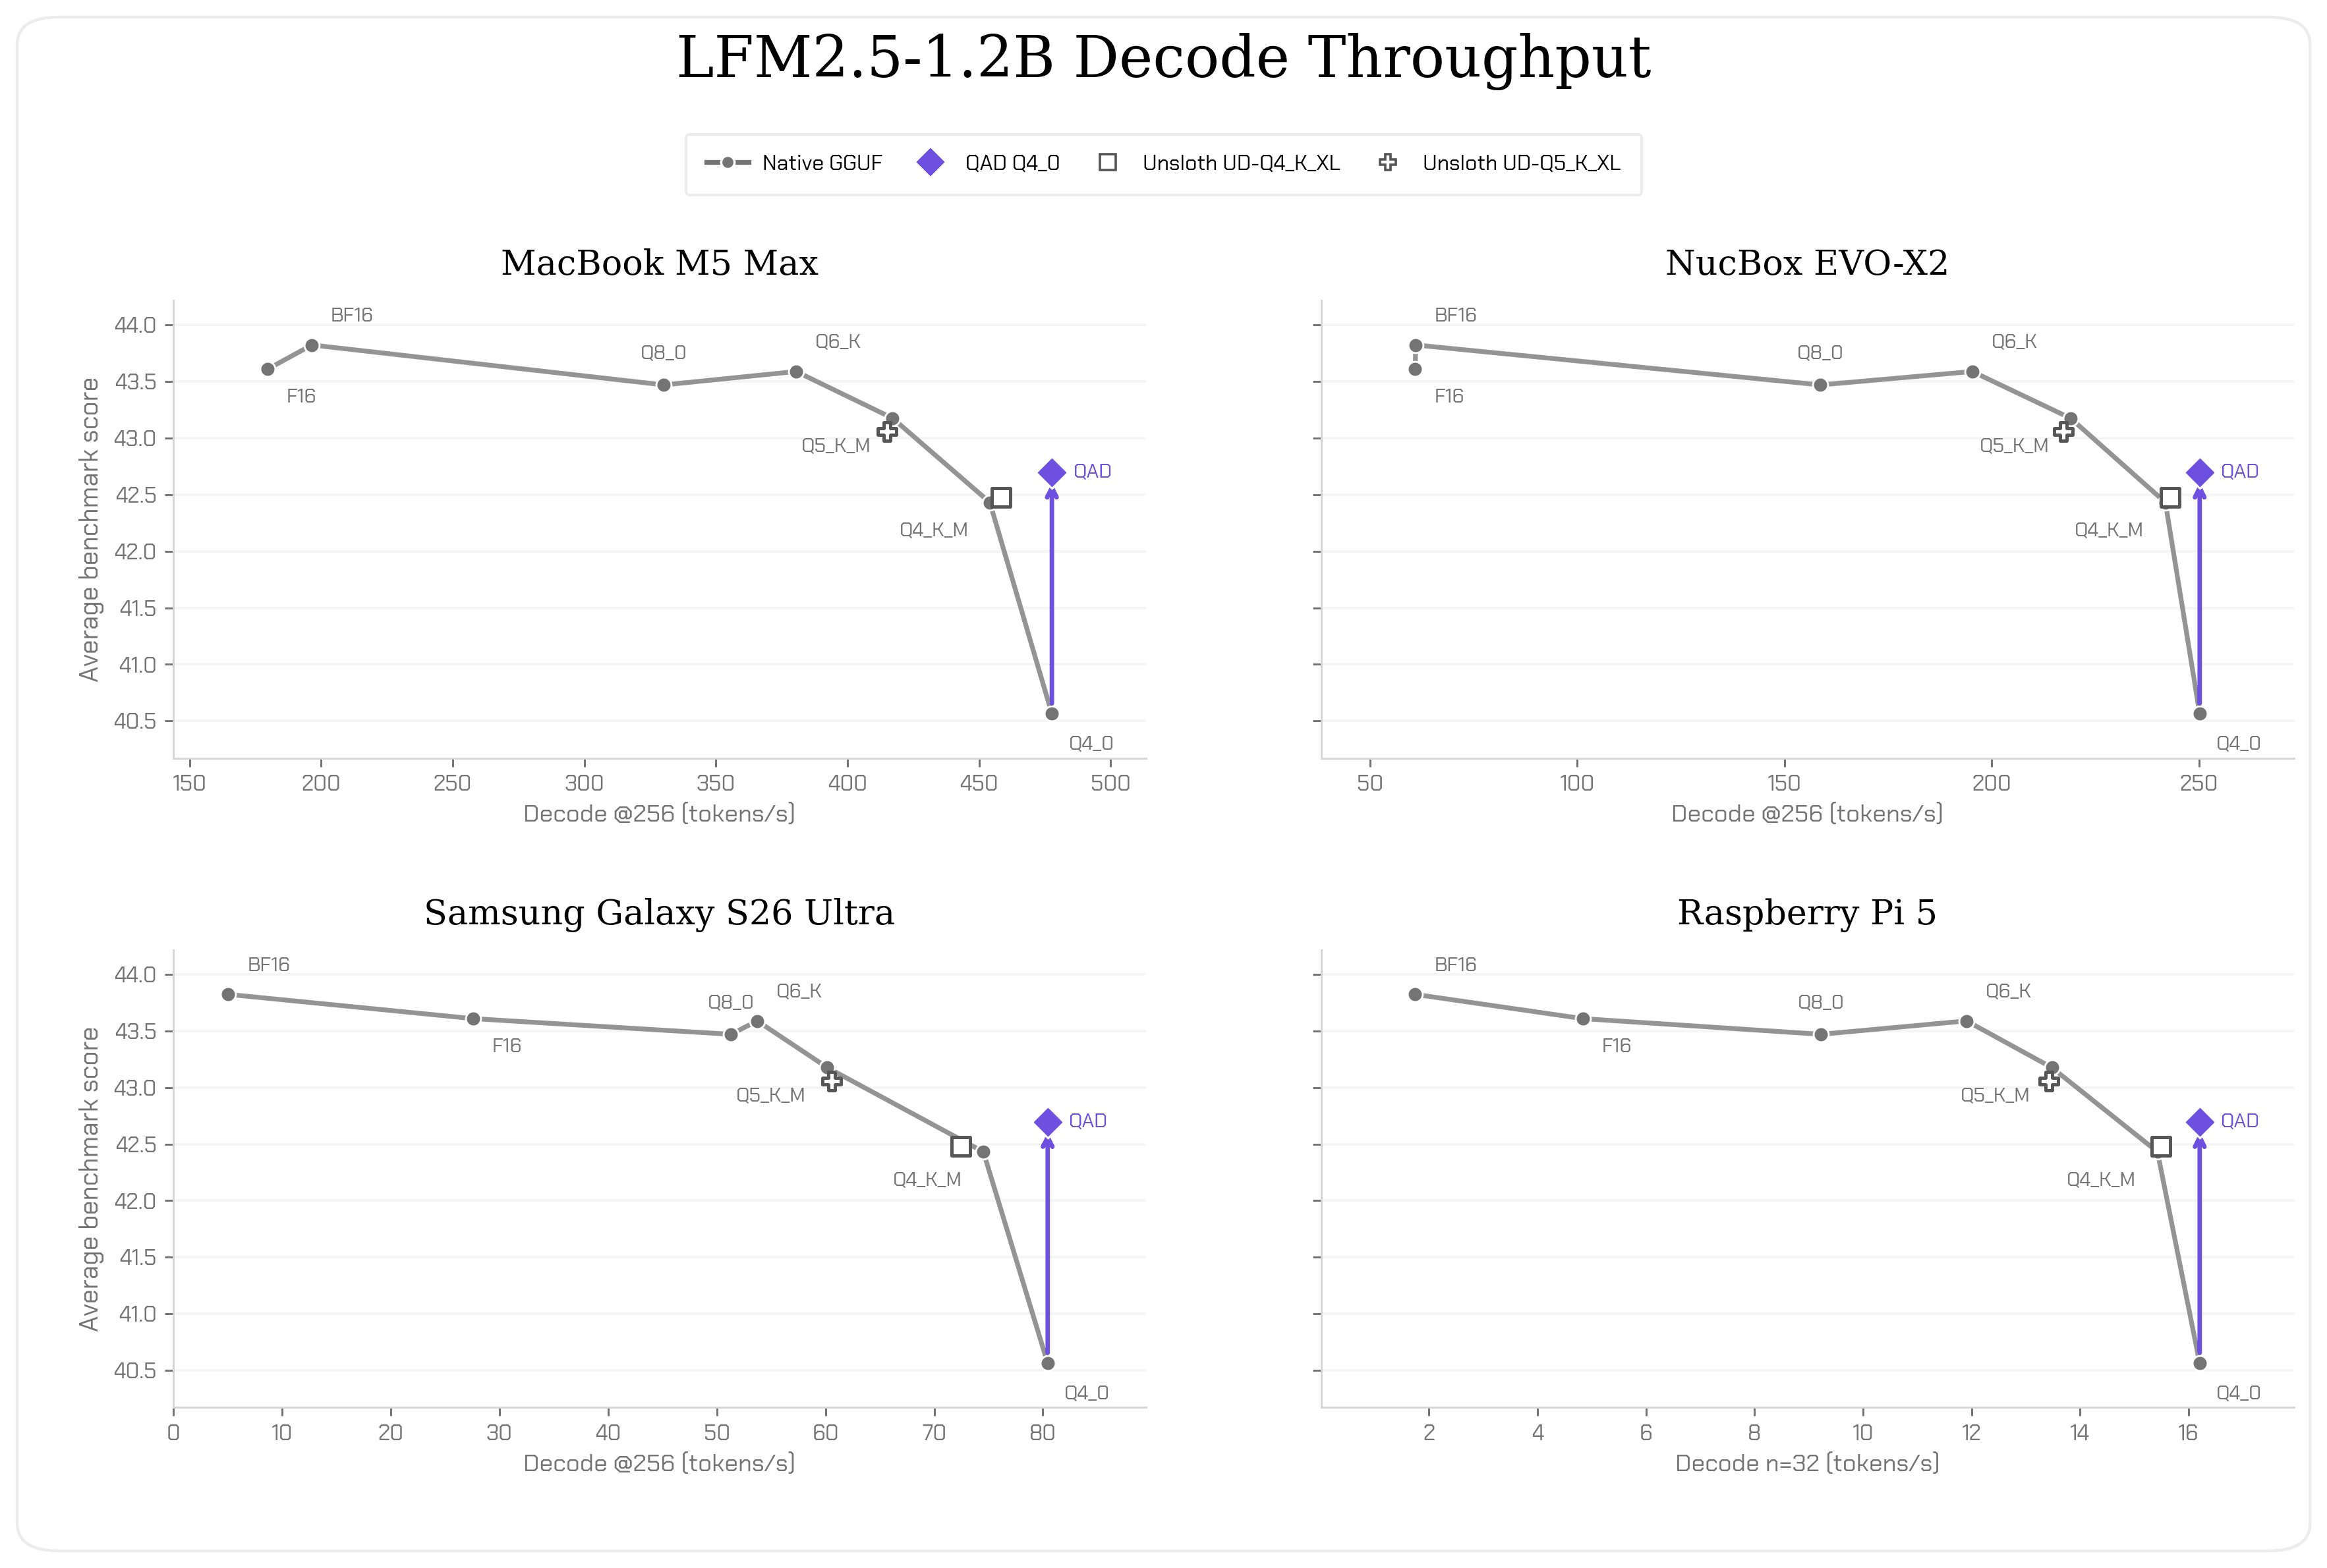
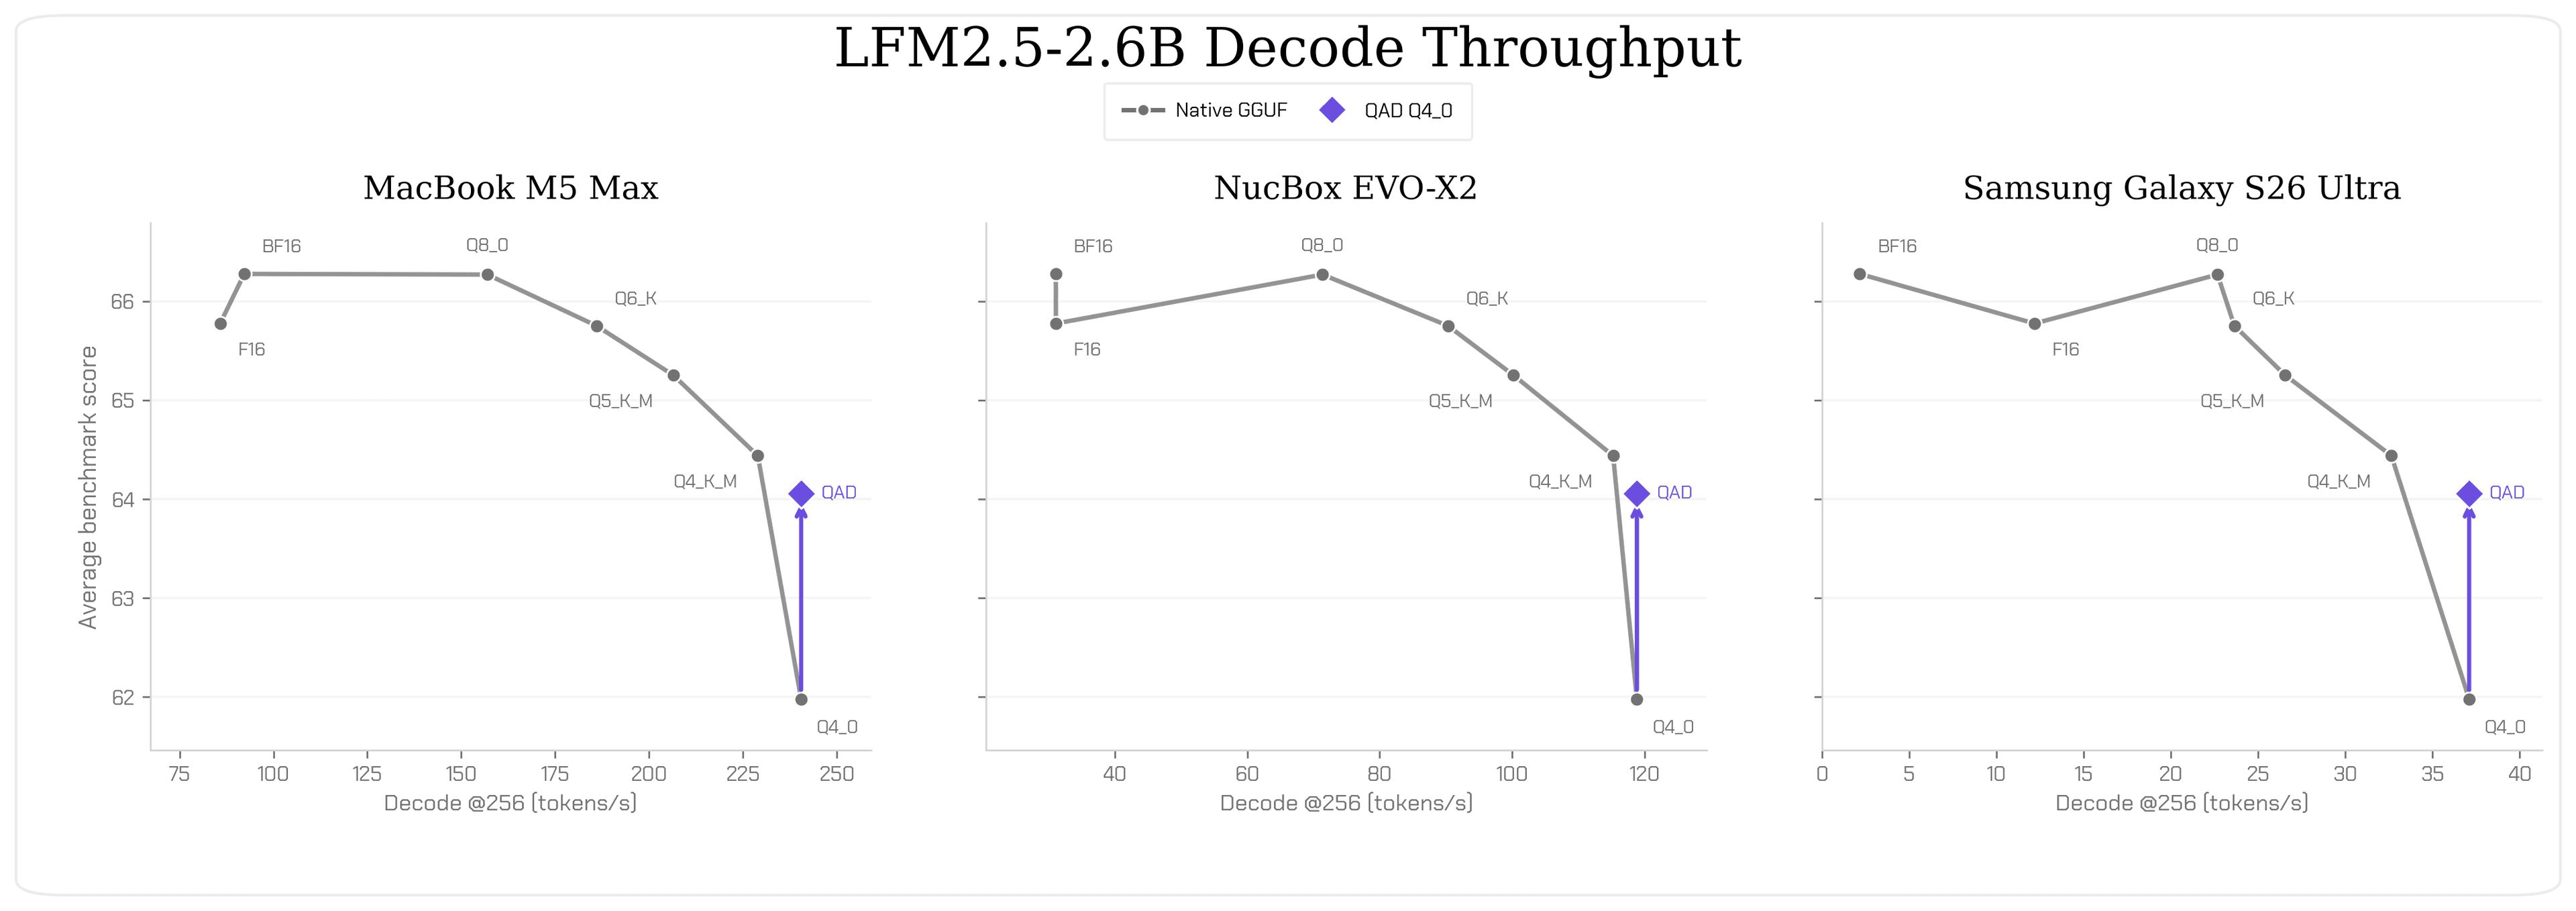
ผลการวัดผลระบุว่าโมเดลรุ่น 230M และ 350M ที่ใช้ QAD Q4_0 มีคุณภาพเทียบเท่ากับ Q5_K_M แต่ให้ความเร็วสูงกว่า 4-33% ขณะที่รุ่น 1.2B และ 2.6B ให้คุณภาพเทียบเท่า Q4_K_M โดยมีความเร็วสูงกว่า 3-14% นอกจากนี้ยังมีประสิทธิภาพทัดเทียมกับ UD-Q4_K_XL ของ Unsloth ซึ่งเป็นโซลูชันภายนอกที่ได้รับการยอมรับในระดับสูง
วิธีใช้งาน QAD GGUFs
นักพัฒนาสามารถใช้งานไฟล์เหล่านี้ผ่าน llama.cpp หรือ runtime ใดๆ ที่รองรับมาตรฐานไฟล์ GGUF Q4_0 ได้ทันทีผ่านคำสั่งตัวอย่างดังนี้:
llama-cli -hf LiquidAI/LFM2.5-350M \
  --hf-file LFM2.5-350M-QAD-Q4_0.gguf \
  -p "What is C. elegans?"
เริ่มต้นใช้งาน QAD GGUFs
ปัจจุบัน QAD GGUFs เปิดให้ดาวน์โหลดแล้วบน Hugging Face สำหรับทุกขนาดโมเดล: LFM2.5-230M, LFM2.5-350M, LFM2.5-1.2B-Instruct, และ LFM2.5-2.6B
การอ้างอิง
สำหรับการอ้างอิงเชิงวิชาการ โปรดใช้ข้อมูลหรือ BibTeX ดังต่อไปนี้:
Liquid AI, "LFM2.5 Q4_0: Quantization-Aware Distillation for Edge Deployment", Liquid AI Blog, Aug 2026.หรือใช้การอ้างอิงแบบ BibTeX
@article{liquidAI2026Q40,
  author = {Liquid AI},
  title = {LFM2.5 Q4_0: Quantization-Aware Distillation for Edge Deployment},
  journal = {Liquid AI Blog},
  year = {2026},
  note = {www.liquid.ai/blog/qad},
}ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร