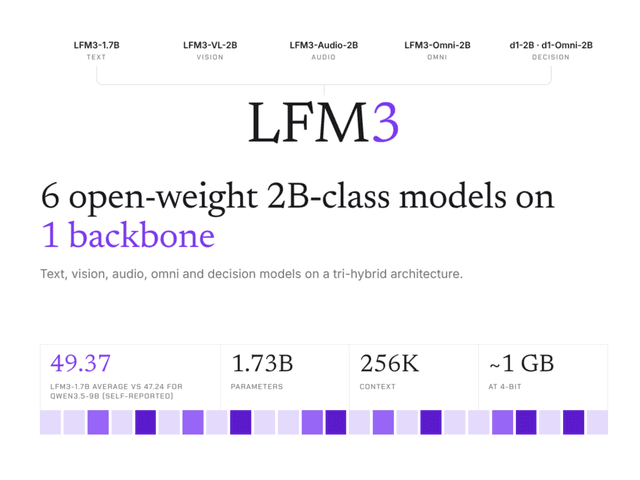
Liquid AI เปิดตัว LFM3 ตระกูลโมเดล 2B แบบ Open-Weight ถึง 6 รุ่นtag: Edge AI, LFM3, Liquid AI, Multimodal, Open-weightOct 28, 2026 · By: NatapolKสรุปข่าว 1:27Liquid AI ปล่อย LFM3 โมเดลขนาดกะทัดรัดระดับ 2B จำนวน 6 รุ่นที่รองรับทั้งข้อความ ภาพ และเสียง โดดเด่นด้วยการใช้หน่วยความจำเพียง 1 GB และรองรับ Context Window สูงถึง 256K
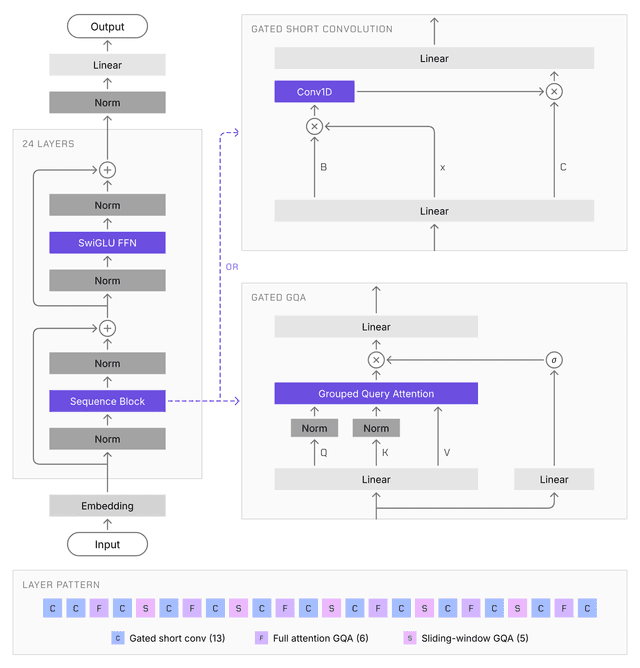
Liquid AI เปิดตัว LFM3 โมเดล Multimodal เฉพาะทางขนาด 2Btag: Edge AI, LFM3, Liquid AI, Multimodal, Open-Source, RoboticsOct 28, 2026 · By: SirilukPสรุปข่าว 1:15Liquid Foundation Models (LFMs) รุ่นล่าสุดมาพร้อม 6 โมเดลย่อยที่ครอบคลุมข้อความ ภาพ และเสียง บน backbone เดียวกัน ชูจุดเด่นด้านประสิทธิภาพสูงบนอุปกรณ์ Edge และรองรับการ Fine-tune ด้วย GPU เพียงตัวเดียว
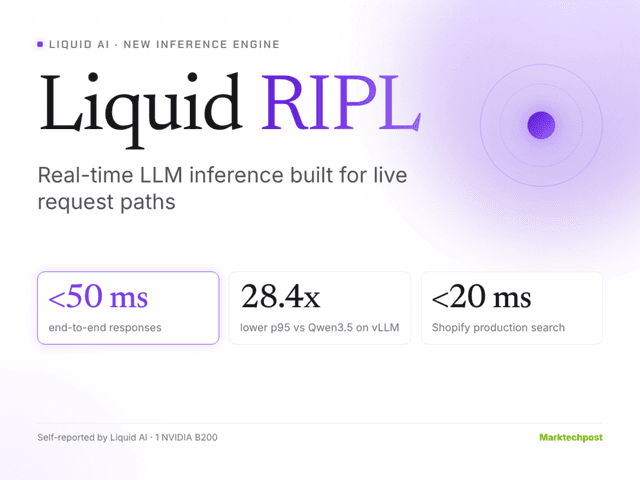
Liquid AI เปิดตัว RIPL เอ็นจิน Inference เรียลไทม์ เร็วกว่า vLLM สูงสุด 28 เท่าtag: Inference Engine, LFM2.5, Liquid AI, NVIDIA B200, RIPL, ShopifyOct 23, 2026 · By: SirilukPสรุปข่าว 1:29Liquid AI เปิดตัว RIPL เอ็นจินสำหรับโมเดล LFM ที่ทำความหน่วงต่ำกว่า 50 ms โดยผลทดสอบบน NVIDIA B200 พบว่าเร็วกว่าการรัน Qwen3.5 บน vLLM สูงสุดถึง 28.4 เท่า
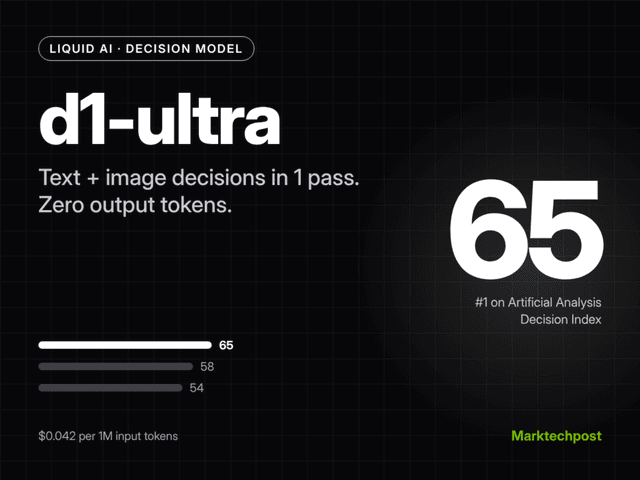
Liquid AI เปิดตัว d1-ultra โมเดลตัดสินใจ Multimodal ทุบสถิติใหม่tag: Artificial Analysis, d1-ultra, Decision Model, Liquid AI, Multimodal AIOct 16, 2026 · By: AttapolKสรุปข่าว 1:31Liquid AI เปิดตัว d1-ultra โมเดลตัดสินใจสำหรับข้อความและรูปภาพที่รันแบบ one forward pass โดยไม่ต้องสร้าง output tokens ทำคะแนนสูงสุดอันดับ 1 บน Artificial Analysis Decision Index
Liquid AI เปิดตัว LFM2.5-24B-A2B โมเดล MoE ประสิทธิภาพสูงสำหรับ Agenttag: LFM2.5-24B-A2B, Liquid AI, Mixture-of-Experts, On-device AI, OpenClawOct 14, 2026 · By: AttapolKสรุปข่าว 1:18Liquid AI เปิดตัวโมเดล LFM2.5-24B-A2B ขนาด 24B ที่ทำงานจริงเพียง 2B พารามิเตอร์ ชูจุดเด่นด้านการให้เหตุผลบนอุปกรณ์ (On-Device) พร้อมความเร็วถอดรหัสสูงสุด 184 tokens/s บน Apple M5 Max
LFM2.5-24B-A2B โมเดลจิ๋วแต่แจ๋ว รัน Agent ส่วนตัวได้เร็วแรงtag: AI Agent, LFM2.5-24B-A2B, Liquid AI, MoE, On-device AIOct 14, 2026 · By: SirilukPสรุปข่าว 1:23LFM2.5-24B-A2B เป็นโมเดลการให้เหตุผลขนาด 24B ที่มีพารามิเตอร์ทำงานจริงเพียง 2B ออกแบบมาเพื่อการทำงานของ agent ที่รวดเร็วและปลอดภัยบนอุปกรณ์ โดยให้ประสิทธิภาพเหนือกว่าโมเดลที่มีขนาดใหญ่กว่า
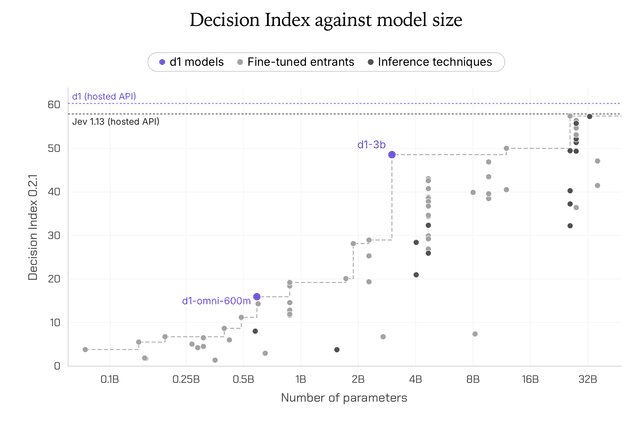
Liquid AI เปิดตัว Open d1 โมเดลตัดสินใจแบบ Multimodal ไร้ Output Tokentag: d1-3B, Decision Model, Liquid AI, Multimodal AI, NVIDIA Jetson, Open d1Oct 8, 2026 · By: NatapolKสรุปข่าว 1:12Liquid AI เปิดตัว Open d1 โมเดล Multimodal แบบ open-weight สองรุ่นใหม่ d1-3B และ d1-omni-600M ชูจุดเด่นการส่งคืนคำตอบแบบความน่าจะเป็นได้ทันทีโดยไม่ต้องสร้างข้อความ ช่วยให้ตัดสินใจได้แบบเรียลไทม์
Liquid AI เปิดตัว d1 โมเดลตัดสินใจแบบ Open Source สำหรับอุปกรณ์ Edgetag: d1-3B, Edge AI, Liquid AI, Multimodal, Open-SourceOct 8, 2026 · By: SirilukPสรุปข่าว 1:36Liquid AI เปิดตัวโมเดลการตัดสินใจ d1-3B และ d1-omni-600M แบบ open-weight ชูจุดเด่นประมวลผลบนอุปกรณ์ปลายทางได้รวดเร็วและแม่นยำ พร้อมรองรับข้อมูลทั้งข้อความ ภาพ และเสียง
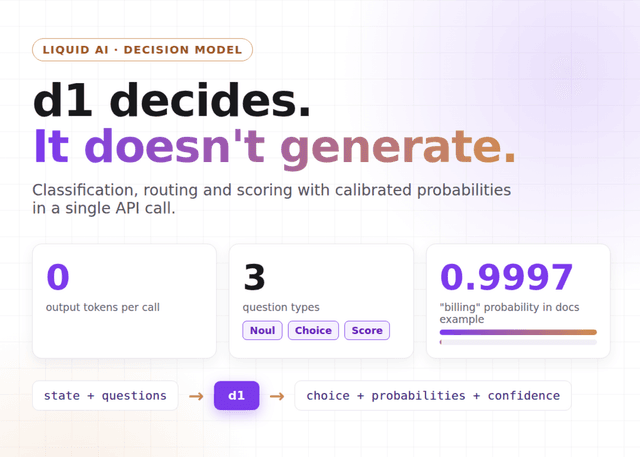
Liquid AI เปิดตัว d1 โมเดลการตัดสินใจคืนค่าความน่าจะเป็นแบบ 0 โทเคนtag: API, d1, Decision Model, Liquid AI, Machine LearningSep 30, 2026 · By: NatapolKสรุปข่าว 1:18Liquid AI เปิดตัว d1 โมเดลการตัดสินใจที่เน้นคืนค่าความน่าจะเป็นที่ปรับเทียบแล้ว (calibrated probabilities) แทนการสร้างข้อความ ช่วยลดต้นทุนเอาต์พุตและตัดปัญหา JSON ผิดรูปแบบ
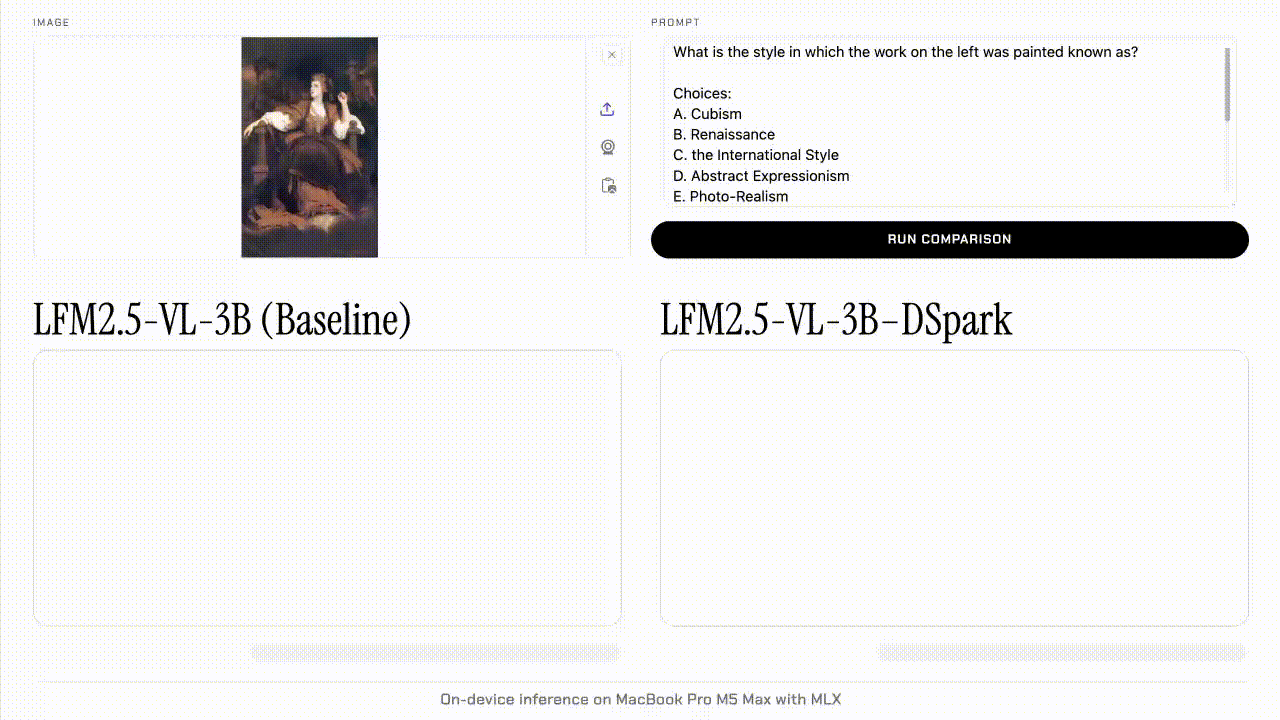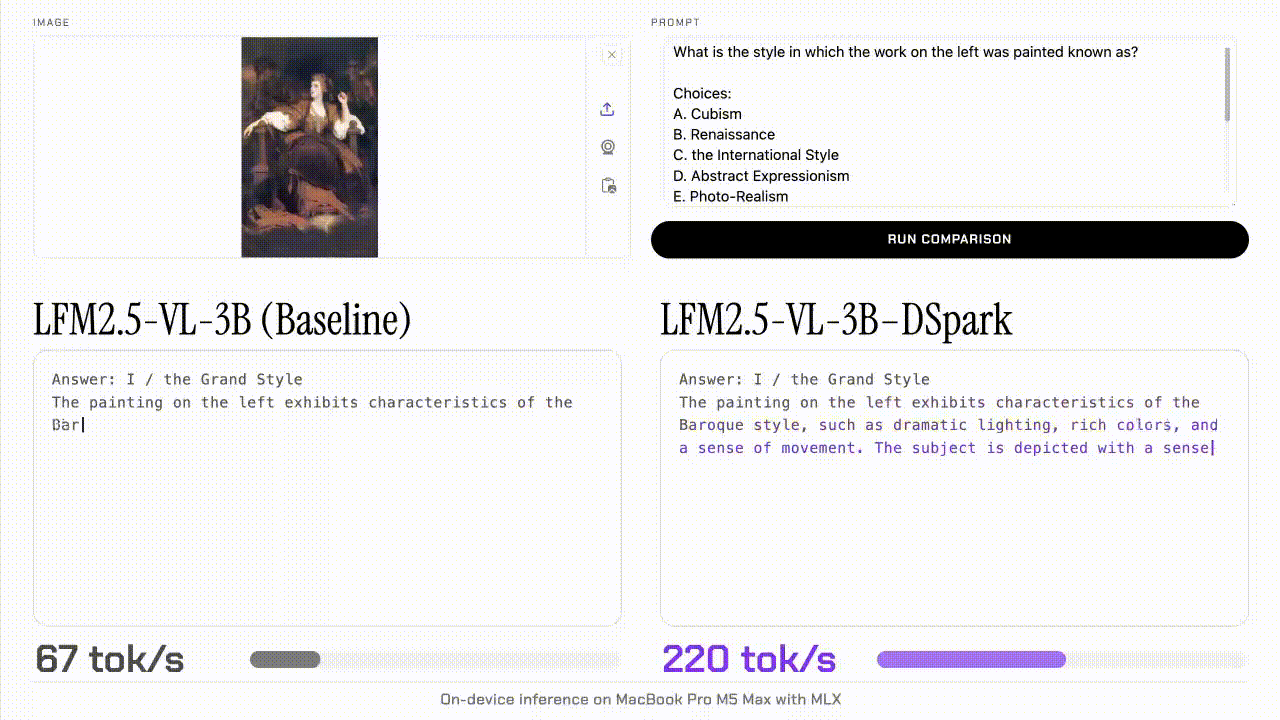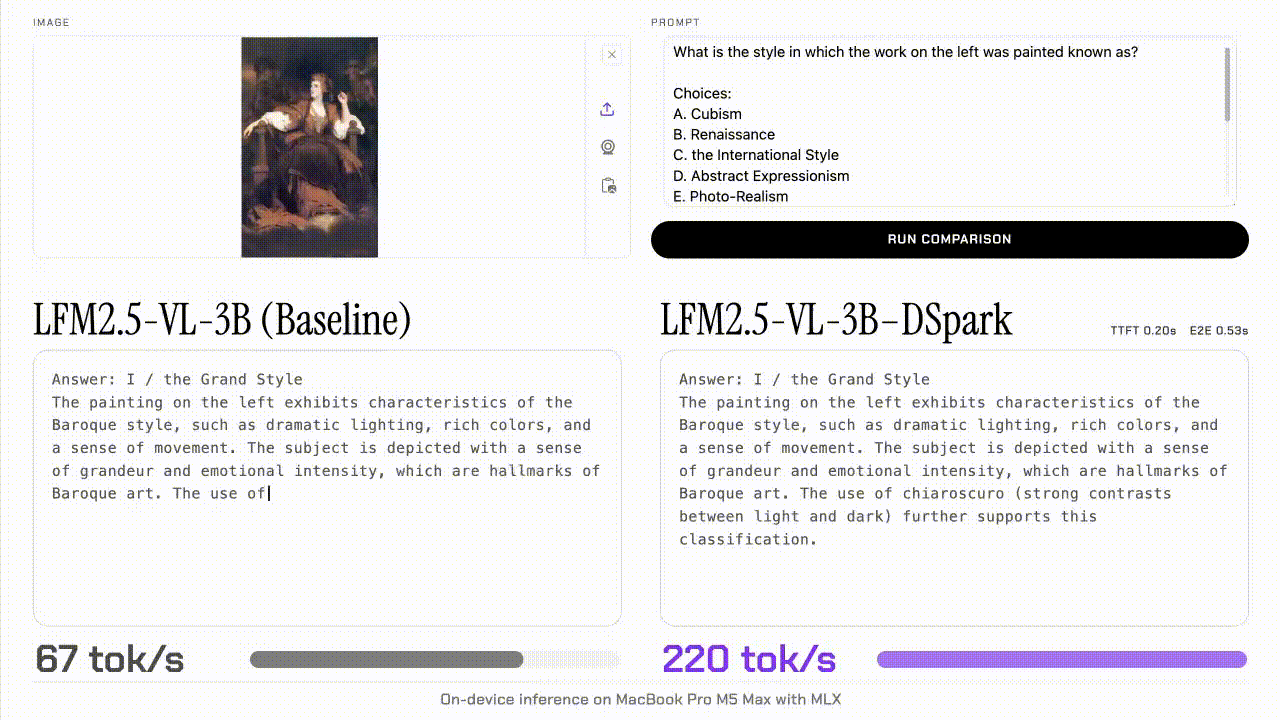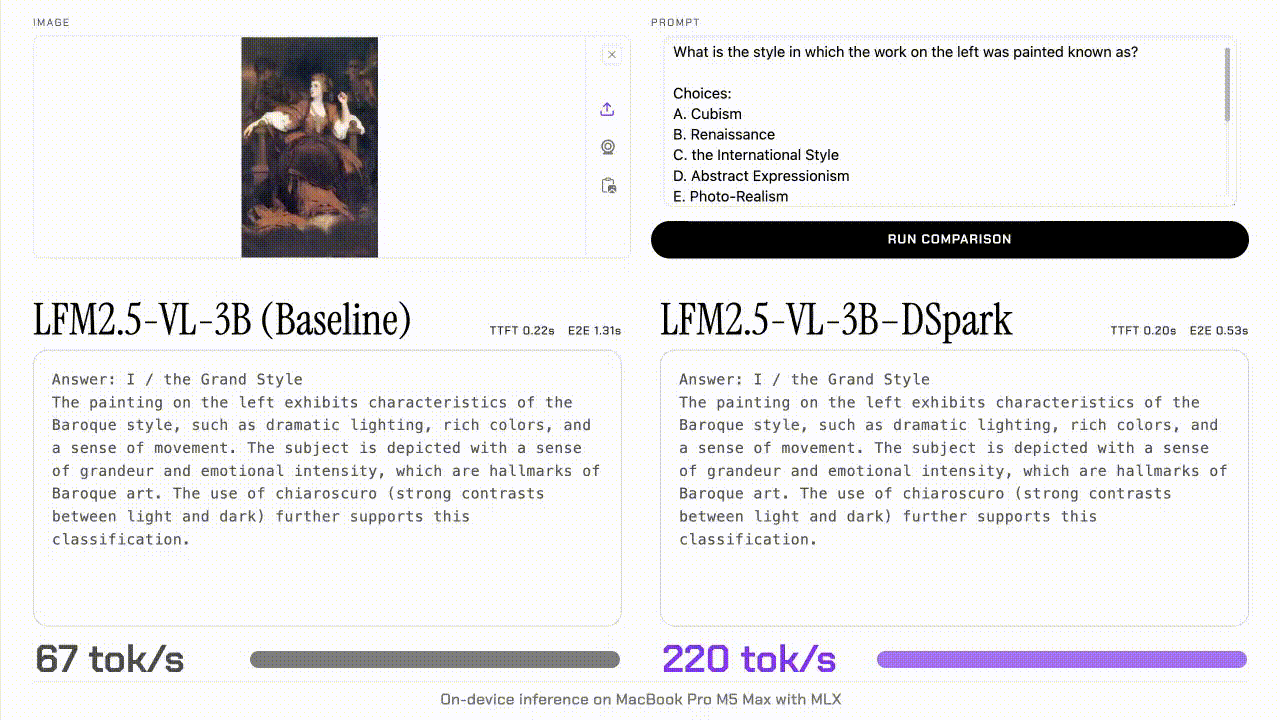
เร่งความเร็ว VLM ด้วย DSpark โมเดลร่างใหม่จาก Liquid AItag: DSpark, LFM2.5-VL, Liquid AI, Speculative Decoding, VLMSep 24, 2026 · By: SirilukPสรุปข่าว 1:18Liquid AI เปิดตัว DSpark รุ่นทดลองสำหรับ LFM2.5-VL-3B ช่วยเร่งความเร็วในการ Decode สูงสุด 3.13 เท่าบนอุปกรณ์พกพา โดยยังคงคุณภาพของผลลัพธ์ไว้เท่าเดิม
Liquid AI เปิดตัว Pipette เครื่องมือ Open-Source วัดประสิทธิภาพ AI บนอุปกรณ์แบบครบวงจรtag: Artificial Analysis, Benchmarking, Edge Devices, Liquid AI, On-device AI, PipetteAug 26, 2026 · By: NatapolKLiquid AI เปิดตัว Pipette แพลตฟอร์ม Open-Source สำหรับทดสอบประสิทธิภาพโมเดล AI บนอุปกรณ์พกพาและ Edge Devices โดยวัดผลครอบคลุมทั้งโมเดล การ Quantization และฮาร์ดแวร์จริง เพื่อแก้ปัญหาความคลาดเคลื่อนของข้อมูลจาก Model Card ทั่วไป
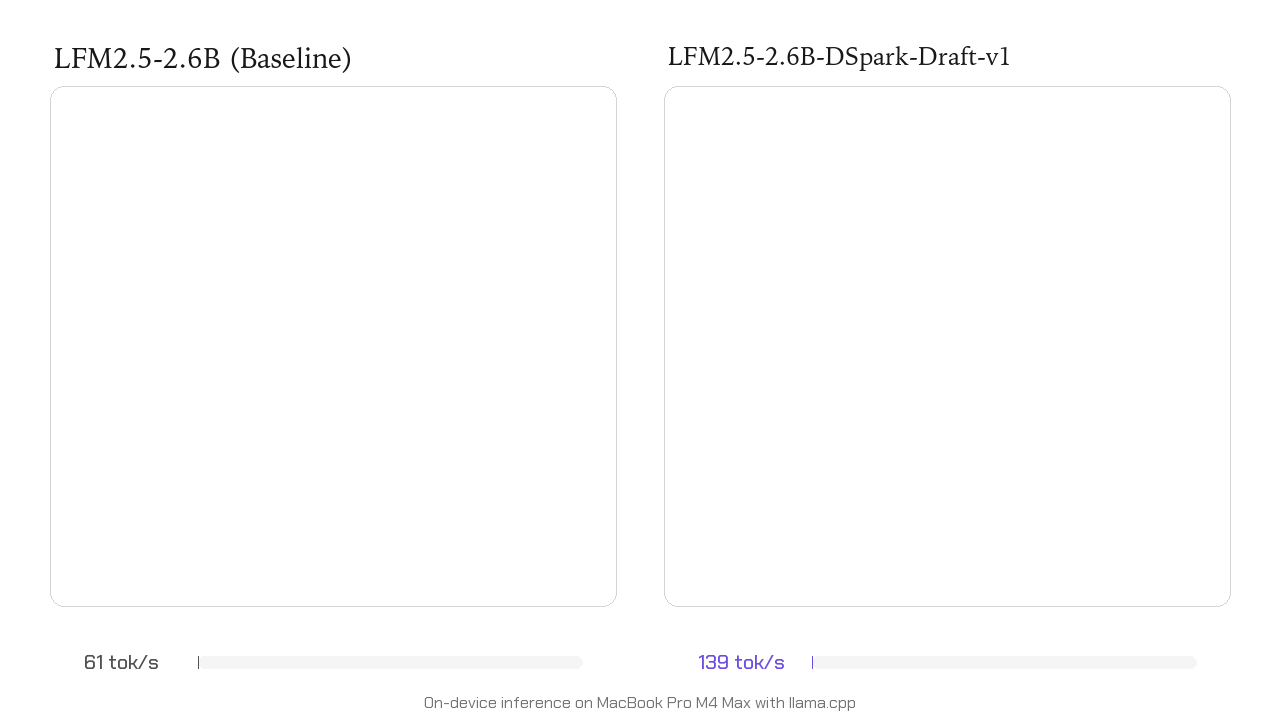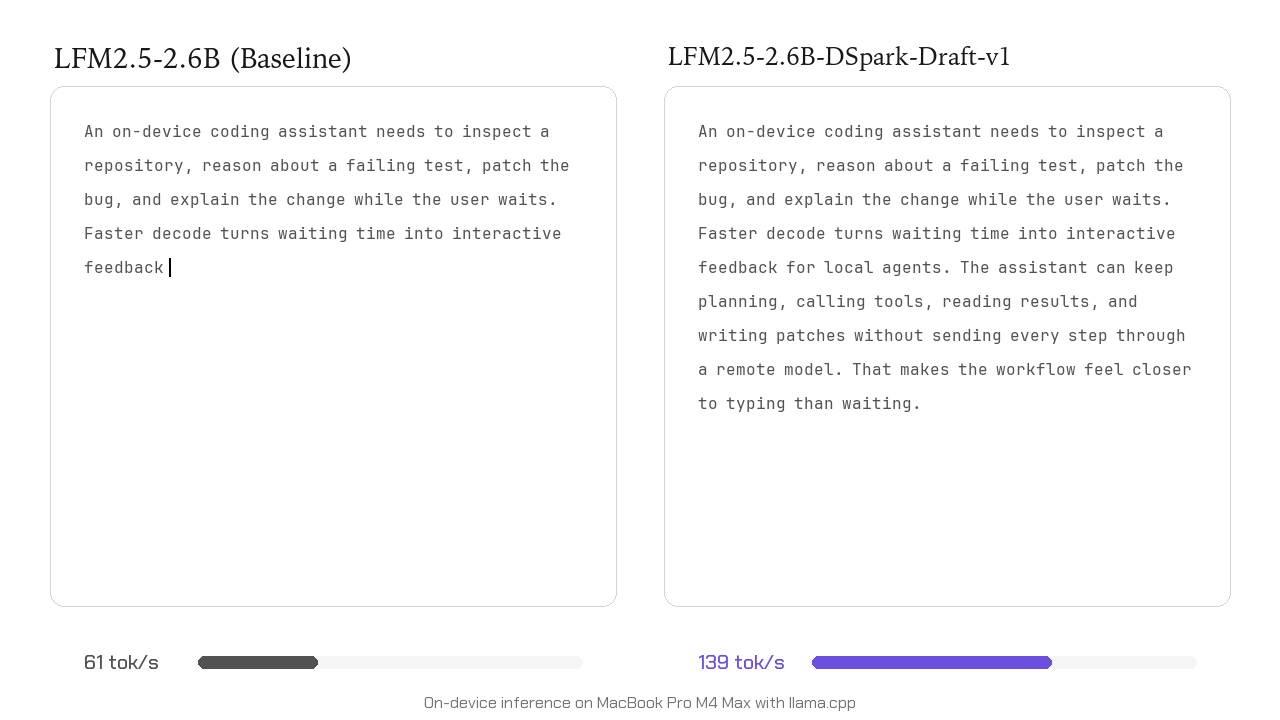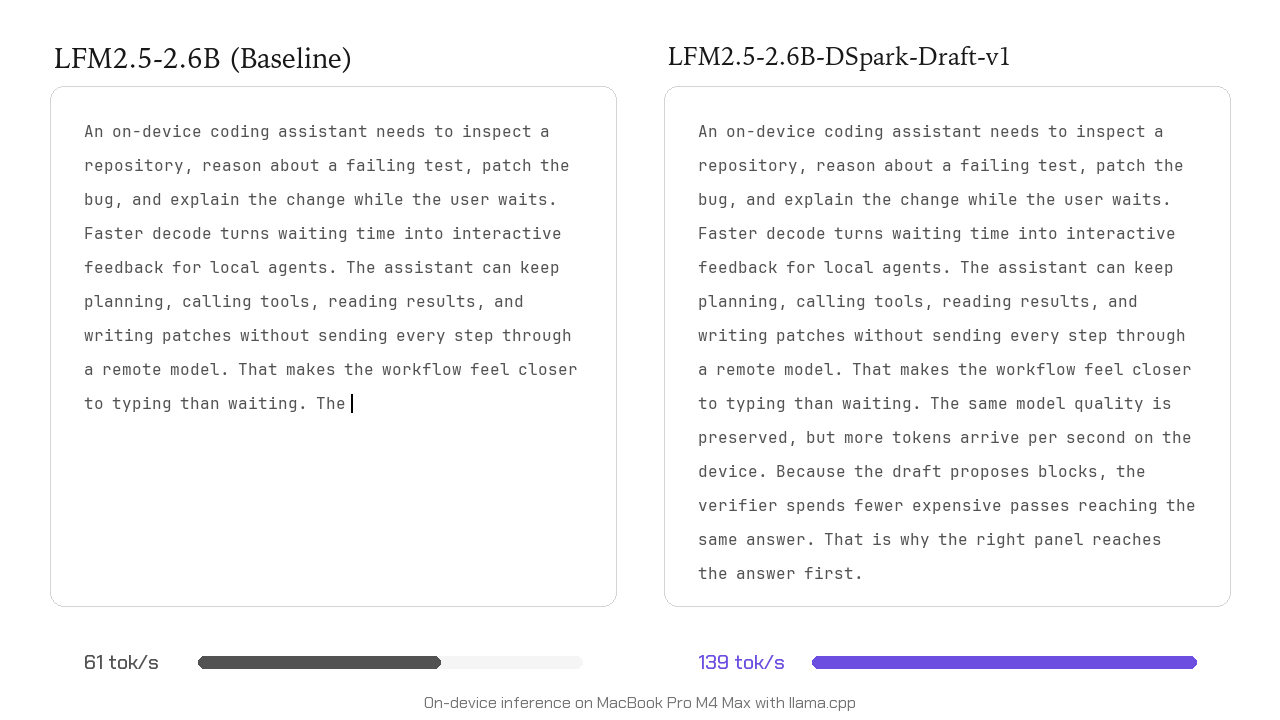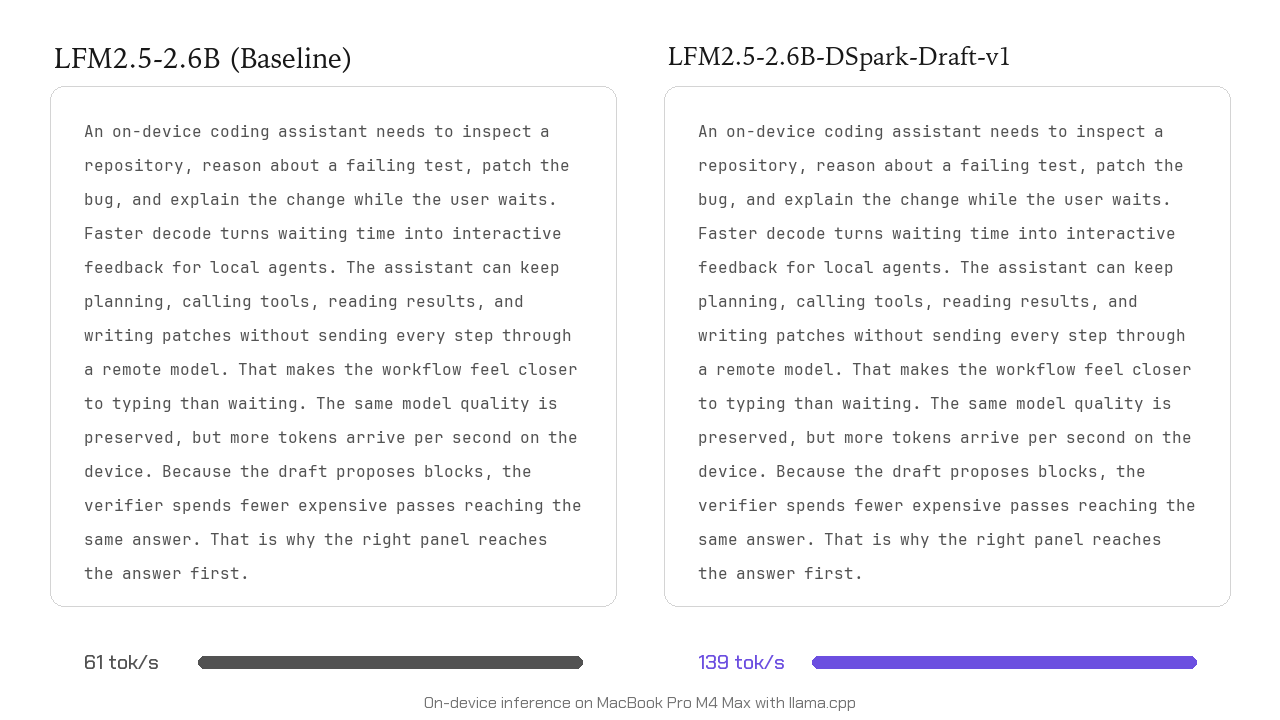
Liquid AI เปิดตัว LFM2.5-DSpark เร่งความเร็วการประมวลผลโมเดลภาษาได้สูงสุด 3.2 เท่าtag: DSpark, LFM2.5, Liquid AI, LLM Inference, Speculative DecodingAug 21, 2026 · By: SirilukPLiquid AI เปิดตัว DSpark draft model สำหรับโมเดลตระกูล LFM2.5 ช่วยเร่งความเร็วการประมวลผล (inference) สูงสุด 3.2 เท่าบน GPU และอุปกรณ์พกพา ผ่านเทคนิค speculative decoding โดยยังคงคุณภาพของผลลัพธ์ไว้เท่าเดิม พร้อมรองรับ llama.cpp และ SGLang ทันที
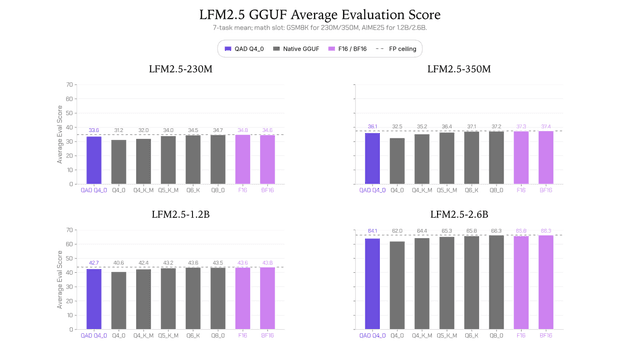
Liquid AI เปิดตัว Checkpoints LFM2.5 Q4_0 ที่ผ่านการเทรนด้วย Quantization-Aware Distillationtag: Edge AI, GGUF, LFM2.5, Liquid AI, QuantizationAug 19, 2026 · By: SirilukPLiquid AI เปิดตัวโมเดล LFM2.5 ในรูปแบบ GGUF 4-bit ที่ใช้เทคนิค Quantization-Aware Distillation (QAD) ช่วยให้คงประสิทธิภาพได้สูงถึง 97% ของรุ่น BF16 เดิม แต่ยังประหยัดหน่วยความจำและทำงานได้รวดเร็วตามมาตรฐาน Q4_0
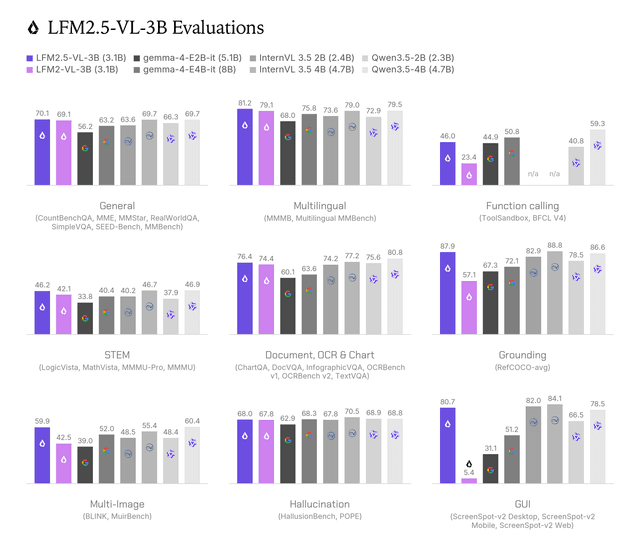
Liquid AI เปิดตัว LFM2.5-VL-3B โมเดล Vision ขนาดเล็ก 3B ที่อ่านหน้าจอและเรียกใช้เครื่องมือได้ในตัวtag: LFM2.5-VL-3B, Liquid AI, Machine Learning, On-device AI, Vision-Language ModelAug 14, 2026 · By: SirilukPLiquid AI เปิดตัวโมเดล vision-language ขนาด 3.1 พันล้านพารามิเตอร์ ออกแบบมาเพื่อทำงานบนอุปกรณ์โดยเฉพาะ โดดเด่นด้านการวิเคราะห์หน้าจอ UI การระบุพิกัดวัตถุ และการเรียกใช้ฟังก์ชันที่มีประสิทธิภาพสูงขึ้น
Liquid AI เปิดตัว LFM2.5-VL-3B โมเดล Vision-Language ไซส์จิ๋วแต่ทรงพลังสำหรับ Edge Devicetag: Edge AI, LFM2.5-VL-3B, Liquid AI, On-device AI, Open-Source, Vision-Language ModelAug 12, 2026 · By: SirilukPLiquid AI เผยโฉม LFM2.5-VL-3B โมเดล Vision-Language ขนาด 3 พันล้านพารามิเตอร์ ชูจุดเด่นด้านการประมวลผลบนอุปกรณ์ที่รวดเร็วแบบเรียลไทม์ พร้อมความสามารถในการเข้าใจหน้าจอและเรียกใช้เครื่องมือที่เหนือกว่าคู่แข่งในระดับเดียวกัน
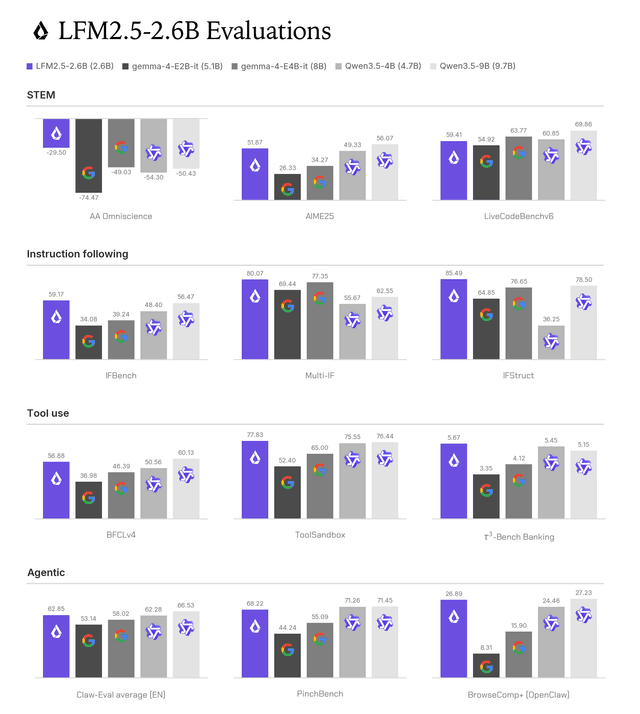
LFM2.5-2.6B โมเดลจิ๋วสเปกแรง ติดตั้ง AI Agent ได้ทุกที่แม้บนมือถือtag: AI Agent, Edge AI, Hugging Face, LFM2.5-2.6B, Liquid AIAug 4, 2026 · By: SirilukPLiquid AI เปิดตัว LFM2.5-2.6B โมเดลขนาดเล็ก 2.6 พันล้านพารามิเตอร์ที่เน้นการทำงานเป็น AI Agent บนอุปกรณ์โดยตรง มีประสิทธิภาพเทียบเท่าโมเดลขนาดใหญ่กว่า 4 เท่า แต่ใช้หน่วยความจำไม่ถึง 2.5 GB
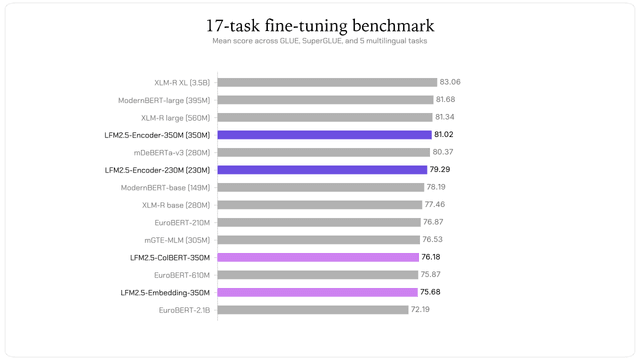
Liquid AI เปิดตัว LFM2.5 Encoder รุ่นใหม่ โดดเด่นด้วยความเร็วระดับ 8K แม้ประมวลผลบน CPUtag: Encoder, LFM2.5, Liquid AI, Machine Learning, Open-weightJul 30, 2026 · By: AttapolKLiquid AI เปิดตัว LFM2.5-Encoder-230M และ 350M โมเดล Bidirectional Encoder แบบ open-weight ที่รองรับ Context สูงถึง 8,192 โทเค็น โดยรุ่น 350M ทำคะแนนทดสอบเป็นอันดับ 4 ของโลกเมื่อเทียบกับโมเดลกลุ่มเดียวกัน
Liquid AI เปิดตัว LFM2.5-Encoders ประมวลผล Long-Context เร็วกว่าเดิม 3.7 เท่าบน CPUtag: LFM2.5-Encoder, Liquid AI, Machine Learning, ModernBERT, NLPJul 28, 2026 · By: SirilukPLiquid AI ปล่อยโมเดลโมเดลตระกูล LFM2.5-Encoder ใหม่ 2 รุ่น ชูจุดเด่นด้านความเร็วในการประมวลผลบริบทขนาดยาวสูงสุด 8,192 tokens โดยมีประสิทธิภาพเหนือกว่า ModernBERT และรองรับการทำงานบน CPU ทั่วไปอย่างดีเยี่ยม