
เร่งความเร็ว VLM ด้วย DSpark โมเดลร่างใหม่จาก Liquid AI
วันนี้เราขอเปิดตัว DSpark รุ่นทดลอง ซึ่งเป็น draft model สำหรับโมเดล vision-language (VLM) รุ่น LFM2.5-VL-3B ของเรา
เช่นเดียวกับ LFM2.5-DSpark drafter models ที่เราเพิ่งเปิดตัวไปเมื่อเร็วๆ นี้ มันช่วยเพิ่มเส้นทางการประมวลผลแบบ speculative decoding ซึ่งแลกกับการใช้หน่วยความจำเพิ่มขึ้นเพียงเล็กน้อย แต่ได้ความเร็วเพิ่มขึ้นอย่างมหาศาลโดยไม่สูญเสียคุณภาพของผลลัพธ์
จุดเด่นที่น่าสนใจ:
- ประมวลผล (inference) เร็วขึ้น: ความเร็วในการ decode เพิ่มขึ้นสูงสุด 3.13 เท่าบนอุปกรณ์พกพา (on-device) และ 2.66 เท่าบน NVIDIA H100 โดยมีประสิทธิภาพรวม (end-to-end) เพิ่มขึ้นสูงสุด 2.62 เท่า
- ใช้หน่วยความจำเพิ่มขึ้นเพียงเล็กน้อย: ตัว drafter เพิ่มพารามิเตอร์เพียง 280M หรือคิดเป็น 8.9% จากโมเดลเป้าหมายขนาด 3B เท่านั้น
- พร้อมใช้งานทันที: รองรับการทำงานร่วมกับ LFM บน llama.cpp, MLX-VLM และ SGLang ตั้งแต่วันแรก
Speculative decoding ใน VLM ทำงานอย่างไร
Vision drafter ใช้สถาปัตยกรรมเดียวกับ text LFM2.5-DSpark drafters โดยจะดึงข้อมูล hidden states ของโมเดลหลักจากเลเยอร์ที่กำหนด เพื่อนำมาสร้างกลุ่ม token ผู้สมัครจำนวน k ตัว
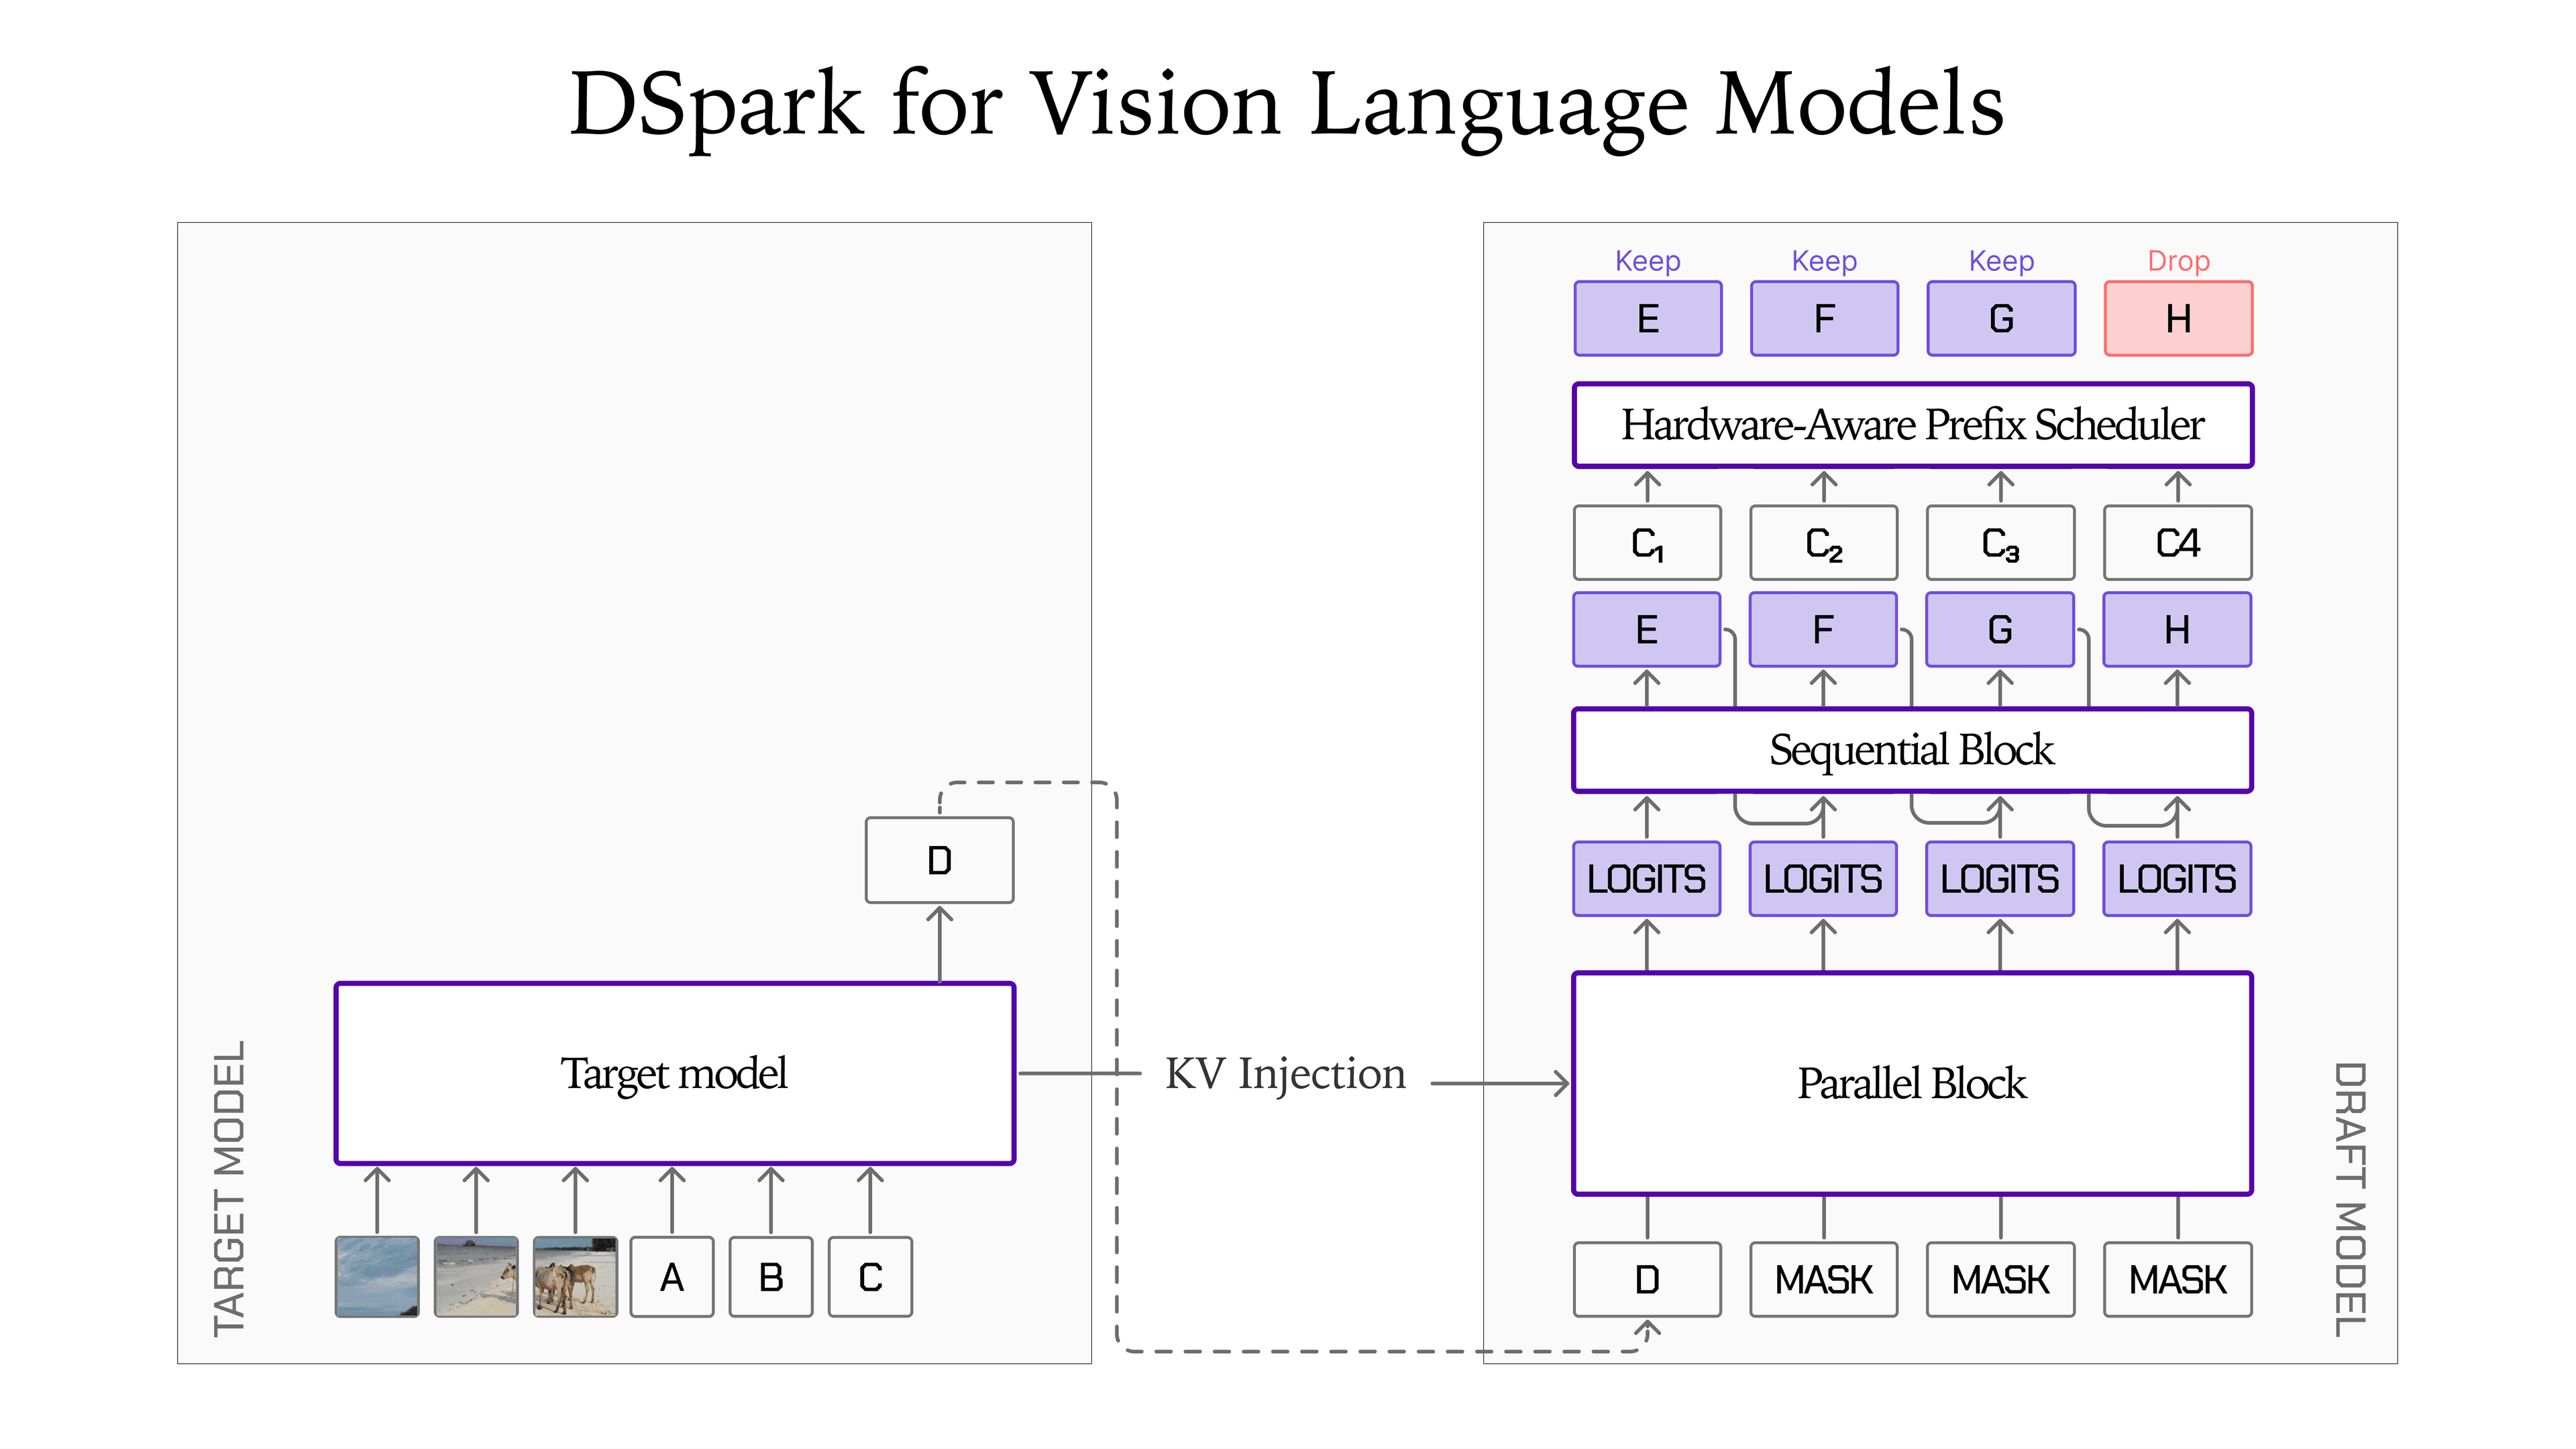
เนื่องจาก image patches และ text tokens จะถูกรวมเข้าเป็น shared representation ก่อนถึงเลเยอร์ดังกล่าว ตัว drafter จึงทำงานบนเวกเตอร์ hidden-state ที่มีมิติเท่ากันโดยไม่เกี่ยงประเภทข้อมูล ทำให้ใช้อัลกอริทึมประมวลผลแบบเดียวกับโมเดลข้อความได้ทันที
การฝึกฝนและสถาปัตยกรรม (Training and Architecture)
เราพัฒนา DSpark ด้วยการผสมผสานข้อมูล vision-language SFT และเน้นน้ำหนักไปยังเวิร์กโหลดที่คาดว่าโมเดลจะถูกนำไปใช้จริง ผลจากการทดสอบ (ablation) พบว่าโมเดลร่างแบบ attention-only ที่ลดรูปเหลือ 4 เลเยอร์ และมีขนาดบล็อก (block size) เท่ากับ 9 ให้ผลลัพธ์ดีที่สุด
เราทำการฝึกฝนทั้งหมด 10 epochs และวัดอัตราการยอมรับ (acceptance rate) พบว่าดีขึ้นตามจำนวน token ที่ใช้ฝึกฝนก่อนจะถึงจุดอิ่มตัว โดยในช่วงใช้งานจริงแนะนำให้ตั้งค่า block size ที่ 8 หรือ 9 ขึ้นอยู่กับฮาร์ดแวร์
| ส่วนประกอบ | LFM2.5-VL-3B |
|---|---|
| Decoder stack (4 layers) | 193.0M |
| Hidden-state projection | 21.0M |
| Markov head | 65.5M |
| Norms + confidence head | 6.4k |
| รวม | 279.5M |
ประสิทธิภาพบน CPU และ GPU
โมเดลร่าง DSpark สำหรับ LFM2.5-VL-3B รองรับการใช้งานผ่าน llama.cpp, MLX-VLM และ SGLang แล้ว
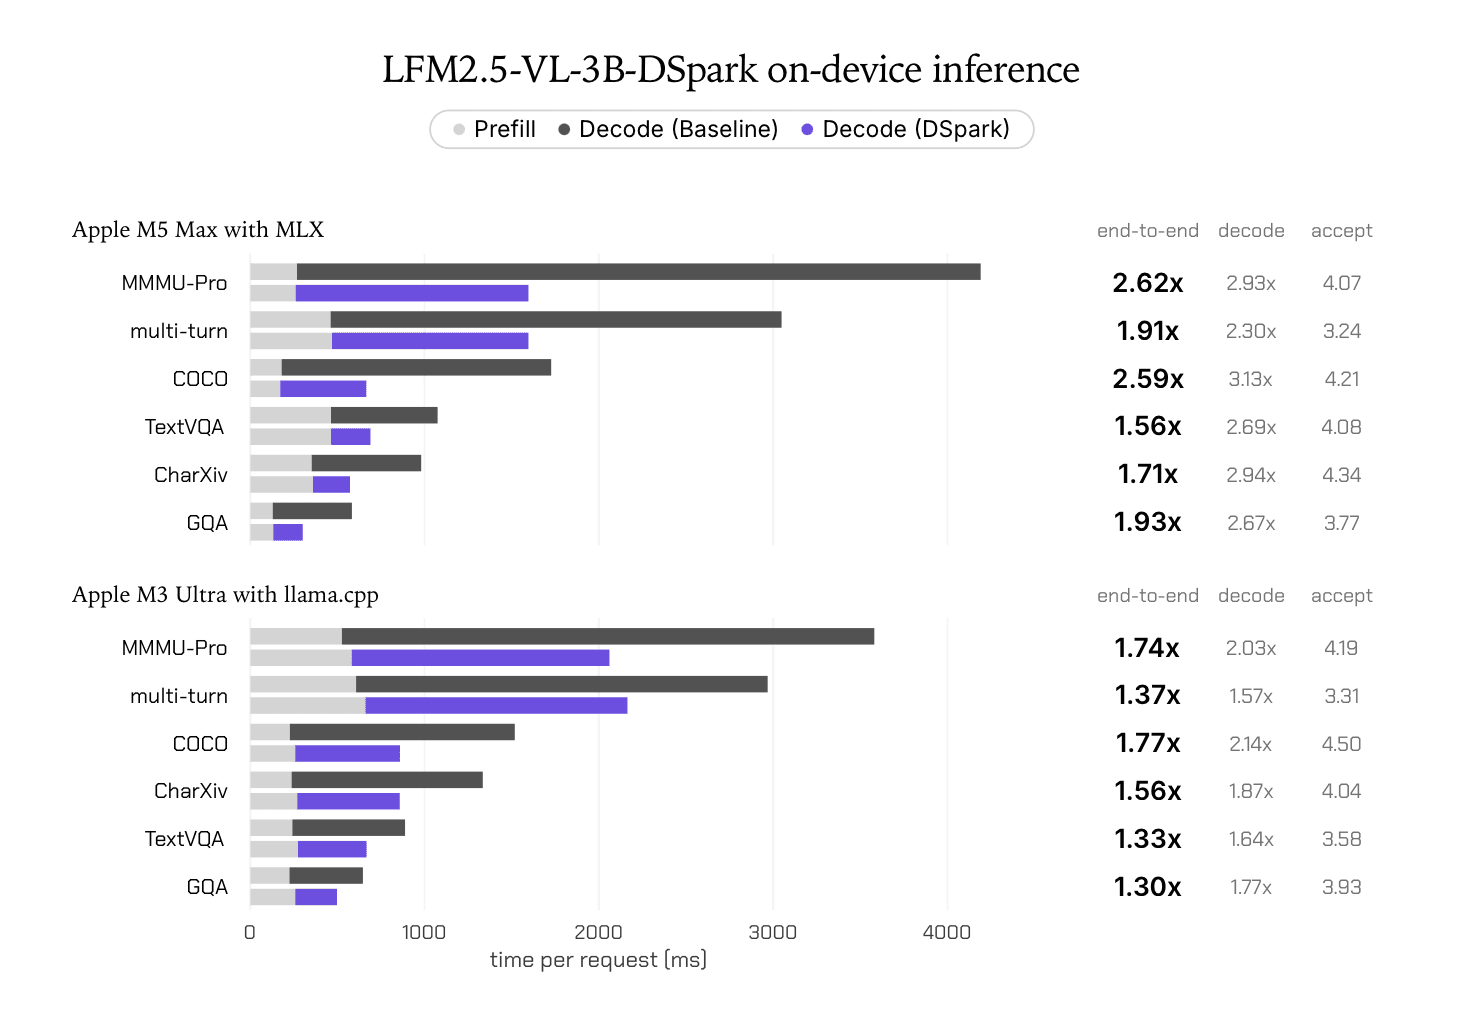
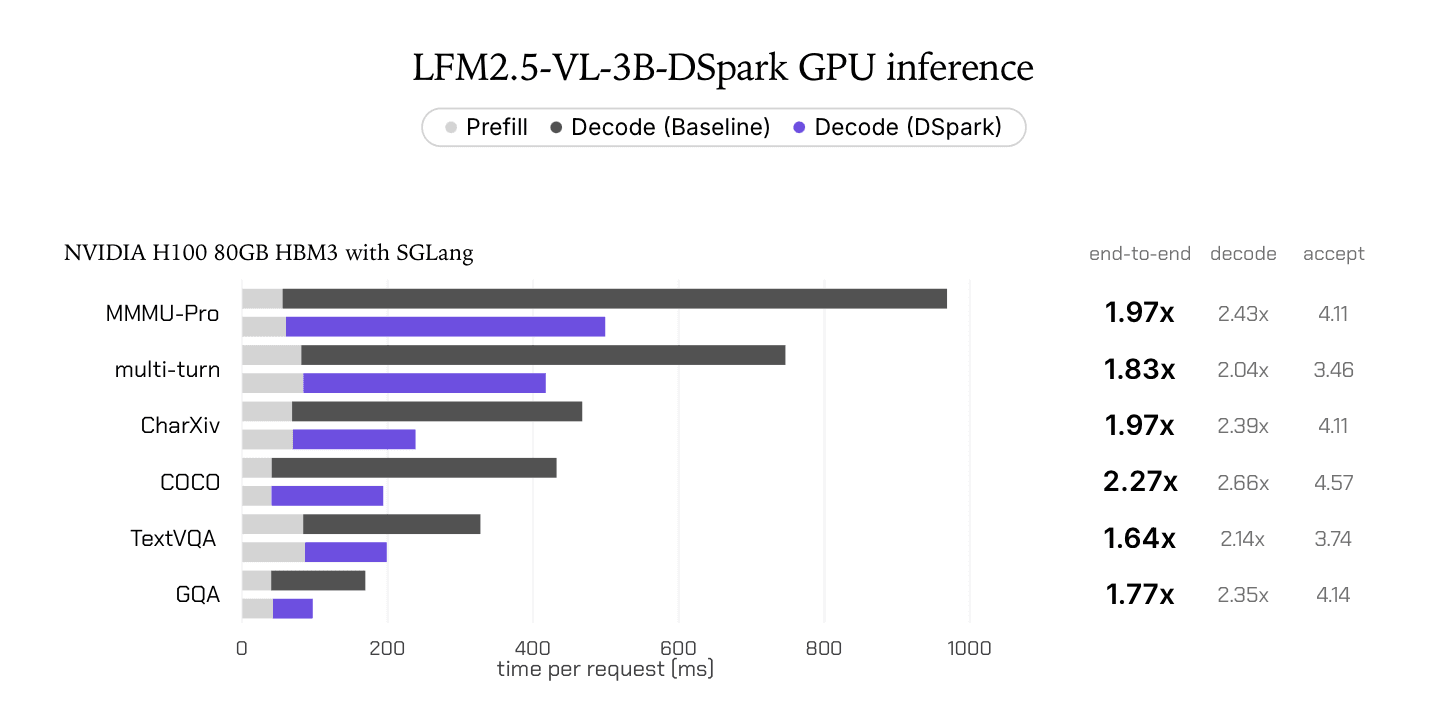
เราได้ทดสอบความเร็วทั้งบนอุปกรณ์พกพาและ GPU โดยครอบคลุมงาน vision 6 ประเภท เช่น general VQA และ complex reasoning ตามเกณฑ์ MMSpec benchmark
การประมวลผลบนอุปกรณ์ (On-device): เมื่อใช้ MLX บนชิป M5 Max การ decode เร็วขึ้น 2.30 ถึง 3.13 เท่า ส่วน llama.cpp บน M3 Ultra ให้ความเร็วการ decode ดีขึ้นสูงสุด 2.14 เท่า
การประมวลผลบน GPU: สำหรับ H100 ตัว drafter เดียวกันนี้ช่วยให้การ decode เร็วขึ้นสูงสุด 2.66 เท่า และเพิ่มประสิทธิภาพโดยรวมได้ถึง 2.27 เท่า
ข้อจำกัดของ Speculation ในงาน Vision
ตามกฎของ Amdahl (Amdahl's law) ความเร็วโดยรวมจะถูกจำกัดด้วยส่วนที่ไม่ได้รับการเร่งความเร็ว ใน VLM ขั้นตอน prefill มักจะช้าเพราะรูปภาพต้องผ่าน vision encoder และประมวลผล visual tokens จำนวนมาก
Speculative decoding จะช่วยเร่งความเร็วเฉพาะขั้นตอน decode เท่านั้น ไม่รวมถึง vision encoding หรือ prefill ดังนั้นในอุปกรณ์ที่มีพลังคำนวณน้อย ขั้นตอน prefill จึงยังคงเป็นคอขวดหลักของค่าความหน่วงทั้งหมด
วิธีใช้งาน LFM2.5-VL-DSpark
หากต้องการใช้งานผ่าน SGLang ต้องใช้เวอร์ชันที่รองรับ (PR #40651) โดยรันโมเดลหลักควบคู่กับโมเดลร่างดังนี้:
python -m sglang.launch_server \
  --model-path LiquidAI/LFM2.5-VL-3B \
  --speculative-algorithm DSPARK \
  --speculative-draft-model-path LiquidAI/LFM2.5-VL-3B-DSpark \
  --speculative-draft-attention-backend flashinfer \
  --speculative-dspark-block-size 9 \
  --disable-radix-cache
สำหรับการใช้งานผ่าน llama.cpp (PR#29339):
llama-server -m models/LFM2.5-VL-3B-F16.gguf \
  --mmproj models/mmproj-LFM2.5-VL-3B-F16.gguf \
  -md LFM2.5-2.6B-DSpark-F16.gguf \
  --spec-type draft-dspark --spec-draft-n-max 8 --spec-draft-n-min 0 \
  -fa on -ngl 99 -c 8192
และสำหรับ MLX-VLM (PR#2280):
mlx_vlm.server --model LiquidAI/LFM2.5-VL-3B --draft-model LiquidAI/LFM2.5-VL-3B-DSparkเริ่มต้นใช้งาน
คุณสามารถดาวน์โหลดโมเดลร่าง DSpark ได้แล้วที่ Hugging Face ทั้งในรูปแบบ Safetensors และ GGUF
LFM2.5 คือก้าวสำคัญของ AI ที่ทำงานได้ทุกที่ด้วยจุดเด่นคือ น้ำหนักโมเดลแบบเปิด (Open-weight), ประมวลผลเร็วตั้งแต่วันแรก และรองรับการใช้งานที่หลากหลายตั้งแต่ข้อความ เสียง ไปจนถึงภาพ
การอ้างอิง
@article{liquidAI2026vldspark,
  author = {Liquid AI},
  title = {LFM2.5-VL-DSpark: Accelerating vision-language models on edge and beyond},
  journal = {Liquid AI Blog},
  year = {2026},
  note = {www.liquid.ai/blog/lfm2-5-vl-dspark},
}ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร