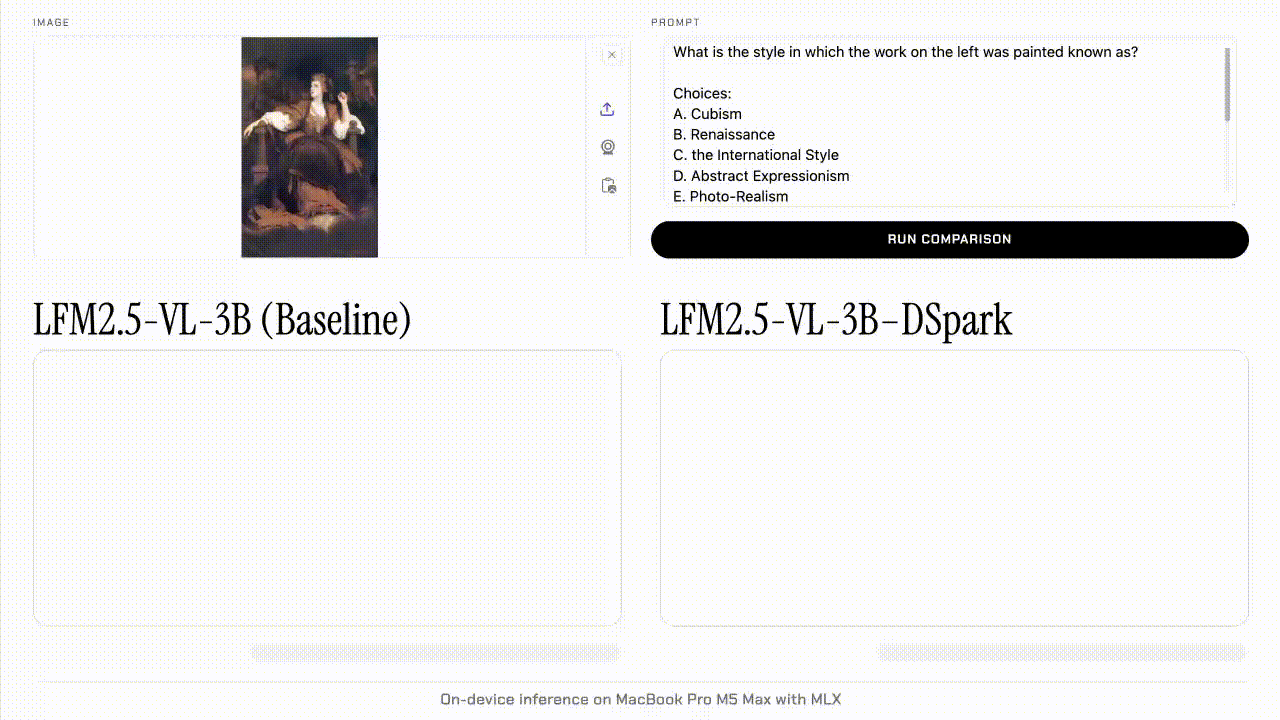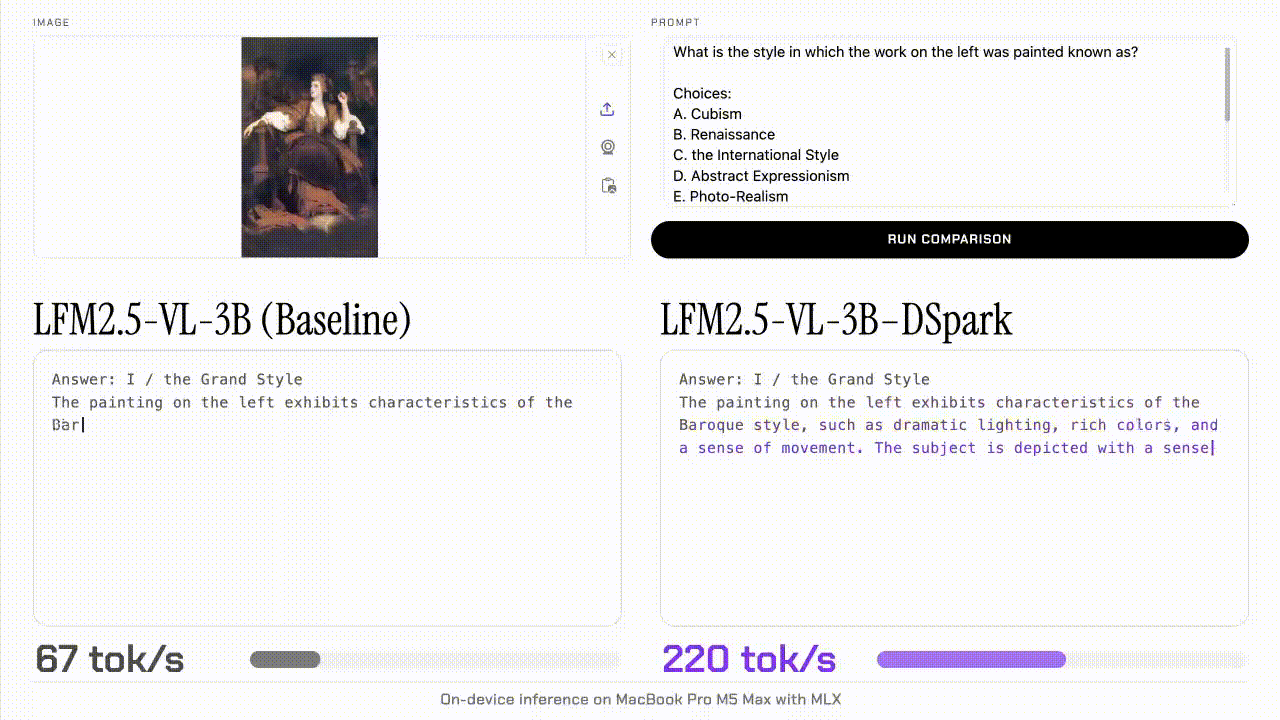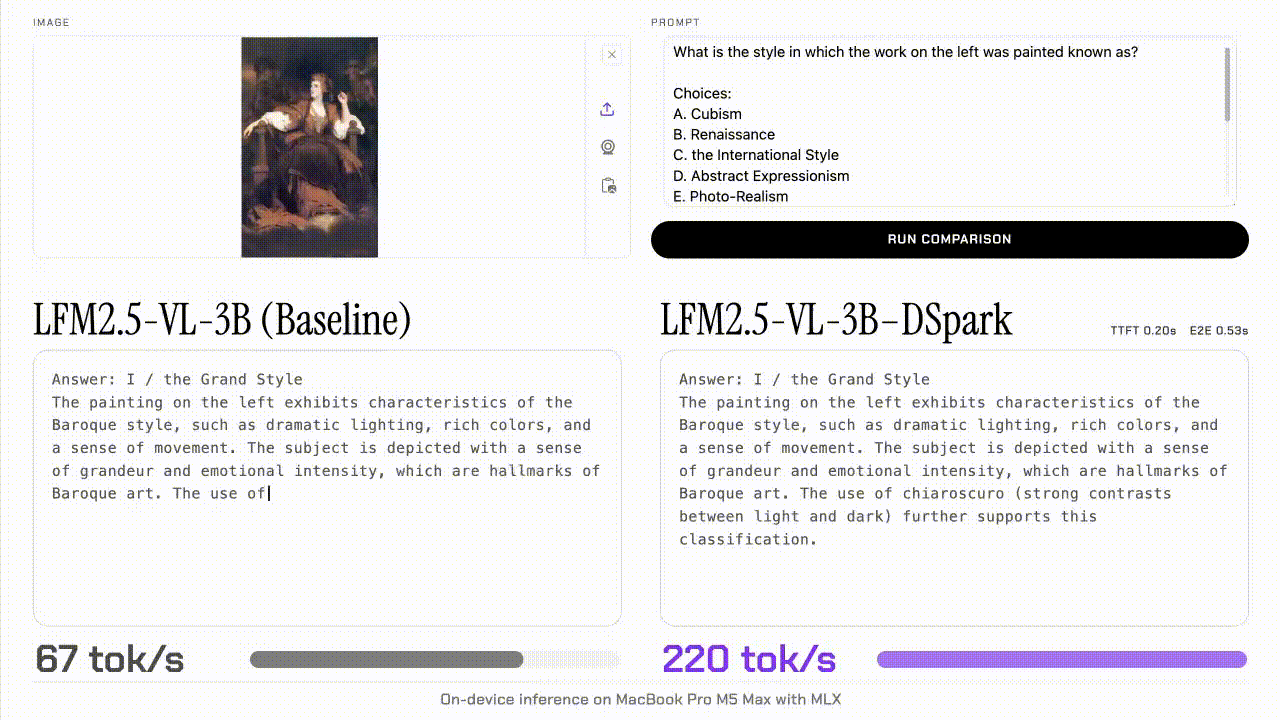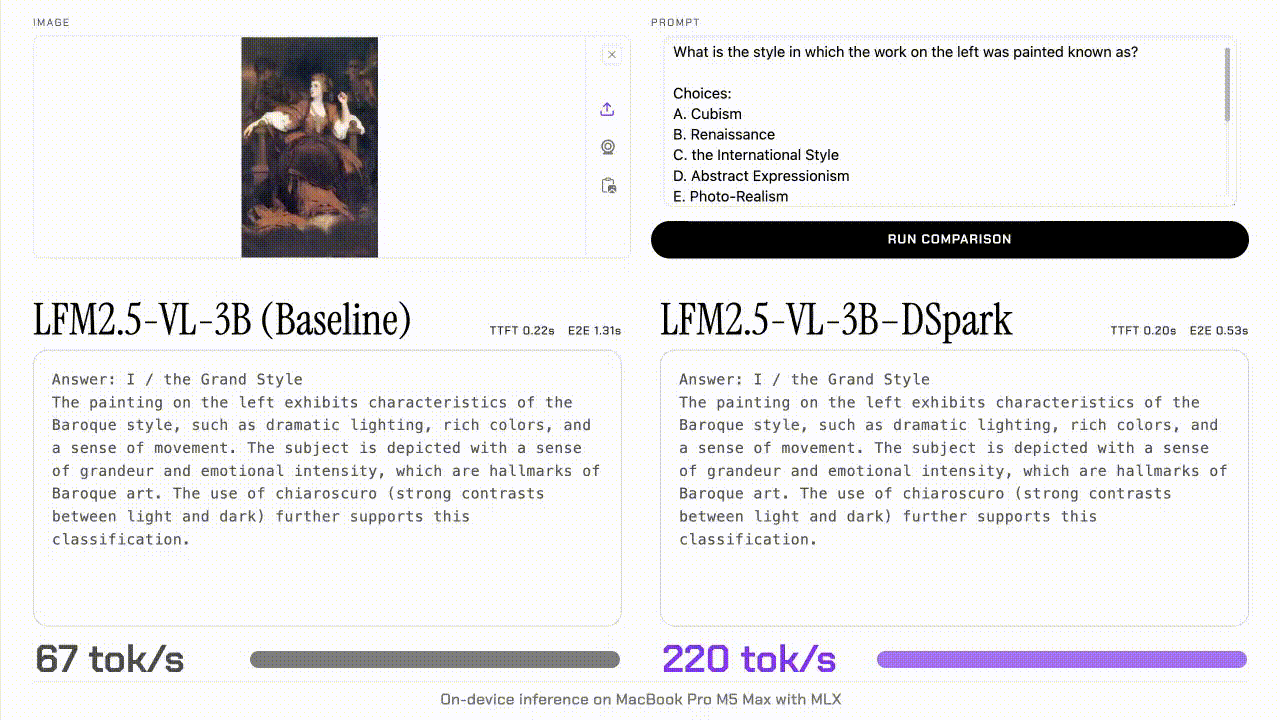
เร่งความเร็ว VLM ด้วย DSpark โมเดลร่างใหม่จาก Liquid AItag: DSpark, LFM2.5-VL, Liquid AI, Speculative Decoding, VLMSep 24, 2026 · By: SirilukPสรุปข่าว 1:18Liquid AI เปิดตัว DSpark รุ่นทดลองสำหรับ LFM2.5-VL-3B ช่วยเร่งความเร็วในการ Decode สูงสุด 3.13 เท่าบนอุปกรณ์พกพา โดยยังคงคุณภาพของผลลัพธ์ไว้เท่าเดิม
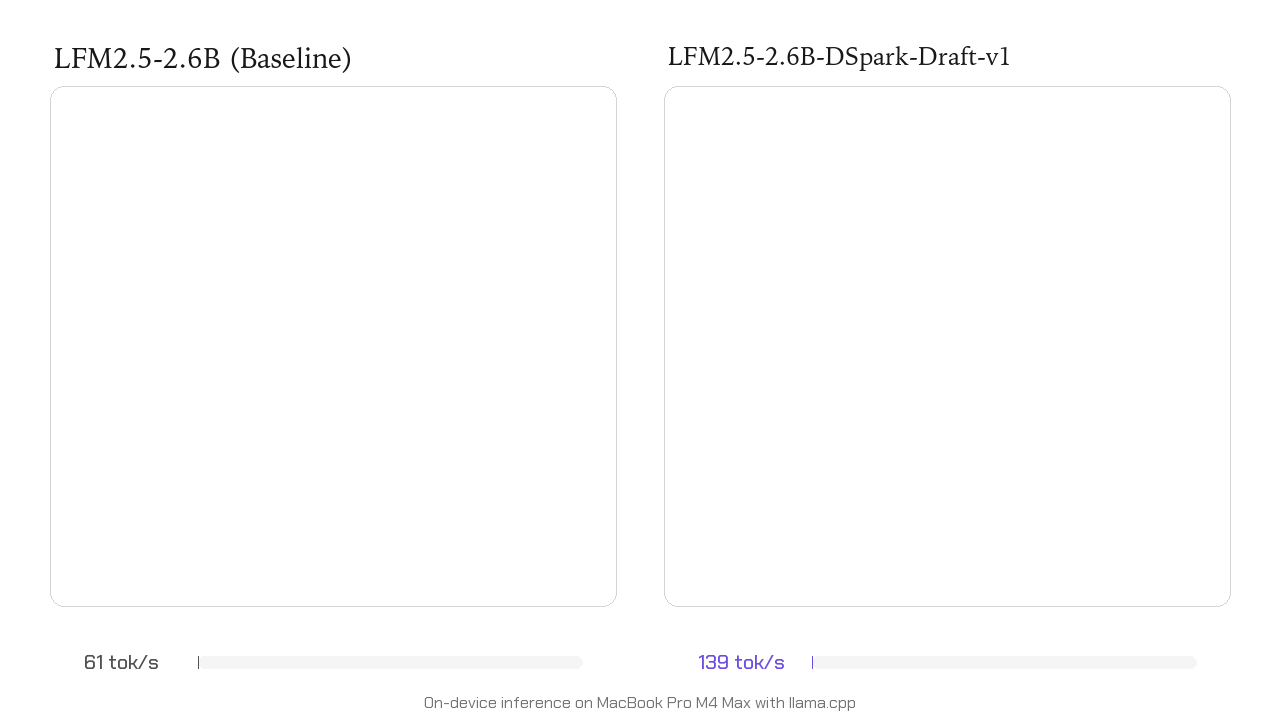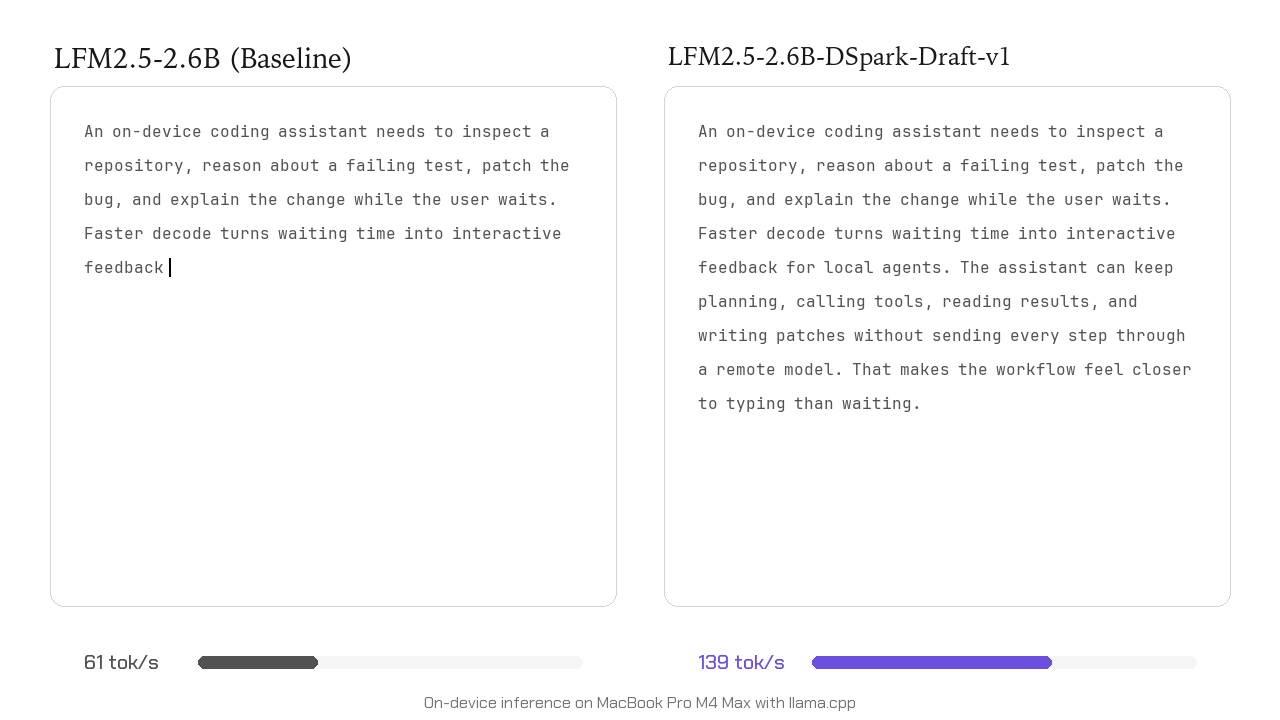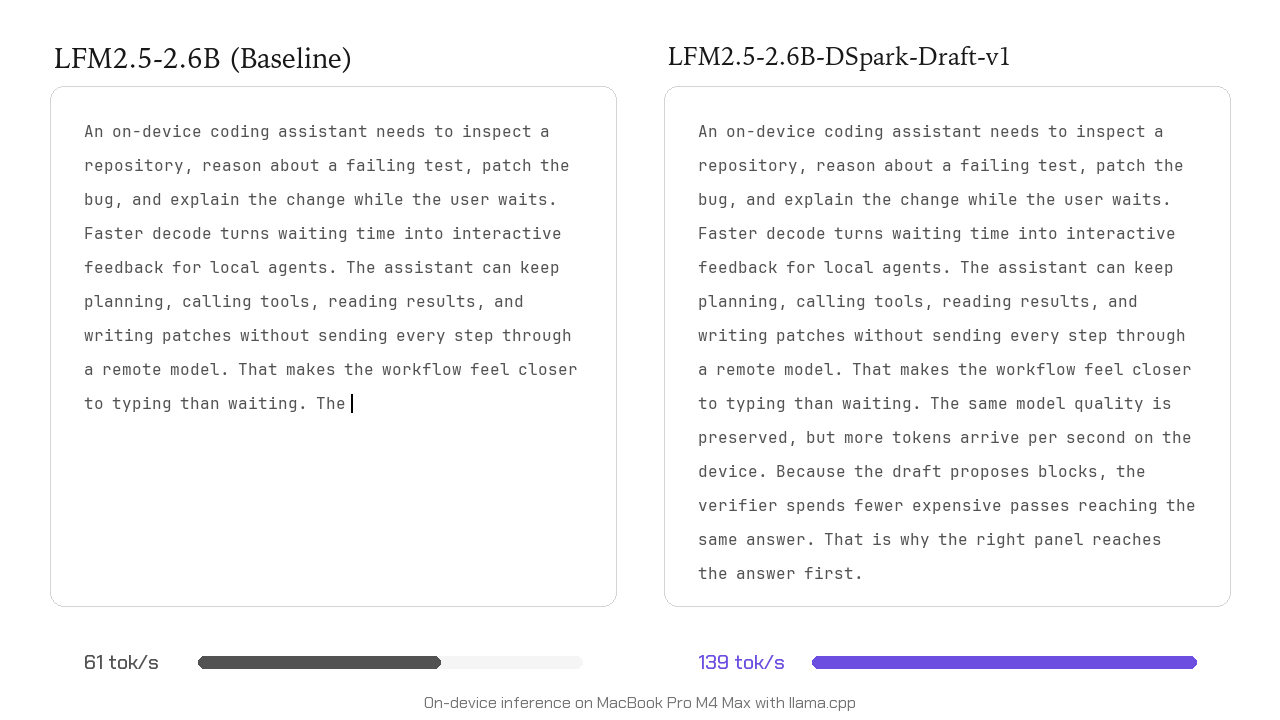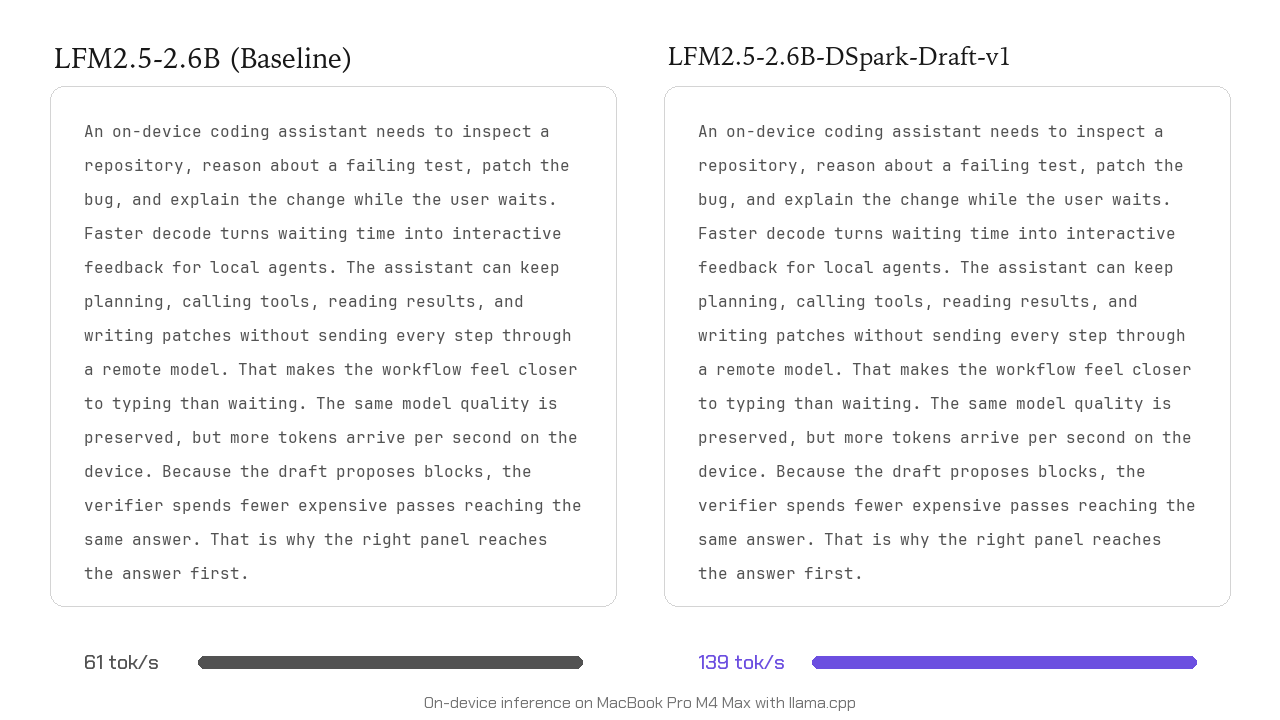
Liquid AI เปิดตัว LFM2.5-DSpark เร่งความเร็วการประมวลผลโมเดลภาษาได้สูงสุด 3.2 เท่าtag: DSpark, LFM2.5, Liquid AI, LLM Inference, Speculative DecodingAug 21, 2026 · By: SirilukPLiquid AI เปิดตัว DSpark draft model สำหรับโมเดลตระกูล LFM2.5 ช่วยเร่งความเร็วการประมวลผล (inference) สูงสุด 3.2 เท่าบน GPU และอุปกรณ์พกพา ผ่านเทคนิค speculative decoding โดยยังคงคุณภาพของผลลัพธ์ไว้เท่าเดิม พร้อมรองรับ llama.cpp และ SGLang ทันที