5 โปรเจกต์วิศวกรรม LLM Inference เพื่อความเข้าใจระบบเบื้องหลังtag: FlashAttention, Hugging Face, LLM Inference, Quantization, Speculative Decoding, vLLMOct 14, 2026 · By: SirilukPสรุปข่าว 1:27เจาะลึกกลไกที่ทำให้ LLM ทำงานได้รวดเร็วผ่าน 5 โปรเจกต์ลงมือทำจริง ตั้งแต่การสร้างระบบจัดการหน่วยความจำไปจนถึงการเขียน GPU Kernel
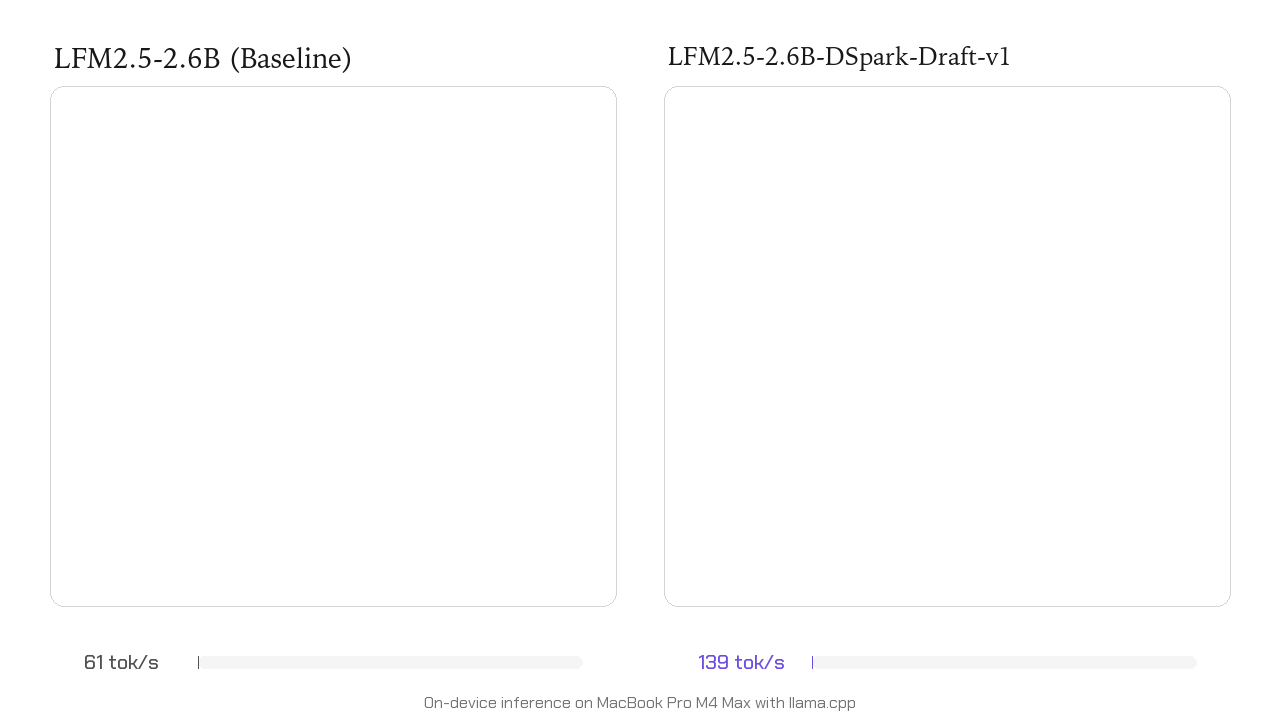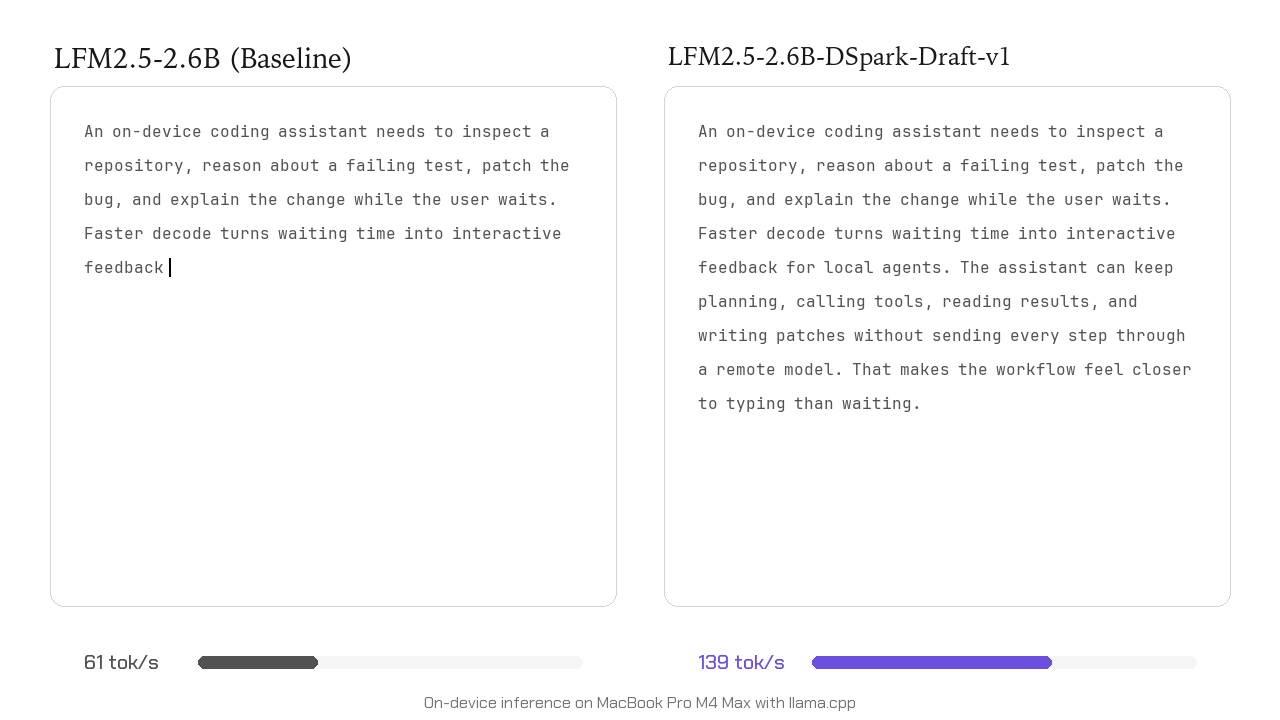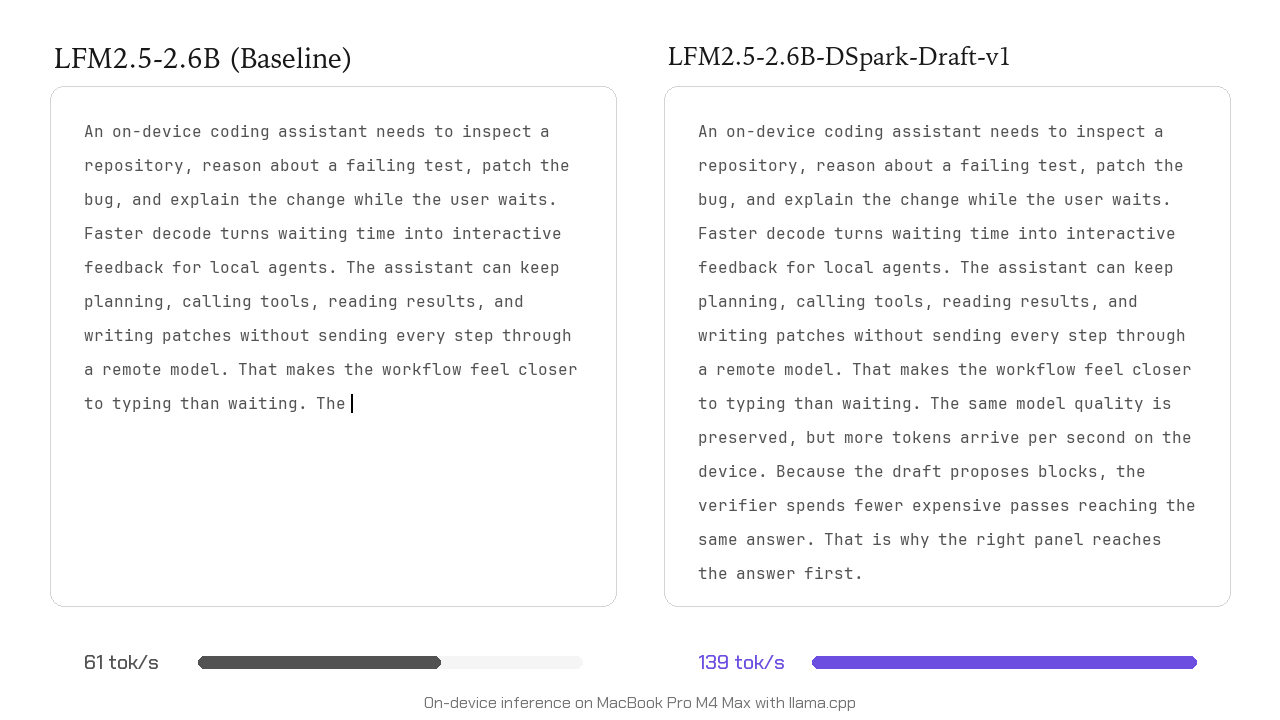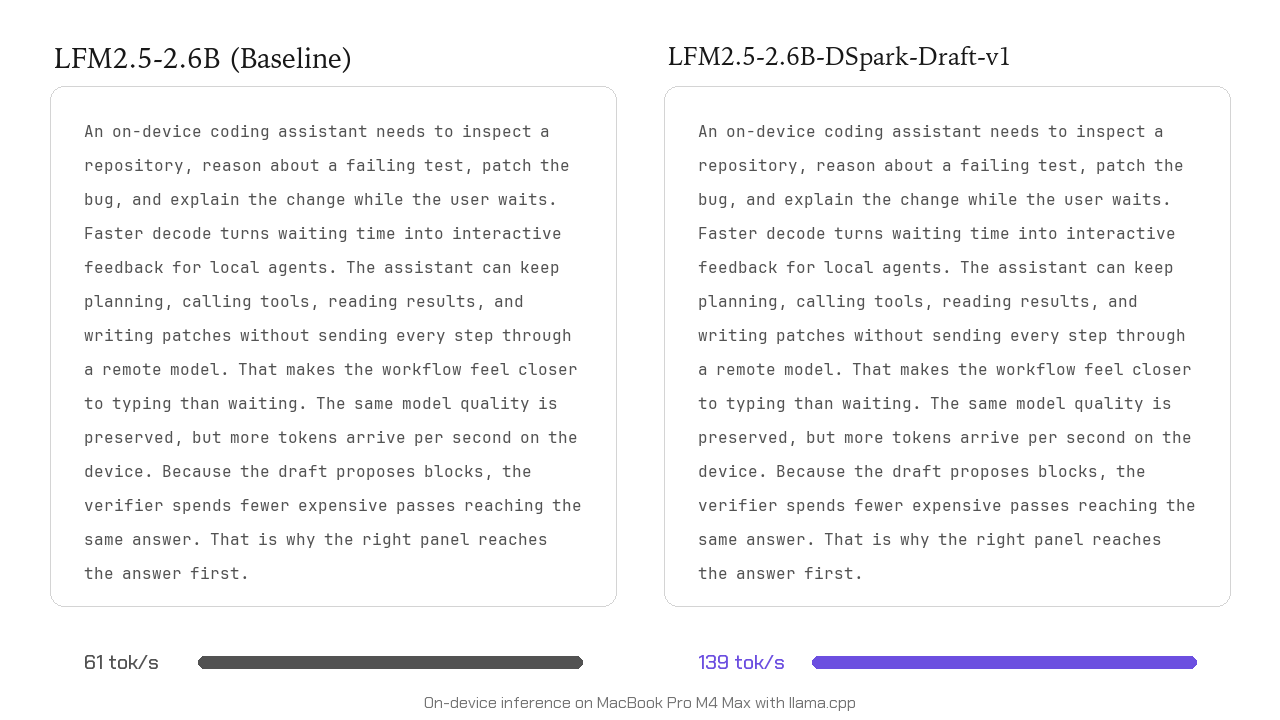
Liquid AI เปิดตัว LFM2.5-DSpark เร่งความเร็วการประมวลผลโมเดลภาษาได้สูงสุด 3.2 เท่าtag: DSpark, LFM2.5, Liquid AI, LLM Inference, Speculative DecodingAug 21, 2026 · By: SirilukPLiquid AI เปิดตัว DSpark draft model สำหรับโมเดลตระกูล LFM2.5 ช่วยเร่งความเร็วการประมวลผล (inference) สูงสุด 3.2 เท่าบน GPU และอุปกรณ์พกพา ผ่านเทคนิค speculative decoding โดยยังคงคุณภาพของผลลัพธ์ไว้เท่าเดิม พร้อมรองรับ llama.cpp และ SGLang ทันที