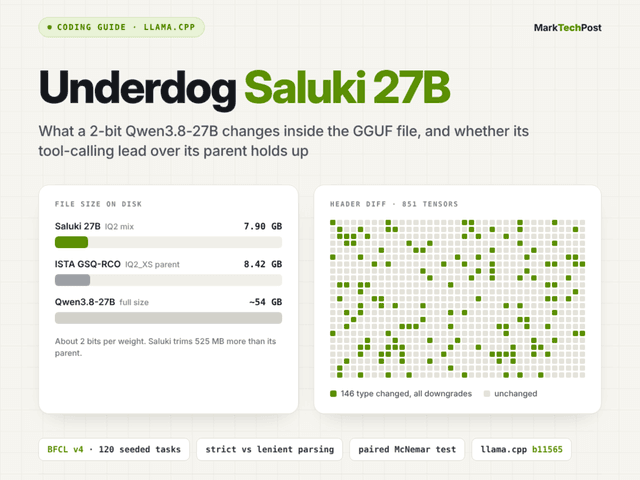
วิธีรัน Underdog Saluki 27B: คู่มือ Tool-Calling ด้วยโมเดล 2-Bittag: Llama.cpp, Quantization, Qwen3.8-27B, Tool-Calling, Underdog SalukiOct 26, 2026 · By: TanasakPเจาะลึกคู่มือการรัน Underdog Saluki 27B โมเดลขนาดเล็กประสิทธิภาพสูง พร้อมเปรียบเทียบการทำ quantization แบบ GSQ-RCO และการทดสอบประสิทธิภาพ Tool-Calling บน BFCL
5 โปรเจกต์วิศวกรรม LLM Inference เพื่อความเข้าใจระบบเบื้องหลังtag: FlashAttention, Hugging Face, LLM Inference, Quantization, Speculative Decoding, vLLMOct 14, 2026 · By: SirilukPสรุปข่าว 1:27เจาะลึกกลไกที่ทำให้ LLM ทำงานได้รวดเร็วผ่าน 5 โปรเจกต์ลงมือทำจริง ตั้งแต่การสร้างระบบจัดการหน่วยความจำไปจนถึงการเขียน GPU Kernel
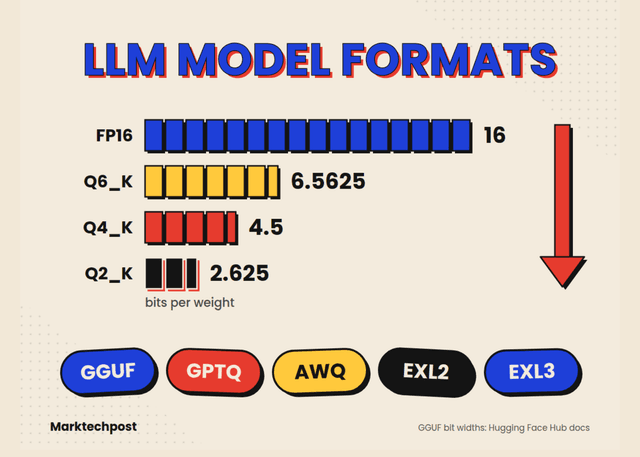
GGUF vs GPTQ vs AWQ vs EXL2: เจาะลึกความต่างรูปแบบโมเดล LLMtag: AWQ, EXL2, GGUF, GPTQ, LLM, QuantizationSep 19, 2026 · By: TanasakPสรุปข่าว 1:36คู่มือเปรียบเทียบรูปแบบโมเดลภาษาขนาดใหญ่ (LLM) ในปี 2026 อธิบายความแตกต่างระหว่างไฟล์คอนเทนเนอร์และวิธี Quantization พร้อมคำแนะนำการเลือกใช้งานให้เหมาะกับฮาร์ดแวร์แต่ละประเภท
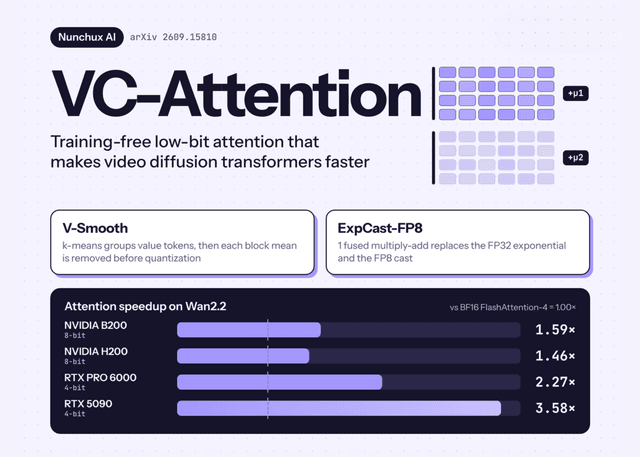
Nunchux AI เปิดตัว VC-Attention เร่งความเร็ววิดีโอ AI สูงสุด 3.5 เท่าtag: B200, Nunchux AI, Quantization, RTX 5090, VC-Attention, Video Diffusion TransformersSep 17, 2026 · By: TanasakPNunchux AI พัฒนา VC-Attention ซึ่งเป็น low-bit attention kernel แบบไม่ต้องเทรน ช่วยแก้ปัญหาคอขวดใน Video Diffusion Transformers ให้ประมวลผลวิดีโอความละเอียดสูงได้เร็วขึ้นอย่างมีนัยสำคัญ
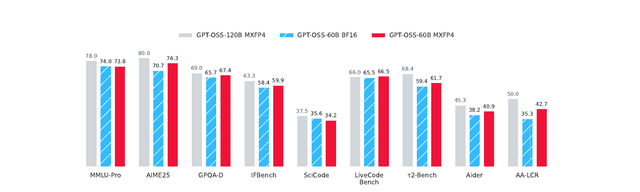
Quantization-Aware Healing: พลิกโฉมโมเดล 4-bit ให้แม่นยำกว่าต้นฉบับ 16-bit แม้ถูกบีบอัดtag: Large Language Models, Model Compression, Nvidia, OpenAI, QAH, QuantizationAug 26, 2026 · By: AttapolKนักวิจัยเปิดตัวเทคนิค Quantization-Aware Healing (QAH) ที่ช่วยฟื้นฟูประสิทธิภาพของโมเดลภาษาขนาดใหญ่หลังการบีบอัด ทำให้โมเดลขนาด 4-bit มีความแม่นยำสูงกว่าโมเดลต้นฉบับ 16-bit ในขณะที่ประหยัดทรัพยากรมากกว่าเดิม
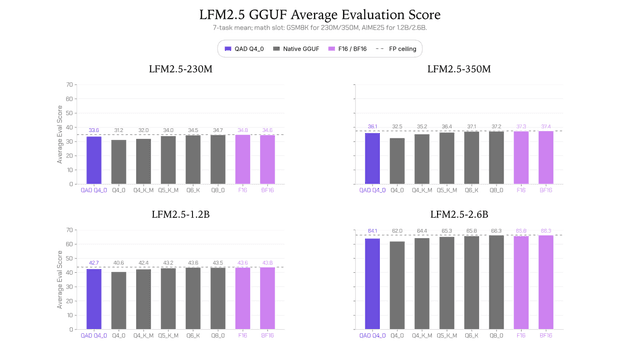
Liquid AI เปิดตัว Checkpoints LFM2.5 Q4_0 ที่ผ่านการเทรนด้วย Quantization-Aware Distillationtag: Edge AI, GGUF, LFM2.5, Liquid AI, QuantizationAug 19, 2026 · By: SirilukPLiquid AI เปิดตัวโมเดล LFM2.5 ในรูปแบบ GGUF 4-bit ที่ใช้เทคนิค Quantization-Aware Distillation (QAD) ช่วยให้คงประสิทธิภาพได้สูงถึง 97% ของรุ่น BF16 เดิม แต่ยังประหยัดหน่วยความจำและทำงานได้รวดเร็วตามมาตรฐาน Q4_0
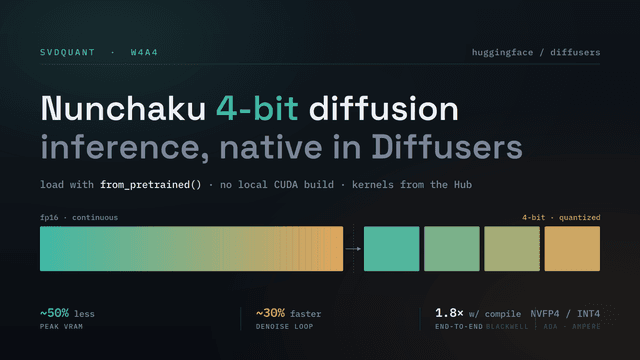
Diffusers รองรับ Nunchaku 4-bit เพิ่มสปีดการรัน Diffusion Transformers โดยใช้หน่วยความจำน้อยลงtag: Diffusers, Hugging Face, Nunchaku, Quantization, SVDQuantJul 23, 2026 · By: TanasakPDiffusers ผสานการทำงานกับ Nunchaku Lite ช่วยให้รันโมเดล Diffusion ขนาดใหญ่ด้วย Precision แบบ 4-bit (W4A4) ได้เร็วขึ้น 30% และลดการใช้ VRAM ลงถึงครึ่งหนึ่งบน GPU ระดับผู้บริโภค