
GGUF vs GPTQ vs AWQ vs EXL2: เจาะลึกความต่างรูปแบบโมเดล LLM
ก่อนอื่น แยก 2 แนวคิดออกจากกัน: คอนเทนเนอร์ vs. วิธี quantization
ความสับสนส่วนใหญ่ในการเลือกใช้โมเดลมาจากการผสมผสานสองเลเยอร์ที่ต่างกันเข้าด้วยกัน ได้แก่ คอนเทนเนอร์ (Container) ซึ่งกำหนดวิธีจัดเก็บ tensor ลงในดิสก์ และ วิธี Quantization (Quantization method) ที่เป็นเทคนิคการบีบอัดน้ำหนัก (weights) ให้เหลือบิตน้อยลง โดยทั่วไป คอนเทนเนอร์ จะประกอบด้วย safetensors, GGUF หรือ PyTorch pickle (.bin / .pt) ส่วน วิธี Quantization จะมีทั้ง GPTQ, AWQ, bitsandbytes NF4, llama.cpp K-quants และ I-quants อย่างไรก็ตาม มีบางกรณีอย่าง EXL2 และ EXL3 ที่เป็นทั้งวิธีและรูปแบบการจัดเก็บในตัวเดียว ซึ่งผูกติดกับไลบรารีการประมวลผล (inference) เฉพาะทาง
กฎเหล็กประมาณการหน่วยความจำแบบเร็วๆ
หน่วยความจำของ Weight ≈ จำนวนพารามิเตอร์ × bits-per-weight ÷ 8
| โมเดล | 16-bit | ~4.5 bits per weight |
|---|---|---|
| 8B | ~16 GB | ~4.5 GB |
| 70B | ~140 GB | ~39 GB |
นี่คือการคำนวณทางคณิตศาสตร์เบื้องต้น ครอบคลุมเฉพาะส่วน weights เท่านั้น ในการใช้งานจริงส่วน KV cache และค่าใช้จ่ายตอนรันระบบ (runtime overhead) จะเพิ่มภาระหน่วยความจำขึ้นไปอีก
1. ความแม่นยำเต็มพิกัด: safetensors และ PyTorch .bin
โมเดลที่ยังไม่ได้ทำ quantization มักจะถูกส่งมอบในรูปแบบ weights 16-bit ผ่านไฟล์ pytorch_model.bin หรือ model.safetensors โดยไฟล์ .bin รุ่นเก่าที่ใช้ Python pickle มีความเสี่ยงด้านความปลอดภัยเนื่องจากสามารถรันโค้ดใดๆ ก็ได้ขณะโหลดไฟล์
Safetensors ที่พัฒนาโดย Hugging Face จึงเข้ามาแก้ปัญหานี้ด้วยการกำจัดความเสี่ยงดังกล่าว ไฟล์จะประกอบด้วยส่วนหัว JSON ขนาดเล็กและ raw tensor buffers ทำให้สามารถโหลดข้อมูลแบบ memory-mapped ได้โดยไม่ต้องอ่านทั้งไฟล์ ปัจจุบันถูกจัดเป็น PyTorch Foundation project
ข้อสังเกตสำคัญ: โมเดลยอดนิยมอย่าง GPTQ, AWQ, EXL2, EXL3 และ MLX ส่วนใหญ่ก็ถูกจัดเก็บในไฟล์ .safetensors เช่นกัน โดยกระบวนการ quantization จะเกิดขึ้นภายในเนื้อหาของ tensor และไฟล์ config ไม่ใช่การเปลี่ยนประเภทคอนเทนเนอร์ใหม่
2. GGUF (llama.cpp)
มันคืออะไร
GGUF คือรูปแบบไบนารีสำหรับรันโมเดลด้วย GGML และ llama.cpp พัฒนาโดย Georgi Gerganov (เอกสาร Hugging Face) เพื่อมาแทนที่รูปแบบ GGML เดิมเมื่อวันที่ 21 สิงหาคม 2023
ทำไมถึงมาแทนที่ GGML
ไฟล์รูปแบบเก่าไม่สามารถระบุสถาปัตยกรรมโมเดลได้ชัดเจน ทำให้เมื่อมีการเพิ่มพารามิเตอร์ใหม่ ไฟล์เดิมจะใช้งานไม่ได้ทันที GGUF จึงเปลี่ยนมาใช้ typed key-value metadata เพื่อให้สามารถเพิ่มฟิลด์ใหม่ๆ ได้โดยไม่กระทบความเข้ากันได้กับไฟล์เวอร์ชันเก่า
เป้าหมายการออกแบบ
GGUF เน้นเป้าหมาย 5 ประการ ได้แก่ การปรับใช้แบบไฟล์เดียว, ความสามารถในการขยาย, การใช้งานร่วมกับ mmap, การโหลดที่ง่าย และความครบถ้วนของข้อมูล โดยสามารถเก็บ tokenizer, special tokens และ Jinja chat template ไว้รวมกับ weights ได้ทันที
การอ่านชื่อ GGUF quant
ชื่อไฟล์อย่าง Q4_K_M.gguf จะระบุรูปแบบที่ใช้ตามข้อมูลจาก เอกสาร Hugging Face GGUF ดังนี้:
| ประเภท | วิธีการทำงาน | Bits per weight |
|---|---|---|
| Q4_0 / Q4_1 (ดั้งเดิม) | 4-bit ปัดเศษใกล้เคียงสุดในบล็อก 32-weight; Q4_1 เพิ่มค่าต่ำสุดของบล็อก | 4.5 / 5.0* |
| Q8_0 (ป้ายชื่อดั้งเดิม) | 8-bit ปัดเศษใกล้เคียงสุดในบล็อก 32-weight | 8.5* |
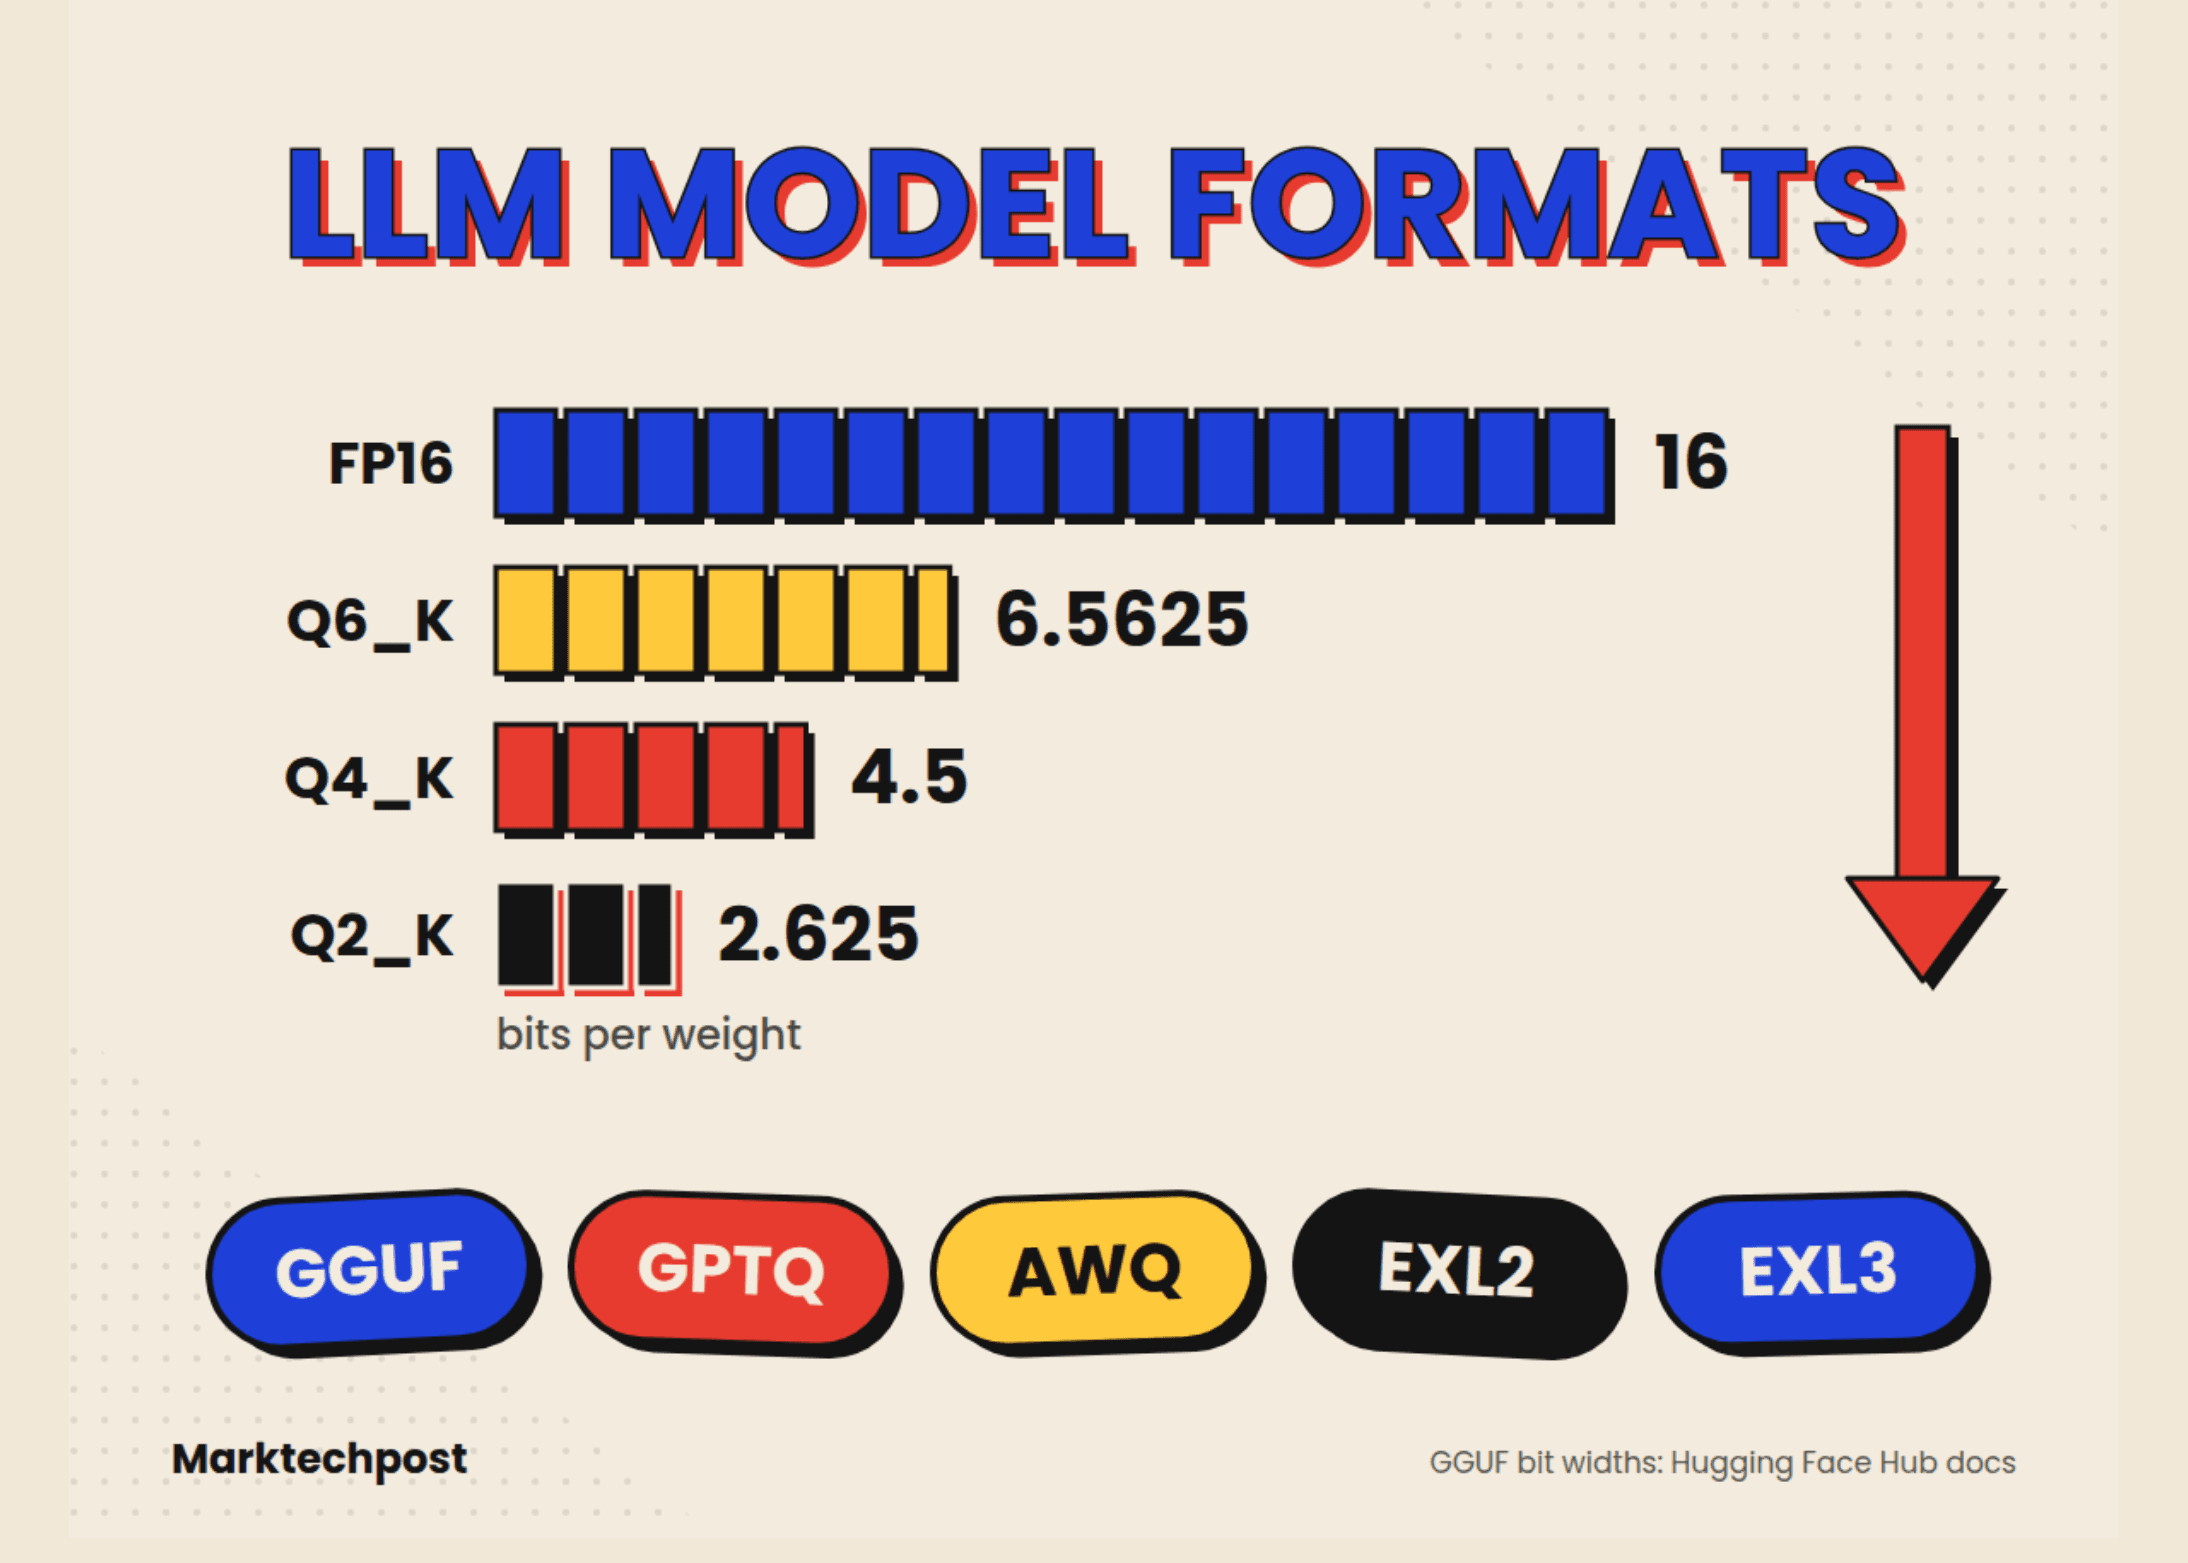
| Q2_K | 16 บล็อก × 16 weights ต่อ super-block, 4-bit scales และ mins | 2.625 |
| Q4_K | 8 บล็อก × 32 weights, 6-bit scales และ mins | 4.5 |
| IQ4_XS | 256-weight super-blocks, ใช้ importance matrix | 4.25 |
| IQ1_S | ตระกูล I-quant เดียวกัน | 1.56 |
หมายเหตุ: ตัวลงท้าย _S, _M, _L คือการผสมประเภท quant ในเลเยอร์ต่างๆ เช่น Q4_K_M จะมีบิตเรตเฉลี่ยสูงกว่า 4.5 เล็กน้อยเพราะสลับใช้ Q6_K ในบางส่วนเพื่อให้แม่นยำขึ้น
คุณภาพเทียบกับขนาด
ตารางอ้างอิงสำหรับ Llama-2-7B แสดงความสัมพันธ์ระหว่างความแม่นยำและขนาดไฟล์:
| Quant | Perplexity | การเปลี่ยนแปลงเทียบกับ FP16 | ขนาด |
|---|---|---|---|
| FP16 | 5.9565 | เกณฑ์อ้างอิง | 13.0 GB |
| Q8_0 | 5.9584 | +0.03% | 7.0 GB |
| Q4_K_M | 6.0565 | +1.68% | 4.1 GB |
Importance matrix (imatrix)
GGUF สามารถใช้ข้อมูลการสอบเทียบผ่าน llama-imatrix เพื่อคำนวณความสำคัญของข้อมูลจากไฟล์ข้อความ ซึ่งจะช่วยรักษาคุณภาพโมเดลโดยเฉพาะในระดับ 1-bit และ 2-bit ที่หากไม่มี imatrix คุณภาพจะลดลงอย่างมาก
GGUF รันที่ไหน
GGUF เป็นมาตรฐานหลักสำหรับ llama.cpp และซอฟต์แวร์ในระบบนิเวศ เช่น LM Studio, GPT4All และ Ollama สำหรับ vLLM นั้นยังอยู่ในขั้นทดลองและต้องใช้ vllm-gguf-plugin แยกต่างหาก
3. GPTQ
GPTQ เป็นผลงานวิจัยที่ตีพิมพ์ใน ICLR 2023 โดยเน้นไปที่การทำ weight quantization หลังการฝึกแบบ one-shot โดยใช้ข้อมูลอันดับสอง (Hessian) เพื่อชดเชยข้อผิดพลาดจากการปัดเศษ weights ทำให้ต้องการเพียงชุดข้อมูลสอบเทียบขนาดเล็ก
ผลลัพธ์ที่ได้คือสามารถทำ quantization โมเดลพารามิเตอร์ 175B ได้ในเวลาเพียง 4 GPU hours และเพิ่มความเร็วการทำงานได้ถึง 3.25 - 4.5 เท่าบนการ์ด NVIDIA A100/A6000 โดยเสียความแม่นยำน้อยมาก
ในด้านเครื่องมือปี 2026 ไลบรารี AutoGPTQ เดิมถูกเลิกพัฒนาแล้ว โดยมี GPTQModel และ llm-compressor เข้ามาแทนที่เพื่อรองรับการใช้งานบน Transformers, vLLM และ SGLang
4. AWQ
AWQ หรือ Activation-aware Weight Quantization จาก MIT ได้รับรางวัล MLSys 2024 Best Paper Award โดยมีแนวคิดหลักคือการปกป้อง weights ที่สำคัญเพียง 1% ซึ่งตรวจพบได้จากขนาดของ activation
จุดเด่นของ AWQ คือการขยายขนาด (scale) ผ่านการแปลงทางคณิตศาสตร์ทำให้เป็นมิตรกับฮาร์ดแวร์และลดโอกาสเกิด overfitting ปัจจุบัน vLLM แนะนำให้ใช้ llm-compressor สำหรับเวิร์กโฟลว์ AWQ แทน AutoAWQ ที่เลิกใช้งานไปแล้ว
5. EXL2 และ EXL3 (ExLlama)
EXL2 เป็นรูปแบบเฉพาะของ ExLlamaV2 ออกแบบมาเพื่อ GPU ระดับผู้บริโภคโดยเฉพาะ จุดเด่นคือสามารถกำหนดบิตเรตเฉลี่ยได้ละเอียด เช่น 4.65bpw ผ่านการผสมระดับบิตข้ามเลเยอร์โดยอัตโนมัติเพื่อให้ได้คุณภาพสูงสุดในขนาดที่กำหนด
ส่วน EXL3 พัฒนาต่อยอดจาก QTIP โดยใช้เทคนิค trellis-coded quantization ช่วยให้โมเดลขนาดใหญ่อย่าง Llama-3.1-70B สามารถทำงานได้ที่ระดับ 1.6 bits per weight และลงตัวใน VRAM ไม่เกิน 16 GB พร้อมรองรับการประมวลผลแบบขนานและการทำ quantization สำหรับ KV-cache
6. bitsandbytes และ MLX
bitsandbytes (NF4/INT8) มักใช้ในการทำ quantization ทันทีขณะโหลดโมเดล โดยเฉพาะในโหมด 4-bit ของ QLoRA ซึ่งเป็นมาตรฐานสำหรับการปรับจูนโมเดลขนาดใหญ่บน GPU ตัวเดียวโดยไม่ต้องใช้ชุดข้อมูลสอบเทียบ
สำหรับผู้ใช้ Apple Silicon จะมี MLX-LM จากทีมวิจัยของ Apple ที่รองรับการรันและปรับจูนโมเดลในรูปแบบ safetensors ที่ปรับแต่งมาเฉพาะสำหรับชิปตระกูล M
ตารางเปรียบเทียบและการเลือกใช้งาน
| รูปแบบ | การสอบเทียบ | ฮาร์ดแวร์ที่ดีที่สุด | รันไทม์หลัก |
|---|---|---|---|
| GGUF | เสริม | CPU, Apple Silicon | llama.cpp, Ollama |
| GPTQ / AWQ | จำเป็น | GPU ศูนย์ข้อมูล | vLLM, SGLang |
| EXL2 / EXL3 | จำเป็น | GPU NVIDIA ผู้บริโภค | TabbyAPI, ExLlama |
| MLX | ไม่ต้อง | Apple Silicon | MLX-LM |
คำแนะนำการเลือก:
- หากใช้ Mac หรือ CPU เป็นหลัก ให้เลือก GGUF (เริ่มต้นที่ Q4_K_M)
- หากให้บริการผ่าน GPU ศูนย์ข้อมูล สำหรับผู้ใช้จำนวนมาก ให้ใช้ AWQ หรือ GPTQ
- หากเป็น ผู้ใช้คนเดียวบน GPU NVIDIA และต้องการความเร็วสูงสุด ให้เลือก EXL3
- หากต้องการ ปรับจูน (Fine-tuning) แบบประหยัด ให้เลือก bitsandbytes NF4
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร