
Jina AI เปิดตัว jina-ocr-v1 โมเดลวิเคราะห์เอกสารความเร็วสูง
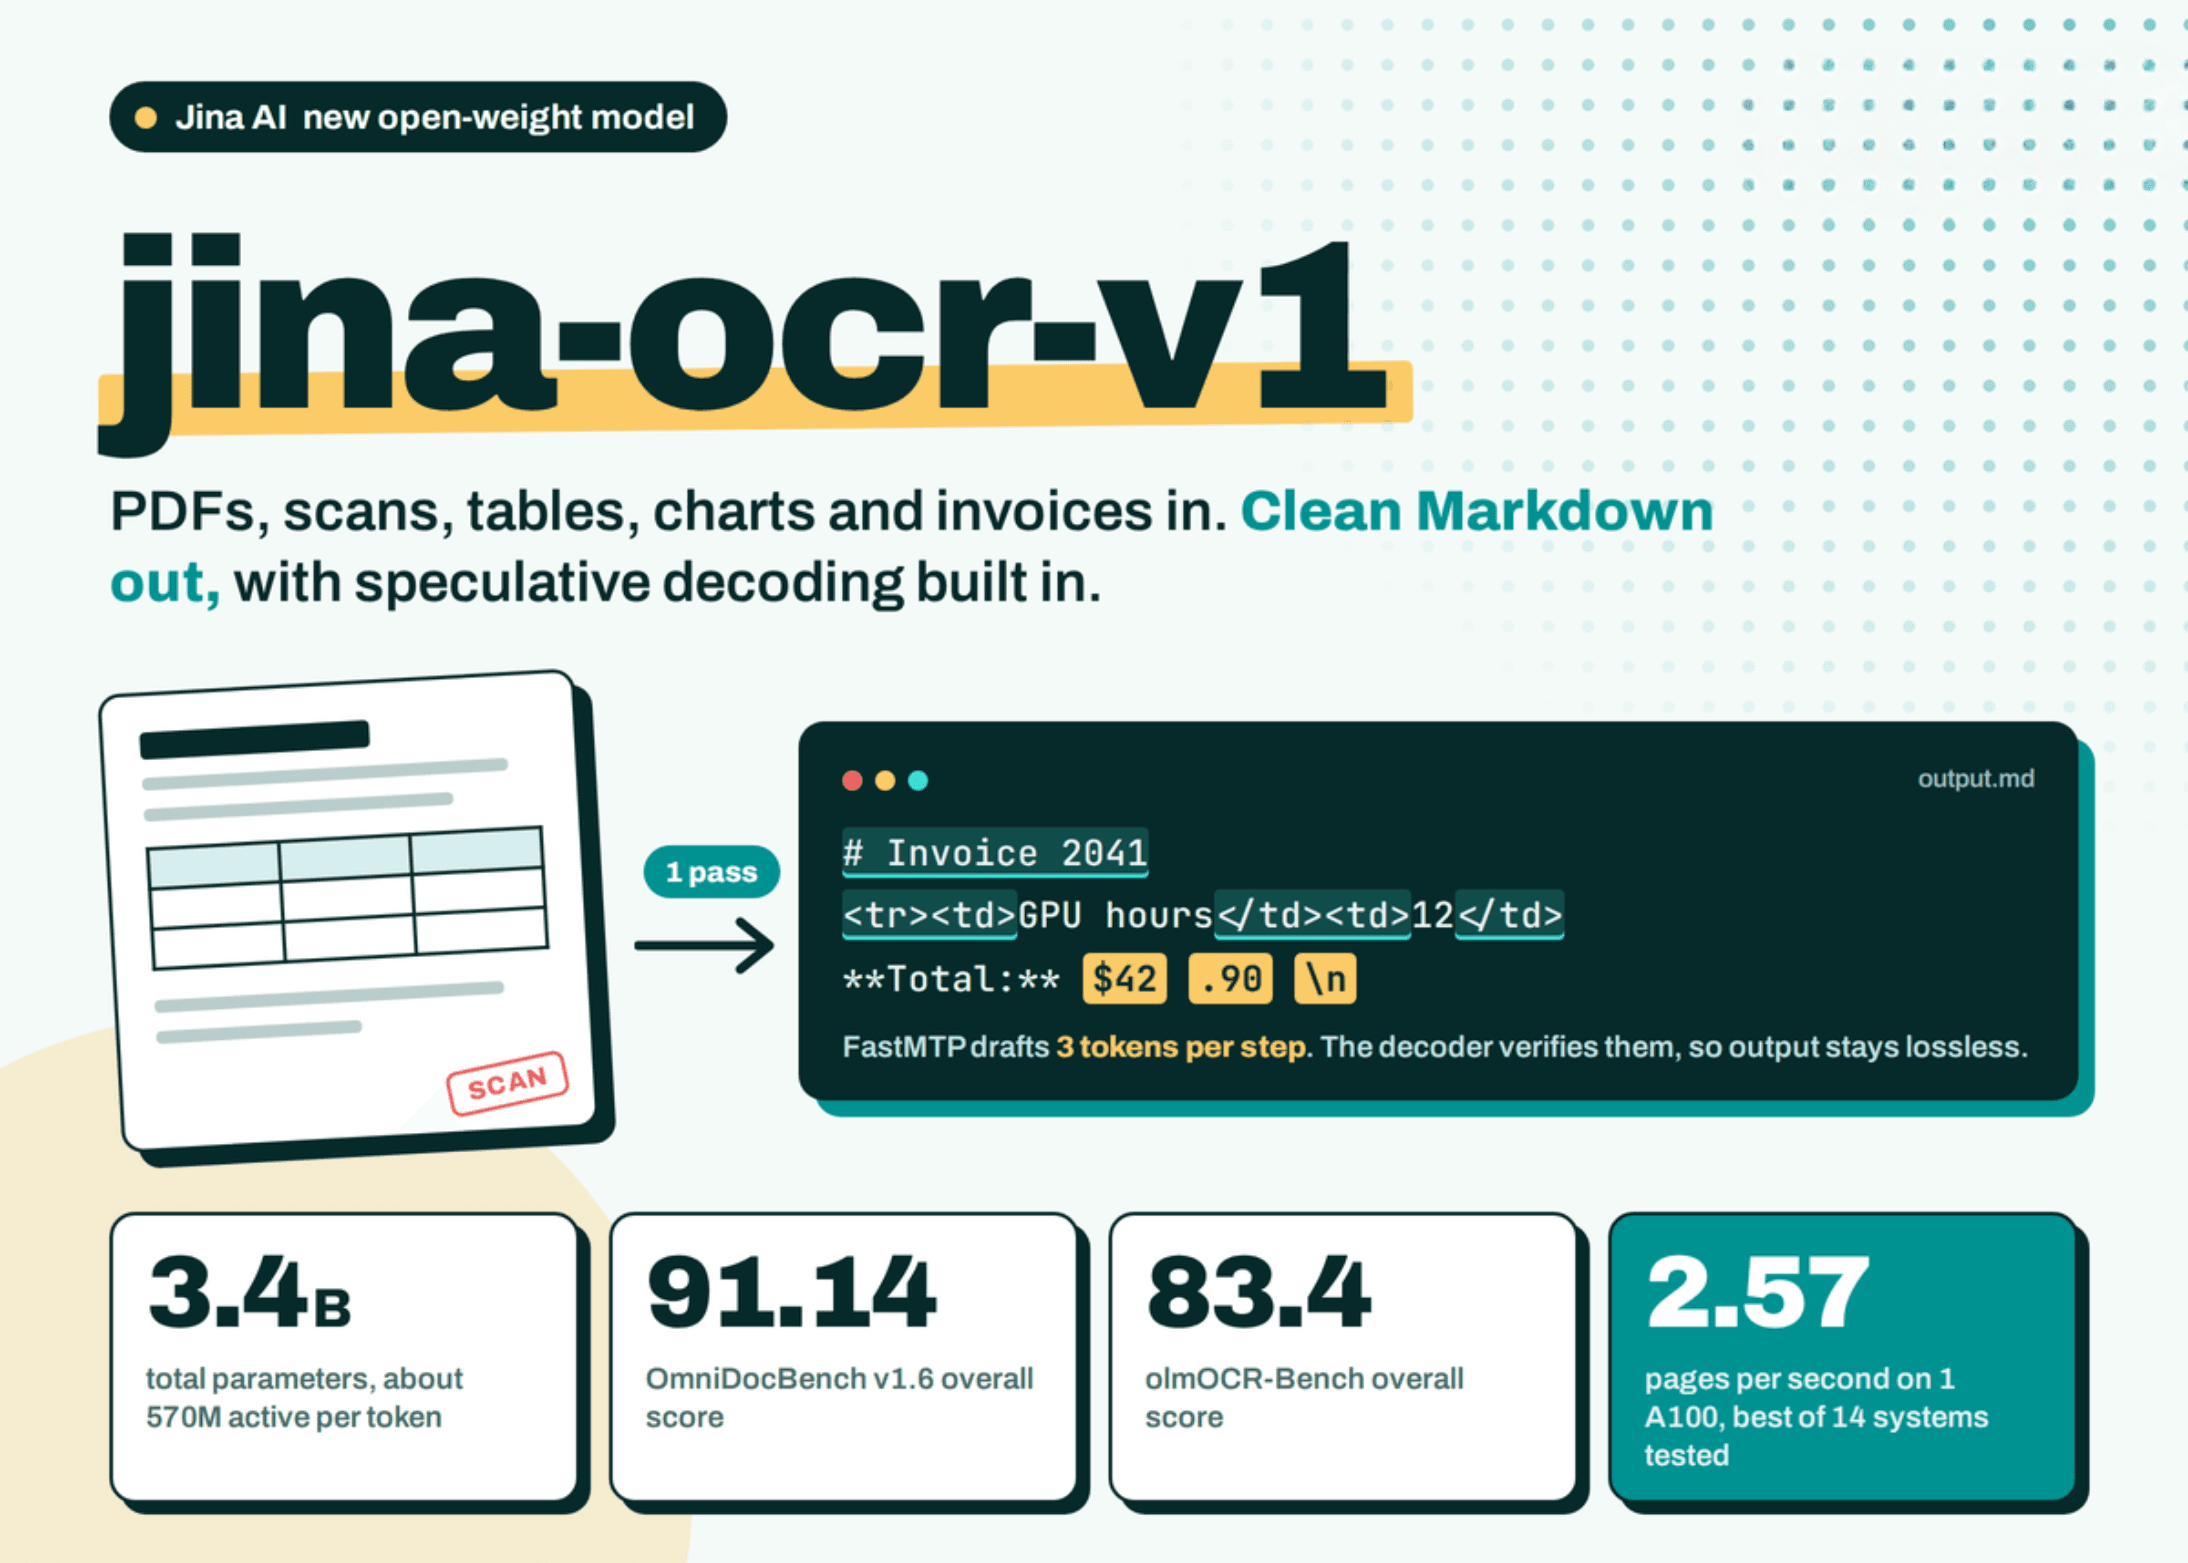
Jina AI ในเครือ Elastic เปิดตัว jina-ocr-v1 โมเดลวิเคราะห์เอกสารแบบ end-to-end ที่สามารถแปลงไฟล์ PDF, ภาพสแกน, ตาราง และใบแจ้งหนี้ให้กลายเป็นรูปแบบ Markdown ที่สะอาดตาได้ในขั้นตอนเดียว โดยตัวโมเดลมีพารามิเตอร์รวม 3.4B และใช้ส่วน decoder ทำงานจริงเพียง 570M ต่อโทเค็น ช่วยให้ประมวลผลได้อย่างมีประสิทธิภาพ
จุดเด่นสำคัญคือการฝังระบบ speculative decoding มาในตัว ทำให้รองรับการใช้งานบน GPU ราคาประหยัดอย่าง NVIDIA L4 ได้เป็นอย่างดี จากรายงานทางเทคนิค technical report พบว่าโมเดลทำคะแนนได้สูงถึง 91.14 บน OmniDocBench v1.6 และ 83.4 บน olmOCR-Bench ซึ่งถือเป็นระดับแนวหน้าของอุตสาหกรรม
สำหรับนักวิจัยและผู้ที่ต้องการใช้งานที่ไม่ใช่เชิงพาณิชย์ สามารถดาวน์โหลด น้ำหนักโมเดลแบบเปิด ขนาด 6.8 GB ในรูปแบบ BF16 ไปใช้งานได้ทันทีผ่าน Transformers หรือ vLLM ภายใต้สัญญาอนุญาตแบบ CC BY-NC 4.0 ส่วนการใช้งานในเชิงพาณิชย์จำเป็นต้อง ติดต่อ Jina AI เพื่อขอรับสิทธิ์
jina-ocr-v1 คืออะไร?
โมเดลนี้ได้รับการพัฒนาต่อยอด (post-train) จาก DeepSeek-OCR โดยยังคงประสิทธิภาพของ DeepEncoder ขนาด 380M ที่ผสานการทำงานของ SAM, ตัวบีบอัด convolutional 16x และ CLIP-L เข้าด้วยกัน ระบบสามารถเปลี่ยนภาพหน้ากระดาษความละเอียด 1024×1024 ให้กลายเป็น visual tokens ได้สูงสุดถึง 1,156 tokens ผ่านโหมดความละเอียดแบบไดนามิก
ในส่วนของ decoder ใช้โครงสร้าง DeepSeek-3B-MoE ประกอบด้วย 12 layers และระบบ Top-6 routing ที่ช่วยให้ประมวลผลได้รวดเร็ว โดยรองรับบริบทสูงสุด 32,768 ตำแหน่ง ผลลัพธ์ที่ได้จะอยู่ในรูปแบบ Markdown โดยเปลี่ยนตารางเป็น HTML และแสดงสูตรทางคณิตศาสตร์เป็น LaTeX เพื่อความสะดวกในการนำไปใช้งานต่อ
การทำงานของ FastMTP Speculative Decoding เนื่องจากผลลัพธ์ของ OCR มักมีโครงสร้างที่ชัดเจน Jina AI จึงนำเทคโนโลยี FastMTP มาใช้ร่วมกับ speculative decoding เพื่อร่างโทเค็นล่วงหน้า 3 โทเค็นต่อขั้นตอน โดยใช้พารามิเตอร์ของร่างที่คงที่เพื่อเพิ่มความเร็วในการทำงาน
ระบบจะทำการตรวจสอบโทเค็นที่ร่างไว้อย่างแม่นยำ หากข้อมูลตรงกับสิ่งที่ decoder เลือกจะถือว่าเป็นโบนัสความเร็วทันที กระบวนการนี้ช่วยให้โมเดลใส่โทเค็นได้เฉลี่ย 2.73 โทเค็นต่อขั้นตอน โดยที่คุณภาพของข้อความยังคงถูกต้อง 100% เทียบเท่ากับการประมวลผลแบบปกติ (lossless)
การทำ Post-Training ด้วย Dense Verifiable Rewards
Jina AI ใช้เทคนิคการฝึกฝนขั้นสูงที่ผสมผสานระหว่าง instruction alignment และการปรับจูนความทนทาน ร่วมกับ GRPO โดยมีการให้รางวัลผ่านโค้ดที่ตรวจสอบความถูกต้องของเนื้อหา สูตร ตาราง และโครงสร้างอย่างละเอียด เพื่อให้มั่นใจว่าหน้าเอกสารที่มีความซับซ้อนจะถูกประมวลผลออกมาได้แม่นยำที่สุด
นอกจากนี้บริษัทยังได้สร้างชุดข้อมูล JinaOCRSynth ซึ่งเป็นหน้าจำลองเอกสารที่อัดแน่นไปด้วยสูตรและตาราง เพื่อใช้ในการทดสอบ unit tests ในรูปแบบ olmOCR-Bench โดยเฉพาะ ทำให้โมเดลมีความสามารถในการจัดการกับเอกสารเชิงวิชาการและรายงานทางธุรกิจที่ซับซ้อนได้เหนือกว่าโมเดลรุ่นก่อนหน้า
เกณฑ์มาตรฐานและประสิทธิภาพการประมวลผล
| Model | Params as listed in the paper | OmniDocBench v1.6 | olmOCR-Bench |
|---|---|---|---|
| jina-ocr-v1 | 3B/570M | 91.14 | 83.4 |
| DeepSeek-OCR | 3B/570M | not listed | 76.0 |
| DeepSeek-OCR-2 | 3B/570M | 90.25 | not listed |
| PaddleOCR-VL-1.6 | 0.9B | 96.34 | not listed |
| chandra-ocr-2 | 4B | not listed | 85.8 |
| Qwen3-VL-235B | 235B/22B | 89.78 | not listed |
ในด้านประสิทธิภาพการประมวลผล (Throughput) jina-ocr-v1 สามารถวิเคราะห์ได้ถึง 2.57 หน้าต่อวินาทีบน A100 1 ตัว ซึ่งถือเป็นความเร็วที่สูงที่สุดในบรรดา 14 ระบบที่ Jina AI ทำการทดสอบ โดยให้ผลลัพธ์ที่กระชับและแม่นยำสูงเมื่อเทียบกับคู่แข่งในระดับเดียวกัน
สำหรับการใช้งานบน NVIDIA L4 ระบบสามารถเพิ่มความเร็วในการสร้างโทเค็นได้สูงสุดถึง 1.95 เท่าเมื่อเทียบกับการประมวลผลแบบเดิม แสดงให้เห็นถึงประสิทธิภาพที่ยอดเยี่ยมแม้จะทำงานบนฮาร์ดแวร์ระดับเริ่มต้น
วิธีการรันโมเดล
ผู้ที่สนใจสามารถทดลองใช้งานผ่าน Jina Reader ได้ง่ายๆ เพียงส่ง URL ไปที่ r.jina.ai พร้อมระบุส่วนหัว X-Respond-With: jina-ocr-v1 เพื่อให้ระบบแปลงหน้าเว็บหรือ PDF เป็น Markdown ทันที หรือจะใช้งานผ่าน API ที่รองรับรูปแบบของ OpenAI ก็ได้เช่นกันที่ ตัวอย่างสาธิต
สำหรับการติดตั้งใช้งานเอง (self-hosting) สามารถดึงโค้ดจาก repository โดยตั้งค่า trust_remote_code=True โดยหากต้องการใช้ความสามารถ FastMTP อย่างเต็มที่ จำเป็นต้องใช้ vLLM เวอร์ชัน 0.21 ขึ้นไป เพื่อประสิทธิภาพสูงสุดในการประมวลผลเอกสารจำนวนมาก
สรุปประเด็นสำคัญ
- พารามิเตอร์รวม 3.4B ทำงานจริงประมาณ 570M ต่อโทเค็น พัฒนาบน DeepSeek-OCR
- FastMTP ร่าง 3 โทเค็นต่อขั้นตอน และการตรวจสอบแบบ greedy ทำให้การถอดรหัสไม่สูญเสียคุณภาพ
- ทำคะแนนได้ 91.14 บน OmniDocBench v1.6 และ 83.4 บน olmOCR-Bench
- ประมวลผลได้ถึง 2.57 หน้าต่อวินาทีบน A100 1 ตัว ซึ่งสูงที่สุดจาก 14 ระบบที่วัดผล
- พร้อมใช้งานแล้ววันนี้บน Hugging Face และผ่านส่วนหัวของ Jina Reader
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร