
Nunchux AI เปิดตัว VC-Attention เร่งความเร็ววิดีโอ AI สูงสุด 3.5 เท่า
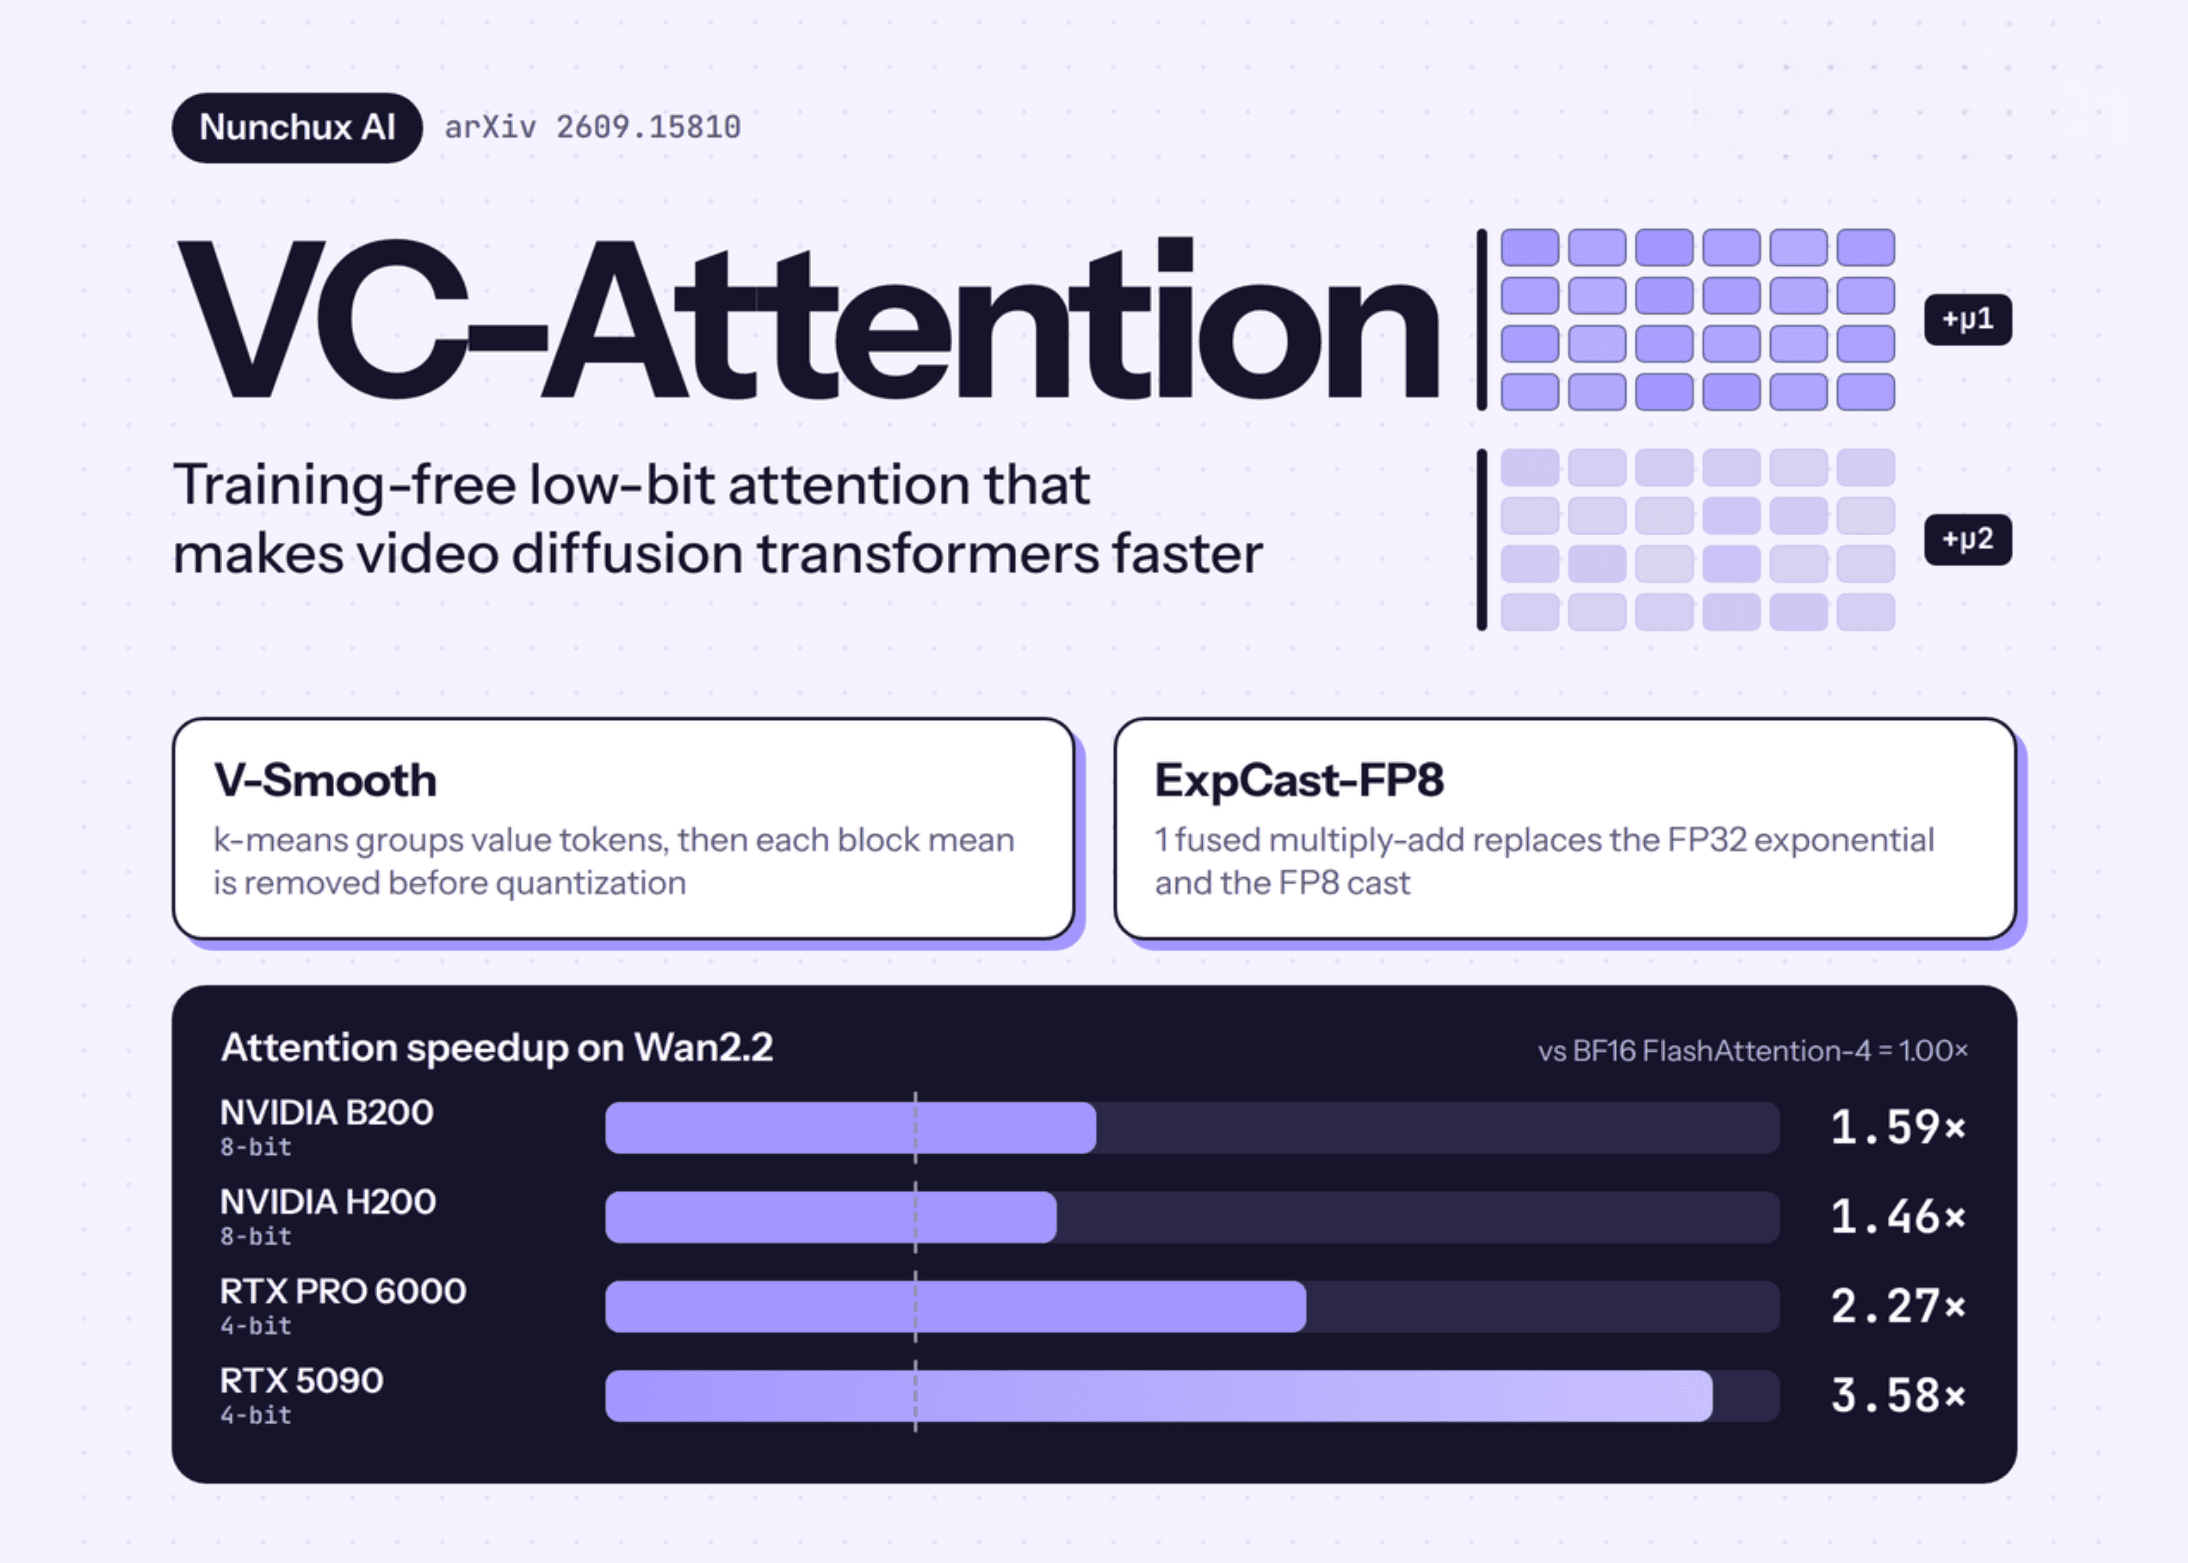
Nunchux AI ได้เปิดตัว VC-Attention ซึ่งเป็น low-bit attention kernel แบบไม่ต้องเทรน (training-free) ที่สร้างขึ้นสำหรับ video Diffusion Transformers (DiTs) โดยมุ่งเป้าไปที่ 2 ปัญหาพร้อมกัน ได้แก่ ข้อผิดพลาดจากการทำ quantization ของค่า value และขั้นตอน softmax ที่ล่าช้า
ทำไม Attention จึงเป็นคอขวดของวิดีโอ
ในสถาปัตยกรรม Video DiTs ระบบจะทำการ flatten คลิปวิดีโอให้เป็น sequence ของ spatiotemporal tokens และรัน full self-attention ในทุกเลเยอร์ ยกตัวอย่างเช่น คลิปจากโมเดล Wan2.2-14B ความละเอียด 720p ความยาว 5 วินาที จะประกอบด้วยโทเคนประมาณ 70,000 ตัว ซึ่งเมื่อประมวลผลบน RTX 5090 ขั้นตอน attention เพียงอย่างเดียวต้องใช้เวลามากกว่า 64% ของเวลาการสร้างทั้งหมด ทีมวิจัยระบุว่า attention คิดเป็นสัดส่วนถึงสองในสามของทุกขั้นตอน denoising ของ MiniMax-H3 บนชิป B200 เพียงตัวเดียว
แม้ Low-bit Tensor Cores จะช่วยเร่งความเร็วการคูณเมทริกซ์ QK และ PV ได้ แต่ยังคงมีอุปสรรคสำคัญ 2 ประการ ประการแรกคือวิธีการเดิมอย่าง SageAttention2 ที่ใช้การ smooth queries และ keys พบว่าค่า value ยังคงเป็นสาเหตุของ error ในเอาต์พุตถึง 82% บนโมเดล Wan2.2 ประการที่สองคือขั้นตอน softmax ที่ยังต้องรันในรูปแบบ FP32 ซึ่งบนชิป B200 และ H200 ขั้นตอนการหาค่า exponential และการแปลงกลับเป็น FP8 กลายเป็นส่วนที่ใช้เวลานานที่สุดในกระบวนการ
V-Smooth: การแก้ไข Value Outliers
ทีมวิจัยพบว่า Value outliers มักแฝงตัวอยู่ในโทเคนเพียงไม่กี่ตัว และช่องสัญญาณจะเปลี่ยนไปตาม heads, layers และ steps ซึ่งการหมุนแบบ Hadamard ไม่สามารถกำจัดออกไปได้เนื่องจากเป็นการรักษา token norms ไว้ โดยการหมุน V ช่วยลดค่า value error ได้เพียง 0.2% เท่านั้น
V-Smooth จึงเลือกใช้วิธีการที่ต่างออกไปดังนี้:
- Group: ใช้ online k-means รวมกลุ่ม value tokens ต่อ batch และ head โดยสลับลำดับ keys และ values ไปพร้อมกัน ทำให้เอาต์พุตของ non-causal attention ไม่เปลี่ยนแปลง
- Demean: แต่ละบล็อกฮาร์ดแวร์ขนาด 128 โทเคนจะถูกลบด้วยค่าเฉลี่ยของมัน และนำเฉพาะส่วนที่เหลือ (residual) ไปทำ quantization แบบ per-channel E4M3 ที่ 8 bits หรือ NVFP4 ที่ 4 bits
- Restore: บวกค่าเฉลี่ยกลับเข้าไปโดยใช้ผลรวมแถวที่ online softmax เก็บไว้อยู่แล้ว ทำให้ไม่จำเป็นต้องรันรอบสองหรือใช้ buffer เพิ่มเติม
จากการทดสอบค่าเฉลี่ยของ Wan2.2 จำนวน 100 heads พบว่าการหักค่าเฉลี่ยช่วยขจัดพลังงานของบล็อกออกไปได้ 8-36% ตามลักษณะของข้อมูล โดยมีต้นทุนเพิ่มเพียง 0.125 bit ต่อ element ของ value ทั้งนี้ Grouping จะรันเฉพาะในช่วง 25% แรกของขั้นตอน denoising และนำลำดับที่สลับไว้กลับมาใช้ซ้ำในขั้นตอนติดกัน ทำให้มีต้นทุนเวลาเพียง 3-4% ของช่วง attention
ExpCast-FP8: การขจัดคอขวดของ Softmax เนื่องจากไบต์แบบ E4M3 มีค่าใกล้เคียงกับค่าลอการิทึมในตัวอยู่แล้ว ExpCast-FP8 จึงเขียนไบต์โดยตรงจากคะแนนในโดเมน log ด้วยการทำ fused multiply-add เพียงครั้งเดียว โดยใช้ค่าคงที่ β = -0.35 เพื่อปรับสมดุลข้อผิดพลาดที่เหลือโดยไม่ต้องปรับจูนแยกตามโมเดล
วิธีนี้สามารถเขียนไบต์ได้ตรงกับวิธี FP32 แบบดั้งเดิมถึง 79.6% และกรณีอื่นๆ คลาดเคลื่อนเพียงเล็กน้อย โดยการวัดใน 204.8K แถวของ Wan2.2 พบค่าความคลาดเคลื่อนเฉลี่ยเพียง 1.6% เท่านั้น นอกจากนี้การใช้ CuTe/CUDA fusion ที่เขียนขึ้นเองสำหรับ preprocessing chain ยังช่วยลดเวลาเรียกใช้ V-Smooth จาก 42.2 ms เหลือเพียง 4.8 ms บนชิป B200
เกณฑ์มาตรฐาน (Benchmarks)
การทดสอบครอบคลุม video DiTs แบบ open-weight 4 รุ่น ได้แก่ Wan2.2-T2V-A14B, LongCat-Video, HunyuanVideo-1.5 และ MiniMax-H3 โดยวัดความแม่นยำเทียบกับ FlashAttention-4 แบบ BF16
| GPU (Wan2.2) | ความแม่นยำ | ความเร็ว Attention ที่เพิ่มขึ้น | ความเร็ว End-to-end ที่เพิ่มขึ้น |
|---|---|---|---|
| B200 | 8-bit | 1.59× | 1.19× |
| H200 | 8-bit | 1.46× | 1.13× |
| RTX PRO 6000 | 4-bit | 2.27× | 1.36× |
| RTX 5090 | 4-bit | 3.58× | 1.70× |
บน B200 VC-Attention ทำงานเร็วกว่า SageAttention2 ถึง 6.02× เนื่องจากรายหลังยังไม่มี Blackwell kernel ส่วนบนการ์ดจอระดับเวิร์กสเตชัน V-Smooth แบบ 4-bit ให้ประสิทธิภาพเทียบเท่าหรือดีกว่า SageAttention3 โดยมีความต่างด้านความแม่นยำเป็นตัวตัดสินสำคัญ
ด้านผลลัพธ์ความแม่นยำ (Fidelity) พบว่าที่ 8 bits V-Smooth ให้ค่า PSNR ดีกว่า SageAttention2 ในทุกโมเดลที่ทดสอบ ส่วนที่ 4 bits ก็สามารถเอาชนะ SageAttention3 ได้อย่างชัดเจน โดยเฉพาะบน Wan2.2 ที่ดีกว่าถึง 2.9 dB ขณะที่การใช้ Nunchux Attention ซึ่งเป็นกรรมสิทธิ์ของบริษัท สามารถเร่งความเร็วบน B200 ได้ถึง 1.91× สำหรับ MiniMax-H3
เทคนิคนี้เน้นการลดต้นทุนต่อการปฏิสัมพันธ์ จึงสามารถใช้งานร่วมกับวิธีอื่นอย่าง sparse attention (Sparse VideoGen หรือ Radial Attention) ได้ทันที รวมถึงการทำ distillation ปัจจุบัน Nunchux ยังไม่ได้ปล่อย kernel สู่สาธารณะ แต่เปิดให้ลงทะเบียน Modelverse waitlist เพื่อรอใช้งาน MiniMax-H3 ฟรีเร็วๆ นี้
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร