
เปิดตัว GLiFormer: Encoder สกัดข้อมูล Nested JSON แม่นยำระดับ GPT-4
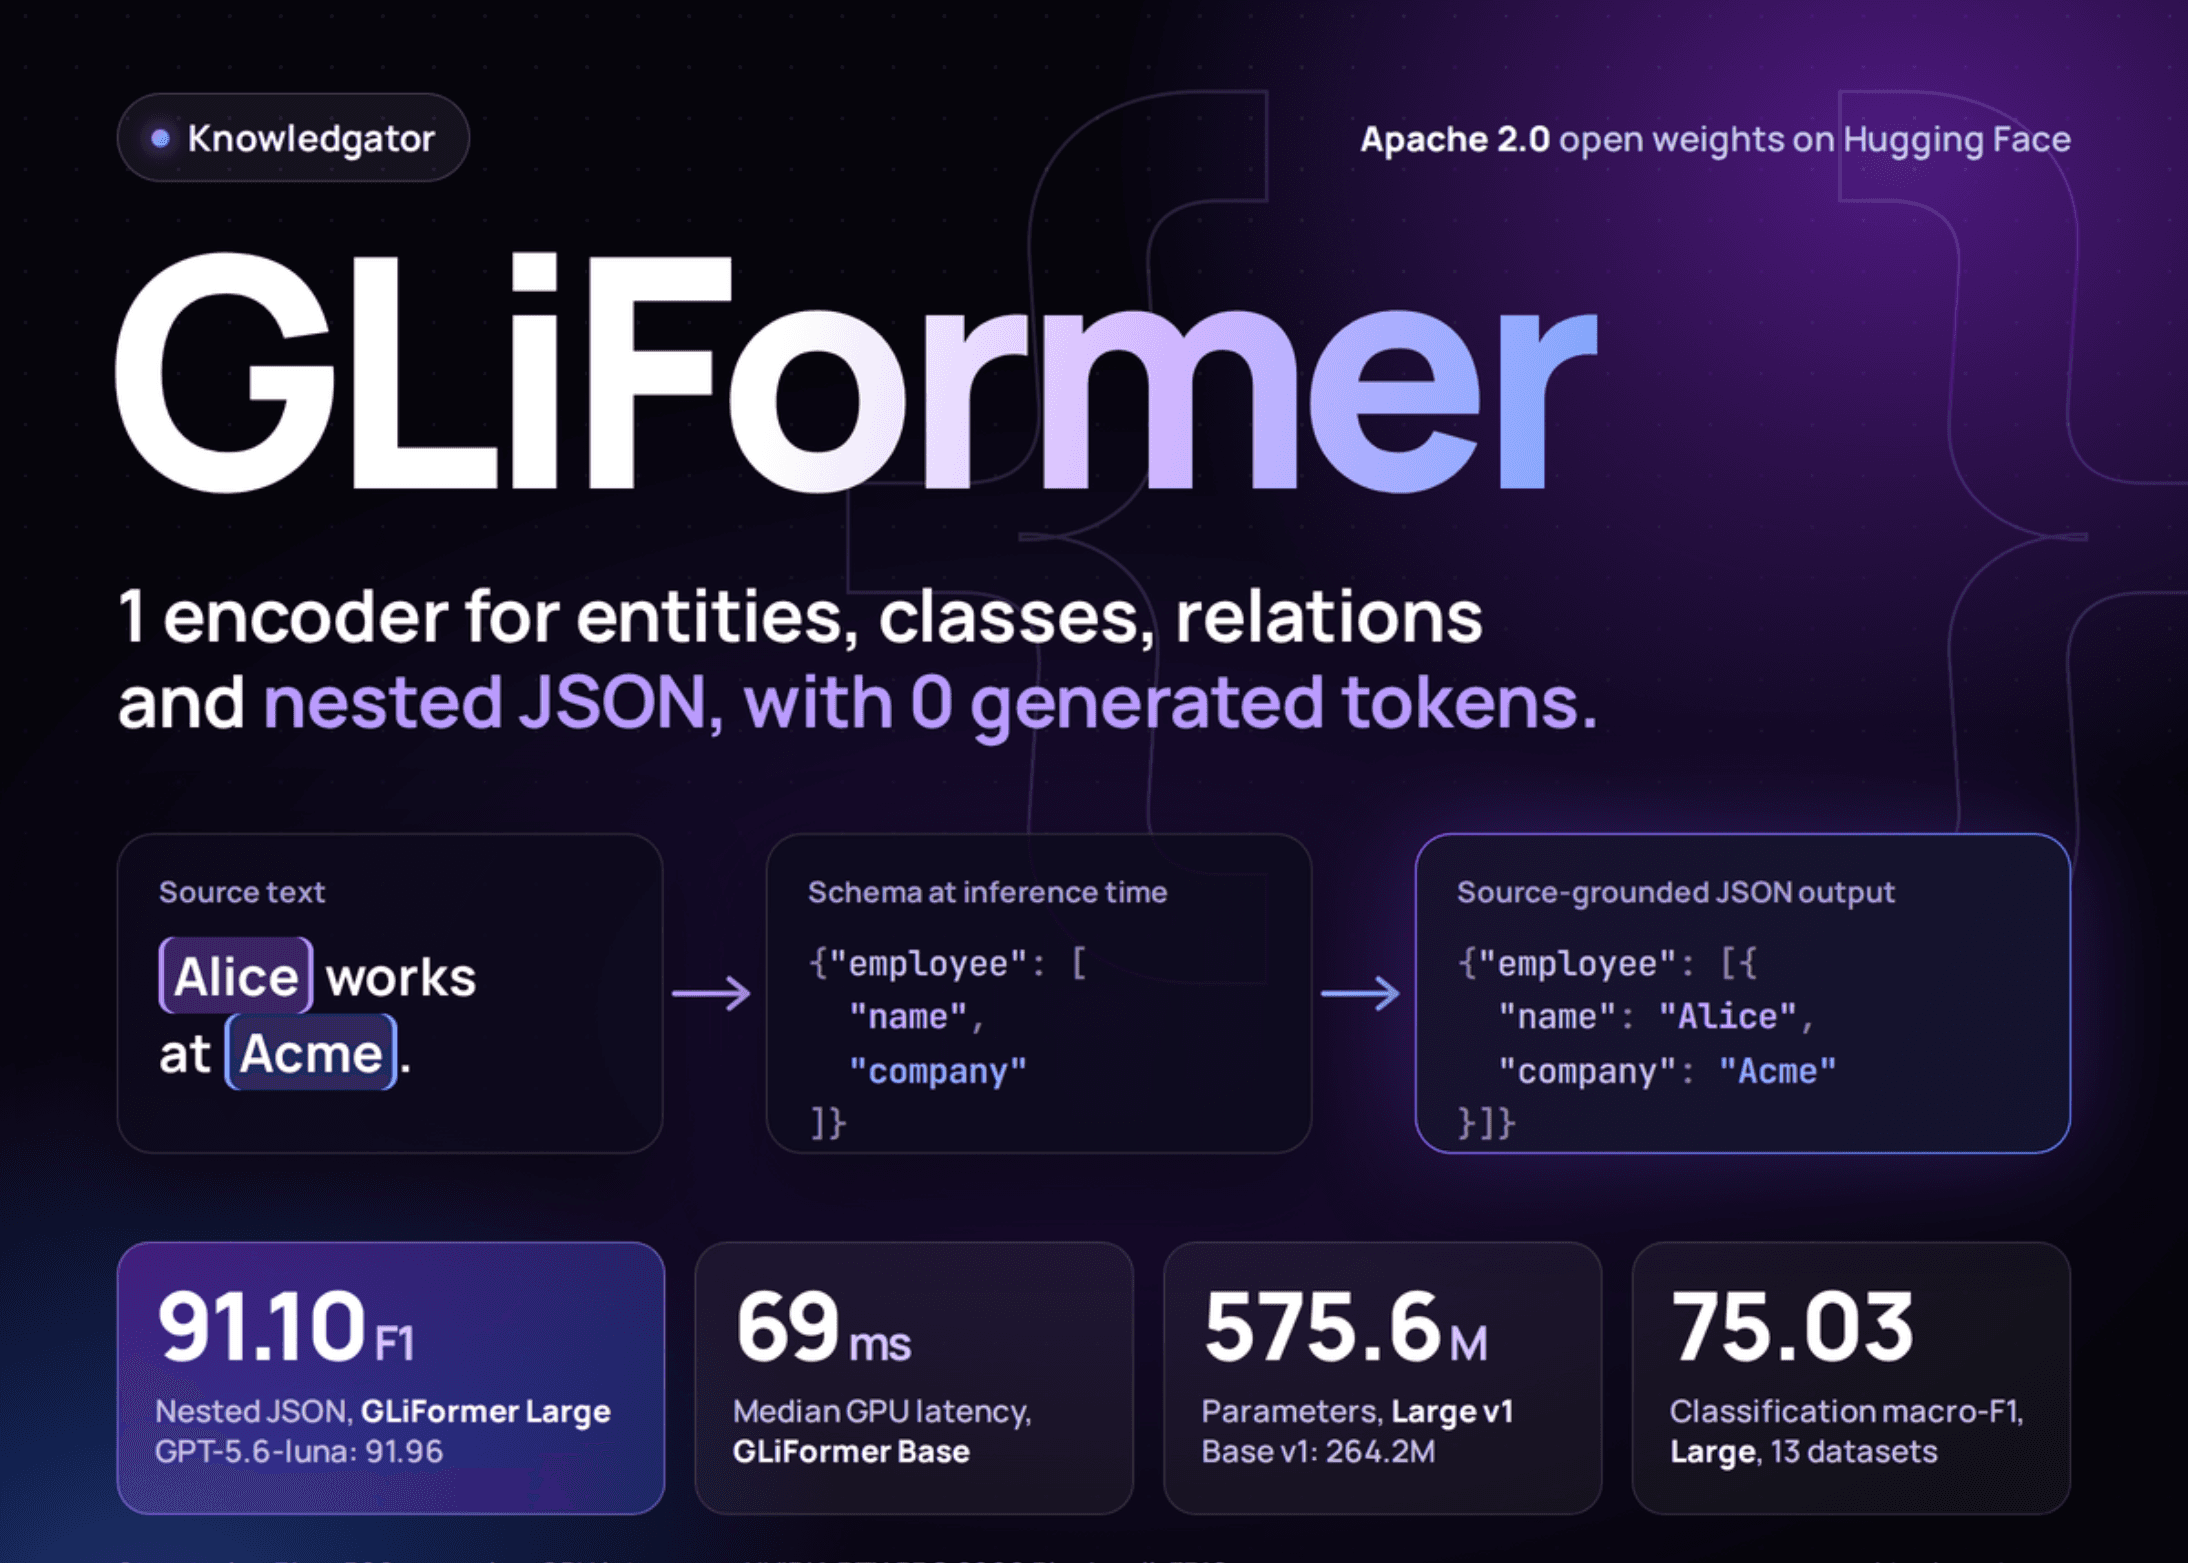
Knowledgator Engineering เปิดตัว GLiFormer เฟรมเวิร์ก encoder แบบ schema-conditioned ที่ออกแบบมาเพื่อการสกัดข้อมูลโดยเฉพาะ โมเดลเดียวสามารถรองรับการทำงานได้หลากหลาย ตั้งแต่การจดจำเอนทิตี (NER), การจำแนกประเภทข้อความ, การสกัดความสัมพันธ์ ไปจนถึงการจัดโครงสร้าง nested JSON และการทำ text embeddings โดยผู้ใช้สามารถส่ง label และ schema เข้าไปในขณะเรียกใช้งาน (inference) ได้ทันที
ปัจจุบันมีโมเดลให้เลือกใช้งานสองรุ่นบน Hugging Face ได้แก่ GLiFormer Base v1 ขนาด 264.2 ล้านพารามิเตอร์ และ GLiFormer Large v1 ขนาด 575.6 ล้านพารามิเตอร์ ทั้งคู่ใช้สัญญาอนุญาตแบบ Apache 2.0 สามารถติดตั้งได้ง่ายผ่านคำสั่ง pip install gliformer และรองรับการทำงานทั้งบน CPU และ GPU
ปัญหาที่มุ่งเป้าแก้ไข โดยปกติแล้ว ระบบสกัดข้อมูลมักต้องเชื่อมต่อโมเดลแยกกันหลายตัวเพื่อทำหน้าที่ต่างกัน เช่น ตัวหนึ่งติดแท็ก อีกตัวจำแนก และตัวที่สามจัดระเบียบข้อมูลใหม่ แต่ ทีมวิจัย มองว่างานเหล่านี้มีแกนหลักที่เหมือนกันคือการ encode แหล่งข้อมูลและจับคู่ความเข้ากันได้
แม้ LLM จะสามารถสร้าง nested JSON ได้ แต่ต้องสร้างข้อมูลทีละ token รวมถึงเครื่องหมายวรรคตอนต่างๆ ซึ่งอาจทำให้เกิดความล่าช้าและข้อผิดพลาด แต่ GLiFormer ได้ตัดขั้นตอนการสร้าง output (generation) ออกไป ทำให้การประมวลผลรวดเร็วและแม่นยำยิ่งขึ้น
GLiFormer ทำงานอย่างไร
GLiFormer พัฒนาต่อยอดมาจาก GLiNER โดยใช้แนวคิด 'anchor' ในการจับคู่ label ซึ่งอาจเป็นได้ทั้งกลุ่มเวกเตอร์ คู่เอนทิตี หรือช่องว่างในเรคคอร์ด ข้อมูลจะถูก encode เพียงครั้งเดียวแต่รองรับหลาย schema พร้อมกัน ทำให้ประมวลผลงานหลายประเภทได้ในรอบเดียว
กระบวนการจัดโครงสร้างข้อมูลแบ่งเป็น 4 ขั้นตอน:
- ระบุค่าฟิลด์ (Ground field values) โดยดึงจากข้อความต้นฉบับโดยตรง
- กำหนดช่วงข้อความให้กับช่องเรคคอร์ด (unordered record slots) ด้วยวิธี Hungarian matching
- ทำนายความสัมพันธ์แบบพ่อ-ลูกตามเส้นทางที่ schema กำหนด
- ประกอบเป็น nested JSON ด้วยตัวถอดรหัสแบบกำหนดผลลัพธ์ตายตัว (deterministic decoder) เนื่องจากโมเดลใช้วิธีดึงช่วงข้อความจากต้นฉบับ จึงช่วยป้องกันปัญหาการสร้างข้อมูลเท็จที่ไม่มีอยู่ในอินพุต อย่างไรก็ตาม ยังมีความเสี่ยงที่การเลือกช่วงข้อความหรือการจัดลำดับชั้นอาจเกิดข้อผิดพลาดได้
Checkpoints และการฝึกฝน
โมเดล v1 ทั้งสองรุ่นมาพร้อมกับหัวประมวลผล 5 ด้าน ได้แก่ NER, classification, joint relations, multilevel structuring และ embeddings โดยกำหนดความกว้างช่วงข้อความสูงสุด 12 คำ และรองรับ anchor เรคคอร์ดได้ถึง 100 รายการ รายละเอียดเพิ่มเติมสามารถศึกษาได้ที่ เอกสารโมเดลที่ฝึกไว้ล่วงหน้า
| รายละเอียด | Base v1 | Large v1 |
|---|---|---|
| พารามิเตอร์ | 264.2M | 575.6M |
| ชั้นของ Encoder | 12 | 24 |
| มิติของ Embedding | 768 | 1024 |
ค่า max_len ที่กำหนดไว้ | 16,384 | 8,192 |
โมเดลรุ่น Base เริ่มต้นจากโครงสร้าง DeBERTa ที่ผ่านการฝึกเพิ่มเติมด้วย 1 แสนล้าน token โดยมีตัวอย่างการฝึกแบบ multitask กว่า 1.3 ล้านรายการ และอีก 3.7 แสนรายการสำหรับการปรับแต่งเฉพาะงาน
ผลการทดสอบ (Benchmarks)
ข้อมูลจาก Knowledgator ระบุว่าในการสกัด Nested JSON รุ่น Large ทำคะแนน F1 ได้ 91.10 ซึ่งใกล้เคียงกับ GPT-4 (91.96) และทิ้งห่าง GPT-4o-mini (82.56) อย่างเห็นได้ชัด ส่วนการจำแนกประเภทข้อความ รุ่น Large ทำคะแนนเฉลี่ยได้ 75.03 macro-F1 ซึ่งสูงกว่า GLiNER2.5 รุ่นเดิม
อย่างไรก็ตาม ในด้านการสกัดความสัมพันธ์ รุ่น Large ทำได้เฉลี่ย 21.33 micro-F1 ซึ่งยังตามหลังโมเดลเฉพาะทางอย่าง GLiNER-Relex แต่ในภาพรวมของงาน NER และการจำแนกประเภท รุ่น Large สามารถเอาชนะโมเดลที่มีขนาดใหญ่กว่า 14 เท่าอย่าง Gemma-7B-IT ได้ในบางการทดสอบ
ความเร็วที่เหนือกว่าด้วยการไม่สร้าง Token
จากการทดสอบความหน่วง (latency) กับเอกสาร 40 ฉบับบน GPU NVIDIA RTX 6000 Ada รุ่น Base มีค่ามัธยฐานเพียง 69 ms ส่วนบน CPU AMD EPYC อยู่ที่ 547 ms ซึ่งเร็วกว่าการใช้ LLM แบบเดิมที่ต้องรอสร้าง token ทีละตัว โดยทีมวิจัยประเมินว่าอาจเร็วกว่าเดิมได้สูงสุดถึง 95.8 เท่าในเชิงทฤษฎี
วิธีการใช้งาน
ผู้ใช้สามารถดูตัวอย่างการใช้งานได้จาก GitHub repo หรือ model card ซึ่งแสดงการเรียกใช้งานแบบง่ายๆ ดังนี้:
records = model.structure(
"Alice works at Acme.",
{"employee": ["name", "company"]},
)
print(records)
# {'employee': [{'name': 'Alice', 'company': 'Acme'}]}
โมเดลรองรับ Schema แบบ Nested Pydantic สำหรับเรคคอร์ดหลายระดับ และสามารถรันงานสกัดเอนทิตีไปพร้อมกับการจัดโครงสร้างได้ในการประมวลผลครั้งเดียว
สรุปประเด็นสำคัญ
- GLiFormer รวบรวมงาน NER, Classification และ Nested JSON ไว้ใน Encoder เดียว
- ประสิทธิภาพในงานจัดโครงสร้างข้อมูล (Structuring) ใกล้เคียงกับโมเดลระดับท็อปอย่าง GPT-4
- ความหน่วงต่ำมากเพียง 69 ms บน GPU เพราะไม่ต้องเสียเวลาสร้าง output tokens
- เป็นโมเดล Open Source (Apache 2.0) ที่ติดตั้งและรันได้เองภายในองค์กร
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร