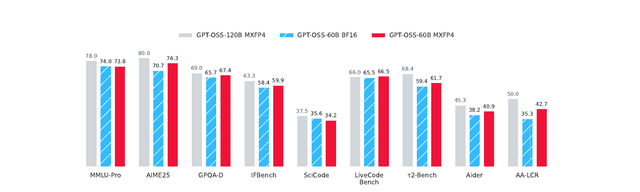
Quantization-Aware Healing: พลิกโฉมโมเดล 4-bit ให้แม่นยำกว่าต้นฉบับ 16-bit แม้ถูกบีบอัดtag: Large Language Models, Model Compression, Nvidia, OpenAI, QAH, QuantizationAug 26, 2026 · By: AttapolKนักวิจัยเปิดตัวเทคนิค Quantization-Aware Healing (QAH) ที่ช่วยฟื้นฟูประสิทธิภาพของโมเดลภาษาขนาดใหญ่หลังการบีบอัด ทำให้โมเดลขนาด 4-bit มีความแม่นยำสูงกว่าโมเดลต้นฉบับ 16-bit ในขณะที่ประหยัดทรัพยากรมากกว่าเดิม