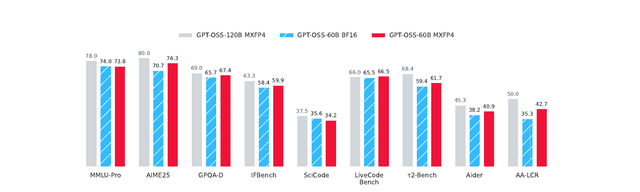
Quantization-Aware Healing: พลิกโฉมโมเดล 4-bit ให้แม่นยำกว่าต้นฉบับ 16-bit แม้ถูกบีบอัดtag: Large Language Models, Model Compression, Nvidia, OpenAI, QAH, QuantizationAug 26, 2026 · By: AttapolKนักวิจัยเปิดตัวเทคนิค Quantization-Aware Healing (QAH) ที่ช่วยฟื้นฟูประสิทธิภาพของโมเดลภาษาขนาดใหญ่หลังการบีบอัด ทำให้โมเดลขนาด 4-bit มีความแม่นยำสูงกว่าโมเดลต้นฉบับ 16-bit ในขณะที่ประหยัดทรัพยากรมากกว่าเดิม
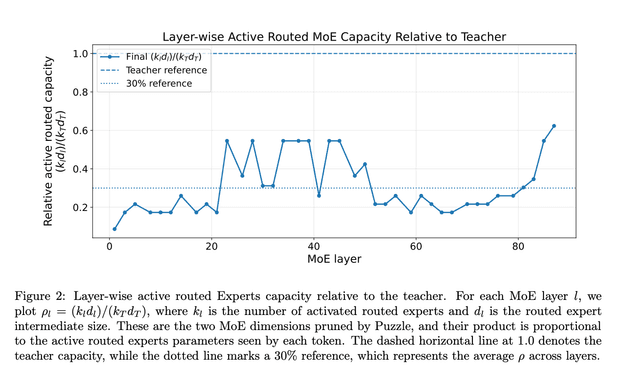
NVIDIA เปิดตัว Nemotron-Labs-3-Puzzle-75B-A9B: โมเดล Hybrid MoE ฉบับบีบอัด เร่ง Throughput สูงขึ้น 2.03 เท่าtag: Hybrid MoE, Mamba, Model Compression, Nemotron-Labs-3-Puzzle-75B-A9B, NvidiaJul 17, 2026 · By: AttapolKNVIDIA เปิดตัวโมเดลบีบอัด Nemotron-Labs-3-Puzzle-75B-A9B ที่ใช้เทคนิค Iterative Puzzle ช่วยลดขนาดพารามิเตอร์ลงแต่ยังคงประสิทธิภาพสูง เพิ่มความเร็วในการประมวลผลเซิร์ฟเวอร์ได้สูงสุดกว่า 2 เท่า และรองรับ 1M-token บน H100 ได้พร้อมกันถึง 8 รีเควส