
Quantization-Aware Healing: พลิกโฉมโมเดล 4-bit ให้แม่นยำกว่าต้นฉบับ 16-bit แม้ถูกบีบอัด
การลดขนาดโมเดลภาษาขนาดใหญ่ (LLM) มักมีราคาที่ต้องจ่ายเสมอ สูตรมาตรฐานในปัจจุบันคือการบีบอัดสถาปัตยกรรมด้วยการตัด layer หรือพารามิเตอร์ออก จากนั้นจึงทำ quantization น้ำหนักที่เหลือให้เหลือ 4 bits เพื่อประหยัดหน่วยความจำและการประมวลผล ทว่ากระบวนการเหล่านี้มักส่งผลเสียต่อขีดความสามารถหลัก เช่น การใช้เหตุผล การแก้โจทย์คณิตศาสตร์ และการเขียนโค้ด ทำให้ต้องมีขั้นตอน "การเยียวยา" (healing) ก่อนนำไปใช้งานจริง ดังที่เห็นในโมเดลชื่อดังอย่าง gpt-oss, ตระกูล Nemotron ของ NVIDIA และ Hypernova 60B ที่ล้วนใช้แนวทางบีบอัดแล้วเยียวยาทั้งสิ้น
บทความวิจัยล่าสุดเรื่อง Quantization-Aware Healing: A Practical Recipe for Recovering Compressed, 4-Bit LLMs ได้นำเสนอเทคนิค Quantization-Aware Healing (QAH) เพื่อแก้ปัญหาการกู้คืนประสิทธิภาพที่วงการยังหาข้อสรุปไม่ได้ ผลการทดสอบกับโมเดล GPT-OSS 120B ที่ถูกบีบอัดเหลือ 60B และทำ quantization เป็น MXFP4 พบว่าโมเดล 4-bit นี้สามารถเอาชนะเวอร์ชัน full-precision (bfloat16) ของตัวมันเองได้ใน 7 จาก 9 แบบทดสอบ (benchmarks) ซึ่งเป็นการทำลายกฎความเชื่อเดิมที่ว่าโมเดล 4-bit จะต้องด้อยกว่า 16-bit เสมอไป
ทำไมวิธีการเยียวยาแบบปกติถึงใช้ไม่ได้ผลดีที่นี่
กระบวนการเพิ่มประสิทธิภาพทั่วไปประกอบด้วยสามขั้นตอนคือ บีบอัดสถาปัตยกรรม, ทำ quantization และเยียวยาความเสียหาย ซึ่งจุดต่างสำคัญอยู่ที่ขั้นตอนสุดท้าย
วิธีที่นิยมที่สุดคือ quantization-aware training (QAT) ซึ่งจะจำลองการทำ quantization ในระหว่างการฝึกฝนเพื่อให้น้ำหนักเรียนรู้การทนต่อความแม่นยำต่ำ แต่วิธีนี้มีค่าใช้จ่ายสูงและมักจะไม่เสถียรหากฝึกฝนเกินจุดที่เหมาะสม ขณะที่อีกทางเลือกคือ quantization-aware distillation (QAD) ที่ใช้การกลั่นกรองความรู้จาก teacher แบบ full-precision แต่เมื่อโมเดลมีการบีบอัดโครงสร้างร่วมด้วย (ไม่ใช่แค่ลดบิต) จะทำให้ไม่มีโมเดล teacher ที่มีโครงสร้างเดียวกันเป๊ะๆ ส่งผลให้เพดานความแม่นยำถูกจำกัดไว้ที่ตัว teacher ที่ถูกกู้คืนมาเท่านั้น
แนวทางของเรา
QAH ทลายข้อจำกัดดังกล่าวด้วยการกลั่นกรองความรู้โดยตรงจากโมเดลต้นฉบับก่อนการบีบอัด แทนที่จะมาจากโมเดลที่กู้คืนมาแล้ว ทำให้ teacher และ student ไม่จำเป็นต้องมีสถาปัตยกรรมเหมือนกัน แม้ teacher จะมีขนาดเต็มและความแม่นยำสูง แต่ student ที่มีขนาดเพียงครึ่งเดียวในรูปแบบ MXFP4 ก็สามารถเรียนรู้ผ่าน output distribution ของ teacher ได้โดยตรง
วิธีนี้เปลี่ยนมุมมองต่อ quantization จากเดิมที่เป็นเพียงขั้นตอนหลังการประมวลผลที่ทำให้เสียข้อมูล ให้กลายเป็นการกลั่นกรองความรู้รอบที่สองที่เข้มข้นกว่าเดิม Student แบบ 4-bit จึงไม่ใช่แค่การชดเชยข้อมูลที่หายไป แต่เป็นการเก็บรับข้อมูลใหม่ที่ขั้นตอนก่อนหน้าทำไม่สำเร็จ
นอกจากนี้ QAH ยังให้ความเสถียรที่สูงกว่าด้วย KL distillation ซึ่งช่วยให้โมเดลคงที่เมื่อถึงจุดสูงสุด ต่างจาก cross-entropy task loss ที่มักผลักดันจนโมเดลเริ่มเสื่อมสภาพ และเพื่อให้รองรับบริบทที่ยาวได้ (long context) ทีมวิจัยได้ใช้ chunked KL-divergence loss ที่ประหยัดหน่วยความจำ ช่วยให้การเยียวยาระดับ 32k-token ทำได้ภายใต้งบประมาณ GPU ที่จำกัด ซึ่งรายละเอียดเพิ่มเติมได้เคยกล่าวถึงใน โพสต์ก่อนหน้า
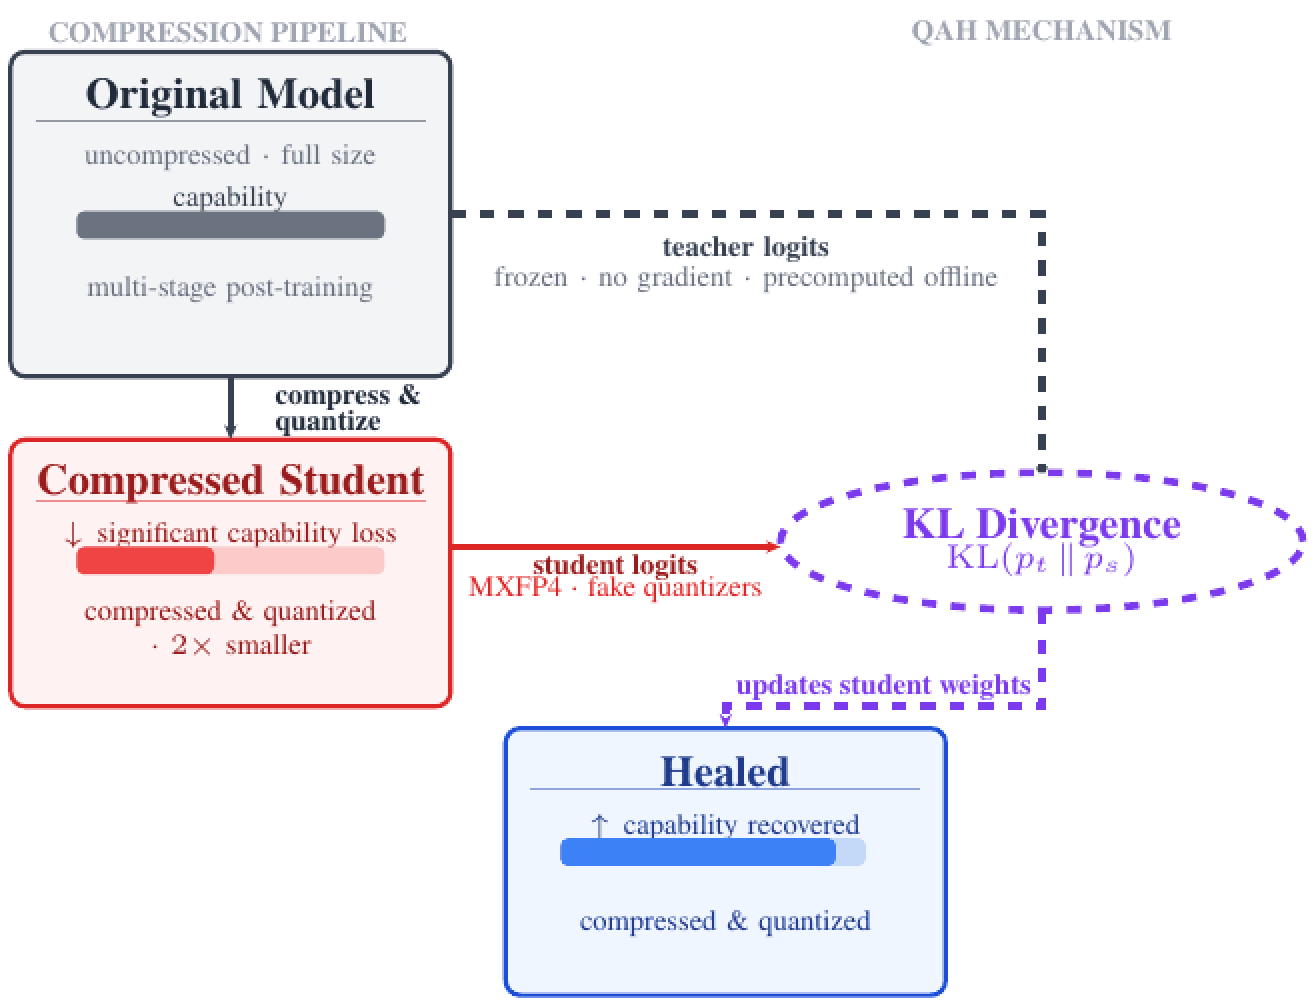
ภาพรวมของ QAH หลังจากบีบอัดโครงสร้างและทำ quantization ขีดความสามารถจะลดลงอย่างรวดเร็ว QAH กลั่นกรองความรู้จากโมเดลต้นฉบับ ซึ่งเป็น teacher ที่ถูกแช่แข็งและมีการคำนวณ logits ไว้ล่วงหน้าแบบ offline แทนที่จะเป็นจาก checkpoint ที่กู้คืนมา ที่มา: รูปประกอบที่ 1 ในบทความวิจัย
ผลลัพธ์
จากการทดสอบ QAH กับ GPT-OSS 120B ที่บีบอัดเหลือ 60B และทำ quantization เป็น MXFP4 พบว่าโมเดล QAH ชนะ bfloat16 checkpoint ในสถาปัตยกรรมเดียวกันถึง 7 จาก 9 แบบทดสอบ
| Benchmark | 120B teacher (MXFP4) | 60B BF16 (recovered) | 60B MXFP4 (QAH) | QAH vs BF16 |
|---|---|---|---|---|
| AA-LCR (long-context reasoning) | 50.0 | 35.3 | 42.7 | +7.4 |
| AIME 2025 (math) | 80.0 | 70.7 | 76.3 | +5.6 |
| Aider (agentic coding) | 45.3 | 38.2 | 40.9 | +2.7 |
| τ²-bench (tool use) | 68.4 | 59.4 | 61.7 | +2.3 |
| GPQA Diamond (science) | 69.0 | 65.7 | 67.4 | +1.7 |
| IFBench (instruction following) | 63.3 | 58.4 | 59.9 | +1.5 |
| LiveCodeBench (coding) | 66.0 | 65.5 | 66.5 | +1.0 |
| MMLU-Pro (knowledge) | 78.0 | 74.0 | 73.8 | −0.2 |
| SciCode (science coding) | 37.5 | 35.6 | 34.2 | −1.4 |
แม้ในบางรายการจะตามหลังครูฝึกอยู่บ้าง แต่โมเดล 4-bit นี้กลับนำหน้าข้อมูล 16-bit ของตัวเองอย่างชัดเจน โดยเฉพาะในการใช้เหตุผลบริบทที่ยาว (+7.4 บน AA-LCR) และวิชาคณิตศาสตร์ (+5.6 บน AIME 2025)
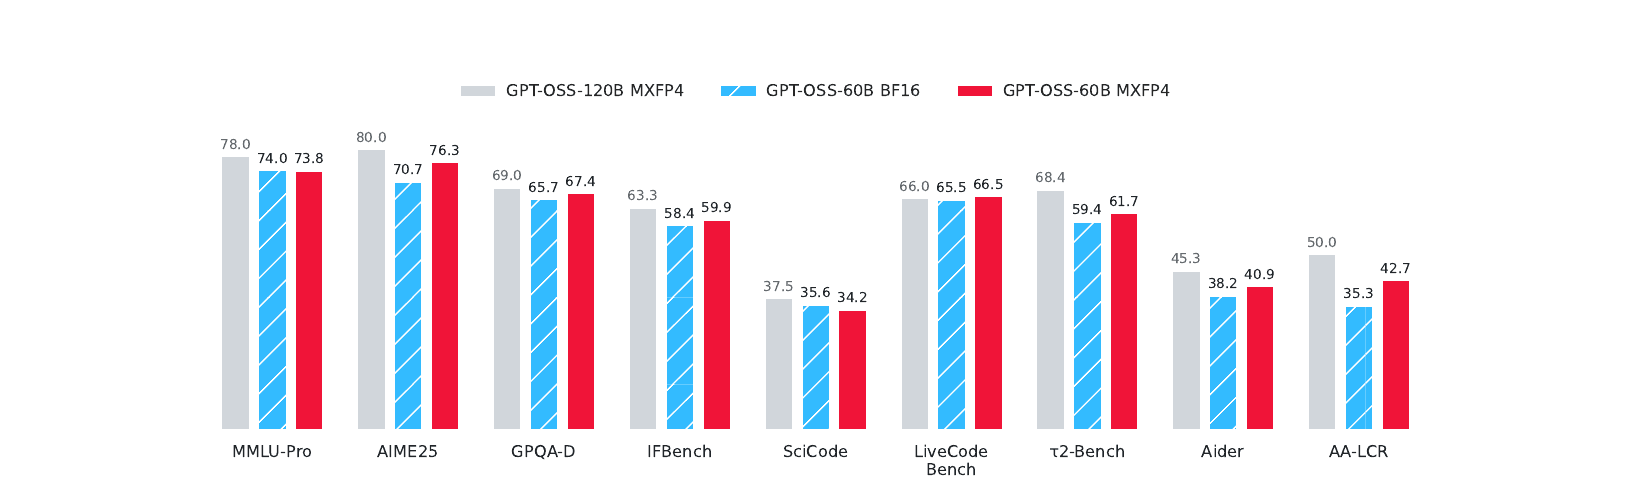
โมเดล 4-bit QAH มีประสิทธิภาพเทียบเท่าหรือดีกว่าแหล่งข้อมูล bfloat16 ใน 7 จาก 9 แบบทดสอบ และเอาชนะ teacher ขนาดเต็มใน LiveCodeBench ที่มา: รูปประกอบที่ 2 ในบทความวิจัย
QAH เทียบกับ QAT แบบตัวต่อตัว
เมื่อเปรียบเทียบ QAH กับ QAT โดยตรงผ่านโมเดล GPT-OSS 9B พบว่าทั้งสองวิธีให้ความแม่นยำสูงสุดในระดับเดียวกัน แต่ QAH ถึงจุดสูงสุดเร็วกว่า QAT ถึง 7 เท่า (ใช้เพียง 100 steps เทียบกับ 700 steps) และที่สำคัญคือ QAH ยังคงความเสถียรไว้ได้ตลอดการฝึกที่เหลือ ขณะที่ QAT พังทลายลงอย่างรวดเร็วหลังผ่านจุดสูงสุดไปเพียงไม่กี่ร้อย step
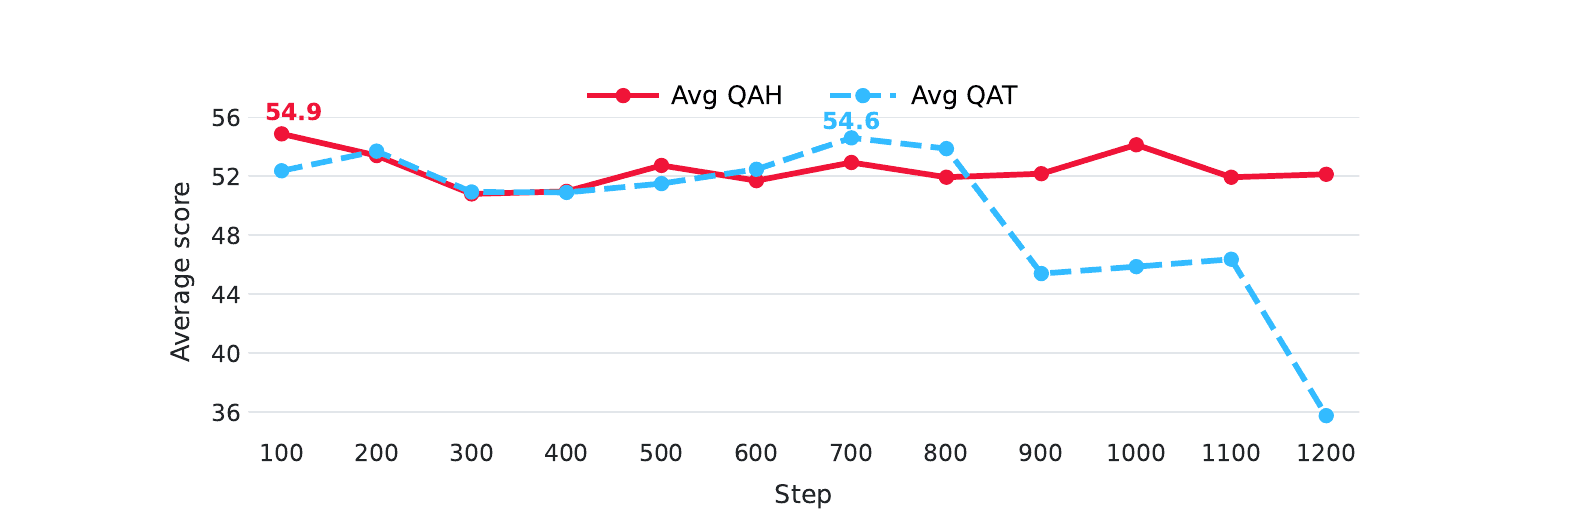
QAH ถึงจุดสูงสุดที่ 54.9 ในประมาณ 100 steps และคงที่ ส่วน QAT ถึง 54.6 ที่ประมาณ step 700 จากนั้นเสียคะแนนไปเกือบ 19 คะแนนที่ step 1,200 ที่มา: รูปประกอบที่ 3 ในบทความวิจัย
สิ่งนี้เปลี่ยนแปลงอะไรในทางปฏิบัติ
โมเดล QAH ขนาด 4-bit ใช้หน่วยความจำน้อยกว่า student แบบ bfloat16 ถึง 4 เท่า และด้วยจำนวนพารามิเตอร์ที่ลดลงครึ่งหนึ่ง จึงช่วยให้การประมวลผลต่อ token เร็วขึ้นเกือบ 8 เท่าเมื่อเทียบกับต้นฉบับ
ข้อสรุปที่น่าตื่นเต้นคือ โมเดลที่ถูกบีบอัดไม่จำเป็นต้องด้อยประสิทธิภาพเสมอไป ด้วยสูตร QAH นี้ โมเดลสามารถมีขนาดเล็กลง ประหยัดต้นทุนขึ้น และมีความแม่นยำสูงขึ้นได้พร้อมกัน ทำให้ Quantization ไม่ใช่ภาระที่ต้องจ่ายอีกต่อไป แต่เป็นโอกาสในการยกระดับโมเดลให้ดียิ่งขึ้น
สำหรับผู้ที่สนใจรายละเอียดเชิงลึกเกี่ยวกับกระบวนการเยียวยาและการนำไปใช้ สามารถอ่านเพิ่มเติมได้ที่ บทความวิจัยฉบับเต็ม
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร