
NVIDIA เปิดตัว Nemotron-Labs-3-Puzzle-75B-A9B: โมเดล Hybrid MoE ฉบับบีบอัด เร่ง Throughput สูงขึ้น 2.03 เท่า
โมเดล hybrid MoE ขนาดใหญ่อย่าง Nemotron-3-Super แม้จะมีความแม่นยำสูงแต่ก็แลกมาด้วยค่าใช้จ่ายในการให้บริการ (serve) ที่แพง เนื่องจากพารามิเตอร์ขณะทำงาน, KV cache และสถานะ Mamba ของโมเดลเหล่านี้เป็นตัวจำกัดจำนวนผู้ใช้ที่โหนดหนึ่งจะรองรับได้ ณ อัตราความเร็วที่กำหนด ทีม NVIDIA AI จึงเปิดตัว Nemotron-Labs-3-Puzzle-75B-A9B ซึ่งเป็นรุ่นบีบอัดของ Nemotron-3-Super โดยลดพารามิเตอร์รวมจาก 120.7B เหลือ 75.3B และลดพารามิเตอร์ขณะทำงานจาก 12.8B เหลือ 9.3B
เป้าหมายของการพัฒนาครั้งนี้ถูกกำหนดไว้ชัดเจนก่อนเริ่มการค้นหาสถาปัตยกรรม คือหนึ่ง ต้องเพิ่ม throughput ของเซิร์ฟเวอร์ให้ได้ 2 เท่าที่ความเร็ว 100 tokens ต่อวินาทีต่อผู้ใช้ และสอง ต้องรองรับรีเควสระดับ 1M-token พร้อมกันได้ 8 รายการบน H100 เครื่องเดียว โดยปัจจุบันมี checkpoint สามรูปแบบให้เลือกใช้บน Hugging Face ได้แก่ BF16, FP8, และ NVFP4
TL;DR
- บีบอัดพารามิเตอร์รวมจาก 120.7B เหลือ 75.3B (จาก 12.8B เหลือ 9.3B ในช่วงทำงาน) โดยยังคงโครงสร้าง hybrid แบบ 88-block ไว้
- Throughput รวมบน 8xB200 เพิ่มขึ้น 1.60x ถึง 2.14x เมื่อเทียบกับรุ่น Super ที่ระดับ NVFP4 ในอัตราความเร็วต่อผู้ใช้ที่เท่ากัน
- รองรับ 1M-token พร้อมกันบน H100 เครื่องเดียวเพิ่มจาก 1 เป็น 8 รายการ เนื่องจากน้ำหนักโมเดลลดลงจาก 70 GB เหลือ 44.5 GB
- เทคนิค Iterative Puzzle ทำคะแนนเฉลี่ยชนะการบีบอัดแบบขั้นตอนเดียว (single-step) ไป 0.57 จุด ภายใต้เป้าหมายการบีบอัดเดียวกัน
- ประสิทธิภาพที่ลดลงสะท้อนผ่าน Arena-Hard-V2 (-4.2) และ SWE-Bench (-2.6) ขณะที่ RULER และ AA-LCR แทบไม่มีการเปลี่ยนแปลง
Nemotron-Labs-3-Puzzle-75B-A9B
Nemotron-3-Super เป็นโมเดล hybrid Mamba-Transformer MoE โดยรุ่น Puzzle-75B-A9B ยังคงโครงสร้างบล็อกเดิมไว้ทั้งหมด 88 บล็อก แบ่งเป็น 40 Mamba, 40 MoE และ 8 attention blocks
การเปลี่ยนแปลงขนาดขีดความสามารถ (capacity) ภายในบล็อก:
| จำนวน | Super | Puzzle-75B-A9B | สัดส่วน |
|---|---|---|---|
| พารามิเตอร์รวม | 120.7B | 75.3B | 62.4% |
| พารามิเตอร์ขณะทำงาน | 12.8B | 9.3B | 73.1% |
| ขนาดสถานะ Mamba SSM | 128 | 96 | 75% |
| ขนาดระดับกลางของ MoE routed expert | 2688 | 1280-2688 | เฉลี่ย 59.9% |
| จำนวนผู้เชี่ยวชาญที่ถูกเรียกใช้ต่อโทเค็น | 22 | 4-18 | เฉลี่ย 50% |
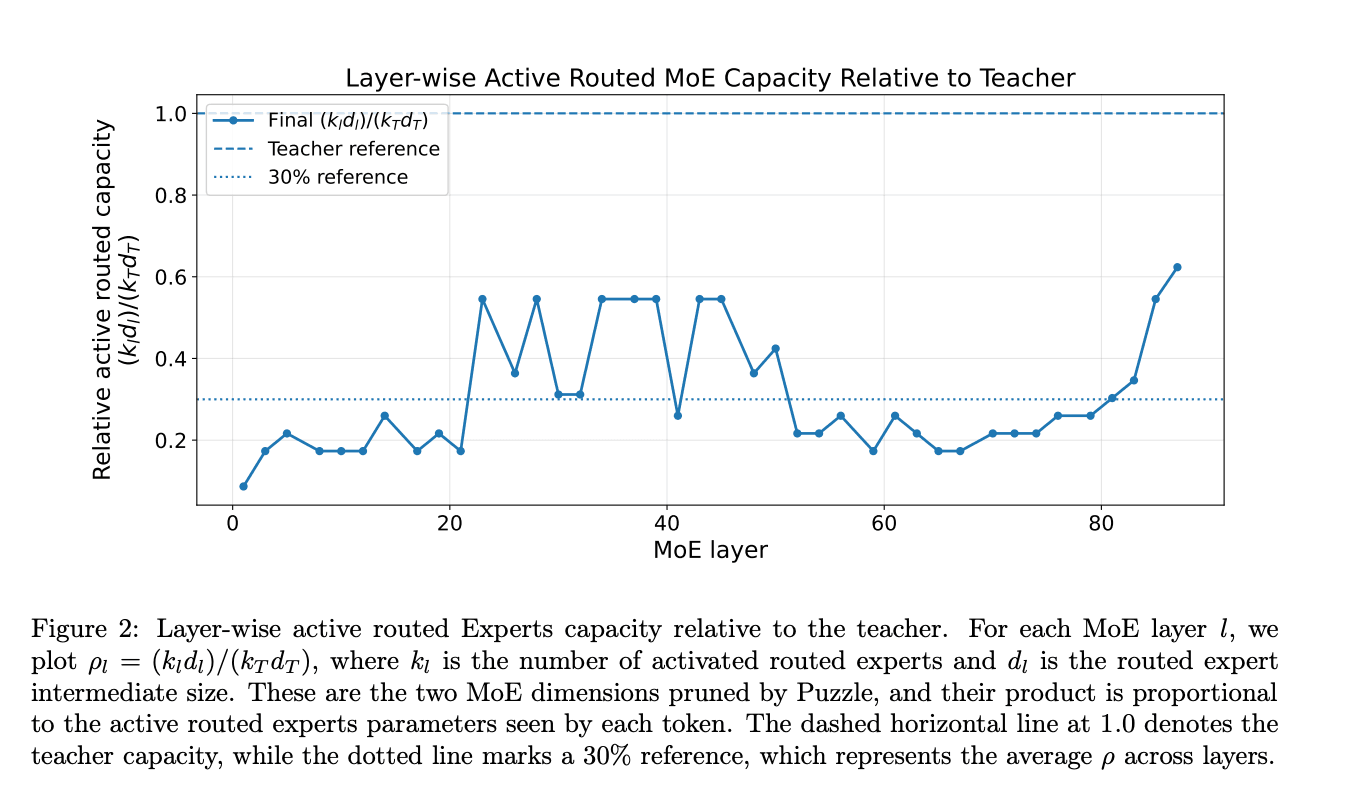
| ขีดความสามารถของผู้เชี่ยวชาญขณะทำงาน (สัมพัทธ์) | 100% | 8.7%-62.3% | เฉลี่ย 30.9% |
ทั้งนี้ จำนวน routed experts, ขนาด shared expert และขนาดเลเยอร์แฝง (latent size) ของ MoE รวมถึงเลเยอร์ Attention ไม่มีการเปลี่ยนแปลง เนื่องจาก Nemotron-3-Super มีความประหยัด KV-cache อยู่แล้ว ส่วนเลเยอร์ Mamba ถูกตัดทอน (pruned) อย่างสม่ำเสมอเพื่อให้รองรับเฟรมเวิร์กการประมวลผลที่ยังมีข้อจำกัดเรื่องขนาดสถานะ SSM
ผลลัพธ์ที่ได้ไม่ใช่การย่อส่วนโมเดลแบบเท่ากันทุกส่วน แต่หากสังเกตจากรูปด้านบนจะเห็นว่าเทคนิค Puzzle เลือกที่จะรักษาขีดความสามารถไว้ในบางเลเยอร์ช่วงกลางและช่วงท้ายที่สำคัญ และตัดลดสัดส่วนอย่างหนักในส่วนอื่นๆ แทน
Benchmark and Performance
ตารางด้านล่างแสดงค่า throughput รวมที่ดีที่สุด (Pareto-optimal) บนโหนด 8xB200 เครื่องเดียว พร้อมการถอดรหัสแบบ single-step
| สถานการณ์ (เข้า/ออก) | UT ต่ำสุด | Super (tok/s) | Puzzle-75B-A9B (tok/s) | การเพิ่มขึ้น |
|---|---|---|---|---|
| 50K / 2K | >= 100 | 5,128 | 8,210 | 1.60x |
| 50K / 2K | >= 125 | 3,784 | 6,412 | 1.69x |
| 50K / 2K | >= 150 | 2,532 | 4,523 | 1.79x |
| 8K / 64K | >= 100 | 20,939 | 42,601 | 2.03x |
| 8K / 64K | >= 125 | 13,074 | 27,918 | 2.14x |
| 8K / 64K | >= 150 | 8,522 | 18,047 | 2.12x |
ทั้งสองโมเดลทดสอบด้วยมาตรฐาน NVFP4 เท่ากัน ดังนั้นความเร็วที่เพิ่มขึ้นจึงเป็นผลจากการบีบอัดโดยตรง โดยโหมด 8K/64K ที่เน้นการถอดรหัส (decode) จะได้ประโยชน์สูงสุด
สำหรับการใช้งานบน H100 เครื่องเดียวที่บริบท 1M โทเค็น ข้อจำกัดจะอยู่ที่หน่วยความจำ (HBM) โดยรุ่น Super กินพื้นที่ไปถึง 70 GB ทำให้รันได้ครั้งละ 1 รายการ ขณะที่ Puzzle-75B-A9B กินพื้นที่เพียง 44.5 GB ทำให้รองรับการทำงานพร้อมกันได้ถึง 8 รายการ และมีค่า throughput รวมสูงกว่าตัวเดิมถึง 4 เท่า
How Iterative Puzzle Works
Puzzle เป็นเฟรมเวิร์กการค้นหาสถาปัตยกรรมประสาทแบบแยกส่วน (Puzzletron) เพื่อเลือกวิธีการนำเลเยอร์แต่ละตัวไปใช้ให้เหมาะสมภายใต้ข้อจำกัดหน้างาน
เทคนิคการตัดทอนที่ใช้ประกอบด้วย:
- Intermediate channel pruning: ตัดทอนช่องสัญญาณภายใน routed expert โดยอ้างอิงตามส่วนร่วมต่อผลลัพธ์
- Top-k reduction: ปรับเปลี่ยนจำนวนผู้เชี่ยวชาญ (expert) ที่โทเค็นจะถูกส่งไปหาตามความเหมาะสมของแต่ละเลเยอร์
- Mamba SSM pruning: ลดขนาดสถานะ SSM จาก 128 เหลือ 96 ช่องสัญญาณ ซึ่งช่วยเร่งความเร็วเคอร์เนลได้ 1.2x ถึง 1.3x
Iterative Puzzle แตกต่างจากวิธีดั้งเดิมตรงที่จะไม่กระโดดข้ามไปยังเป้าหมายการบีบอัดทันที แต่จะสลับการบีบอัดที่มีขอบเขตเข้ากับการกู้คืนด้วย knowledge distillation ระยะสั้น โดยแบ่งเป็น 3 ขั้นตอนเพื่อรักษาคุณภาพของโมเดลให้ได้มากที่สุด
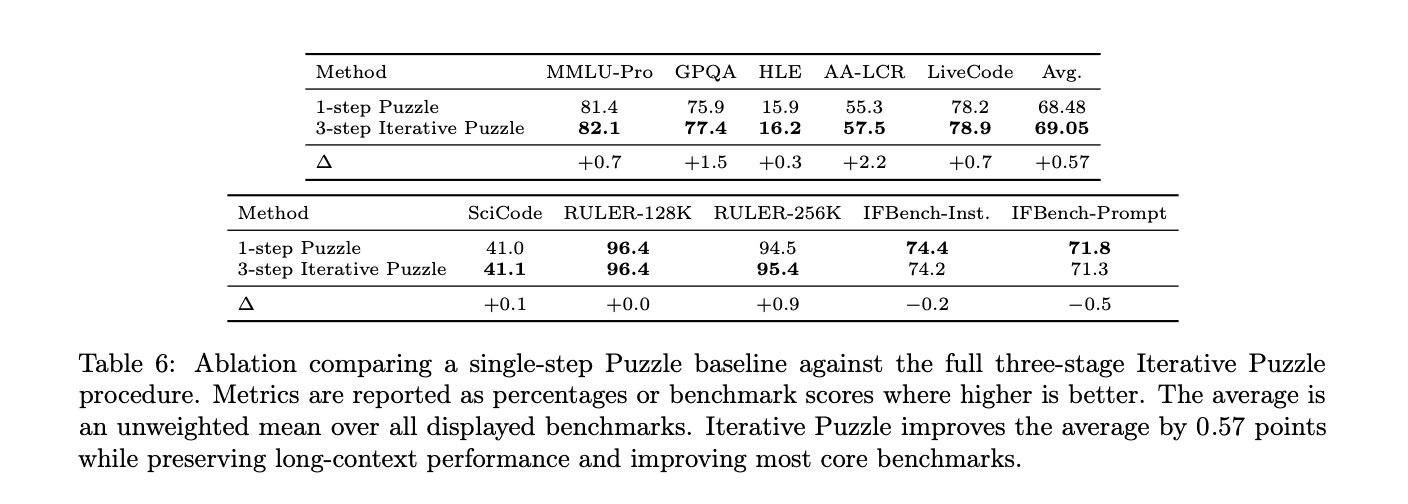
ตารางเปรียบเทียบแสดงให้เห็นว่ากระบวนการ 3 ขั้นตอนนี้ทำคะแนนเฉลี่ยได้ 69.05 สูงกว่าการบีบอัดแบบขั้นตอนเดียวที่ได้ 68.48 โดยเห็นการพัฒนาที่ชัดเจนในแบบทดสอบอย่าง MMLU-Pro และ GPQA
Recovery: Distillation, RL, and Verbosity
ทีมงานใช้ Knowledge distillation (KD) โดยใช้ข้อมูล pretraining 30% และข้อมูล SFT 70% จากรุ่น Nano ในช่วงแรกฝึกฝนที่ความยาวลำดับ 32K ก่อนขยายเป็น 128K และ 512K ในช่วงการกู้คืน นอกจากนี้ยังมีการทำ Post-training RL เพื่อเน้นความสามารถด้านซอฟต์แวร์เอเจนต์ด้วย
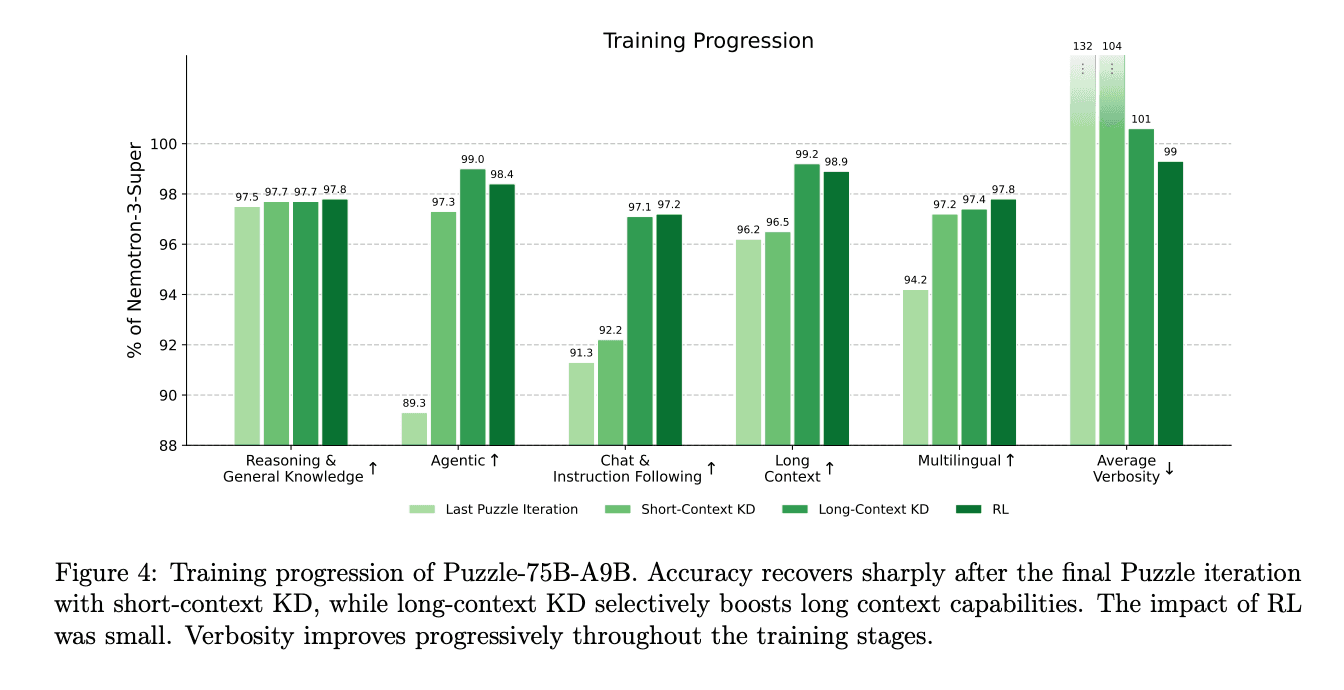
จากรูปที่ 4 การทำ KD ในช่วงบริบทสั้นช่วยกู้คืนความสามารถได้กว่า 97% เมื่อเทียบกับรุ่นต้นฉบับ ขณะที่ความยาวบริบทที่เพิ่มขึ้นช่วยเสริมสมรรถนะในงานอินพุตยาวและการสร้างข้อความ ส่วนผลกระทบของ RL ในการทดลองนี้ถือว่าค่อนข้างน้อย
Deployment: Quantization and Multi-Token Prediction
มีการปรับใช้สูตร Quantization สองแบบคือ FP8 สำหรับ Hopper และ NVFP4 สำหรับ Blackwell เพื่อให้เหมาะสมกับสถาปัตยกรรมฮาร์ดแวร์แต่ละประเภท
| ส่วนประกอบ | BF16 baseline | FP8 checkpoint | NVFP4 checkpoint |
|---|---|---|---|
| Sparse และ shared MoE GEMMs | BF16 | FP8 | NVFP4 |
| Mamba GEMMs | BF16 | FP8 | FP8 |
| Mamba SSM cache | FP32 | FP32 | FP16+SR |
| KV cache | FP8 | FP8 | FP8 |
| Router | FP32 | FP32 | FP32 |
| Attention QKV/output, MoE latent projections, LM head | BF16 | BF16 | BF16 |
นอกจากนี้ Puzzle-75B-A9B ยังรับช่วงต่อหัว MTP (Multi-Token Prediction) จากรุ่น Super โดยการฝึกฝนหัวประมวลผลต่อช่วยแก้ปัญหาความไม่สอดคล้องกันระหว่างการฝึกกับการใช้งาน ทำให้อัตราการยอมรับ (acceptance lengths) เพิ่มขึ้นอย่างมีนัยสำคัญ
Where Compression Helps and Where It Hurts
| แบบทดสอบ (BF16) | Super | Puzzle-75B-A9B | ส่วนต่าง |
|---|---|---|---|
| MMLU-Pro | 83.8 | 82.4 | -1.4 |
| AIME25 (no tools) | 92.2 | 89.7 | -2.5 |
| GPQA (no tools) | 80.5 | 78.6 | -1.9 |
| LiveCodeBench | 82.1 | 81.1 | -1.0 |
| SciCode (subtask) | 42.3 | 40.6 | -1.7 |
| SWE-Bench (OpenHands) | 59.5 | 56.9 | -2.6 |
| Arena-Hard-V2 | 72.8 | 68.6 | -4.2 |
| AA-LCR | 56.8 | 56.9 | +0.1 |
| RULER 1M | 93.9 | 92.2 | -1.7 |
| MMLU-ProX | 79.5 | 77.5 | -2.0 |
จุดที่ได้รับผลกระทบมากที่สุดจากการบีบอัดคือการทดสอบด้านการทำตามคำสั่ง (instruction-following) และงานเชิงเอเจนต์ (agentic) โดยเฉพาะ Arena-Hard-V2 ที่คะแนนลดลงมากที่สุด ส่วนงานด้านอินพุตยาวยังคงรักษามาตรฐานไว้ได้ดี
Use Cases
- Ultra-long-context RAG: เหมาะสำหรับบริการวิเคราะห์เอกสารขนาดใหญ่ 1M โทเค็นบน GPU เดียว โดยรองรับผู้ใช้พร้อมกันได้มากขึ้น 8 เท่า
- ผู้ช่วยเขียนโค้ด: เพิ่มประสิทธิภาพการให้บริการโทเค็นได้กว่า 2.03 เท่าในโหมดโต้ตอบ
- งานจัดการเอกสารแบบ Prefill: แม้จะได้ประโยชน์น้อยกว่า (1.60x) แต่ยังถือว่าเพิ่มความเร็วได้ดีในระดับหนึ่ง
- วงจร Agentic SWE: ควรระวังประสิทธิภาพที่ลดลงเล็กน้อยในงานวิศวกรรมซอฟต์แวร์ ซึ่งการกู้คืนด้วย RL ช่วยได้เพียงบางส่วน
Deployment Explorer
ศึกษาข้อมูลเพิ่มเติมได้ที่ Paper and Model weight
และคุณสามารถติดตามพวกเราได้ที่
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร