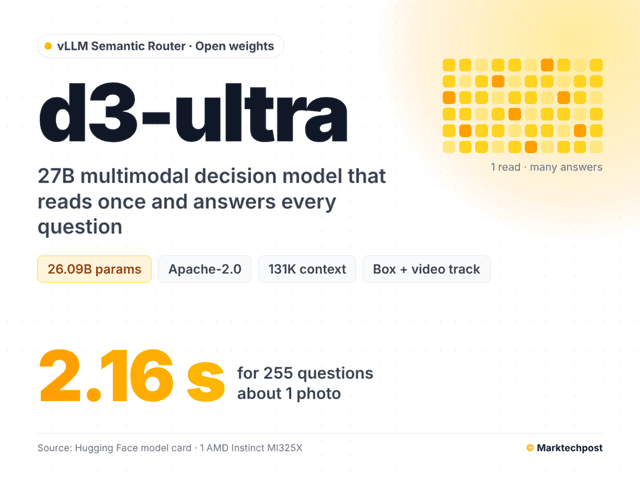
เปิดตัว d3-ultra โมเดลการตัดสินใจ Multimodal โอเพนซอร์สขนาด 27Btag: d3-ultra, Decision Model, Multimodal AI, Open-Source, Semantic Router, vLLMOct 27, 2026 · By: TanasakPสรุปข่าว 1:29vLLM Semantic Router เปิดตัว d3-ultra โมเดลแบบ open-weight ขนาด 27B ที่สามารถประมวลผลข้อความ รูปภาพ และวิดีโอได้ในครั้งเดียวเพื่อส่งคืนค่าความน่าจะเป็นสำหรับการตัดสินใจโดยเฉพาะ
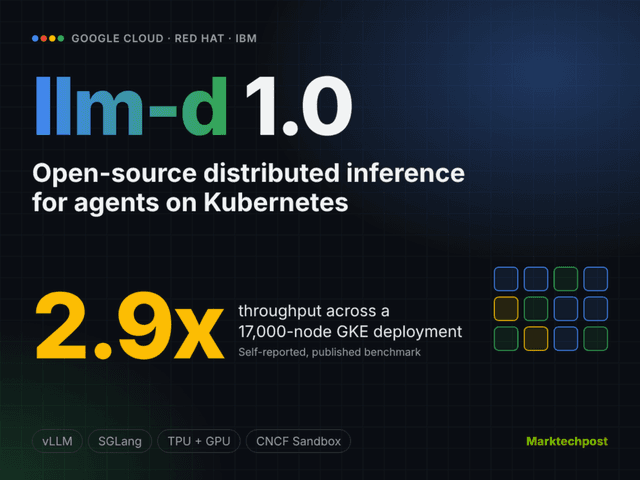
Google Cloud เปิดตัว llm-d 1.0 ยกระดับการประมวลผล LLM ด้วย Cache-Awaretag: Google Cloud, GPU, Kubernetes, llm-d, TPU, vLLMOct 21, 2026 · By: TanasakPสรุปข่าว 1:15Google ร่วมกับ Red Hat และ IBM เปิดตัว llm-d 1.0 สแต็กโอเพนซอร์สแบบ Kubernetes-native สำหรับการทำ distributed LLM inference ที่รองรับทั้ง TPU และ GPU พร้อมระบบควบคุมข้อมูลแบบ multi-tenant
Google เปิดตัวเอนจิน vLLM และ SGLang บน TPU รองรับ PyTorch Nativetag: Google Cloud, Inference, PyTorch, SGLang, TPU, vLLMOct 20, 2026 · By: TanasakPสรุปข่าว 1:40Google Cloud ประกาศเปิดตัว PyTorch backend แบบ native สำหรับเอนจิน vLLM และ SGLang บน TPU เพื่อเพิ่มประสิทธิภาพการทำ inference และตอบโจทย์การพัฒนา AI ระดับ Agentic
Granite Switch 4.1: รวมการแชท ตัดสินใจ และถอดเสียงใน Endpointเดียวtag: aLoRA, Granite Switch, IBM Granite, OpenASR, vLLMOct 16, 2026 · By: NatapolKสรุปข่าว 1:18โครงการ Granite Switch เปิดตัวเวอร์ชัน 4.1 ที่ผสานโมเดล Granite เข้ากับ aLoRA adapters ช่วยให้สลับการทำงานระหว่างการแชท การตัดสินใจ และการแปลงเสียงเป็นข้อความได้รวดเร็วบน GPU ตัวเดิม
5 โปรเจกต์วิศวกรรม LLM Inference เพื่อความเข้าใจระบบเบื้องหลังtag: FlashAttention, Hugging Face, LLM Inference, Quantization, Speculative Decoding, vLLMOct 14, 2026 · By: SirilukPสรุปข่าว 1:27เจาะลึกกลไกที่ทำให้ LLM ทำงานได้รวดเร็วผ่าน 5 โปรเจกต์ลงมือทำจริง ตั้งแต่การสร้างระบบจัดการหน่วยความจำไปจนถึงการเขียน GPU Kernel
พบช่องโหว่ระดับวิกฤตใน LMCache เปิดช่องแฮกเกอร์รันโค้ดระยะไกลtag: CVE-2026-105192, Cybersecurity, JFrog, LMCache, vLLMOct 7, 2026 · By: SirilukPตรวจพบช่องโหว่ระดับวิกฤต CVE-2026-105192 ใน LMCache ซอฟต์แวร์เร่งความเร็ว LLM ซึ่งช่วยให้ผู้โจมตีสามารถรันโค้ดอันตรายด้วยสิทธิ์ Root ได้โดยไม่ต้องระบุตัวตน และปัจจุบันยังไม่มีแพตช์แก้ไข
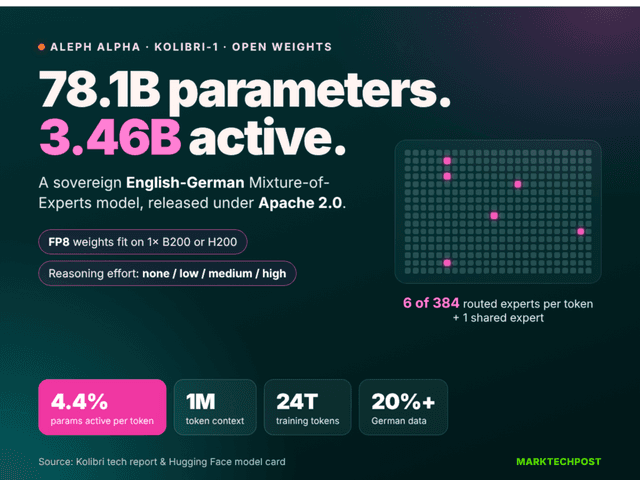
Aleph Alpha เปิดตัว Kolibri โมเดล MoE สองภาษาประสิทธิภาพสูงtag: Aleph Alpha, Kolibri, Large Language Model, Mixture-of-Experts, Open-Source, vLLMOct 4, 2026 · By: AttapolKสรุปข่าว 1:21Aleph Alpha เปิดตัว Kolibri โมเดลภาษาอังกฤษ-เยอรมันขนาด 78.1B แบบ Open-Weight ที่ใช้ทรัพยากรต่ำเพียง 3.46B พารามิเตอร์ต่อโทเค็น พร้อมรองรับบริบทสูงสุดถึง 1 ล้านโทเค็น
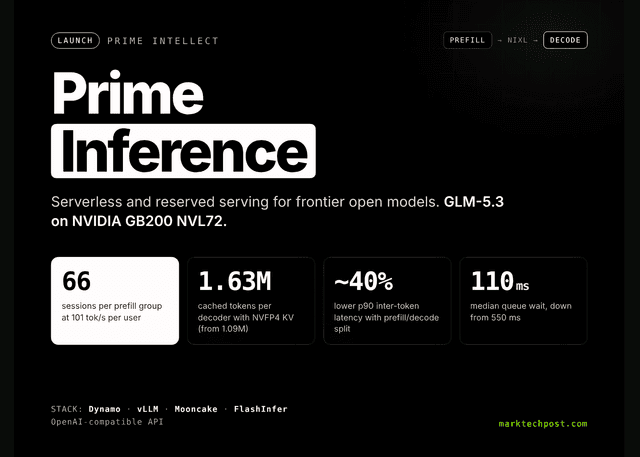
Prime Intellect เปิดตัว Prime Inference รันโมเดลโอเพนซอร์สบน NVIDIA Blackwelltag: GLM-5.3, NVIDIA Blackwell, Open-Source, Prime Intellect, vLLMOct 3, 2026 · By: TanasakPสรุปข่าว 1:24Prime Intellect เปิดตัวแพลตฟอร์ม Prime Inference รองรับการให้บริการโมเดลโอเพนซอร์สระดับแนวหน้าผ่าน NVIDIA Blackwell ชูจุดเด่นความเร็ว 101 tok/s ต่อผู้ใช้ด้วยเทคโนโลยี GLM-5.3 และระบบ Cache-aware routing
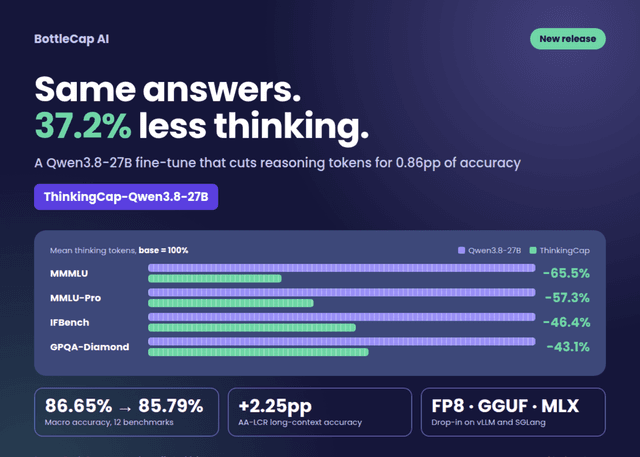
BottleCap AI เปิดตัว ThinkingCap-Qwen3.8-27B ลดโทเคนการคิดลง 37%tag: BottleCap AI, Qwen3.8-27B, Reasoning Model, ThinkingCap, vLLMSep 25, 2026 · By: NatapolKสรุปข่าว 1:21โมเดลรุ่นใหม่ ThinkingCap-Qwen3.8-27B ปรับจูนจาก Qwen3.8-27B ให้ใช้ Thinking Tokens น้อยลงถึง 37.2% โดยยังคงความแม่นยำรวมไว้ได้เกือบเท่าเดิมและทำงานในบริบทข้อมูลยาวได้ดียิ่งขึ้น
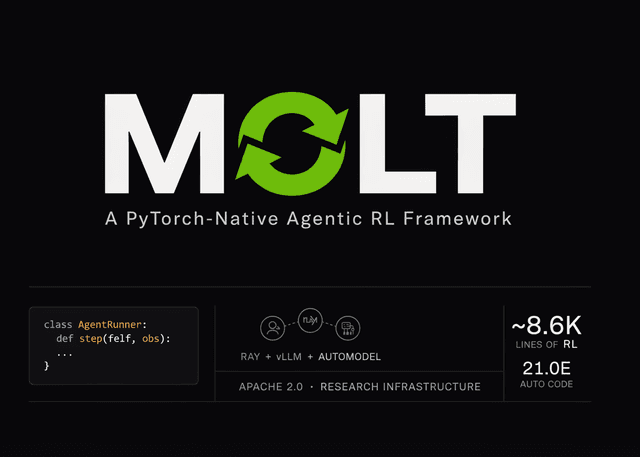
NVIDIA เปิดตัว Molt เฟรมเวิร์ก Agentic RL ขนาดกะทัดรัด รองรับ PyTorch แบบ Nativetag: Agentic RL, Molt, NeMo, Nvidia, PyTorch, vLLMAug 3, 2026 · By: AttapolKNVIDIA NeMo Labs เปิดตัว Molt เฟรมเวิร์กสำหรับการวิจัยการเรียนรู้แบบเสริมกำลังเชิงเอเจนต์ (Agentic RL) ที่เน้นความเรียบง่ายด้วยโค้ดเพียง 8,600 บรรทัด พร้อมรองรับการทำงานร่วมกับ Ray และ vLLM โดยตรง
Feyn AI เปิดตัว SQRL โมเดล Text-to-SQL สายพันธุ์ใหม่ ตรวจสอบฐานข้อมูลจริงก่อนเขียน Querytag: Feyn AI, Hugging Face, Machine Learning, SQRL, Text-to-SQL, vLLMJul 21, 2026 · By: NatapolKFeyn Labs เปิดตัว SQRL ตระกูลโมเดล text-to-SQL ที่ใช้ระบบตรวจสอบแบบอ่านอย่างเดียว (read-only probes) เพื่อแก้ปัญหากำกวมของข้อมูล โดยรุ่นเรือธงทำความแม่นยำได้ถึง 70.6% แซงหน้า Claude 3.5 Opus ในการทดสอบ BIRD Dev benchmark
ยกระดับ vLLM: เมื่อ Backend ของ Transformers เร็วแรงระดับ Native โดยไม่ต้องแก้โค้ดtag: Hugging Face, Inference, LLM, PyTorch, Transformers, vLLMJul 17, 2026 · By: TanasakPvLLM อัปเกรดแบ็กเอนด์ Transformers ให้มีประสิทธิภาพเทียบเท่าหรือสูงกว่าการเขียนโค้ดเฉพาะทาง ช่วยให้ผู้พัฒนาสามารถรันโมเดล LLM หลากหลายสถาปัตยกรรมได้ทันทีด้วยความเร็วสูงสุด