
ยกระดับ vLLM: เมื่อ Backend ของ Transformers เร็วแรงระดับ Native โดยไม่ต้องแก้โค้ด
TL;DR: ปัจจุบันแบ็กเอนด์ Transformers บน vLLM มีความเร็วเทียบเท่า (หรืออาจจะเร็วกว่า) การเขียนโค้ดแบบ Custom Implementation สำหรับสถาปัตยกรรม LLM หลายตัวแล้ว ช่วยให้ผู้สร้างโมเดลนำจุดเด่นของ Transformers มาใช้ทำ Inference บน vLLM ได้อย่างรวดเร็วเป็นพิเศษโดยไม่มีค่าใช้จ่ายเพิ่มเติม
# Upgrade the vllm pip package
uv pip install --upgrade vllm --torch-backend auto
ไลบรารี Transformers ได้กลายเป็น reference modeling library หลักสำหรับ Machine Learning ที่รองรับโมเดลกว่า 450 สถาปัตยกรรมผ่าน API ชุดเดียวกัน โดยมีจุดมุ่งหมายให้โค้ดโมเดลนั้น จบในตัว และ ทำความเข้าใจได้ง่าย ซึ่งช่วยให้ผู้พัฒนาศึกษาวิธีการทำงานของสถาปัตยกรรมต่างๆ ได้สะดวก ก่อนจะพอร์ตไปยังเฟรมเวิร์กอื่นๆ เช่น vLLM, SGLang, MLX หรือ llama.cpp
เราให้ความสำคัญกับบทบาทนี้และมุ่งมั่นพัฒนาให้การใช้งานง่ายขึ้น ก้าวสำคัญคือการรวม Transformers เข้าเป็นโมเดลลิ่งแบ็กเอนด์ใน vLLM เมื่อปีที่แล้ว ซึ่งช่วยให้รันโมเดล Transformers (ทั้ง LLM และ VLM) บน vLLM ได้ทันทีโดยไม่ต้องพอร์ตโค้ด โดยให้ Transformers จัดการส่วนโครงสร้างโมเดล ส่วน vLLM ดูแลเทคนิคการทำ Inference ระดับสูง เช่น continuous batching และ custom attention kernels
และการทำงานร่วมกันนี้ก็ดียิ่งขึ้นไปอีกในปัจจุบัน 🚀!
ทำความรู้จักประสิทธิภาพ
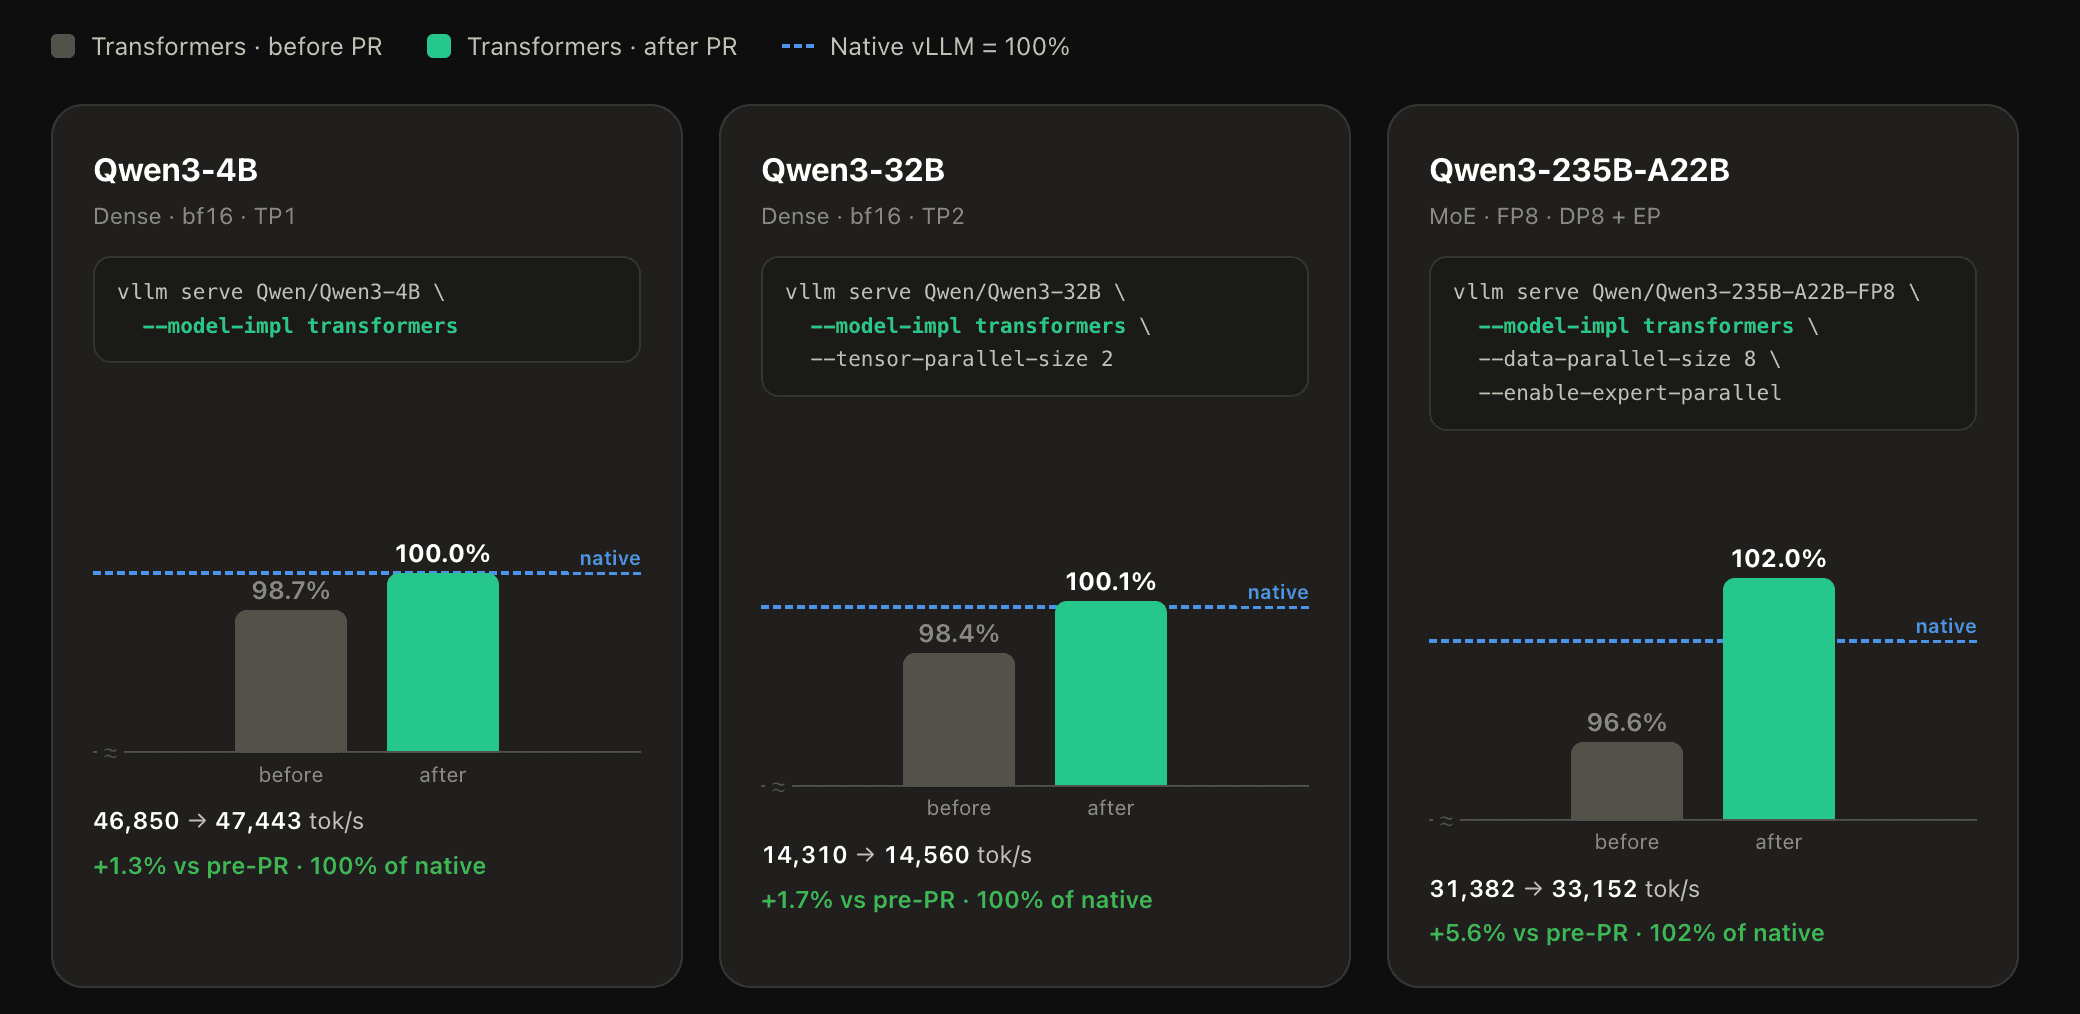
เราได้เปรียบเทียบแบ็กเอนด์ Transformers สำหรับ vLLM กับ Native Implementation ที่เขียนขึ้นเฉพาะสำหรับ vLLM โดยใช้โมเดล Qwen3 ใน 3 รูปแบบที่แตกต่างกันมาก:
- โมเดล 4B dense บน GPU ตัวเดียว
- โมเดล 32B dense ทำงานแบบ tensor parallelism
- โมเดล 235B-parameter FP8 Mixture-of-Experts บน data + expert parallelism ในโหนด 8×H100 เดียวกัน
 |
|---|
| ผลลัพธ์: ปัจจุบันแบ็กเอนด์ Transformers มีประสิทธิภาพเทียบเท่าหรือสูงกว่า Native Throughput ในทุกรูปแบบโมเดล |
การรันโมเดลใดๆ* จาก Hugging Face ผ่านแบ็กเอนด์ Transformers ทำได้ง่ายๆ ด้วยการเติมแฟล็ก --model-impl transformers ซึ่งใช้ร่วมกับตัวเลือก Parallelism ปกติได้ทันที โดยไม่ต้องเปลี่ยนโครงสร้างการให้บริการ (serving setup) เดิมของคุณ:
# Qwen3-4B dense, single GPU
vllm serve Qwen/Qwen3-4B --model-impl transformers

# Qwen3-32B dense, tensor-parallel across 2 GPUs
vllm serve Qwen/Qwen3-32B --model-impl transformers --tensor-parallel-size 2

# Qwen3-235B-A22B-FP8 MoE, data-parallel + expert-parallel across 8 GPUs
vllm serve Qwen/Qwen3-235B-A22B-FP8 --model-impl transformers --data-parallel-size 8 --enable-expert-parallel
# add --max-model-len 8192 if your node is memory constrained- ยกเว้นโมเดลที่ใช้ linear attention ซึ่งจะรองรับในอนาคตอันใกล้ ส่วนโมเดล Custom บน Hub repo อาจใช้งานไม่ได้หากโค้ดไม่ได้เขียนตามมาตรฐานสากล
วิธีการทดสอบ
การวัดผลใช้เงื่อนไขเดียวกันทุกประการ โดยแบ่งตามเส้นทางโค้ดดังนี้:
- native —
--model-impl vllm(โค้ดเฉพาะทางของ vLLM ที่ใช้เป็นเกณฑ์มาตรฐาน) - after —
--model-impl transformersหลังจาก อัปเดต PR - before —
--model-impl transformersก่อน มีการอัปเดต PR
ดูรายละเอียดการรันเพื่อทดสอบซ้ำได้ที่: benchmark.sh
มีอะไรใหม่ในเวอร์ชันนี้?
ในอดีต แบ็กเอนด์ Transformers บน vLLM เน้นไปที่ส่วน Attention ซึ่งเป็นคอขวดหลัก แม้จะช่วยให้รันได้ แต่การรีดประสิทธิภาพสูงสุดจำเป็นต้องมีองค์ประกอบอื่นๆ เช่น การทำ Parallelization ข้าม GPU, การคอมไพล์ (compilation) และ fused kernels เพื่อให้ได้ความเร็วระดับ ultra-fast
 |
|---|
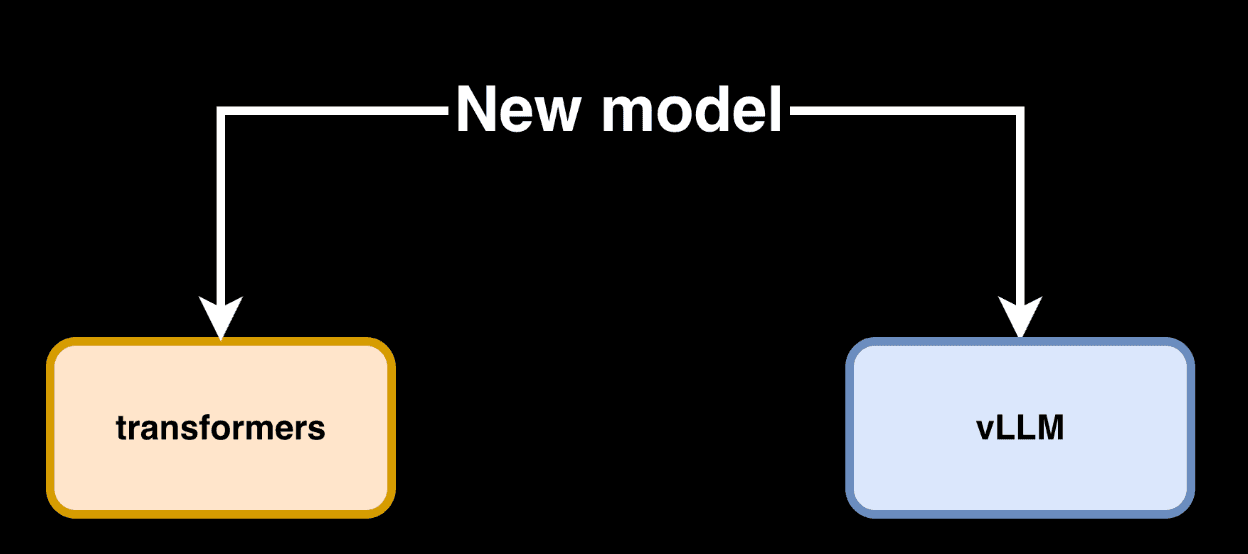
| แต่ก่อน โมเดลใหม่ต้องถูกพัฒนาสองรอบ ทั้งสำหรับ Transformers และ vLLM เพื่อให้ได้ประสิทธิภาพสูงสุด |
เมื่อนักพัฒนาต้องการความแรงระดับสูงสุด พวกเขาจึงมักต้องเขียน Implementation เฉพาะสำหรับ vLLM แยกต่างหาก
 |
|---|
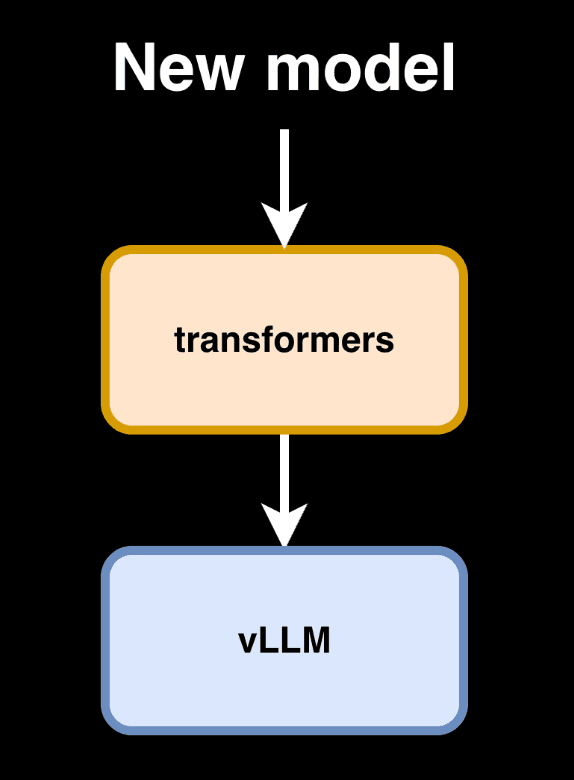
| ปัจจุบัน เมื่อโมเดลใหม่ถูกเพิ่มเข้าไปใน Transformers จะสามารถใช้งานบน vLLM ได้ทันทีด้วยความเร็วระดับ Native |
แบ็กเอนด์ Transformers เวอร์ชันล่าสุดจะผสานเลเยอร์ (inference specific layer fusions) แบบไดนามิกขณะรัน เพื่อให้ได้ความเร็วเทียบเท่าการเขียนโค้ดเฉพาะทางสำหรับสถาปัตยกรรมที่รองรับ
เบื้องหลังการทำงาน
แบ็กเอนด์นี้ใช้ torch.fx เพื่อวิเคราะห์โครงสร้างกราฟของโมเดล (static analysis) เพื่อค้นหารูปแบบที่สามารถปรับแต่งได้ จากนั้นจะใช้ ast (abstract syntax tree) เข้าไปจัดการและเขียนทับคำสั่งในโค้ดต้นฉบับโดยตรง
เราทำอะไรได้บ้างจากเทคนิคนี้?
- รวมการทำงาน (Fused operations) เข้ากับ vLLM kernels ที่ปรับแต่งมาเป็นพิเศษ เช่น การใช้ Expert Parallelization (EP) ในโมเดล Mixture-of-Experts (MoE)
- ปรับปรุงบล็อกสำคัญอย่าง
MergedColumnParallelLinearและQKVParallelLinearเพื่อรองรับแผนการทำงานขนานแบบ TP (tensor-parallel) และ PP (pipeline-parallel) ให้มีประสิทธิภาพขึ้น - โมเดลที่ผ่านกระบวนการนี้ยังรองรับการคอมไพล์ผ่าน
torch.compileและ CUDA Graphs ได้สมบูรณ์แบบ - ต่างจาก vLLM แบบเดิม โค้ดที่ใช้ใน Transformers นี้สามารถนำไปใช้ใน การฝึกฝน (training) ได้ด้วย ทำให้ใช้โค้ดชุดเดียวได้ตั้งแต่ Training, Eval ไปจนถึง RL rollouts
ผลลัพธ์คือความเร็วระดับ Native Inference สำหรับโมเดลที่รองรับ โดยที่นักพัฒนาไม่ต้องเสียเวลาเขียนโค้ดปรับแต่งแม้แต่บรรทัดเดียว
เรากำลังเตรียมบทความฉบับเต็มเพื่อเจาะลึกรายละเอียดทางเทคนิคของการจัดการโมเดลเหล่านี้ในเร็วๆ นี้
แหล่งข้อมูลเพิ่มเติม
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร