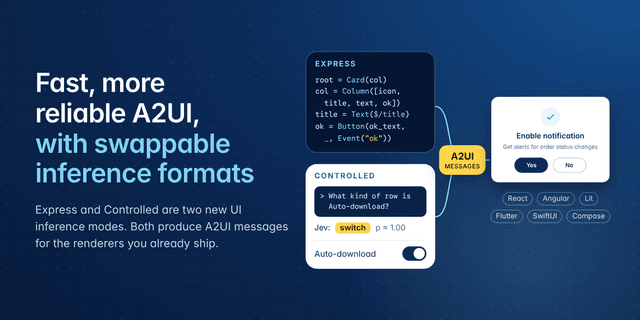
Google เปิดตัว A2UI Express ปฏิวัติความเร็ว Generative UI ขึ้น 3 เท่าtag: A2UI, Apparite, Generative UI, Google, Inference, JevOct 27, 2026 · By: TanasakPสรุปข่าว 1:24Google แนะนำรูปแบบ Inference ใหม่สำหรับ A2UI ที่ลด Latency ลงอย่างมาก พร้อมเปิดตัว A2UI Express และการใช้งานร่วมกับ Jev เพื่อสร้าง UI ที่รวดเร็วและแม่นยำยิ่งขึ้น
r/LocalLLaMANewsDeepSeek เปิดตัว DeepInfer เฟรมเวิร์กจัดการโมเดลแบบ Open Sourcetag: DeepInfer, DeepSeek, Huawei, Inference, Nvidia, Open-SourceOct 26, 2026 · By: AttapolKDeepSeek ปล่อยซอร์สโค้ด DeepInfer ซึ่งเป็นเอนจิ้นสำหรับรันโมเดลขนาดใหญ่ให้มีประสิทธิภาพสูง โดยรองรับทั้งการ์ดจอ NVIDIA และชิป Ascend NPU ของ Huawei
Google เปิดตัวเอนจิน vLLM และ SGLang บน TPU รองรับ PyTorch Nativetag: Google Cloud, Inference, PyTorch, SGLang, TPU, vLLMOct 20, 2026 · By: TanasakPสรุปข่าว 1:40Google Cloud ประกาศเปิดตัว PyTorch backend แบบ native สำหรับเอนจิน vLLM และ SGLang บน TPU เพื่อเพิ่มประสิทธิภาพการทำ inference และตอบโจทย์การพัฒนา AI ระดับ Agentic
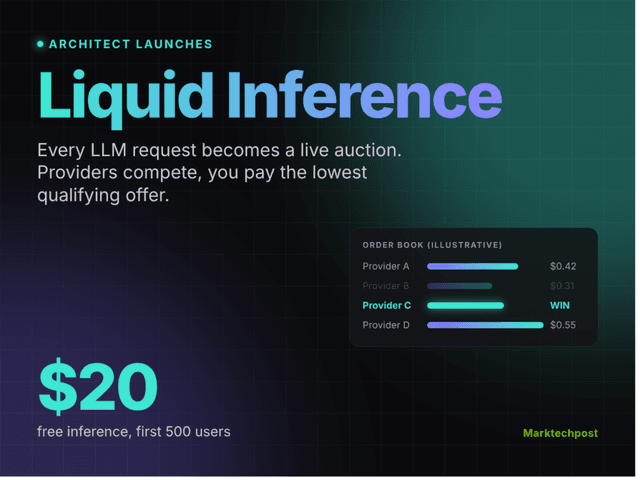
Architect เปิดตัว Liquid Inference ตลาดประมูลค่าประมวลผล LLM แบบเรียลไทม์tag: Architect, GPU Compute, Inference, Liquid Inference, LLMOct 8, 2026 · By: AttapolKสรุปข่าว 1:23Architect Financial Technologies เปิดตัว Liquid Inference ตลาดกลางสำหรับการประมวลผล LLM ที่ใช้วิธีประมูลสดรายคำขอ เพื่อให้ผู้ใช้ได้รับราคาประมวลผลที่ถูกที่สุดตามเงื่อนไขที่กำหนด
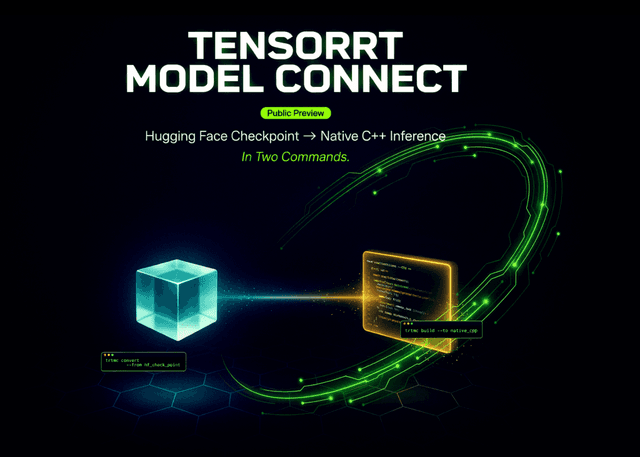
NVIDIA เปิดตัว TensorRT Model Connect รุ่น Public Preview เปลี่ยน Hugging Face เป็น C++ Inference ใน 2 คำสั่งtag: C++, Hugging Face, Inference, Nvidia, Open-Source, TensorRTAug 20, 2026 · By: NatapolKNVIDIA เปิดตัวโปรเจกต์ open-source TensorRT Model Connect (TRTMC) ช่วยแปลงโมเดลจาก Hugging Face สู่ระบบ Inference ด้วยภาษา C++ ได้โดยตรงโดยไม่ต้องผ่าน ONNX หรือใช้ PyTorch ในขณะรันไทม์
ยกระดับ vLLM: เมื่อ Backend ของ Transformers เร็วแรงระดับ Native โดยไม่ต้องแก้โค้ดtag: Hugging Face, Inference, LLM, PyTorch, Transformers, vLLMJul 17, 2026 · By: TanasakPvLLM อัปเกรดแบ็กเอนด์ Transformers ให้มีประสิทธิภาพเทียบเท่าหรือสูงกว่าการเขียนโค้ดเฉพาะทาง ช่วยให้ผู้พัฒนาสามารถรันโมเดล LLM หลากหลายสถาปัตยกรรมได้ทันทีด้วยความเร็วสูงสุด