tag: DeepSeek

Anthropic แฉกลุ่มแฮ็กเกอร์ใช้ Claude พัฒนาขีปนาวุธ-โดรนกามิกาเซ่ พร้อมพบแล็บจีนแอบสูบข้อมูลเทรนโมเดล

Anthropic แฉกลุ่มแฮ็กเกอร์ใช้ Claude พัฒนาขีปนาวุธ-โดรนกามิกาเซ่ พร้อมพบแล็บจีนแอบสูบข้อมูลเทรนโมเดล

· By: SirilukP
รายงานภัยคุกคามของ Anthropic พบการใช้ Claude ในทางที่ผิด ทั้งการพัฒนาอาวุธร้ายแรงและการจารกรรมข้อมูล โดยมีห้องแล็บ AI ชั้นนำจากจีนอย่าง Alibaba และ DeepSeek แอบดึงข้อมูลมหาศาลเพื่อใช้ฝึกฝนโมเดลของตนเอง
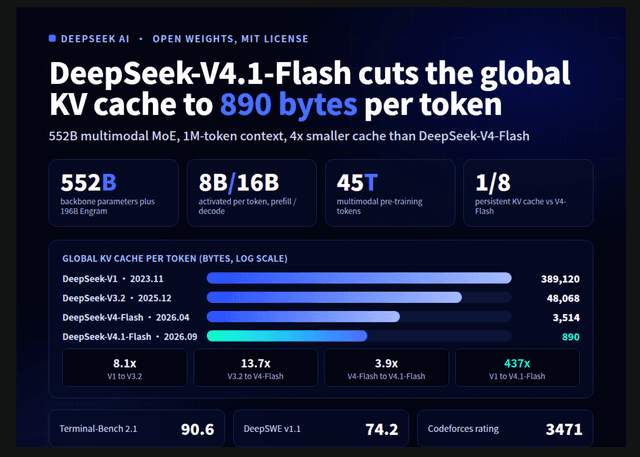
DeepSeek ปล่อย DeepSeek-V4.1-Flash รุ่นใหม่: มาพร้อม 1M Context และนวัตกรรมประหยัด KV Cache ถึง 437 เท่า

DeepSeek ปล่อย DeepSeek-V4.1-Flash รุ่นใหม่: มาพร้อม 1M Context และนวัตกรรมประหยัด KV Cache ถึง 437 เท่า

DeepSeek-V4.1-Flash คือโมเดล Mixture-of-Experts มัลติโมดอลที่ออกแบบมาเพื่อลดปัญหาคอขวดของหน่วยความจำในการรัน Long-horizon agents โดยรองรับ Context Window สูงสุดถึง 1 ล้านโทเคน
Deepseek ผุดโปรเจกต์ยักษ์ ติดตั้งชิป Huawei 1.6 แสนตัวในมองโกเลียใน หวังลดการพึ่งพา Nvidia

Deepseek ผุดโปรเจกต์ยักษ์ ติดตั้งชิป Huawei 1.6 แสนตัวในมองโกเลียใน หวังลดการพึ่งพา Nvidia

· By: SirilukP
Deepseek วางแผนสร้างคลัสเตอร์ชิป Huawei Ascend-950DT ขนาด 160,000 ตัวในมองโกเลียในเพื่อใช้งาน Inference โดยเฉพาะ แต่อาจเผชิญปัญหาคอขวดด้านการผลิตที่ทำให้การส่งมอบล่าช้ากว่าหนึ่งปี
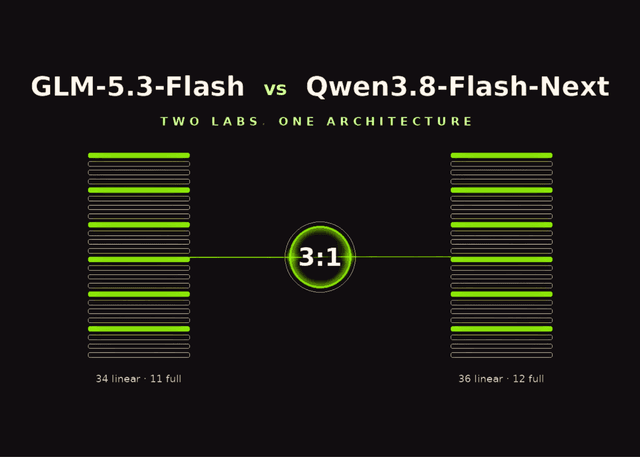
GLM-5.3-Flash ปะทะ Qwen3.8-Flash-Next: สองยักษ์ใหญ่ AI จีนกับสถาปัตยกรรมโมเดลที่เหมือนกันโดยไม่ได้นัดหมาย

GLM-5.3-Flash ปะทะ Qwen3.8-Flash-Next: สองยักษ์ใหญ่ AI จีนกับสถาปัตยกรรมโมเดลที่เหมือนกันโดยไม่ได้นัดหมาย

· By: NatapolK
Z.ai และทีม Qwen จาก Alibaba เปิดตัวโมเดล AI รุ่นใหม่ที่มีสถาปัตยกรรมคล้ายคลึงกันอย่างน่าประหลาดใจ โดยทั้งคู่เลือกใช้ไฮบริด Linear Attention อัตราส่วน 3:1 และระบบ Gated Residuals 4 กิ่งเพื่อเพิ่มประสิทธิภาพการประมวลผล
Frontier Radar #4: จีนไล่กวดทันแล้ว ความเป็นผู้นำด้าน AI ของตะวันตกเหลือจุดแข็งอะไรบ้าง?

Frontier Radar #4: จีนไล่กวดทันแล้ว ความเป็นผู้นำด้าน AI ของตะวันตกเหลือจุดแข็งอะไรบ้าง?

· By: SirilukP
Kimi K3 และ GLM-5.3 จากจีนก้าวขึ้นมาประชิดโมเดลระดับท็อปของสหรัฐฯ ในเกือบทุกด้าน บีบให้ฝั่งตะวันตกต้องเร่งสร้างคูเมืองใหม่ผ่านระบบนิเวศและการใช้งานจริงมากกว่าแค่ตัวโมเดล
จีนไฟเขียวนำเข้าชิป Nvidia H200 เพื่อช่วยบริษัท AI ในประเทศให้ก้าวทันสหรัฐฯ

จีนไฟเขียวนำเข้าชิป Nvidia H200 เพื่อช่วยบริษัท AI ในประเทศให้ก้าวทันสหรัฐฯ

· By: SirilukP
ทางการจีนอนุญาตให้ ByteDance และ Tencent นำเข้าชิป Nvidia H200 ในจำนวนจำกัด เพื่อสนับสนุนการพัฒนาโมเดล AI ท่ามกลางมาตรการควบคุมการส่งออกของสหรัฐฯ
เอเจนท์ AI ต้องการความจำมากแค่ไหน? ผลวิจัยชี้ต้อง 'ปรับจูน' ให้พอดีกับความสามารถโมเดล

เอเจนท์ AI ต้องการความจำมากแค่ไหน? ผลวิจัยชี้ต้อง 'ปรับจูน' ให้พอดีกับความสามารถโมเดล

· By: NatapolK
IBM Research พบว่าการใส่ความจำหรือคำแนะนำให้เอเจนท์ AI ไม่ได้ยิ่งมากยิ่งดีเสมอไป แต่ต้องปรับปริมาณยาให้เหมาะสมกับระดับความฉลาดของโมเดลแต่ละรุ่นเพื่อประสิทธิภาพสูงสุดและต้นทุนที่ต่ำลง
DeepSeek เปิดตัว DeepSeek Harness v0.1 ชุดเครื่องมือสร้าง AI Agent แบบปลั๊กอินภายใต้สัญญาอนุญาต MIT

DeepSeek เปิดตัว DeepSeek Harness v0.1 ชุดเครื่องมือสร้าง AI Agent แบบปลั๊กอินภายใต้สัญญาอนุญาต MIT

· By: AttapolK
DeepSeek Harness v0.1 เป็น Harness สำหรับสร้าง AI Agent ที่ใช้สถาปัตยกรรมปลั๊กอินของ Cordis รองรับการปรับแต่งทุกส่วนอย่างอิสระ พร้อมระบบบันทึกเซสชันที่ตรวจสอบย้อนหลังได้ละเอียดและไม่ยึดติดกับผู้ให้บริการโมเดล
DeepSeek เปิดตัว V4-Pro เวอร์ชันเต็ม พร้อมปล่อย Harness v0.1 โอเพนซอร์ส และปรับขึ้นราคา API

DeepSeek เปิดตัว V4-Pro เวอร์ชันเต็ม พร้อมปล่อย Harness v0.1 โอเพนซอร์ส และปรับขึ้นราคา API

· By: SirilukP
DeepSeek ประกาศนำโมเดลเรือธง V4-Pro ออกจากช่วงทดสอบ พร้อมเปิดตัวซอฟต์แวร์เอเจนท์ Harness v0.1 แบบโอเพนซอร์ส ขณะที่ราคา API มีการปรับขึ้นโดยเฉพาะ Cache Hits ที่เพิ่มขึ้นถึง 6 เท่า
สงครามตัดราคา AI เริ่มดุเดือด หลังบริษัทใหญ่ลดราคาโทเค็นสู้คู่แข่งจากจีน

สงครามตัดราคา AI เริ่มดุเดือด หลังบริษัทใหญ่ลดราคาโทเค็นสู้คู่แข่งจากจีน

· By: SirilukP
บริษัทยักษ์ใหญ่ด้าน AI กำลังแห่ลดราคาโทเค็นลงอย่างมหาศาลเพื่อแข่งขันกับโมเดลราคาถูกจากจีน ท่ามกลางความกังวลเรื่องกำไรและภาระต้นทุนโครงสร้างพื้นฐานที่สูงลิ่ว
DeepSeek เปิดตัว DeepSeek-V4-Flash-0731 อัปเกรดประสิทธิภาพ Agentic และงานโค้ดแบบก้าวกระโดด

DeepSeek เปิดตัว DeepSeek-V4-Flash-0731 อัปเกรดประสิทธิภาพ Agentic และงานโค้ดแบบก้าวกระโดด

DeepSeek อัปเกรดโมเดล V4-Flash เวอร์ชันทางการเข้าสู่ช่วง Public Beta โดยเน้นการปรับปรุงผ่านกระบวนการ Post-training ทำให้ได้ประสิทธิภาพสูงกว่ารุ่น Pro เดิมในด้าน Agentic แต่ยังคงราคาที่เข้าถึงง่ายสำหรับนักพัฒนา
DeepSeek เปิดตัวโมเดล Flash ใหม่ ประสิทธิภาพจี้ติด GPT-5.6 Luna ในราคาถูกกว่า 60%

DeepSeek เปิดตัวโมเดล Flash ใหม่ ประสิทธิภาพจี้ติด GPT-5.6 Luna ในราคาถูกกว่า 60%

· By: SirilukP
DeepSeek อัปเกรดโมเดล V4 Flash เวอร์ชัน 0731 ทำคะแนนบน Artificial Analysis Intelligence Index พุ่งแตะ 50 จุด ไล่เลี่ยกับ GPT-5.6 Luna ของ OpenAI แต่มีต้นทุนถูกกว่าถึง 60%
จีนอาจสั่งห้ามบริษัทในประเทศใช้บริการ TSMC พร้อมคุมเข้มการส่งออกเทคโนโลยี AI

จีนอาจสั่งห้ามบริษัทในประเทศใช้บริการ TSMC พร้อมคุมเข้มการส่งออกเทคโนโลยี AI

· By: SirilukP
กระทรวงพาณิชย์จีนกำลังพิจารณามาตรการควบคุมการส่งออกเทคโนโลยี AI ขั้นสูง รวมถึงอาจสั่งห้ามบริษัทในประเทศใช้บริการผลิตชิปจากโรงงานต่างชาติอย่าง TSMC
สรุป 6 Local LLM สเปกเทพปี 2026 ที่รันบน GPU 24GB ใบเดียวได้ลื่นไหล

สรุป 6 Local LLM สเปกเทพปี 2026 ที่รันบน GPU 24GB ใบเดียวได้ลื่นไหล

· By: TanasakP
คู่มือเปรียบเทียบโมเดล AI แบบ open-weight ขนาด 20B–35B ที่เหมาะสมที่สุดสำหรับ GPU หน่วยความจำ 24GB ครอบคลุมทั้งด้านการเขียนโค้ด การใช้เหตุผล และความเร็วในการประมวลผล
สหรัฐฯ เตรียมสั่งแบนโมเดล AI จีน ท่ามกลางกระแสความนิยม Kimi K3 และ DeepSeek ที่เพิ่มขึ้น

สหรัฐฯ เตรียมสั่งแบนโมเดล AI จีน ท่ามกลางกระแสความนิยม Kimi K3 และ DeepSeek ที่เพิ่มขึ้น

· By: SirilukP
รัฐบาลโดนัลด์ ทรัมป์ รื้อฟื้นแผนแบนโมเดล AI แบบ Open-weight จากจีนโดยอ้างความมั่นคงทางไซเบอร์ แต่การบังคับใช้อาจทำได้ยากเนื่องจากบริษัทสหรัฐฯ นิยมใช้งานเพื่อลดต้นทุน
ศึก 3 ยักษ์ใหญ่ MoE จีน: เปรียบเทียบ Kimi K3, DeepSeek V4 Pro และ GLM-5.2 ในยุคโมเดลล้านล้านพารามิเตอร์

ศึก 3 ยักษ์ใหญ่ MoE จีน: เปรียบเทียบ Kimi K3, DeepSeek V4 Pro และ GLM-5.2 ในยุคโมเดลล้านล้านพารามิเตอร์

· By: TanasakP
การเปรียบเทียบโมเดล AI สัญชาติจีน 3 รุ่น ได้แก่ Kimi K3, DeepSeek V4 Pro และ GLM-5.2 พบว่า Kimi K3 มีประสิทธิภาพสูงสุดในระนาบเดียวกับโมเดลชั้นนำของโลก แต่ DeepSeek V4 Pro โดดเด่นด้านความคุ้มค่าของราคา API ในขณะที่ GLM-5.2 ให้ความเร็วในการประมวลผลสูงสุด
โมเดล Open-weight ไล่จี้ติดรุ่น Frontier! ประสิทธิภาพด้านไซเบอร์ตามหลังเพียง 4 เดือนด้วยต้นทุนที่ถูกกว่า

โมเดล Open-weight ไล่จี้ติดรุ่น Frontier! ประสิทธิภาพด้านไซเบอร์ตามหลังเพียง 4 เดือนด้วยต้นทุนที่ถูกกว่า

· By: AttapolK
สถาบันความปลอดภัย AI แห่งสหราชอาณาจักรเตือนว่าโมเดล Open-weight พัฒนาขีดความสามารถด้านไซเบอร์จนตามหลังโมเดลระดับ Frontier เพียง 4-7 เดือน ซึ่งอาจทำให้ฝ่ายป้องกันภัยไซเบอร์มีเวลาเตรียมตัวรับมือน้อยลง
DeepSeek เตรียมระดมทุนรอบใหม่ เสริมแกร่งชิปและศูนย์ข้อมูล หลังเพิ่งปิดดีล 7 พันล้านดอลลาร์เพียงไม่กี่สัปดาห์

DeepSeek เตรียมระดมทุนรอบใหม่ เสริมแกร่งชิปและศูนย์ข้อมูล หลังเพิ่งปิดดีล 7 พันล้านดอลลาร์เพียงไม่กี่สัปดาห์

· By: SirilukP
DeepSeek แล็บ AI สัญชาติจีนเดินหน้าเจรจาระดมทุนเพิ่มเพื่อสร้างอาณาจักรศูนย์ข้อมูลและพัฒนาชิปของตนเอง หวังคงกลยุทธ์ตัดราคาสุดดุเดือดท่ามกลางการแข่งขันที่ร้อนแรงจากคู่แข่งทั้งในและต่างประเทศ