tag: Mixture-of-Experts

เผยโครงสร้าง Sleep: แนวคิดใหม่ช่วย LLM เรียนรู้ต่อเนื่องไม่หยุดยั้ง

เผยโครงสร้าง Sleep: แนวคิดใหม่ช่วย LLM เรียนรู้ต่อเนื่องไม่หยุดยั้ง

· By: SirilukP
นักวิจัยนำแรงบันดาลใจจากการพักผ่อนของสมองมนุษย์มาสร้าง framework ใหม่ ช่วยให้ AI สามารถจดจำข้อมูลระยะยาวและพัฒนาตนเองได้โดยไม่ลืมความรู้เก่า
MiniMax เปิดตัว M3.1 Flash โมเดล Agentic MoE ราคาประหยัด

MiniMax เปิดตัว M3.1 Flash โมเดล Agentic MoE ราคาประหยัด

· By: SirilukP
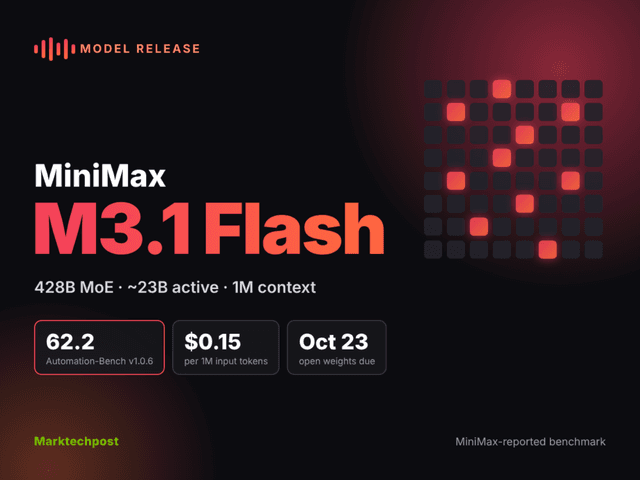
MiniMax เปิดตัวโมเดล M3.1 Flash สถาปัตยกรรม MoE ขนาด 428B พารามิเตอร์ ชูจุดเด่นด้านงาน Agentic และ context window 1M ในราคาเพียง $0.15 ต่อ 1 ล้าน input tokens
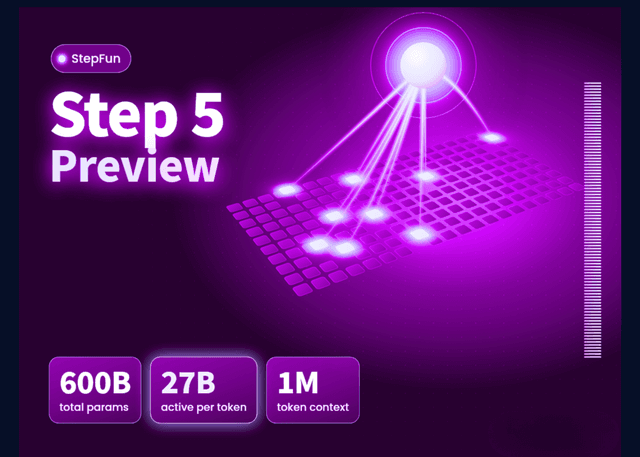
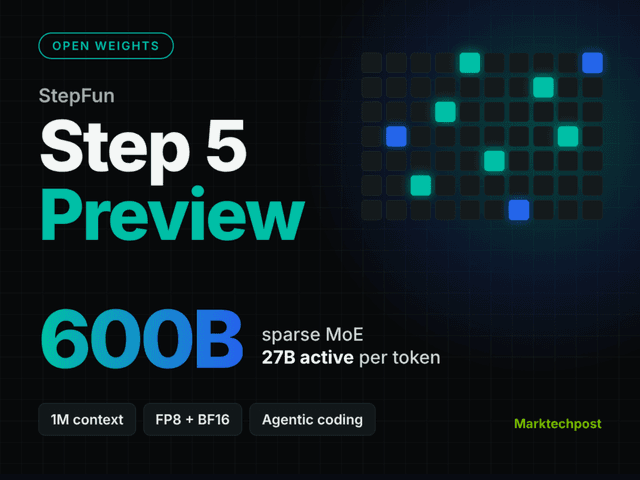
StepFun เปิดตัว Step 5 Preview โมเดล MoE 600B แบบ Open Weights

StepFun เปิดตัว Step 5 Preview โมเดล MoE 600B แบบ Open Weights

· By: AttapolK
StepFun เปิดตัว Step 5 Preview โมเดลภาษาขนาดใหญ่พารามิเตอร์รวม 600B รองรับ Context 1M พร้อมเปิด Open Weights ให้ใช้งานได้บน Hugging Face และ ModelScope เพื่อรองรับงานด้าน Agentic และการวิเคราะห์ข้อมูลซับซ้อน
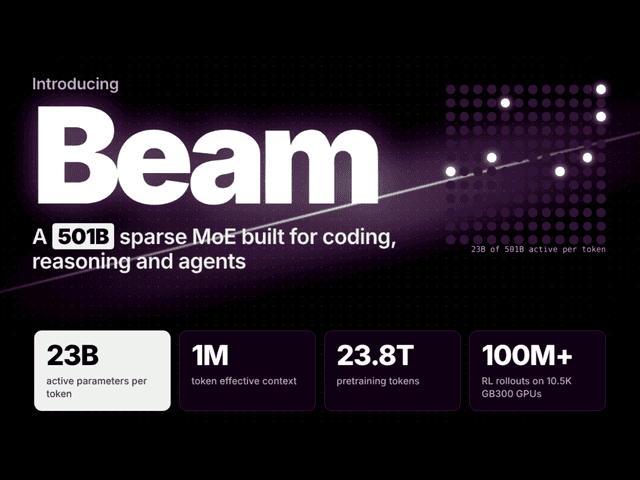
เปิดตัว Beam: โมเดล Open-Weight ขนาด 501B ปรับแต่งได้อิสระ

เปิดตัว Beam: โมเดล Open-Weight ขนาด 501B ปรับแต่งได้อิสระ

· By: TanasakP
Reflection เปิดตัว Beam โมเดลภาษาแบบเปิดโครงสร้าง MoE ขนาด 501B ที่รองรับบริบทสูงสุด 1M tokens มุ่งเน้นงานด้าน Coding และ Agentic พร้อมรองรับการรันบนฮาร์ดแวร์ส่วนตัวภายใต้สัญญาอนุญาต Apache 2.0
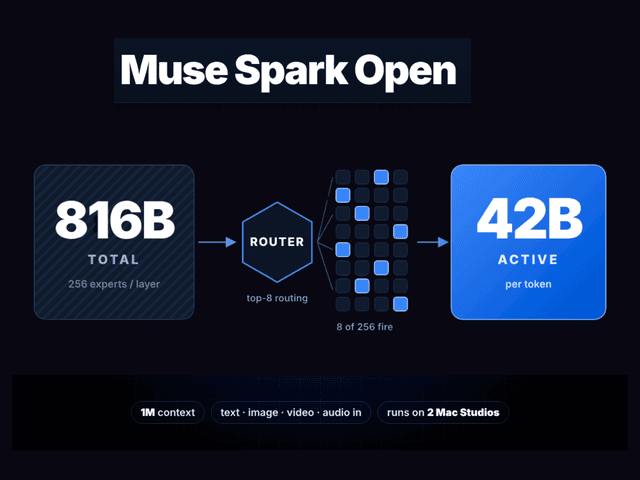
Meta เปิดตัว Muse Spark Open โมเดล MoE 816B รองรับ Context 1M

Meta เปิดตัว Muse Spark Open โมเดล MoE 816B รองรับ Context 1M

· By: TanasakP
Meta เปิดตัว Muse Spark Open โมเดลภาษาแบบ open-weight ขนาด 816B พารามิเตอร์ ชูจุดเด่นรองรับอินพุตหลากหลายและ context window ขนาด 1M token สามารถรันบน Mac Studio ชิป M5 Ultra 2 เครื่องได้
Meta เปิดตัว Muse Spark Open โมเดล MoE แบบ Open-weight ทรงพลังที่สุด

Meta เปิดตัว Muse Spark Open โมเดล MoE แบบ Open-weight ทรงพลังที่สุด

· By: TanasakP
Meta เปิดตัว Muse Spark Open โมเดล multimodal ขนาด 816 พันล้านพารามิเตอร์ที่รองรับทั้งข้อความ ภาพ เสียง และวิดีโอ โดยออกแบบมาเพื่อรองรับงาน Agentic Coding และการทำงานที่ซับซ้อนในระดับ Frontier
Fish Audio เปิดตัว Drama 3 โมเดล TTS สถาปัตยกรรม MoE 35B

Fish Audio เปิดตัว Drama 3 โมเดล TTS สถาปัตยกรรม MoE 35B

· By: NatapolK
Fish Audio เปิดตัว Drama 3 โมเดล Text-to-Speech แบบ open-weight ขนาด 35B ที่สั่งการอารมณ์ด้วยภาษาทั่วไปได้ รองรับ 83 ภาษา และใช้งานได้ฟรีภายใต้เงื่อนไขรายได้ที่กำหนด
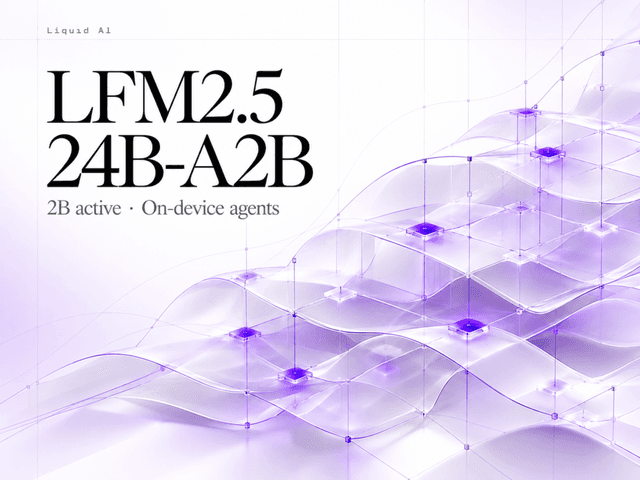
Liquid AI เปิดตัว LFM2.5-24B-A2B โมเดล MoE ประสิทธิภาพสูงสำหรับ Agent

Liquid AI เปิดตัว LFM2.5-24B-A2B โมเดล MoE ประสิทธิภาพสูงสำหรับ Agent

· By: AttapolK
Liquid AI เปิดตัวโมเดล LFM2.5-24B-A2B ขนาด 24B ที่ทำงานจริงเพียง 2B พารามิเตอร์ ชูจุดเด่นด้านการให้เหตุผลบนอุปกรณ์ (On-Device) พร้อมความเร็วถอดรหัสสูงสุด 184 tokens/s บน Apple M5 Max
r/LocalLLaMAMeme

แฟนคลับ Qwen แห่โหวตขนาดโมเดลที่ต้องการผ่านภาพน้องคาปิบารา

· By: AttapolK
ผู้ใช้ Reddit ร่วมแสดงความเห็นหลังทีมผู้พัฒนา Qwen โพสต์ถามว่าต้องการโมเดล AI ขนาดใหญ่หรือขนาดเล็กผ่านภาพมาสคอตคาปิบาราที่ได้รับความนิยมสูง
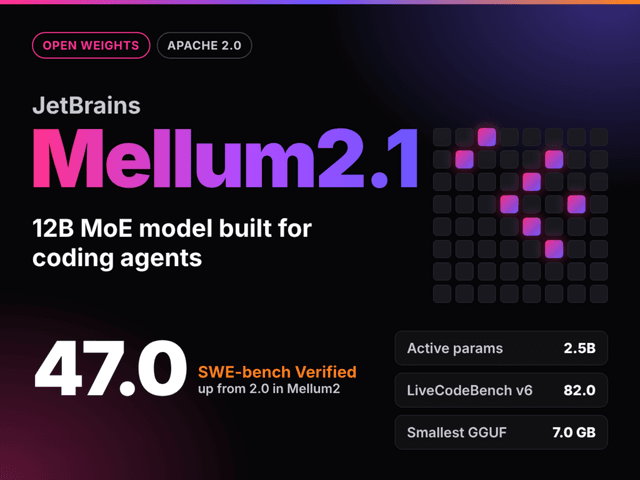
JetBrains เปิดตัว Mellum2.1 โมเดล MoE 12B สำหรับ Coding Agents

JetBrains เปิดตัว Mellum2.1 โมเดล MoE 12B สำหรับ Coding Agents

· By: SirilukP
JetBrains เปิดตัว Mellum2.1 โมเดลภาษาแบบโอเพนซอร์สขนาด 12B ที่เน้นการใช้เหตุผลเพื่อช่วยเขียนโค้ด โดยทำคะแนน SWE-bench Verified ก้าวกระโดดจาก 2.0 เป็น 47.0 ด้วยการฝึกแบบ RL ในสภาพแวดล้อมจริง
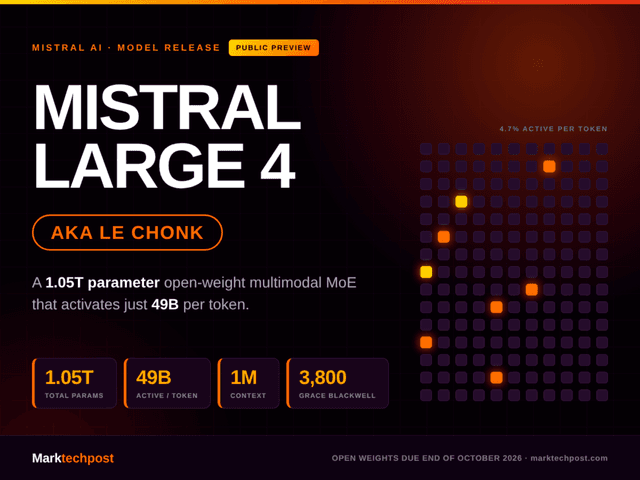
Mistral AI เปิดตัว Mistral Large 4 (Le Chonk) โมเดล MoE 1.05 ล้านล้านพารามิเตอร์

Mistral AI เปิดตัว Mistral Large 4 (Le Chonk) โมเดล MoE 1.05 ล้านล้านพารามิเตอร์

· By: SirilukP
Mistral AI เปิดตัวโมเดล Multimodal รุ่นใหม่ Mistral Large 4 (ML4) ในรูปแบบ Public Preview โดดเด่นด้วยขนาด 1.05 ล้านล้านพารามิเตอร์ และประสิทธิภาพด้านความปลอดภัยไซเบอร์ที่เหนือกว่าคู่แข่ง
Reflection AI เปิดตัว Beam โมเดล MoE 501B ประสิทธิภาพสูงเพื่อสาย Coding

Reflection AI เปิดตัว Beam โมเดล MoE 501B ประสิทธิภาพสูงเพื่อสาย Coding

· By: NatapolK
Reflection AI เปิดตัว Beam โมเดล Open-Weight ขนาดใหญ่ที่ออกแบบมาเพื่อการเขียนโค้ดและงาน Agentic โดยเฉพาะ ชูจุดเด่นด้านการประหยัดทรัพยากรคำนวณมากกว่าคู่แข่ง 3-4 เท่า เตรียมปล่อย Weights ปลายเดือนตุลาคม 2026
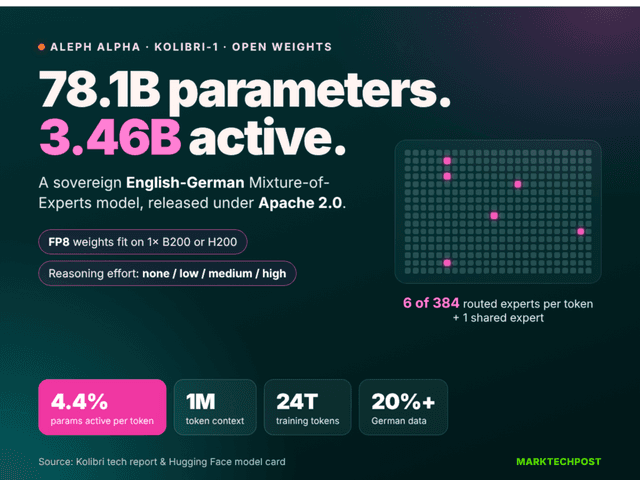
Aleph Alpha เปิดตัว Kolibri โมเดล MoE สองภาษาประสิทธิภาพสูง

Aleph Alpha เปิดตัว Kolibri โมเดล MoE สองภาษาประสิทธิภาพสูง

· By: AttapolK
Aleph Alpha เปิดตัว Kolibri โมเดลภาษาอังกฤษ-เยอรมันขนาด 78.1B แบบ Open-Weight ที่ใช้ทรัพยากรต่ำเพียง 3.46B พารามิเตอร์ต่อโทเค็น พร้อมรองรับบริบทสูงสุดถึง 1 ล้านโทเค็น
เปิดตัว Olmo-core 3 โครงสร้างพื้นฐานฝึกฝน MoE ระดับล้านล้านพารามิเตอร์

เปิดตัว Olmo-core 3 โครงสร้างพื้นฐานฝึกฝน MoE ระดับล้านล้านพารามิเตอร์

· By: SirilukP
Allen Institute for AI เปิดตัว Olmo-core 3 เฟรมเวิร์กโอเพนซอร์สเจนเนอเรชันใหม่ที่รองรับการฝึกโมเดล Mixture-of-Experts (MoE) ขนาดใหญ่ระดับล้านล้านพารามิเตอร์ พร้อมประสิทธิภาพ throughput ที่สูงกว่าเดิมถึง 2.7 เท่า
StepFun เปิดตัว Step 5 Preview โมเดล MoE 600B เน้นงาน Agentic

StepFun เปิดตัว Step 5 Preview โมเดล MoE 600B เน้นงาน Agentic

· By: AttapolK
Step 5 Preview โมเดลเรือธงตัวใหม่จาก StepFun มาพร้อมสถาปัตยกรรม MoE ขนาด 600B รองรับ Context Window 1M โทเคน มุ่งเป้างานวิศวกรรมซอฟต์แวร์และการเงินในราคาที่เข้าถึงง่าย
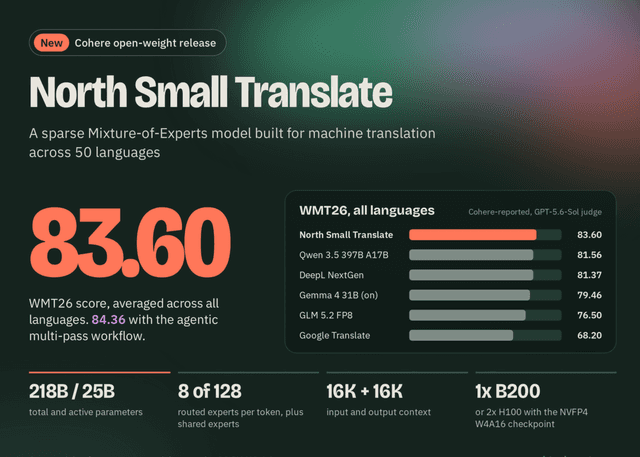
Cohere เปิดตัว North Small Translate โมเดลแปลภาษา MoE

Cohere เปิดตัว North Small Translate โมเดลแปลภาษา MoE

Cohere เปิดตัว North Small Translate โมเดลแปลภาษาด้วยเครื่องแบบ open-weight ขนาด 218B รองรับ 50 ภาษา ทำคะแนนประเมิน WMT26 เฉลี่ย 83.6 คะแนน ชูจุดเด่นแปลเอกสารยาวได้แม่นยำ พร้อมเปิดให้ใช้งานฟรีสำหรับการใช้งานที่ไม่ใช่เชิงพาณิชย์
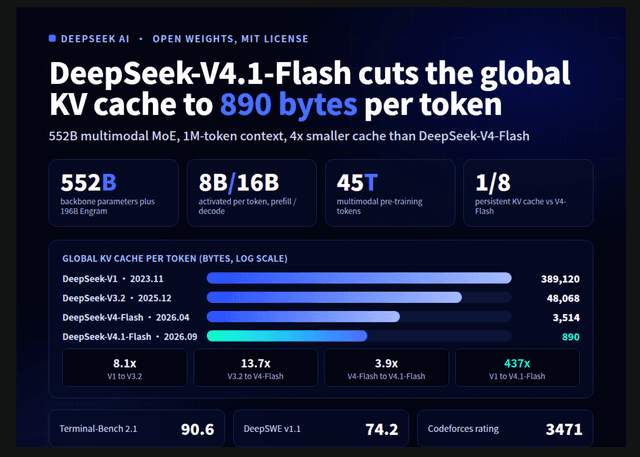
DeepSeek ปล่อย DeepSeek-V4.1-Flash รุ่นใหม่: มาพร้อม 1M Context และนวัตกรรมประหยัด KV Cache ถึง 437 เท่า

DeepSeek ปล่อย DeepSeek-V4.1-Flash รุ่นใหม่: มาพร้อม 1M Context และนวัตกรรมประหยัด KV Cache ถึง 437 เท่า

DeepSeek-V4.1-Flash คือโมเดล Mixture-of-Experts มัลติโมดอลที่ออกแบบมาเพื่อลดปัญหาคอขวดของหน่วยความจำในการรัน Long-horizon agents โดยรองรับ Context Window สูงสุดถึง 1 ล้านโทเคน
AMD เปิดตัว Instella-MoE-16B-A3B โมเดล LLM แบบเปิดกว้างเต็มรูปแบบ ฝึกฝนบนชิป Instinct GPU

AMD เปิดตัว Instella-MoE-16B-A3B โมเดล LLM แบบเปิดกว้างเต็มรูปแบบ ฝึกฝนบนชิป Instinct GPU

· By: NatapolK
AMD เปิดตัว Instella-MoE-16B-A3B โมเดลภาษาขนาด 16B ที่ใช้พารามิเตอร์จริงเพียง 2.8B ต่อโทเค็น ฝึกฝนบน GPU Instinct MI300X และ MI325X พร้อมเปิดเผยชุดข้อมูลและโค้ดทั้งหมดเพื่อการวิจัย
Induction Labs เปิดตัว Photon-1 โมเดล MoE 106B ที่เรียนรู้การใช้คอมพิวเตอร์จากวิดีโอโดยไม่ต้องอาศัยการกำกับข้อมูล

Induction Labs เปิดตัว Photon-1 โมเดล MoE 106B ที่เรียนรู้การใช้คอมพิวเตอร์จากวิดีโอโดยไม่ต้องอาศัยการกำกับข้อมูล

Induction Labs เปิดตัว Photon-1 สถาปัตยกรรม imagination model ที่เรียนรู้พฤติกรรมการใช้งานคอมพิวเตอร์และฟิสิกส์พื้นฐานได้จากการวิเคราะห์วิดีโอดิบ โดยใช้ทรัพยากรน้อยกว่าคู่แข่งอย่าง Gemini ถึง 27 เท่า
Poolside เปิดตัว Laguna S 2.1 โมเดล Agentic Coding แบบ Open-Weight ระดับ 118B สยบยักษ์ใหญ่บน SWE-Bench

Poolside เปิดตัว Laguna S 2.1 โมเดล Agentic Coding แบบ Open-Weight ระดับ 118B สยบยักษ์ใหญ่บน SWE-Bench

Poolside เปิดตัว Laguna S 2.1 โมเดล Mixture-of-Experts ขนาด 118B ที่รองรับบริบทสูงสุด 1M tokens โดยทำผลงานชนะโมเดลขนาดใหญ่กว่าหลายเท่าในด้านการเขียนโค้ดและรันได้บน NVIDIA DGX Spark เพียงเครื่องเดียว
ศึก 3 ยักษ์ใหญ่ MoE จีน: เปรียบเทียบ Kimi K3, DeepSeek V4 Pro และ GLM-5.2 ในยุคโมเดลล้านล้านพารามิเตอร์

ศึก 3 ยักษ์ใหญ่ MoE จีน: เปรียบเทียบ Kimi K3, DeepSeek V4 Pro และ GLM-5.2 ในยุคโมเดลล้านล้านพารามิเตอร์

· By: TanasakP
การเปรียบเทียบโมเดล AI สัญชาติจีน 3 รุ่น ได้แก่ Kimi K3, DeepSeek V4 Pro และ GLM-5.2 พบว่า Kimi K3 มีประสิทธิภาพสูงสุดในระนาบเดียวกับโมเดลชั้นนำของโลก แต่ DeepSeek V4 Pro โดดเด่นด้านความคุ้มค่าของราคา API ในขณะที่ GLM-5.2 ให้ความเร็วในการประมวลผลสูงสุด
Moonshot AI เปิดตัว Kimi K3: โมเดล Open MoE 2.8 ล้านล้านพารามิเตอร์ พร้อมเทคโนโลยี KDA และคอนเทกซ์ 1M

Moonshot AI เปิดตัว Kimi K3: โมเดล Open MoE 2.8 ล้านล้านพารามิเตอร์ พร้อมเทคโนโลยี KDA และคอนเทกซ์ 1M

Moonshot AI เปิดตัว Kimi K3 โมเดลภาษาแบบ Open MoE ขนาด 2.8 ล้านล้านพารามิเตอร์ที่มาพร้อมความสามารถด้าน Vision และรองรับคอนเทกซ์สูงถึง 1 ล้าน Token โดยเน้นประสิทธิภาพด้านการเขียนโค้ดและงานวิจัยเชิงลึก
เปิดตัว Inkling: โมเดล Open Multimodal ระดับ 1 ล้านล้านพารามิเตอร์จาก Thinking Machines

เปิดตัว Inkling: โมเดล Open Multimodal ระดับ 1 ล้านล้านพารามิเตอร์จาก Thinking Machines

Thinking Machines เปิดตัว Inkling โมเดล open source ขนาดมหึมาที่รองรับอินพุตทั้งภาพ ข้อความ และเสียงแบบเนทีฟ พร้อม Context Window สูงถึง 1 ล้านโทเค็น และความสามารถด้านการใช้เหตุผลระดับสูง
Robbyant เปิดตัว LingBot-VLA 2.0: โมเดล VLA ขนาด 6B แบบ Open-Source คุมหุ่นยนต์ได้หลากหลายรูปแบบร่าง

Robbyant เปิดตัว LingBot-VLA 2.0: โมเดล VLA ขนาด 6B แบบ Open-Source คุมหุ่นยนต์ได้หลากหลายรูปแบบร่าง

· By: TanasakP
Robbyant จาก Ant Group เปิดตัว LingBot-VLA 2.0 โมเดลควบคุมหุ่นยนต์ข้ามรูปแบบร่างที่ฝึกฝนด้วยข้อมูลกว่า 60,000 ชั่วโมง โดยใช้สถาปัตยกรรม MoE และระบบพื้นที่การสั่งการมาตรฐาน 55 มิติเพื่อรองรับการสั่งงานที่ซับซ้อน
Tencent เปิดตัว Hy3 โมเดล AI โอเพนซอร์สสถาปัตยกรรม MoE ประสิทธิภาพแรงกว่าขนาดตัว 5 เท่า

Tencent เปิดตัว Hy3 โมเดล AI โอเพนซอร์สสถาปัตยกรรม MoE ประสิทธิภาพแรงกว่าขนาดตัว 5 เท่า

· By: NatapolK
Tencent เปิดตัวโมเดลภาษาขนาดใหญ่ Hy3 ชูจุดเด่นสถาปัตยกรรม MoE ที่มีพารามิเตอร์รวม 295 พันล้าน แต่ใช้ทรัพยากรประมวลผลจริงเพียง 21 พันล้านพารามิเตอร์ ให้ประสิทธิภาพสูงเทียบเท่าโมเดลขนาดใหญ่กว่าหลายเท่า พร้อมลดอัตราการหลอนลงกว่าครึ่ง