
Meta เปิดตัว Muse Spark Open โมเดล MoE 816B รองรับ Context 1M
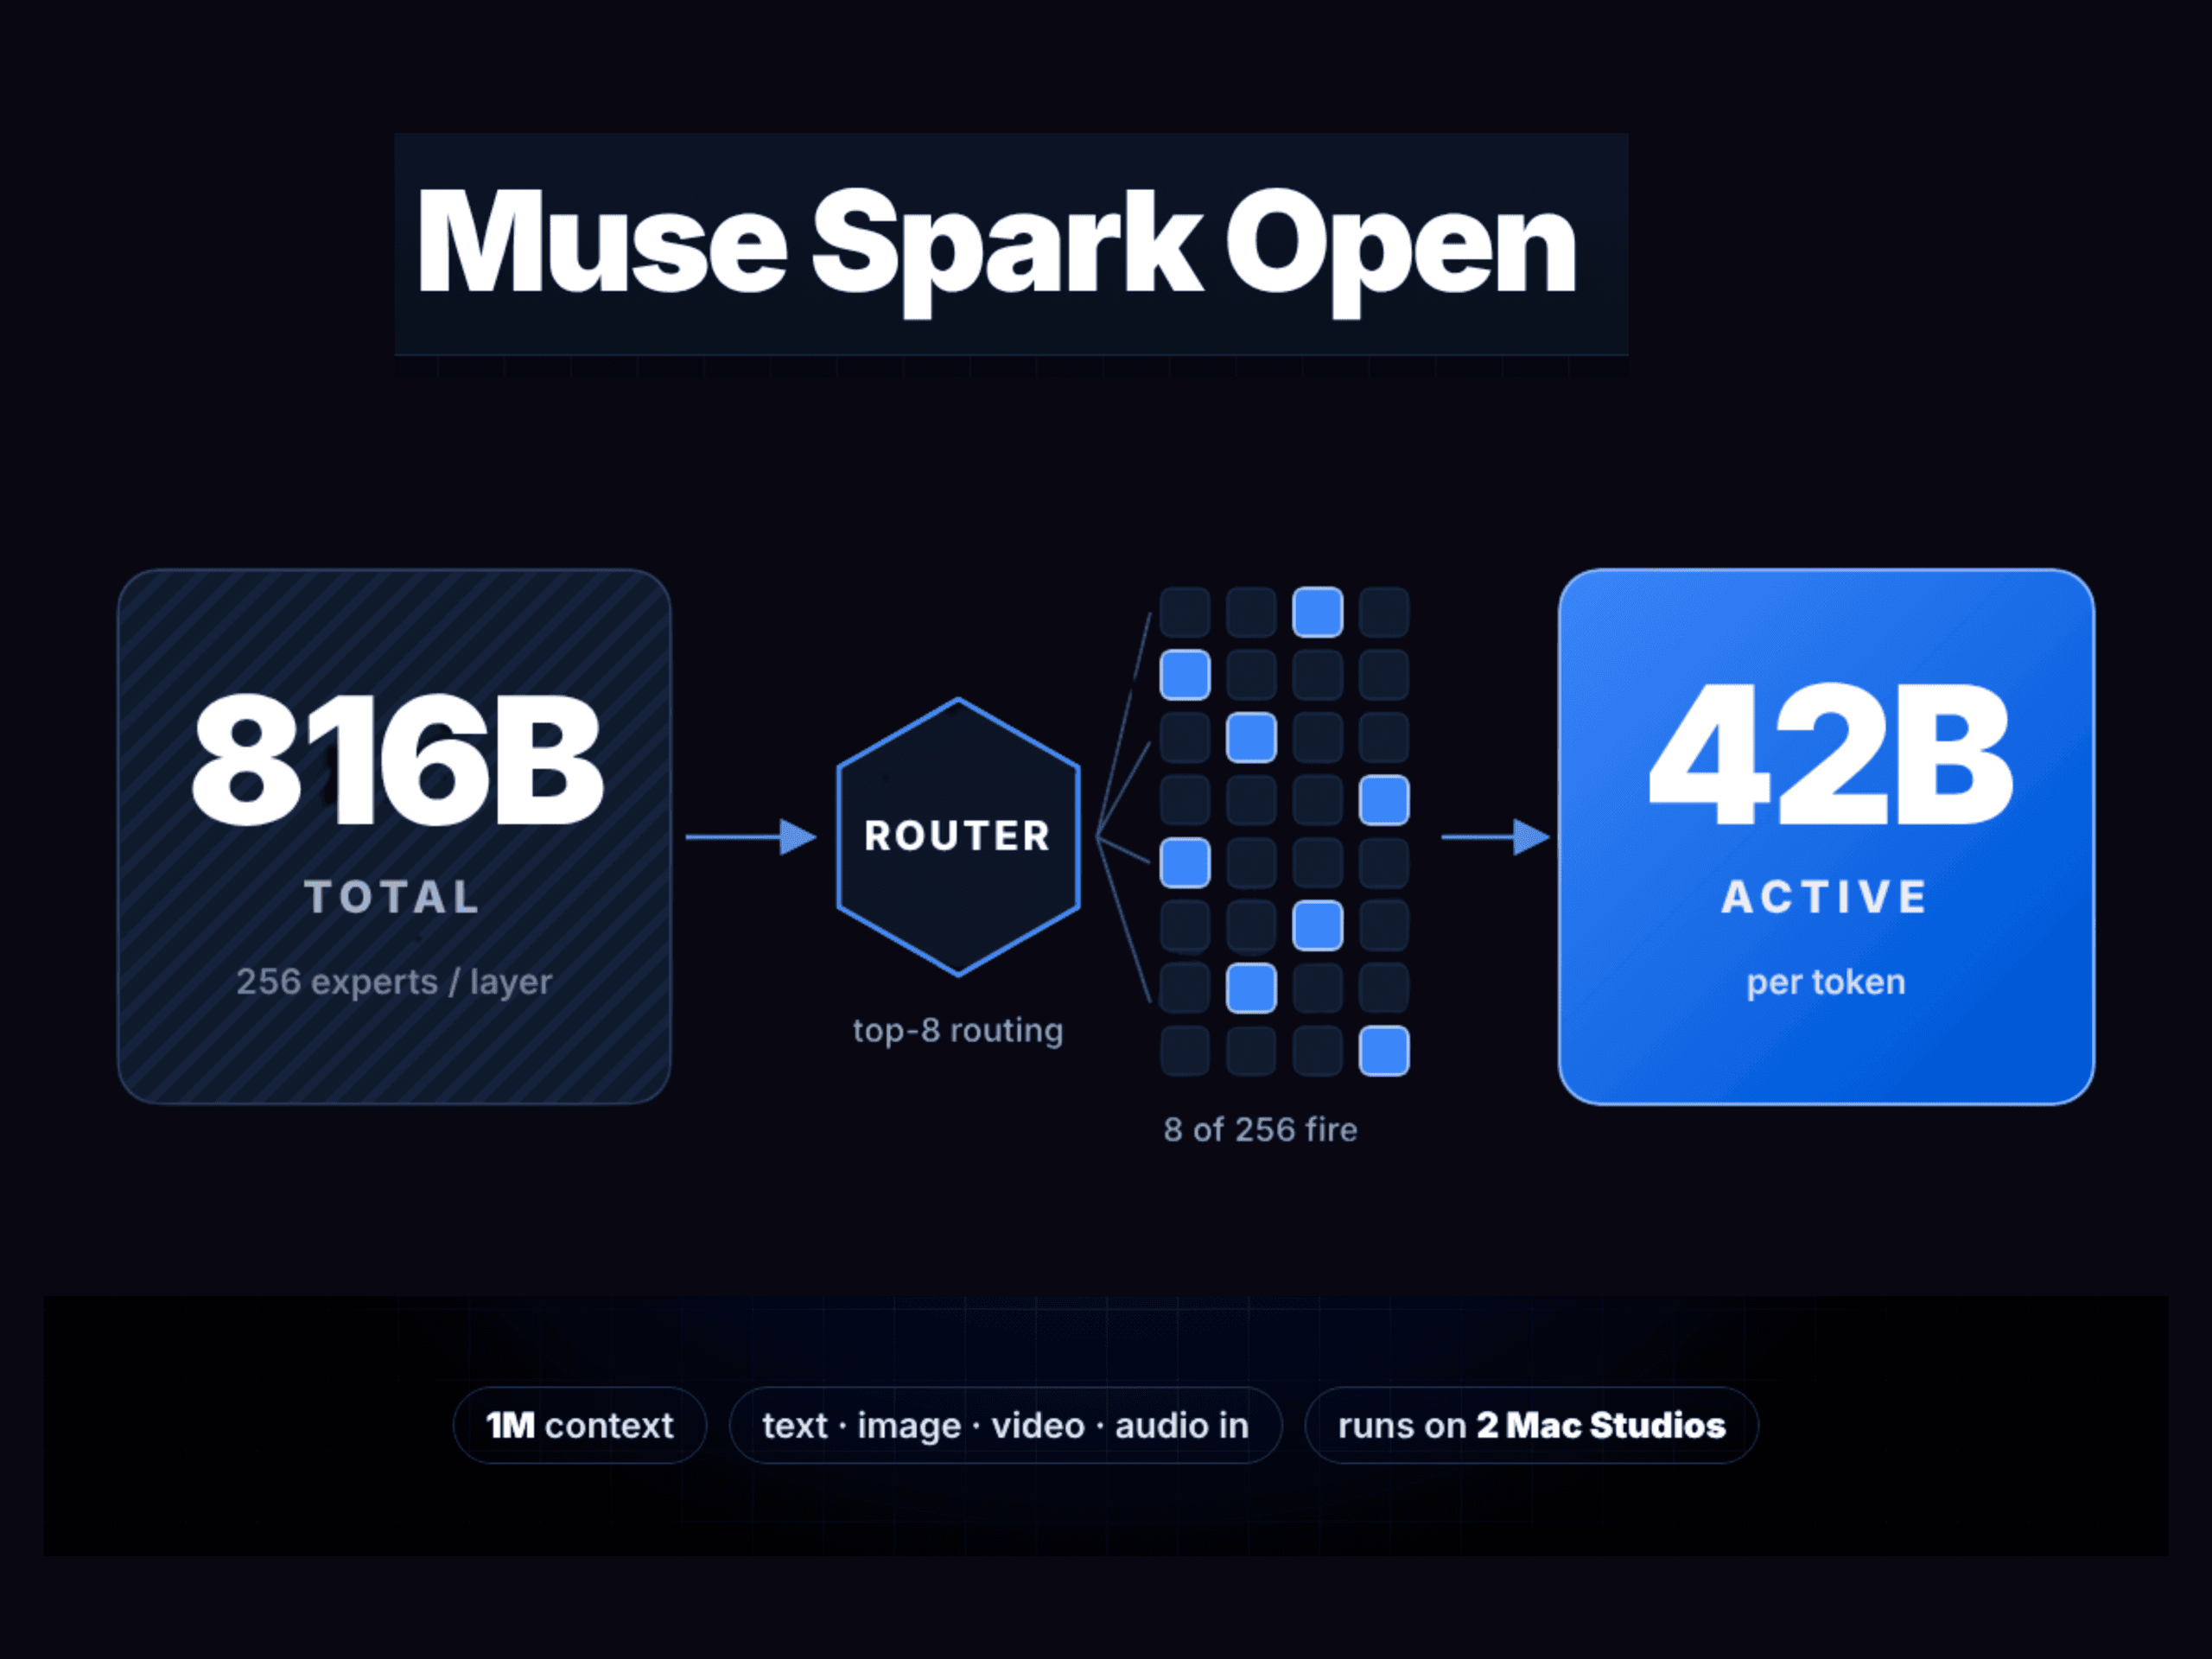
Meta Superintelligence Labs ได้เปิดตัว Muse Spark Open ซึ่งเป็นเวอร์ชัน open-weight ของโมเดล Muse Spark โดยเป็นโมเดลแบบ Mixture-of-Experts (MoE) ขนาด 816B พารามิเตอร์ ที่จะเปิดใช้งาน 42B พารามิเตอร์ต่อ token
โมเดลนี้รองรับอินพุตทั้งข้อความ รูปภาพ วิดีโอ และเสียง โดยส่งคืนค่าเป็นข้อความ และมี context window ขนาด 1M-token ทางทีม Meta กล่าวอ้างว่า เป็นโมเดลแบบ open-weight ของสหรัฐฯ ที่มีความสามารถสูงสุดในปัจจุบัน สำหรับนักพัฒนาความน่าสนใจอยู่ที่การปรับใช้ (deployment) ซึ่งตัว build แบบ NVFP4 สามารถรันบน Apple M5 Ultra Mac Studio จำนวน 2 เครื่องได้
TL;DR
- ขนาด: รวม 816B / ทำงานจริง 42B พารามิเตอร์ (256 experts, ทำงาน 8 ตัวต่อ token); context 1M-token
- รันบน: Mac Studio 2 เครื่อง (M5 Ultra, เครื่องละ 512 GB) ผ่าน MLX; GPU Blackwell Ultra 4 ตัว หรือ H200 8 ตัว พร้อม NVFP4; หรือการตั้งค่าประมาณ 300 GB ผ่าน Unsloth 2-bit GGUF
- ประสิทธิภาพ: แข็งแกร่งในการใช้งานเครื่องมือแบบ agentic; อยู่ในระดับกลางในกลุ่มโมเดลเปิดขนาดใหญ่ด้านการเขียนโค้ด
- ดีที่สุด: MCP-Atlas 89.2 ซึ่งเป็นคะแนนสูงสุดในตารางเปรียบเทียบของ Meta
- แย่ที่สุด: Terminal-Bench 2.1 ได้ 76.4 ตามหลัง Kimi K3 (85.0), GLM 5.3 (83.9) และ Qwen3.8 (82.0)
Muse Spark Open คืออะไร?
Muse Spark Open เป็นโมเดล MoE แบบ multimodal โดยกำเนิดจาก Meta สร้างขึ้นเพื่อการเขียนโค้ดและงานแบบ agentic ที่มีระยะเวลายาวนาน (long-horizon) โดยปล่อย weight ในรูปแบบ BF16 และ NVFP4 บน Hugging Face
ทั้งนี้เวอร์ชันเปิดได้รับการทำ post-training ด้านความปลอดภัยเพิ่มเติม ซึ่งทีม Meta ระบุว่าสิ่งนี้ทำให้โมเดลมีความแข็งแกร่งมากขึ้นโดยไม่ต้องมี guardrails ในระดับระบบ
สถาปัตยกรรมทำงานอย่างไร?
model card ระบุว่ามี 62 เลเยอร์ และ hidden dimension ขนาด 8192 ในแต่ละเลเยอร์ MoE ประกอบด้วย 256 experts และการหาเส้นทางแบบ top-k จะเปิดใช้งาน 8 ตัวต่อ token ส่วน attention เป็นแบบ grouped-query โดยมี 128 query heads และ 16 KV heads
นอกจากนี้ยังมี Perception Encoder ขนาด 1.8B พารามิเตอร์ แยกต่างหากเพื่อจัดการอินพุตที่เป็นภาพ มีคำศัพท์ (vocabulary) ทั้งหมด 202,048 tokens และข้อมูลที่ใช้เทรนครอบคลุมมากกว่า 100 ภาษา โดยความลึกในการใช้เหตุผลสามารถตั้งค่าได้ด้วย reasoning_effort: low, medium, high หรือ xhigh ซึ่งค่าเริ่มต้นคือ xhigh
ประสิทธิภาพของ Muse Spark Open บน benchmark เป็นอย่างไร?
Meta เปรียบเทียบกับ Kimi K3, GLM 5.3, Qwen3.8-2.4T-A95B และอื่นๆ ที่ระดับการใช้เหตุผลสูงสุด โดยผลลัพธ์ที่แข็งแกร่งที่สุดคือการใช้เครื่องมือและความน่าเชื่อถือของความรู้:
- MCP-Atlas: 89.2 นำหน้า Qwen3.8 (84.5) และ GLM 5.3 (84.2)
- JobBench: 61.8 นำหน้า GLM 5.3 (61.4) เล็กน้อย
- HLE-Diamond (ไม่มีเครื่องมือ): 26.1 เทียบกับ 22.2 สำหรับ Kimi K3
- AA Omniscience: 25 ซึ่งเป็นคะแนนสูงสุดในตารางของ Meta
- ZeroBench พร้อมเครื่องมือ: 50.0 เทียบกับ 41.0 สำหรับ Kimi K3
การเขียนโค้ดถือเป็นจุดอ่อน โดยในการทดสอบ Terminal-Bench 2.1 ด้วย Terminus 2 harness โมเดลทำคะแนนได้ 76.4 ขณะที่ Kimi K3 สูงถึง 85.0, GLM 5.3 ได้ 83.9 และ Qwen3.8 ได้ 82.0 ส่วนดัชนี Artificial Analysis Intelligence Index อยู่ที่ 39 ซึ่งตามหลังคู่แข่งจากจีนทั้งหมด
ดังนั้นคำกล่าวที่ว่า "ทรงพลังที่สุดในสหรัฐฯ" (most capable US) นั้นยังคงเป็นจริง แต่โมเดลแบบเปิดของจีนยังคงเป็นผู้นำในภาพรวม โดยคะแนนของคู่แข่งบางรายเป็นแบบรายงานด้วยตนเอง (self-reported) ซึ่งสามารถตรวจสอบ ระเบียบวิธีประเมินผล ได้จากที่มาของแต่ละแหล่งข้อมูล
Muse Spark Open ต้องการฮาร์ดแวร์อะไร?
ตาม คู่มือนักพัฒนา ของ Meta ระบุว่า weight แบบ BF16 มีขนาดประมาณ 1.6 TB ส่วน NVFP4 จะทำ quantization เฉพาะส่วน experts ทำให้เหลือขนาดใกล้เคียง 530 GB โดยแนะนำว่าควรมี VRAM อย่างน้อย 700 GB สำหรับ NVFP4 และ 2 TB สำหรับ BF16
- Data center: NVFP4 บน GPU Blackwell Ultra 4 ตัว หรือ H200 8 ตัว
- Desktop: M5 Ultra Mac Studios 2 เครื่อง พร้อมหน่วยความจำเครื่องละ 512 GB เชื่อมต่อผ่าน Thunderbolt 5 ด้วย RDMA โดยใช้ MLX tensor parallelism เพื่อแยกทุกเลเยอร์ไปรันบนทั้งสองเครื่อง
- Workstation: Unsloth Dynamic GGUFs ที่ลดขนาดลงเหลือ 2-bit สามารถบรรจุลงในหน่วยความจำรวมประมาณ 300 GB ได้
นักพัฒนาสามารถรันได้ที่ไหน?
เอนจินที่รองรับตั้งแต่วันแรก ได้แก่ SGLang, vLLM, TensorRT-LLM, Hugging Face Transformers, MLX, llama.cpp และ Unsloth ส่วน hosted API เปิดให้บริการแล้วบน Baseten, Fireworks AI, Groq, Modal, Nebius, OpenRouter และ Together AI โดย OpenRouter ระบุราคาที่ $1.25 ต่อ 1M input tokens และ $4.25 ต่อ 1M output tokens
มีโมเดลร่าง (draft models) สองตัวเพื่อช่วยเร่งความเร็วในการถอดรหัส (decoding): DFlash V2 สำหรับ SGLang และ DSpark สำหรับ vLLM โดย Meta รายงานว่ามี throughput สำหรับ single-request เพิ่มขึ้น 3.7 เท่าเมื่อใช้ DFlash V2 บน AMD MI355X ส่วนการ fine-tuning สามารถทำได้ด้วย TorchTitan, Hugging Face TRL และ NVIDIA NeMo AutoModel
สัญญาอนุญาต Muse Model License อนุญาตอะไรบ้าง?
Muse Model License อนุญาตให้ใช้งาน, fine-tuning, distillation และเผยแพร่ต่อได้ โดยมีเงื่อนไขสำคัญคือผลิตภัณฑ์ต้องแสดงข้อความ “Built with Muse Spark Open” และผู้ให้บริการ Model-as-a-Service ที่มีรายได้เกิน 20 ล้านดอลลาร์ในรอบ 12 เดือน จำเป็นต้องมีข้อตกลงแยกต่างหากกับ Meta
สำหรับการใช้งานภายในองค์กร งานวิจัย และการเพิ่มฟีเจอร์ในผลิตภัณฑ์ของคุณเองจะได้รับการยกเว้นจากข้อกำหนดเรื่องรายได้
Muse Spark Open vs Kimi K3 vs GLM 5.3 vs Qwen3.8
| คุณสมบัติ | Muse Spark Open | Kimi K3 | GLM 5.3 | Qwen3.8-2.4T-A95B |
|---|---|---|---|---|
| พารามิเตอร์ทั้งหมด | 816B | 2.8T | 753B | 2.4T |
| พารามิเตอร์ที่ทำงานจริง | 42B | 104B | ~40B | 95B |
| Context | 1M | 1,048,576 | 1,048,576 | 262,144 (native), สูงสุด 1,010,000 |
| อินพุต | ข้อความ, รูปภาพ, วิดีโอ, เสียง | ข้อความ, รูปภาพ, วิดีโอ | ข้อความ | ข้อความ |
| สัญญาอนุญาต | Muse Model License | Kimi K3 License | glm-5.3 license | qwen3.8-max license |
| Weight ที่ปล่อย | BF16, NVFP4 | MXFP4 (QAT) | BF16, FP8 | BF16 |
| AA Intelligence Index (ผ่าน Meta) | 39 | 44 | 45 | 40 |
| Terminal-Bench 2.1, Terminus 2 (ผ่าน Meta) | 76.4 | 85.0 | 83.9 | 82.0 |
| MCP-Atlas (ผ่าน Meta) | 89.2 | 82.3 | 84.2 | 84.5 |
| Toolathlon Verified (ผู้ผลิต) | 72.8 | 76.5 | 73.0 | 72.5 |
| HLE พร้อมเครื่องมือ (ผู้ผลิต) | 61.0 | 56.0 | 62.5 | 56.2 |
| DeepSWE 1.1 (ผู้ผลิต, harness ของตนเอง) | 60 | 67.5 | 66.9 | 56.6 |
| การตั้งค่าเดสก์ท็อป | 2x M5 Ultra Mac Studio | ไม่ระบุ | ไม่ระบุ | ไม่ระบุ |
ประเด็นสำคัญ
- รวม 816B, ทำงานจริง 42B, context 1M, รองรับอินพุตข้อความ/รูปภาพ/วิดีโอ/เสียง
- เป็นผู้นำในตารางโมเดลเปิดของ Meta บน MCP-Atlas (89.2) และ JobBench (61.8)
- ตามหลัง Kimi K3, GLM 5.3 และ Qwen3.8 ในด้าน Terminal-Bench 2.1 (76.4)
- ตัว build แบบ NVFP4 สามารถรันบน M5 Ultra Mac Studio 2 เครื่องผ่าน MLX
- ฟรีสำหรับผู้ใช้ส่วนใหญ่; ผู้ให้บริการ MaaS ที่มีรายได้เกิน 20 ล้านดอลลาร์ต้องมีข้อตกลงพิเศษ
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร