
JetBrains เปิดตัว Mellum2.1 โมเดล MoE 12B สำหรับ Coding Agents
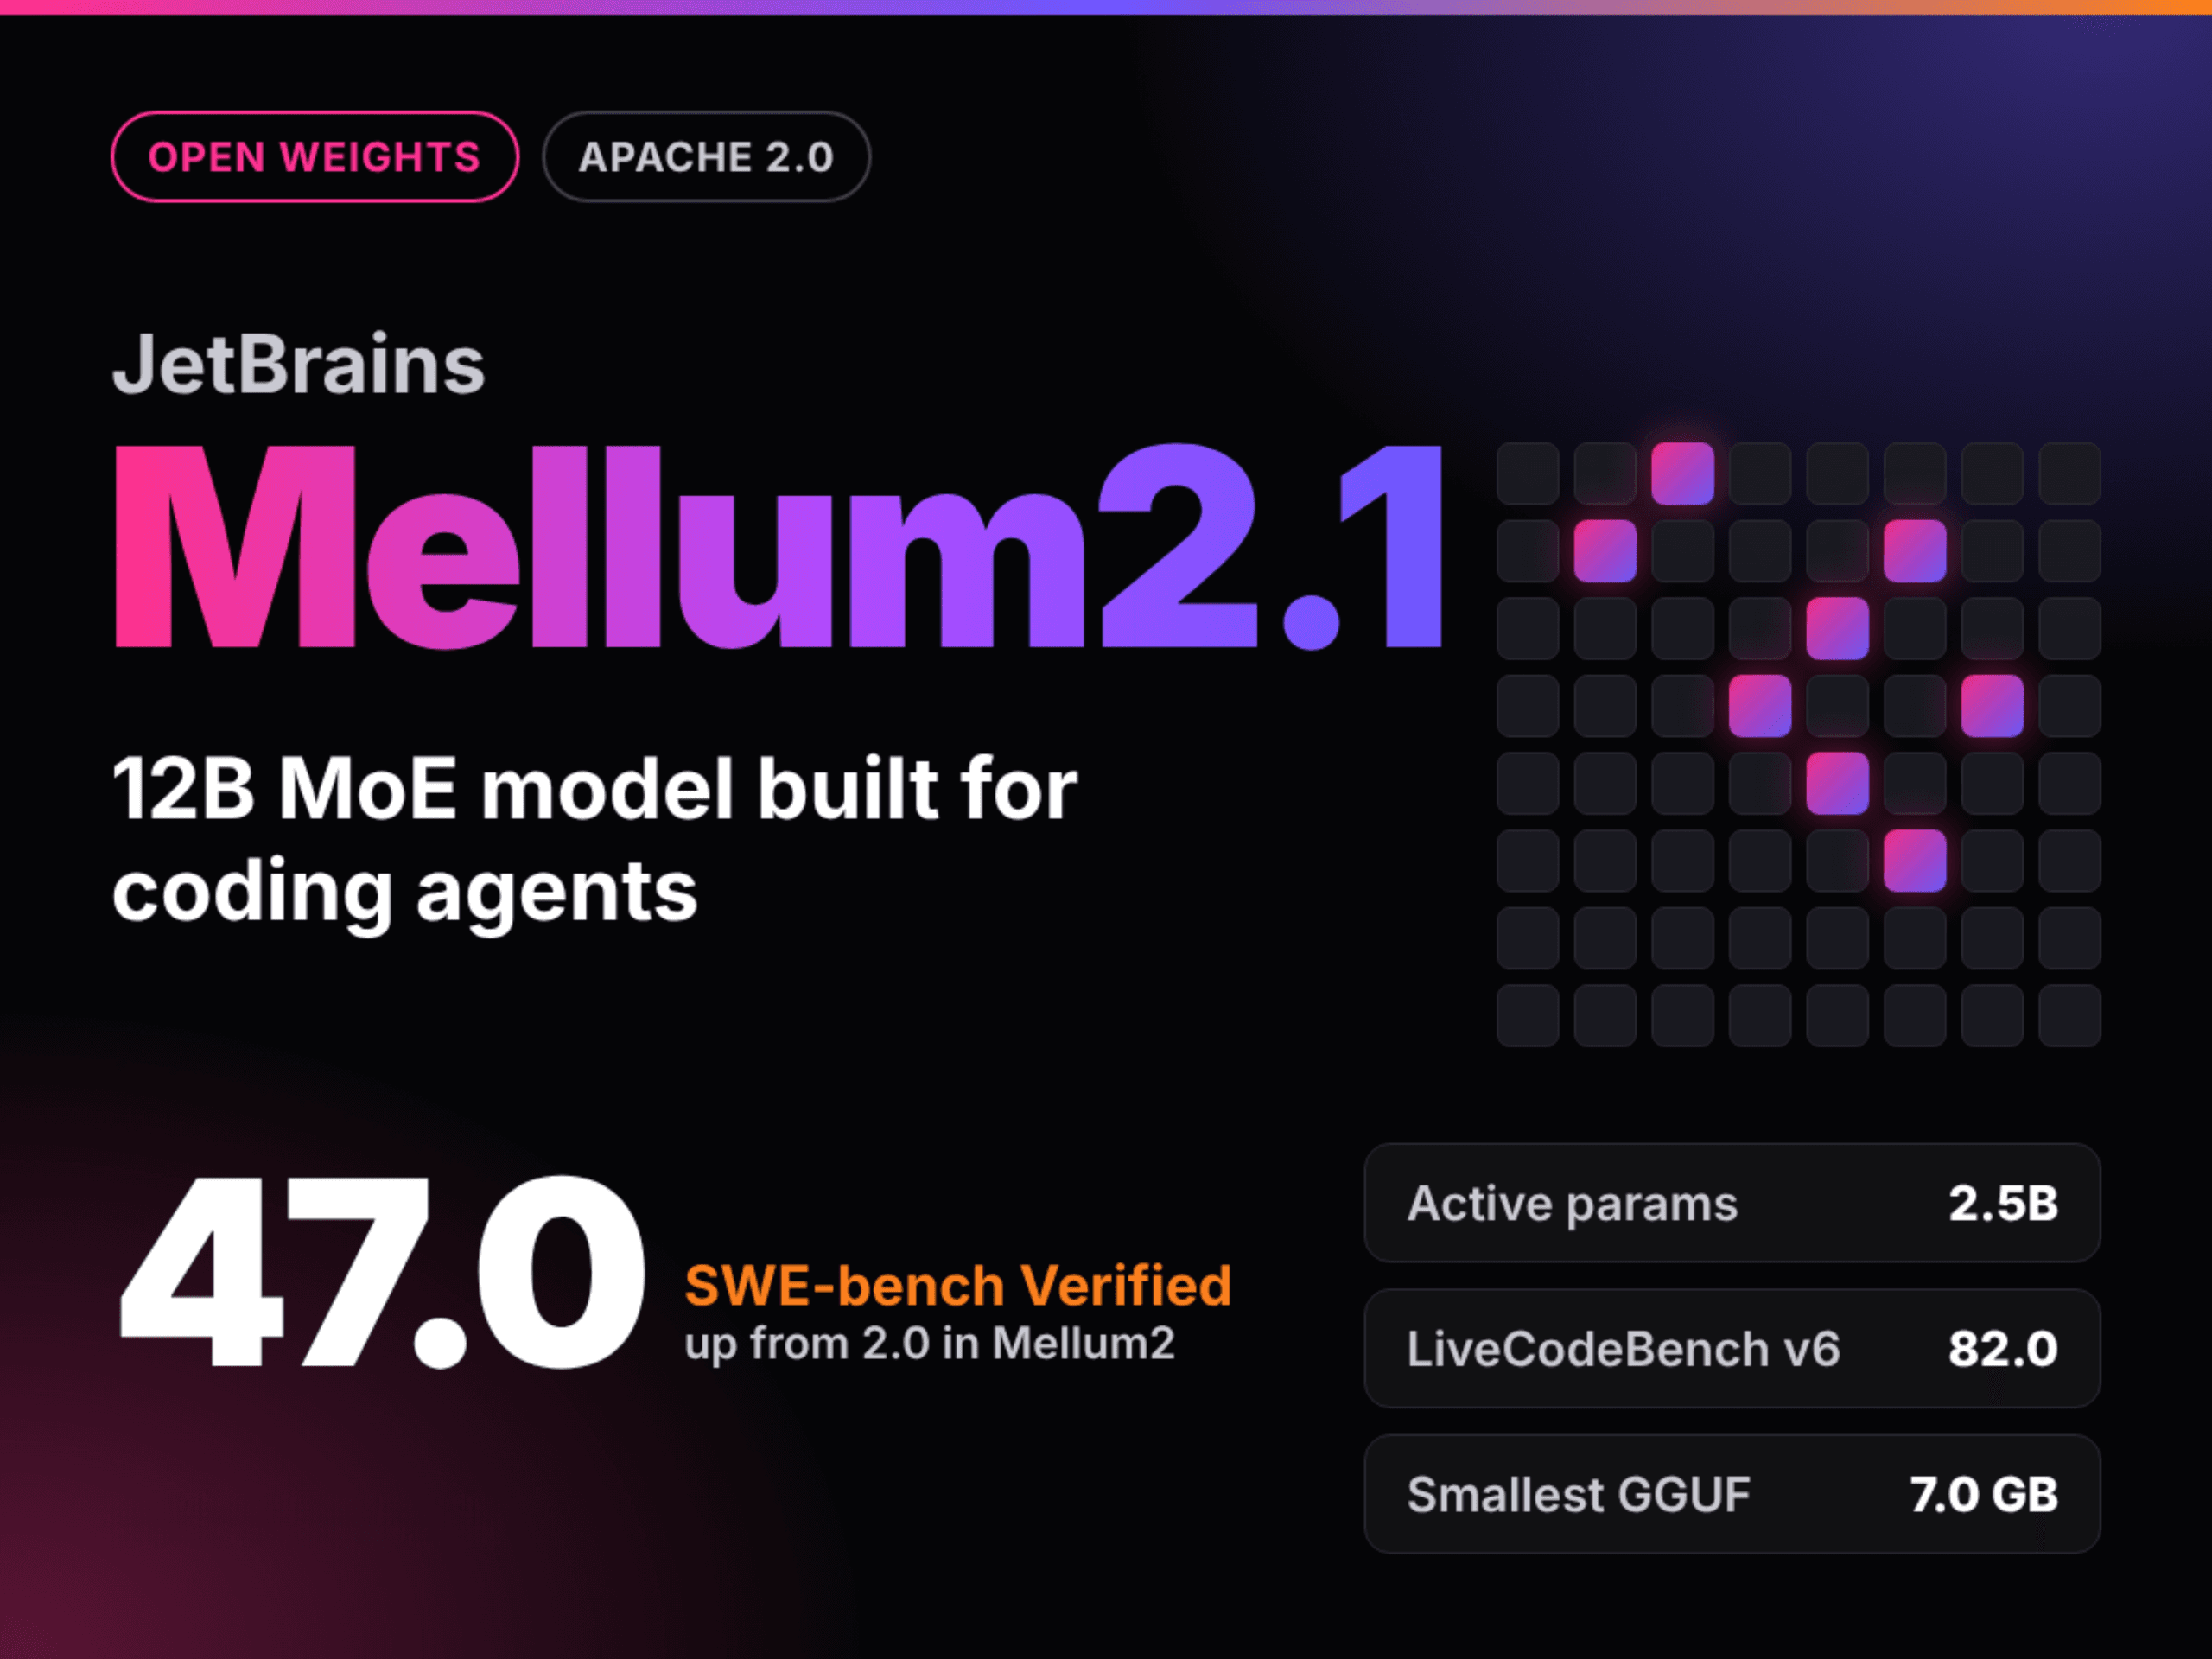
JetBrains เปิดตัว Mellum2.1 โมเดลแบบเปิด (open model) ที่ออกแบบมาเพื่อความรวดเร็วสำหรับ coding agents และ sub-agents โดยเฉพาะ Mellum2.1 ใช้สถาปัตยกรรมแบบ mixture-of-experts ขนาด 12B ซึ่งมีพารามิเตอร์ทำงานจริงเพียง 2.5B ต่อ token เผยแพร่ภายใต้สัญญาอนุญาต Apache 2.0 บน Hugging Face
แม้สถาปัตยกรรมจะยังคงเดิมจาก Mellum2 แต่การอัปเกรดส่วนใหญ่เกิดขึ้นจากการเรียนรู้แบบเสริมกำลัง (reinforcement learning หรือ RL) ในสภาพแวดล้อมซอฟต์แวร์จริง ส่งผลให้ได้โมเดลขนาดเล็กที่สามารถรันเองได้ (self-hosting) พร้อมความสามารถในการสำรวจ repository แก้ไขไฟล์ และตรวจสอบความถูกต้องของการเปลี่ยนแปลงโค้ดได้ด้วยตัวเอง
TL;DR
- ขนาด: รวม 12B, ทำงานจริง 2.5B (64 experts, เปิดใช้งาน 8), context 131,072 token
- การรัน: ใช้งานผ่าน GPU ของคุณเองด้วย vLLM หรือ SGLang (ทดสอบบน NVIDIA H200) ส่วนเวอร์ชัน GGUF สำหรับ llama.cpp, Ollama และ LM Studio เริ่มต้นที่ 7.0 GB
- ประสิทธิภาพ: ชนะ Mellum2 ใน 15 จาก 17 benchmark และชนะ Qwen3.5-9B ได้ใน 5 จาก 17 หัวข้อ
- จุดแข็ง: ทำคะแนนได้ 82.0 บน LiveCodeBench v6 นำหน้า Qwen3.5-9B (75.4) และ Gemma 4 E4B (69.4)
- จุดอ่อน: ทำได้ 17.4 บน Terminal-Bench 2.1 ซึ่งยังต่ำกว่า Qwen3.5-9B (21.7)
- สรุป (จุดเด่น): เขียนโค้ดได้ยอดเยี่ยมและมี throughput สูงเนื่องจากใช้พารามิเตอร์ทำงานจริงเพียง 2.5B
- สรุป (จุดด้อย): ยังตามหลัง Qwen3.5-9B ในงานด้านความรู้ทั่วไปและงานแบบ agentic ที่มีความซับซ้อนสูง
Mellum2.1 คืออะไร?
Mellum2.1 คือเวอร์ชันพัฒนาต่อจาก Mellum2 Thinking ที่ JetBrains เปิดเป็น open-source ในเดือนมิถุนายน 2026 โดยเวอร์ชันล่าสุดคือ Mellum2.1-12B-A2.5B-Thinking ซึ่งเป็นโมเดลที่แสดงกระบวนการคิด (chain of thought) ก่อนตอบคำถาม
JetBrains วางเป้าหมายการใช้งานไว้ 3 ด้านหลัก ได้แก่ การเป็นเครื่องมือช่วยงานอัตโนมัติ (agent worker), ผู้ช่วยให้เหตุผลทั่วไป และการนำไปติดตั้งใช้งานแบบส่วนตัวภายในองค์กร
สถาปัตยกรรม Mellum2.1 ทำงานอย่างไร?
โมเดลประกอบด้วย 28 layer และ 64 experts โดยมีระบบ router เลือกเปิดใช้งาน 8 experts ต่อหนึ่ง token สำหรับส่วน attention ใช้เทคนิค grouped-query attention (32 query heads และ 4 KV heads) โดยในทุก 3 จาก 4 layer จะใช้ระบบ sliding window ขนาด 1,024 token รองรับ context ยาวสูงสุด 131,072 token และมี vocabulary 98,304 token โดยเก็บน้ำหนักโมเดลในรูปแบบ bfloat16
Mellum2.1 ถูกฝึกฝนอย่างไร?
กระบวนการพัฒนาส่วนใหญ่เน้นไปที่ช่วง post-training โดยขยายส่วน RL ให้เป็นหัวใจหลักของการฝึกฝน JetBrains ได้เพิ่มโจทย์ RL ครอบคลุมทั้งด้านคณิตศาสตร์ การแข่งขันเขียนโปรแกรม วิทยาศาสตร์ การใช้เครื่องมือ และวิศวกรรมซอฟต์แวร์ นอกจากนี้ยังมีการกรองชุดข้อมูลแบบเปิดเพื่อคัดกรองงานที่ง่ายเกินไปหรือมีข้อผิดพลาดออก
ในส่วนของวิศวกรรมซอฟต์แวร์ โมเดลถูกฝึกใน repository จริงโดยใช้ shell และเครื่องมือแก้ไขไฟล์จริง โมเดลจะได้รับรางวัล (reward) เมื่อทำการทดสอบผ่าน ซึ่งการฝึกฝนนี้ทำงานบน sandbox หลายล้านเครื่องภายใต้สภาพแวดล้อมที่แตกต่างกันนับพันรูปแบบ
ประสิทธิภาพบน Benchmark
JetBrains ประเมิน Mellum2.1 เปรียบเทียบกับ Mellum2, Qwen3.5-9B และ Gemma 4 E4B ผ่านระบบทดสอบเดียวกันในโหมด thinking ซึ่งผลคะแนนทั้งหมดรายงานโดย JetBrains เอง
จุดที่พัฒนาขึ้นอย่างโดดเด่นคือ agentic coding โดยคะแนน SWE-bench Verified พุ่งจาก 2.0 เป็น 47.0 ขณะที่ SWE-bench Pro เพิ่มจาก 0.0 เป็น 28.0 และ Terminal-Bench 2.1 ขยับจาก 0.6 เป็น 17.4 ซึ่งการทดสอบแบบ Agentic นี้ใช้เฟรมเวิร์ก Pi v0.73.1 พร้อม context ขนาด 114K-token
Mellum2.1 ขึ้นแท่นผู้นำในกลุ่มใน LiveCodeBench v6 (82.0), HumanEval+ (91.5), MBPP+ (79.4) และ BFCL v4 (62.3) อย่างไรก็ตาม Qwen3.5-9B ยังคงรักษาตำแหน่งผู้นำในด้าน SWE-bench Verified (50.0), SWE-bench Pro (38.0), AIME 25/26 (86.7) และ GPQA Diamond (77.8) ส่วนด้านความปลอดภัยนั้น Mellum2.1 ทำได้ดีขึ้น โดยคะแนน HarmBench ลดลงเหลือ 8.5 (ยิ่งต่ำยิ่งดี)
ทั้งนี้ มีข้อสังเกตว่าตัวเลขผลลัพธ์อาจต่างกันตามวิธีการทดสอบ เช่น Qwen ระบุคะแนน LiveCodeBench v6 ของตนเองไว้ที่ 65.6 และ GPQA Diamond ที่ 81.7 แต่ทาง JetBrains วัดได้ 75.4 และ 77.8 ตามลำดับ
Mellum2.1 เร็วแค่ไหน? เนื่องจากไม่มีการเปลี่ยนสถาปัตยกรรมในช่วง post-training ความเร็วจึงเท่ากับ Mellum2 โดย JetBrains ระบุว่าเมื่อรันบน H200 1 ใบ Mellum2.1 สามารถจ่าย token ได้เร็วกว่า Qwen3.5-9B เกือบ 2 เท่าต่อหนึ่งการร้องขอ และเมื่อใช้ multi-token prediction (MTP) จะช่วยให้เร็วขึ้นถึง 1.6 เท่า โดยแผนการเพิ่ม MTP head สำหรับ vLLM speculative decoding จะตามมาเร็วๆ นี้
วิธีการรัน Mellum2.1 ในเครื่อง (locally)
ผู้ใช้สามารถรันโมเดลตัวเต็มบน vLLM โดยใช้คำสั่ง --reasoning-parser qwen3 และสำหรับการเรียกใช้เครื่องมือ (tool call) ให้เพิ่ม --enable-auto-tool-choice --tool-call-parser hermes โดยตั้งค่าแนะนำที่ temperature 0.6, top_p 0.95 และ top_k 20
สำหรับการใช้งานผ่าน GGUF นั้นอยู่ระหว่างดำเนินการ ซึ่งใน GGUF repository มีไฟล์ให้เลือกดังนี้:
- BF16: 24.3 GB (ขนาดเต็ม)
- Q8_0: 12.9 GB (ความแม่นยำ 96.1%)
- Q6_K: 10.9 GB (ความแม่นยำ 93.9%)
- Q4_K_M: 8.1 GB (ความแม่นยำ 88.0% - แนะนำให้ใช้)
- MXFP4_MOE: 7.0 GB (ความแม่นยำ 85.6%)
ตารางเปรียบเทียบประสิทธิภาพ
| คุณสมบัติ | Mellum2.1 | Mellum2 Thinking | Qwen3.5-9B | Gemma 4 E4B |
|---|---|---|---|---|
| สถาปัตยกรรม | MoE, 64 experts (8 active) | MoE (เช่นเดียวกับ 2.1) | Hybrid Gated DeltaNet | Dense |
| พารามิเตอร์รวม | 12B | 12B | 9B | 8B |
| พารามิเตอร์ทำงานจริง | 2.5B active | 2.5B active | 9B (dense) | 4.5B effective |
| Context | 131,072 | 131,072 | 262,144+ | 128K |
| LiveCodeBench v6* | 82.0 | 69.4 | 75.4 | 69.4 |
| SWE-bench Verified* | 47.0 | 2.0 | 50.0 | 23.0 |
| BFCL v4* | 62.3 | 49.6 | 58.5 | 52.5 |
| GPQA Diamond* | 64.6 | 51.0 | 77.8 | 53.1 |
หมายเหตุ: เป็นคะแนนจากการทดสอบโดย JetBrains ในโหมด thinking เพื่อเปรียบเทียบมาตรฐานเดียวกัน
สรุปประเด็นสำคัญ
- Mellum2.1 เป็นโมเดล MoE ขนาด 12B ที่ประหยัดทรัพยากรด้วยการทำงานจริงเพียง 2.5B ภายใต้ลิขสิทธิ์ Apache 2.0
- การฝึกแบบ RL ในสภาพแวดล้อมจริงทำให้ความสามารถในงานวิศวกรรมซอฟต์แวร์ก้าวกระโดดอย่างมาก
- โดดเด่นเป็นพิเศษใน LiveCodeBench v6 และการทำงานผ่านเครื่องมือ (BFCL v4)
- แม้ในงานยากๆ จะยังตามหลัง Qwen3.5-9B แต่ด้วยเวอร์ชัน GGUF ที่มีขนาดเพียง 7-8 GB ทำให้การใช้งาน coding agents บนเครื่องส่วนตัวมีประสิทธิภาพและเป็นไปได้จริงมากขึ้น
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร