tag: Text-to-Speech

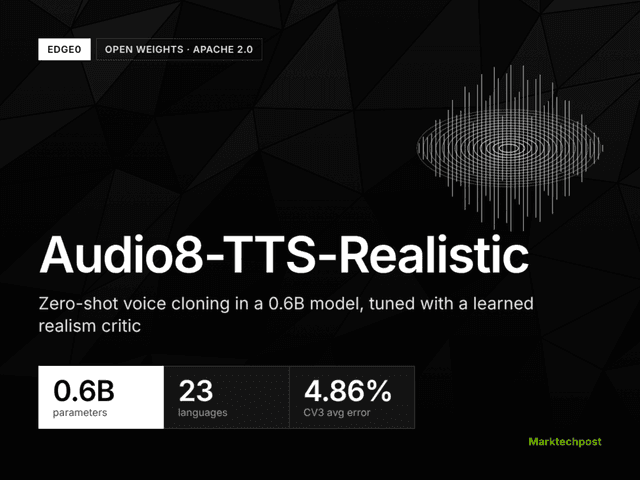
Edge0 เปิดตัวโมเดล Audio8-TTS-Realistic โคลนเสียงสมจริง 23 ภาษา

Edge0 เปิดตัวโมเดล Audio8-TTS-Realistic โคลนเสียงสมจริง 23 ภาษา

· By: TanasakP
Edge0 เปิดตัวโมเดล text-to-speech แบบ open-weight ขนาด 0.6B รองรับ 23 ภาษา รวมถึงภาษาไทย โดดเด่นด้วยการใช้ GRPO และ realism critic เพื่อเพิ่มความเป็นธรรมชาติของเสียง
AssemblyAI เปิดตัว TTS-1 ชูความเร็วสูง ราคาประหยัดสำหรับ Voice Agents

AssemblyAI เปิดตัว TTS-1 ชูความเร็วสูง ราคาประหยัดสำหรับ Voice Agents

· By: AttapolK
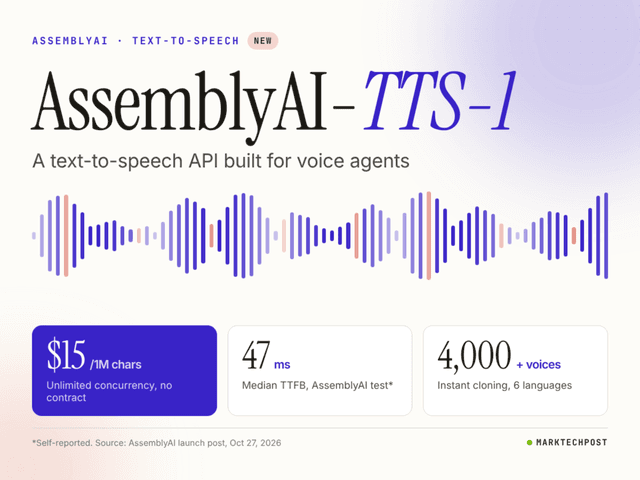
AssemblyAI รุกตลาดเสียงด้วยโมเดล text-to-speech ตัวแรก TTS-1 ชูจุดเด่นที่ความหน่วงต่ำเพียง 47ms และราคาเพียง 15 ดอลลาร์ต่อ 1 ล้านตัวอักษร พร้อมรองรับการโคลนเสียงทันที
Ollama สำหรับ Mac รองรับโมเดล Text-to-Speech แบบ Local แล้ว

Ollama สำหรับ Mac รองรับโมเดล Text-to-Speech แบบ Local แล้ว

· By: NatapolK
Ollama แพลตฟอร์มรัน AI แบบ Local ยอดนิยม ประกาศรองรับการสร้างเสียงจากข้อความ (text-to-speech) บน Mac ผ่านโมเดล Phonon โดยเตรียมขยายสู่ Windows และ Linux เร็วๆ นี้
Gradium เปิดซอร์ส Phonon โมเดล TTS ขนาดจิ๋ว รันบนอุปกรณ์ได้ทันที

Gradium เปิดซอร์ส Phonon โมเดล TTS ขนาดจิ๋ว รันบนอุปกรณ์ได้ทันที

· By: SirilukP
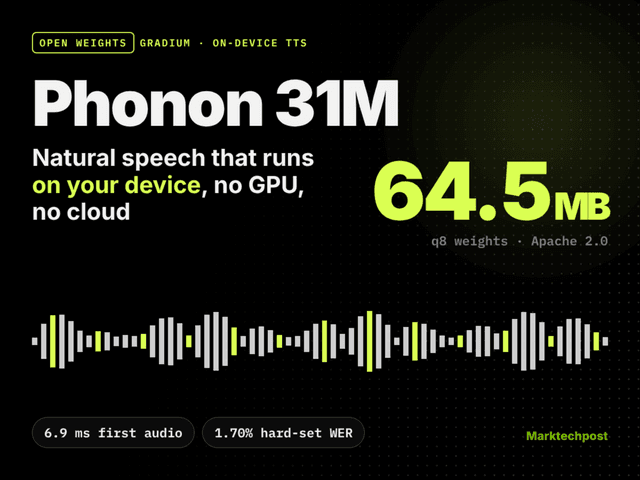
Gradium เปิดตัว Phonon ตระกูลโมเดล text-to-speech แบบ on-device ขนาดเริ่มต้นเพียง 31 ล้านพารามิเตอร์ ให้เสียงเป็นธรรมชาติโดยไม่ต้องพึ่งพา Cloud หรือ GPU
Fish Audio เปิดตัว Drama 3 โมเดล TTS สถาปัตยกรรม MoE 35B

Fish Audio เปิดตัว Drama 3 โมเดล TTS สถาปัตยกรรม MoE 35B

· By: NatapolK
Fish Audio เปิดตัว Drama 3 โมเดล Text-to-Speech แบบ open-weight ขนาด 35B ที่สั่งการอารมณ์ด้วยภาษาทั่วไปได้ รองรับ 83 ภาษา และใช้งานได้ฟรีภายใต้เงื่อนไขรายได้ที่กำหนด
Microsoft AI เปิดตัวโมเดลถอดความและสังเคราะห์เสียงรุ่นใหม่

Microsoft AI เปิดตัวโมเดลถอดความและสังเคราะห์เสียงรุ่นใหม่

· By: AttapolK
Microsoft AI เปิดตัว MAI-Transcribe-2-Streaming โมเดลถอดความแบบเรียลไทม์ที่เคลมว่าแม่นยำที่สุดในตลาด พร้อมโมเดลสังเคราะห์เสียง MAI-Voice-2.1 ที่รองรับสำเนียงเจ้าของภาษาถึง 23 ภาษา
Open TTS Leaderboard มาตรฐานใหม่ประเมินโมเดลสร้างเสียงหลายภาษา

Open TTS Leaderboard มาตรฐานใหม่ประเมินโมเดลสร้างเสียงหลายภาษา

· By: TanasakP
Hugging Face เปิดตัว Open TTS Leaderboard เพื่อสร้างมาตรฐานการประเมินโมเดลแปลงข้อจำเป็นเสียง (TTS) เชิงวัตถุที่วัดผลได้รวดเร็วและรองรับความหลากหลายทางภาษา
Google เปิดตัว Gemini 3.8 TTS ปฏิวัติการสร้างเสียงด้วย AI

Google เปิดตัว Gemini 3.8 TTS ปฏิวัติการสร้างเสียงด้วย AI

· By: SirilukP
Google เปิดตัวโมเดล Gemini 3.8 Flash TTS และ Flash-Lite TTS ที่เปลี่ยนการสร้างเสียงจากค่าล่วงหน้าแบบเดิม ให้กลายเป็นสตูดิโอเสียงที่ปรับแต่งได้ละเอียดผ่านพรอมต์ภาษาธรรมชาติ
Gradium เปิดตัว Voice Design สร้างเสียงสังเคราะห์คุณภาพสูงจาก Prompt ในไม่กี่วินาที

Gradium เปิดตัว Voice Design สร้างเสียงสังเคราะห์คุณภาพสูงจาก Prompt ในไม่กี่วินาที

· By: AttapolK
Gradium สตาร์ทอัพ Voice AI จากปารีส เปิดตัวฟีเจอร์ Voice Design ที่ช่วยให้ผู้พัฒนาสามารถสร้างเสียงสังเคราะห์ใหม่ตามจินตนาการได้เพียงการเขียนคำอธิบาย โดยไม่ต้องใช้ไฟล์เสียงต้นฉบับหรือการโคลนเสียง
Gradium AI เปิดตัวโมเดล TTS รุ่นใหม่ ชูความแม่นยำ 81% และความหน่วงต่ำเพียง 216 ms

Gradium AI เปิดตัวโมเดล TTS รุ่นใหม่ ชูความแม่นยำ 81% และความหน่วงต่ำเพียง 216 ms

· By: TanasakP
Gradium AI เปิดตัวโมเดล Text-to-Speech พื้นฐานตัวใหม่ที่แก้ปัญหาความเร็วและความแม่นยำสวนทางกัน โดยทำคะแนนประเมินจากมนุษย์ในประโยคยากได้ 81.0% พร้อมความเร็ว Time-to-First-Audio ที่ 216 ms บน Coval
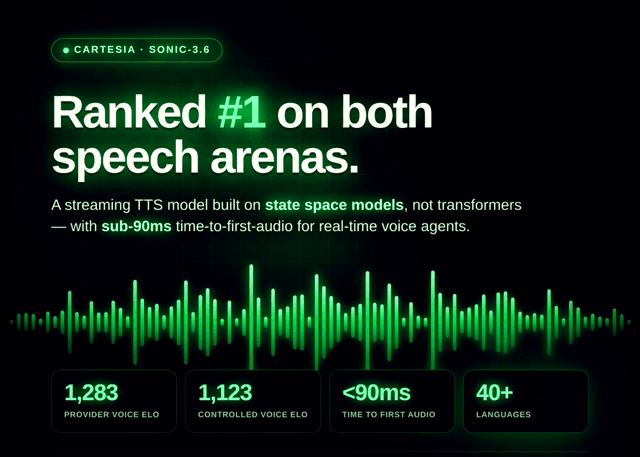
Cartesia เปิดตัว Sonic-3.6 โมเดล AI สร้างเสียงพูดระดับท็อป ครองอันดับ 1 ในทุกตารางทดสอบ

Cartesia เปิดตัว Sonic-3.6 โมเดล AI สร้างเสียงพูดระดับท็อป ครองอันดับ 1 ในทุกตารางทดสอบ

Cartesia ปล่อย Sonic-3.6 โมเดล Text-to-Speech แบบสตรีมมิ่งที่ใช้สถาปัตยกรรม State Space Models จนสามารถคว้าอันดับ 1 ในตาราง Artificial Analysis ทั้งสองรายการ ด้วยความเร็วในการสร้างเสียงครั้งแรกต่ำกว่า 90ms
NVIDIA เปิดตัว Magpie TTS โมเดลสร้างเสียงหลายภาษาแบบ Open Weights ชูจุดเด่นความหน่วงต่ำระดับมิลลิวินาที

NVIDIA เปิดตัว Magpie TTS โมเดลสร้างเสียงหลายภาษาแบบ Open Weights ชูจุดเด่นความหน่วงต่ำระดับมิลลิวินาที

· By: SirilukP
NVIDIA เปิดตัว Magpie TTS โมเดล Text-to-speech แบบ open weights รองรับ 12 ภาษา รวมถึงภาษาใหม่และรองรับการสลับภาษาไปมา (code-switching) ออกแบบมาเพื่อสร้าง Voice Agent ที่ทำงานได้รวดเร็วและควบคุมการติดตั้งได้เองบนโครงสร้างพื้นฐานของผู้ใช้
เจาะลึกวิศวกรรมการสร้าง Voice AI Agent: เมื่อเสียงเป็นมากกว่าแค่การพิมพ์

เจาะลึกวิศวกรรมการสร้าง Voice AI Agent: เมื่อเสียงเป็นมากกว่าแค่การพิมพ์

สรุปกระบวนการสร้างเอเจนต์ AI ควบคุมด้วยเสียง ตั้งแต่การถอดความสตรีมมิ่ง การตรวจจับรอบสนทนา ไปจนถึงการจัดการระบบพูดแทรก เพื่อมอบประสบการณ์การสื่อสารที่เป็นธรรมชาติและลดความหน่วง
เริ่มต้นใช้งาน OmniVoice Studio: ทางเลือกโอเพนซอร์สของ ElevenLabs ที่ทำงานแบบ Local 100%

เริ่มต้นใช้งาน OmniVoice Studio: ทางเลือกโอเพนซอร์สของ ElevenLabs ที่ทำงานแบบ Local 100%

OmniVoice Studio คือเครื่องมือจัดการเสียงระดับมืออาชีพที่รันบนฮาร์ดแวร์ของคุณเองโดยไม่ต้องผ่านคลาวด์ รองรับการโคลนเสียง พากย์วิดีโอ และถอดความได้ฟรีถึง 646 ภาษา