
Google เปิดตัว Gemini 3.8 TTS ปฏิวัติการสร้างเสียงด้วย AI
วันนี้ เราขอแนะนำโมเดล text-to-speech (TTS) ใหม่สองรุ่นสู่ครอบครัว Gemini ซึ่งจะเปลี่ยนการสร้างเสียงจากค่าล่วงหน้าแบบคงที่ให้กลายเป็นสตูดิโอสร้างสรรค์ที่ทรงพลัง โมเดลเหล่านี้ช่วยให้ครีเอเตอร์ นักพัฒนา และองค์กรสามารถสร้างประสบการณ์เสียงที่สมบูรณ์และแสดงอารมณ์ได้มากขึ้น ในขณะเดียวกันก็ช่วยปรับปรุงประสบการณ์ผู้ใช้งานในผลิตภัณฑ์อย่าง Gemini Notebook และ Google Vids
Gemini 3.8 Flash TTS: ออกแบบมาเพื่อการกำกับงานสร้างสรรค์ในระดับลึกและการดีไซน์ตัวละคร โดยสามารถสร้างเสียงใหม่ทั้งหมดตั้งแต่เริ่มต้นผ่านพรอมต์ภาษาธรรมชาติเพื่อทำให้ตัวละครมีชีวิตชีวา ทั้งในเกม หนังสือเสียง พอดแคสต์ และสื่อเชิงโต้ตอบ ผู้ใช้สามารถกำกับการแสดงได้ละเอียดแบบบรรทัดต่อบรรทัด ทั้งจังหวะ การเปลี่ยนสำเนียง และการตอบรับเชิงสนทนา (backchanneling)
Gemini 3.8 Flash-Lite TTS: สร้างขึ้นเพื่อการใช้งานปริมาณมากในราคาประหยัด เหมาะสำหรับการพากย์เสียงจำนวนมากและการสร้างตัวแทนเสียงที่แสดงอารมณ์ได้แม่นยำ พร้อมการควบคุมโทนเสียงและจังหวะที่ละเอียดอ่อน โมเดลเหล่านี้เข้ามาเสริมทัพครอบครัว Gemini Audio ที่เติบโตอย่างรวดเร็ว ต่อจาก 3.5 Live Translate, 3.5 Transcribe, 3.8 Live, and 3.8 Live Extended Thinking
สร้างและปรับแต่งเสียงของคุณเอง
ยกระดับจากเสียงต้นฉบับ 30 เสียงไปสู่คลังเสียงที่ไม่จำกัด ไม่ว่าคุณจะต้องการเสียงตัวละครที่เป็นเอกลักษณ์หรือทูตของแบรนด์ที่คงเส้นคงวา Gemini 3.8 Flash TTS ทำหน้าที่เป็นสตูดิโอเสียงเต็มรูปแบบ ช่วยให้คุณสร้างเสียงที่ฟังดูเป็นธรรมชาติได้ในทุกช่วงเวลา เพิ่มศักยภาพให้นักพัฒนาและองค์กรสร้างประสบการณ์เสียงเฉพาะตัวได้อย่างง่ายดาย
การออกแบบเสียงแบบ Generative: ผู้ใช้สามารถสร้างเสียงเฉพาะตัวโดยกำหนดบทบาท สำเนียง และลักษณะเฉพาะในกว่า 100 ภาษาและสำเนียงท้องถิ่นผ่านพรอมต์ภาษาธรรมชาติ ไม่ว่าจะเป็นมังกรพ่นไฟที่ดูดราม่า หรือนักบรรยายที่มีเสน่ห์พร้อมจังหวะการพูดตามภูมิภาคที่ชัดเจน
ฟังตัวอย่างว่า Gemini 3.8 Flash TTS สร้างเสียงดีเจที่มีพลังงานสูงจากเมลเบิร์นได้อย่างไร
ฟังตัวอย่างว่า Gemini 3.8 Flash TTS สร้างเสียงหุ่นยนต์ที่แหลมเล็กและราบเรียบได้อย่างไร
ฟังตัวอย่างว่า Gemini 3.8 Flash TTS ทำให้มังกรญี่ปุ่นมีชีวิตขึ้นมาได้อย่างไร
ฟีเจอร์เด่นอื่นๆ ประกอบด้วย:
- คลังเสียงที่กว้างขวาง: เข้าถึงเสียงพร้อมใช้งานกว่า 2,000 เสียง ครอบคลุมความหลากหลายทางภูมิภาค เช่น ภาษาสเปนเม็กซิกัน และอังกฤษสกอต
- การจำลองเสียง: สร้างโปรไฟล์เสียงใหม่จากตัวอย่างเพียง 30 วินาที โดยมีระบบตรวจสอบความยินยอม การทำลายน้ำด้วย SynthID และข้อมูลรับรอง C2PA เพื่อความโปร่งใส
- บันทึกและขยายผล: จัดการเสียงที่ออกแบบไว้เพื่อให้การแสดงผลคงเส้นคงวาตลอดโครงการ
- การรีมิกซ์เสียง: เตรียมเปิดให้ปรับแต่งกังวานเสียง (timbre) ระดับเสียง และสำเนียงจากคลังเสียงเดิมผ่านพรอมต์เร็วๆ นี้
กำกับการแสดงแบบบรรทัดต่อบรรทัด
เมื่อเลือกเสียงได้แล้ว โมเดล TTS ทั้งสองรุ่นจะเปิดให้ควบคุมการถ่ายทอดอารมณ์ในแต่ละบรรทัดได้อย่างแม่นยำ ไม่ว่าจะเป็นการเขียนคำสั่งการแสดงเองหรือให้ Gemini ช่วยนำทาง ตั้งแต่พนักงานบริการลูกค้าที่ใจเย็นไปจนถึงเสียงกระซิบในฉากระทึกขวัญ
ฟังตัวอย่างว่า Gemini 3.8 Flash TTS ช่วยให้การสนทนาเป็นธรรมชาติและแสดงอารมณ์ได้สูงสำหรับตัวแทนเสียงเชิงโต้ตอบได้อย่างไร
ชมและฟังว่า Gemini 3.8 Flash TTS ใช้การควบคุมบทพูดที่ละเอียดเพื่อสร้างประสบการณ์เสียงที่ดึงดูดและสมจริงได้อย่างไร
นอกจากนี้ยังรองรับ การสร้างเนื้อหาขนาดยาว ที่รักษาคุณภาพเสียงและจังหวะได้ต่อเนื่องหลายชั่วโมง เหมาะสำหรับพอดแคสต์ รวมถึง การจัดฉากสำหรับผู้พูดสองคนแบบ Native ที่จัดการบทสนทนาโต้ตอบได้ราบรื่นในไฟล์เดียว และการแทรก เสียงตอบรับตามบท เช่น เสียงหัวเราะ หรือการถอนหายใจ เพื่อเพิ่มความสมจริง
ดูวิธีที่ Gemini 3.8 Flash TTS เปลี่ยนพรอมต์ภาษาธรรมชาติให้เป็นบุคลิกเสียงเฉพาะตัวตั้งแต่เริ่มต้น
ดูวิธีที่ Gemini 3.8 Flash TTS ช่วยให้ครีเอเตอร์ออกแบบฉากที่กำหนดเองเพื่อทำให้บทสนทนาแอนิเมชันมีชีวิตชีวา
ดูวิธีที่ Gemini 3.8 Flash TTS เปลี่ยนบทพูดให้เป็นฉากการสนทนาที่มีการแสดงเต็มรูปแบบ ช่วยให้ครีเอเตอร์กำกับการถ่ายทอดเสียงและจังหวะการสลับคิวที่เป็นธรรมชาติ
คุณภาพเสียงระดับโลกที่การันตีด้วยผลทดสอบ
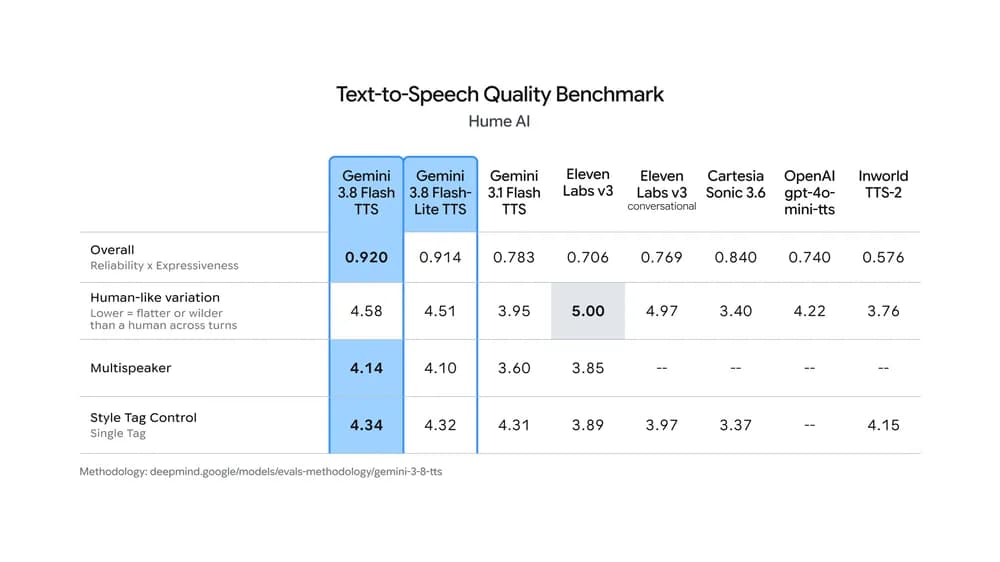
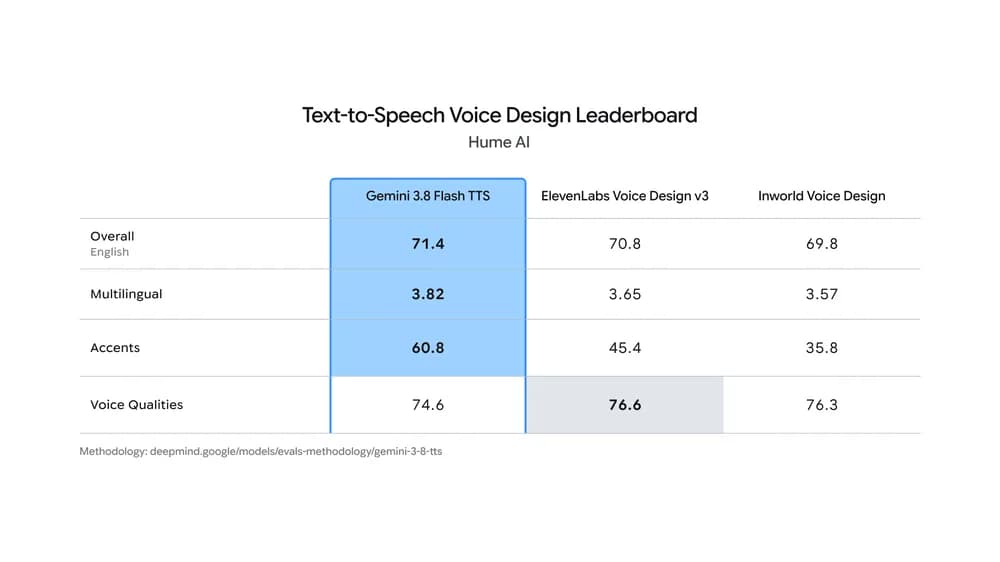
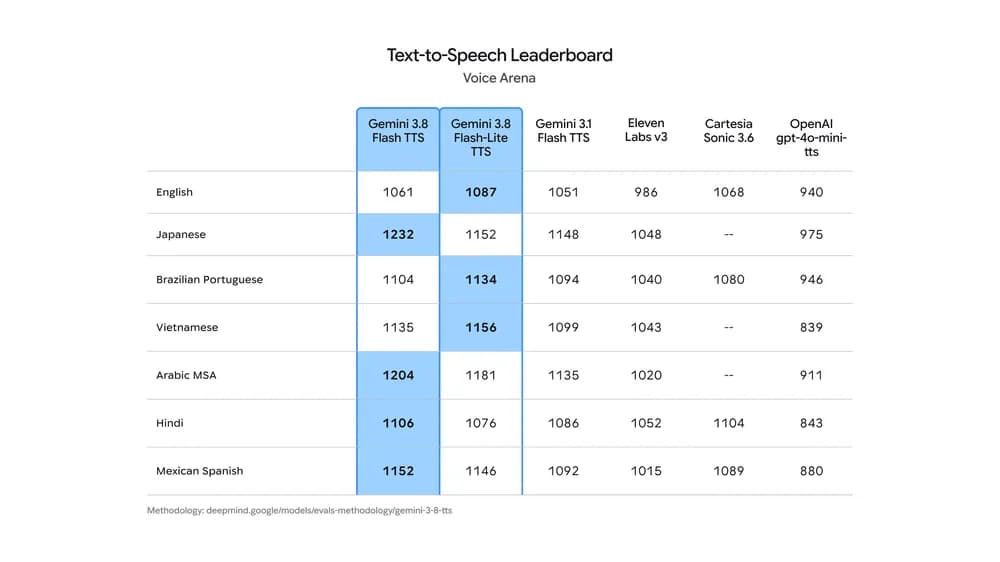
Gemini 3.8 Flash TTS ครองอันดับ 1 ใน Voice Design Benchmark ของ Hume AI ด้วยคะแนน 71.4 และเป็นผู้นำในการจำลองสำเนียง ขณะที่ในการประเมินความพึงพอใจแบบ Blind Human Preference บน Voice Arena พบว่าครองตำแหน่งสูงสุดในหลายภาษาหลัก เช่น ญี่ปุ่น โปรตุเกส เวียดนาม อาหรับ และฮินดี
ความปลอดภัยและความโปร่งใส
เราสร้างความสามารถนี้ด้วยมาตรการป้องกันเข้มงวด การจำลองเสียงต้องใช้บันทึกความยินยอมจากเจ้าของเสียงจริงเท่านั้น นอกจากนี้ คลิปเสียงทุกชิ้นจะถูกใส่ลายน้ำดิจิทัลด้วย SynthID เพื่อให้ตรวจสอบได้ว่าเป็นเสียงจาก AI ป้องกันข้อมูลบิดเบือน สามารถดูรายละเอียดเพิ่มเติมได้ที่ model card
เริ่มต้นใช้งานได้ทันที
นักพัฒนาสามารถทดลองใช้งานใน Google AI Studio ซึ่งออกแบบมาเป็นพื้นที่ทำงานเสียงโดยเฉพาะ สามารถพรอมต์สร้างเสียงใหม่หรือจำลองเสียงตนเอง 1 เพื่อนำไปใช้ในตัวแก้ไขบทภาพยนตร์ได้ทันที
ลองใช้การจำลองเสียงใน Google AI Studio
นอกจากนี้ยังสามารถเข้าถึง Gemini API ผ่านพันธมิตรอย่าง Agora, LiveKit, Pipecat และ Vercel โดยมีบริษัทชั้นนำอย่าง Figma และ HeyGen ร่วมผสานรวมโมเดลเพื่อเพิ่มประสิทธิภาพการพากย์เสียงและการสื่อสารทั่วโลก
ช่องทางการเข้าถึงโมเดลล่าสุด:
Gemini 3.8 Flash TTS:
- นักพัฒนา: Gemini API และ Google AI Studio
- องค์กร: เร็วๆ นี้ทาง API ใน Gemini Enterprise
- ผู้ใช้ทั่วไป: ใน Gemini Notebook
Gemini 3.8 Flash-Lite TTS:
- นักพัฒนา: Gemini API และ Google AI Studio
- องค์กร: เร็วๆ นี้ใน Gemini Enterprise
- ผู้ใช้ทั่วไป: ใน Google Vids
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร